ARTICLE · 1331799
从器件 PDF 到采购 BOM:两步整理硬件资料
硬件团队处理元件资料时,常要先从许多数据手册找参数,再把多份设计导出的 BOM 合并成采购能用的清单。Nex Datasheet Extractor 和 Nex BOM Normalizer 两份技能指南,分别描述了 PDF 字段提取与表格规范化的流程。它们本周公开于 Nex AI 的 SKILL.md 镜像中;仓库 README 说明镜像只包含指南,没有原包脚本或模板。因此下面讲的是文档计划的工作方式,不是已经验证的批量处理程序。
先把规格从 PDF 搬进结构化记录
Datasheet Extractor 面向电子元件 PDF。指南列出的目标字段包括零件号、制造商、供电电压范围、工作温度、封装与引脚数,也会查找 RoHS、REACH 等合规状态,最后整理成 JSON 或 CSV,供 ECAD 元件库或内部检索使用。
适合的起步方式是挑一份有文字层的数据手册,只抽取一个器件,要求输出同时附上页码或原文摘录。拿表格里的最小/最大值回到 PDF 原页核对单位、小数点和条件栏,尤其要留意“典型值”和“保证范围”之间的区别。指南写的是解析 PDF 文本层;对于扫描图片,没有文本层时可能需要 OCR,而当前公开资料没有证明其支持能力。温度范围、引脚数和环保声明都可能影响选型,不能只看一段摘要就直接导入正式元件库。
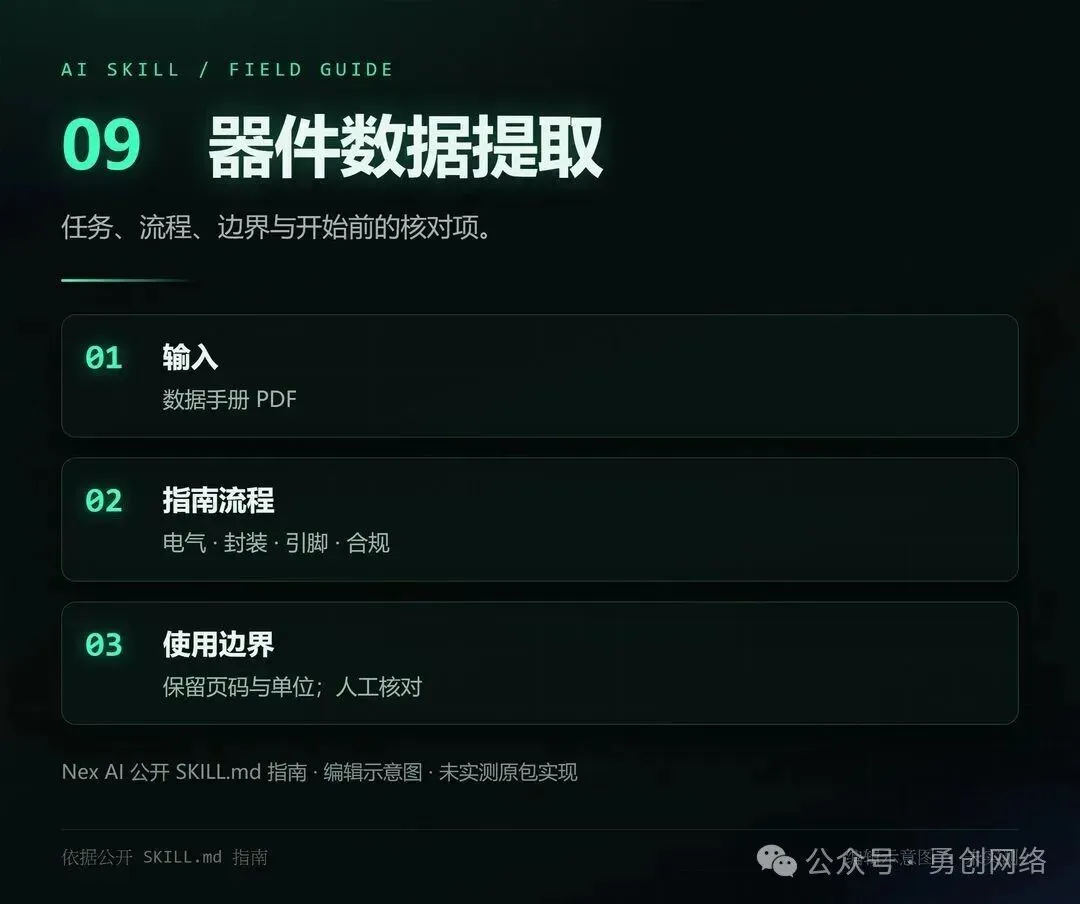
图注:编辑绘制的 PDF 字段提取示意图,依据公开 SKILL.md,未处理真实器件文档。
再把多张 BOM 变成同一套列
BOM Normalizer 处理的是表格结构。不同 EDA 导出可能把制造商零件号写成 MPN、Part Number 或 Manufacturer SKU,也可能把数量和位号放在不同列。指南描述先映射到 RefDes、Qty、MPN、Manufacturer 等标准字段,再按制造商与 MPN 合并重复行、规范位号大小写、汇总数量,并把缺少 MPN、数量或制造商的行放进单独 CSV 供人工检查。
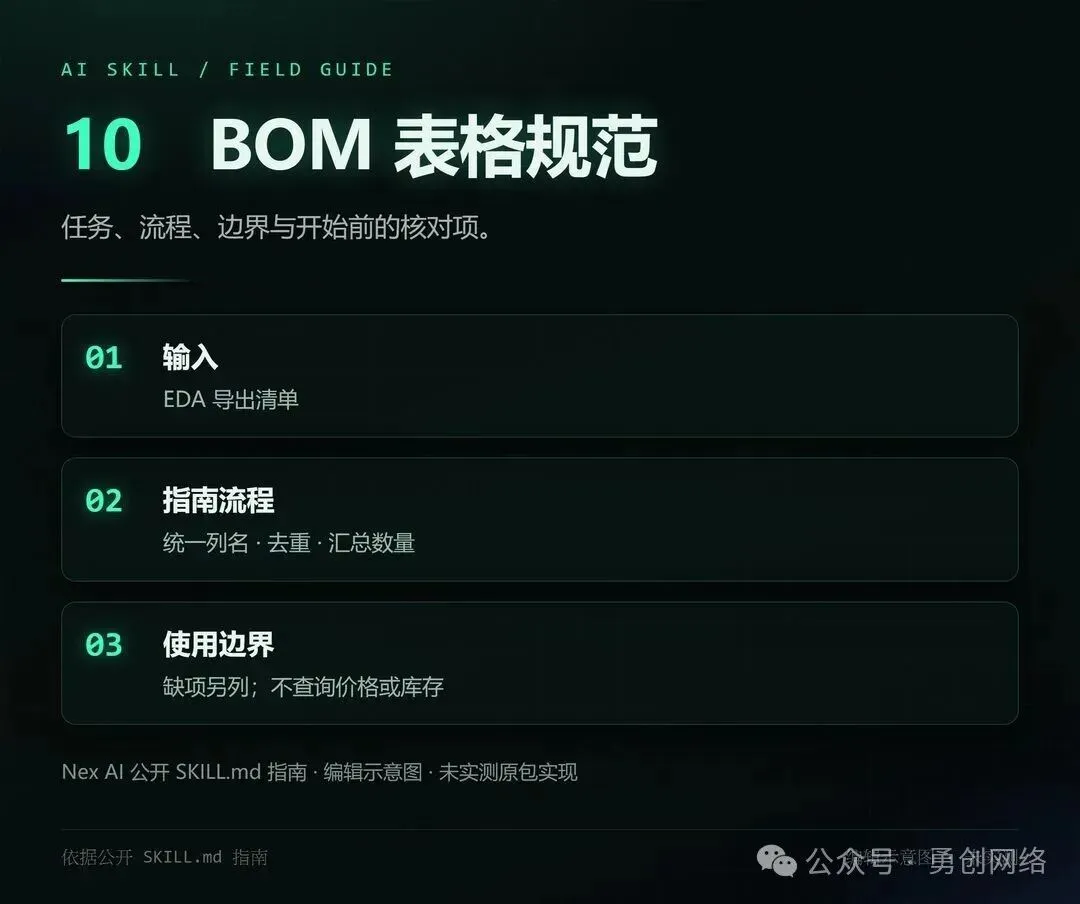
图注:编辑绘制的 BOM 规范化步骤示意图,依据公开指南,不代表真实采购数据结果。
合并规则需要慎重。如果同一个 MPN 的制造商字段被缩写成不同写法,可能被误判为两种料;如果只按零件号合并,也可能把看似相同但供应条件不同的行合在一起。开始前应备份原始文件,用 5 到 10 行样例建立映射规则,让工程师逐项核对 RefDes 与总数量。指南特别指出它不查询实时库存或价格,所以结果不能直接等同于采购建议。
这两个技能适合构建一个可追溯的资料整理链:PDF 提取字段时保留来源页码,BOM 清洗时保留输入行与合并原因。每一步都把不确定值标记出来,别让模型“补全”缺失参数。由于公开仓库只发布说明文本,真正要批量处理时还需确认所拿到的执行实现、文件格式与错误处理能力。对少量关键元件,人工回看原始手册仍是必要的质量关卡。
器件参数的记录最好保留原始值、标准化值、单位、页码和审核状态。若 PDF 写的是条件范围而不是单一数值,结构化字段也应保留条件,不能压缩成一个“最大值”就丢掉上下文。对于合规状态,要分清文档有没有提及、器件是否具备声明,以及资料版本是哪一年。BOM 清理时同样要留来源行号和合并组,便于发现位号遗漏或数量意外翻倍。采购前可以抽查数量较大的器件、缺料较多的分组和所有替代料,再由负责工程或采购的人签字。这样的审核表比一份看似干净却没有来源的 CSV 更可靠。遇到多个数据手册版本时,先记录文件名、版本号和下载日期,避免把旧型号的规格混进新料号。器件选型还要核对封装与引脚定义,不能因为引脚数量相同就认为 footprint 一样。规范 BOM 后,最好将清理表与原始 EDA 导出做一次数量差异对比,解释每个合并或拆分。若上游设计更改导致 RefDes 改名,保留新旧名称映射能帮助采购、生产和工程一起排错。技能指南提出的是字段整理目标,团队仍需提供料号规则和认可的制造商名称清单,才能减少错误合并。数据流完成后可以把记录导入测试元件库,核对字段类型、单位和必填值,再比较总行数与原始 PDF 清单。若遇到只有图片的扫描文件,可先走既有 OCR 流程,并把 OCR 识别标成低置信度;公开指南没有承诺这种输入可准确处理。BOM 合并时同样要留一份未修改的输入和转换日志,出现数量不一致时可以回溯是哪几行合并。团队还应写清制造商名称的标准表,防止同一家公司的缩写和全称导致重复零件,或把相近料号错误归成一个。适合建立一张小型审核表:器件号、字段名、提取值、单位、来源页、审核人和状态。表格过验证后再导入元件库,不要让自动化一步到位覆盖主库。对于 BOM,保留未清洗版本并列出每一组合并的原始行,有助于设计修改后重新对比。还可以随机抽查几颗常用器件和几条缺字段记录,确认错漏没有集中在某种 PDF 版式或某家 EDA 导出格式。随着样例积累,团队再明确哪些规则可以自动处理,哪些必须人工批准。制造商名称与料号规则确定后,可以先建立一套团队自己的字段映射和例外说明,避免每次导出都重新猜列名。质量负责人再抽样检查正常行、重复行、缺失行和合规字段,确认报告中能看见所有异常。只有这些小样例稳定之后,才考虑处理更大的批次或连接正式系统。
来源
Nex Datasheet Extractor:SKILL.md Nex BOM Normalizer:SKILL.md