ARTICLE · 1348425
PDF 为什么这么难改?从 Edge、WPS 到我做的文件工坊
打开一份 PDF 很容易。到了复制文字、给扫描书裁边、或者把摘录跳回原文的时候,才会发现这个格式里有许多值得拆开看的东西。
我以前主要用 Edge 读 PDF,后来改用 WPS,偶尔也会打开 Acrobat。再遇到扫描书白边太宽、书签乱了、想把两处摘录放在一起对照,我还会用 Briss、PDF 补丁丁和 LiquidText,所以准备梳理一下工具。
在做「文件工坊」时,我把这个问题从使用者的角度,又从程序的角度想了一遍。答案先从 PDF 最初想解决的麻烦说起。
01先让一页纸顺利到达别人手里
把一份排好的文档发给别人,收件人可能换了电脑、缺少字体,或者用着另一套软件。即使文字都在,行尾、图表和分页也可能变。PDF 早期追求的是让接收方也能按照设计好的页面阅读和打印。
20 世纪 90 年代初,Adobe 联合创始人 John Warnock 提出 Camelot 项目。1993 年,PDF 1.0 公开发布。2008 年,以 PDF 1.7 为基础的 ISO 32000-1 发布,PDF 有了国际标准。2017 年发布 PDF 2.0,2020 年又出了修订版 ISO 32000-2:2020。今天浏览器、办公软件和独立阅读器都可以依据同一份规范实现各自的解析与显示。实际效果仍会受字体、文件本身和阅读器实现影响。
现在,合同、论文、扫描件、印刷稿都可以放在这个格式里,但对文件的要求各不相同。PDF/A 面向长期保存,PDF/X 面向印刷交换,PDF/UA 面向无障碍访问。理解这一点,就容易明白为什么「我的电脑上打开没问题」和「这份文件能长期归档或被读屏软件正确读出」需要分别检验。
02看着一样的两页,里面可能完全不同
想象把同一页教材保存两次。一次从排版软件导出,一次把打印稿扫描回来。肉眼看着差不多,但用鼠标选一句话,第一份可能可以直接复制,第二份可能只能选中整张图。给扫描版做 OCR,相当于让软件识别图片里的字,再附上一层(所以OCR之后文件尺寸一般不会减小)有位置的文字,阅读器就能搜索和选取它。识别错的地方也会进入搜索结果,尤其值得核对公式、脚注和小字。
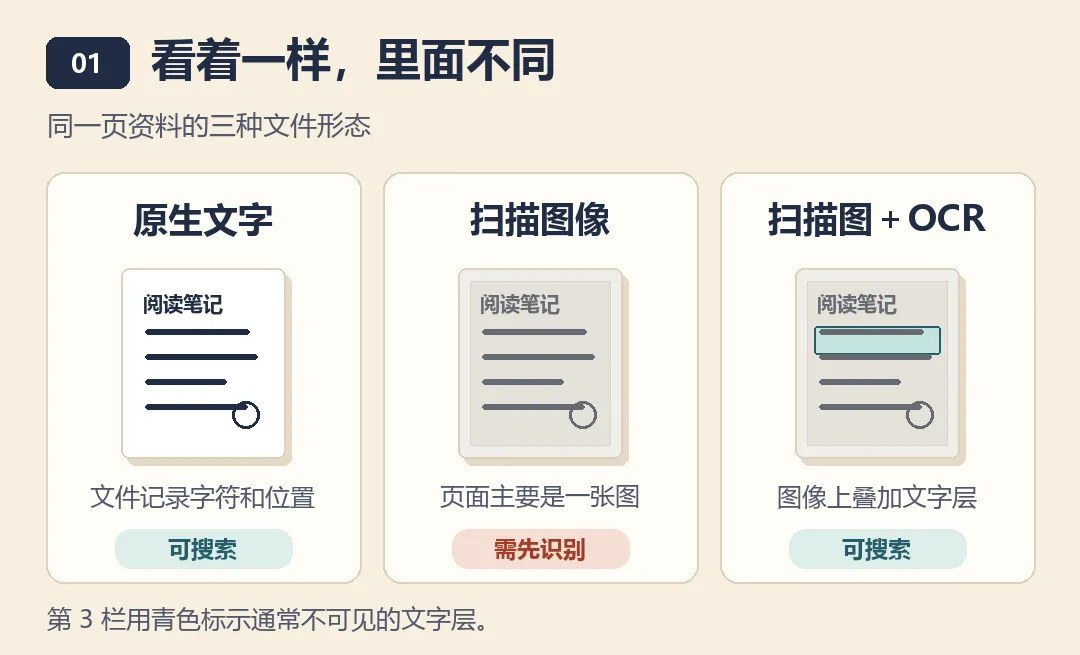
图 1|同一段文字可以来自绘制文字、整页扫描图,或扫描图上叠加的 OCR 文字层。
还能复制,却复制成了乱序,也很常见。一张双栏论文看起来有明确的先后顺序,文件内部可能按不同顺序绘制各处文字。阅读器要从坐标、字符映射和可用的结构信息里重建阅读顺序。能画出来、能搜出来、能按人读的顺序复制,是三个不同层次的工作。
如果再往里拆,会看到页面内容流。可以把它想成一张给绘图员的指令单。把坐标系移到这里,用这个字体画几个字,再把那张图放在右下角。一句话可能分成好几条绘制指令,字节里也可能只存字体编码。直接拿屏幕上看到的一句话去做正则搜索,经常找不到对应的那一串字。
03我在文件工坊里碰到的3个问题
第 300 页,究竟要读多少数据?
打开一本几百兆的 PDF,如果先把整个文件塞给界面,光是搬运数据就要付出代价。我在文件工坊里用了按范围读取的做法。程序在后台打开文件,给预览器一个临时编号。预览器需要页索引或某段页面数据时,带着编号请求「从哪里开始,读多少字节」。后台核对范围和文件身份,再交回对应的字节。文件中途变化时,旧会话不能继续拼接新文件的数据。
这个编号在项目里叫读取租约。至于关掉文件后还能不能回到第 300 页,是另一项功能。文件工坊会记住阅读位置,重开时提示「继续阅读」,点了才跳回去,并重新按需取数据。
摘一句话容易,隔天还能找对才有用
我希望一句摘录存下来的同时,也保留出处。只存「这句话出现在第 42 页」还不够。同一句可能在那页出现两次,文件也可能被移动或换成新版。文件工坊的摘录会保存来源、页码和选区信息。文字选区有锚点,扫描页也可以记下框选区域。回跳时还要考虑当前缩放与原文件版本。
这样,搜索、框选 OCR、翻译、收藏和 Markdown 导出可以各自工作,又能沿着同一条出处线索接起来。几天后整理笔记,点一下摘录就能看回原来的上下文。
想改一页,另一页为什么也变了?
假设两页都引用同一个绘图对象来画相同的页眉。直接修改那个对象,两页都会变。如果只想改第一页,可以给它单独复制一份对象,再把第一页的引用指向副本。因此,改内容流之前,先查清楚哪几页用了这份资源。
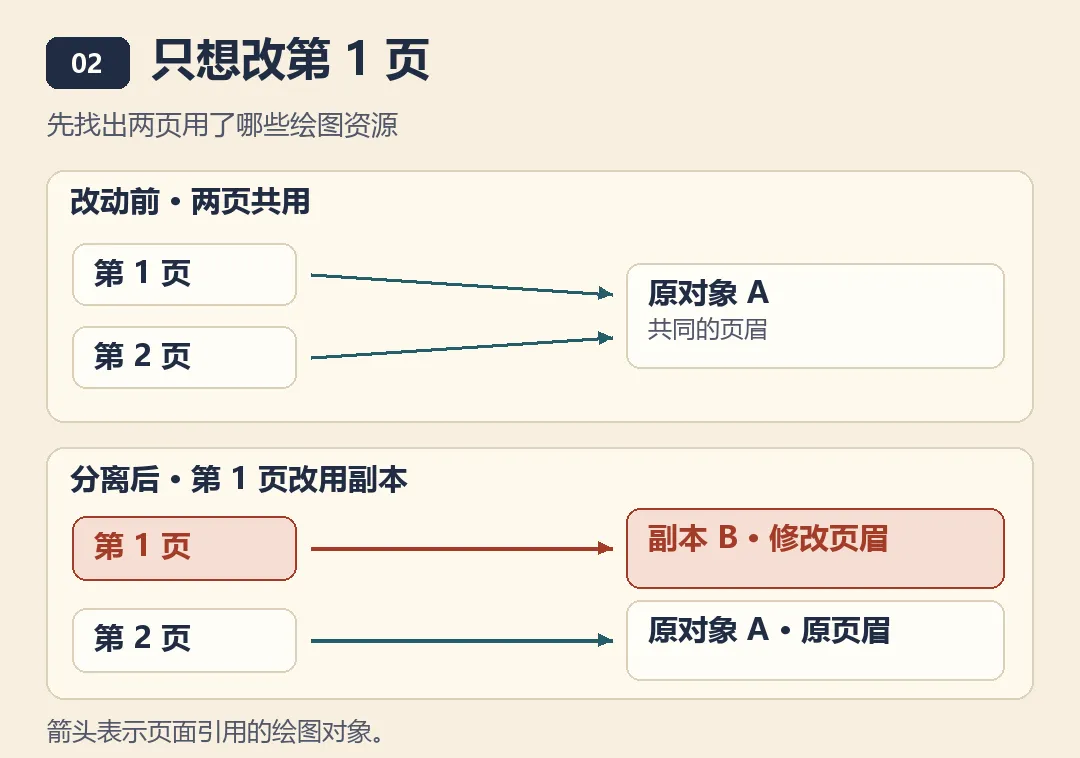
图 2|两页共享绘图对象时,先分离第一页的引用,可以把这次修改限定在第一页。
文件工坊用 PDF.js 做阅读与渲染,用 QPDF 处理部分结构检查和改写。现有的内容流工具可以对符合条件的页面流做正则替换,预览命中和受影响页,然后另存副本并做结构检查与读回。这一版只处理未加密、无数字签名的本地 PDF,解码后每条流上限为 128 KiB,编辑范围限 ASCII 页面指令。上面「复制一个共享绘图对象,再只改某一页」是通用处理思路,也正适合作为后续实验。
04我平时怎么分工
Edge 是我以前最常用的阅读器。收到 PDF,顺手打开就能看、查找、跳页。需要时也能高亮、加批注或朗读。
WPS 是我后来更常用的选择。PDF 经常和 Word、表格、演示文稿一起出现在办公流程里。WPS 把阅读、转换、合并、拆分和 OCR 放在一套办公软件里。当 PDF 和办公文档需要来回处理时,这些入口就在同一套软件里。
Adobe Acrobat 我偶尔会用。它的 Pro 版有一项很适合钻进去看的功能,叫 Preflight。除了检查字体、颜色和印刷条件,它还能把内部对象和内容流展开给你看。结构浏览窗口用来观察,修复则通过规则或其他编辑入口完成。这种分工很适合拿来理解「读懂文件」和「改动文件」分别需要什么。
PDF 补丁丁适合整理现成的 PDF,比如调整书签、拆合文档、提取嵌入图片和探查文档结构(特别是可以去除限制)。
Briss 把裁边做得很有辨识度,它将多页叠在一块,让你找共同的正文边界,再画裁剪框(适合装到阅读器前预处理)。
LiquidText 则适合慢读。摘录可以拖到文档旁的工作区,跨文档并排对照、连线,再从卡片回到原文。这三个工具分别把整理、裁边、研究笔记做成了不同的工作方式。
05几款小工具,值得拆开研究
做过文件工坊再回头看,我会把日常的目标定得小一点。一本扫描教材,先用合适的工具裁边和补文字层,再交给阅读器。读到一段有价值的话,把出处和想法一起留下来。下次能顺利续读,翻旧笔记还能准确找到原文,这条链路就值得打磨。
至于如何有效的接入知识库,等后面再研究,可能需要研究https://mineru.net/。
参考资料(长按复制)
01 Adobe PDF 历史https://www.adobe.com/uk/acrobat/resources/pdf-timeline.html
02 PDF Association 规范档案https://pdfa.org/resource/pdf-specification-archive/
03 PDF 标准族https://pdfa.org/pdf-standards/
04 PDF 2.0 规范https://pdfa.org/resource/iso-32000-2/
05 OCRmyPDF 使用手册https://ocrmypdf.readthedocs.io/en/latest/cookbook.html
06 pikepdf 内容流说明https://pikepdf.readthedocs.io/en/latest/topics/content_streams.html
07 PDF.js 项目https://mozilla.github.io/pdf.js/
08 QPDF 手册https://qpdf.readthedocs.io/en/stable/cli.html
09 Microsoft Edge PDF 阅读器https://learn.microsoft.com/en-us/deployedge/microsoft-edge-pdf
10 WPS PDF 功能https://www.wps.com/feature/pdf/
11 Adobe Preflight 内部结构检查https://helpx.adobe.com/acrobat/using/advanced-preflight-inspections-acrobat-pro.html
12 Preflight 修复规则https://helpx.adobe.com/acrobat/using/correcting-problem-areas-preflight-tool.html
13 PDF 补丁丁https://github.com/wmjordan/PDFPatcher
14 Brisshttps://sourceforge.net/projects/briss/
15 LiquidText 功能https://www.liquidtext.net/features
16 Sioyek 手册https://sioyek-documentation.readthedocs.io/en/latest/index.html
17 Zotero 阅读器与笔记https://www.zotero.org/support/pdf_reader
18 K2pdfopthttps://willus.com/k2pdfopt/
19 diff-pdfhttps://github.com/vslavik/diff-pdf
20 浏览器 PDFCrafthttps://github.com/PDFCraftTool/pdfcraft
21 Rust PdfCrafthttps://github.com/storytold/pdfcraft