ARTICLE · 1353171
文档里的一句话,骗过 96.3% 的模型
模型读不出边界
大模型的输入是一个扁平序列。系统提示、用户指令、检索到的文档、工具返回的结果、历史对话,全部拼在一起喂进去。
模型没有任何先天的机制去区分:这段是命令,那段是资料。
所以攻击方式极其简单:把命令藏在"资料"里。文档、网页、邮件、工具返回值,任何模型会读但不该听的地方。
对聊天机器人来说,最坏结果是它说错话。对智能体来说,最坏结果是它真的去执行——发邮件、改数据库、调支付接口。
权限越大,这个洞越大。
给它一套语法
IBM 的思路不是在外面加一层过滤器,而是从模型读输入的格式入手。
他们做了一套标记语言,叫 LLMON,全称 LLM Object Notation,读作"柠檬"。
做法有三样东西:
六个保留分隔符。 它们是词表里的单个 token,专门用来标记块的开始和结束。因为是独立 token,普通文字拼不出这个结构,伪造不了。
块 ID。 每一份输入被切成若干块:指令块、数据块、文档块、工具块、系统块。每块带一个两字符的随机 ID。
执行块。 每一轮对话结尾有一个 exec 块,明确写清:执行哪一条指令、作用于哪些数据、输出到哪里。
剩下的内容不是被删掉,而是被标记为"未引用材料"——模型看得见,但不当作命令。
这就是 IBM 说的"权限规则":系统块和执行块里的内容是权威的,文档、工具返回、数据块只供阅读。
关键在于,这个规则不是靠提示词求模型遵守,而是靠训练。模型是在这种结构上后训练的,它学到的是另一种读输入的语法。
攻击成功率塌了
数字很硬。
在 OPI 这个间接注入基准上,Granite 4.1 3B 的攻击成功率从 100% 降到 0.1%;8B 从 96.3% 降到 0.02%。
另一个更贴近智能体的场景,注入藏在工具返回值里:3B 从 99.2% 降到 5.6%,8B 从 52.8% 降到 3.1%。
训练语料是 460 万条、46 亿 token,其中 13 万条是注入样本。训练流程是先监督微调,再跑五个阶段的强化学习,最后用 1000 对偏好数据做 DPO。
两个模型都以 Apache 2.0 开源,参数分别是 3B 和 8B,从 Granite 4.1 的基础检查点训练而来,不是从指令模型改的。
IBM 在博客里还说了一句:比它测过的最好的前沿模型少 47% 的攻击,比最好的开源模型少 95%。
这句话要打个折看——那组对比只出现在一张图表里,没有列出具体是哪些模型。
只挡住静态攻击
这是整件事最需要说清楚的部分。
0.02% 这个数字,测的是静态的、单轮的、注入内容固定不变的攻击。
论文自己也承认:在多轮、自适应、会针对防御调整策略的攻击下,保护效果明显变弱。
原因不难理解。LLMON 学到的是一条"规则",不是一个"不可绕过的边界"。规则可以被更强的上下文说服,可以被多轮对话慢慢磨掉,也可以在训练没覆盖的分布上失效。
IBM 的模型卡写得很直白:这是一种学到的行为,可能失效,不能作为智能体唯一的安全防线。
还有一条更实操的限制:集成没那么简单。
如果你只是把模型换掉,仍然把任务和文档塞进同一个文本框,那套结构就不存在了——普通文本字段默认被当作指令。
必须用配套的 chat_template,把文档作为独立的数据块传进去,分离才成立。
这不是"换个模型就安全了",是"换个方式喂输入"。
能力付了代价
安全训练不是免费的。
8B 版本的对比数据:GPQA 从 41.96 掉到 35.05,数学基准从 80.07 掉到 70.86,MMLU 基本持平(73.84 到 74.20),BigCodeBench 反而从 35.00 涨到 44.04。
推理和数学退了一截,写代码涨了一块。
这个取舍很符合直觉:模型被训练成"先分辨这段话是谁说的",这个习惯会占用一部分注意力,而数学和科学推理最吃这种专注度。
所以它现在的定位是"可评估的预览版",不是"拿来就用"。
三层防线这样搭
如果你正在做带工具的 AI 应用,这件事的真正价值不在于"有个新模型",而在于它把防御拆成了三层,而且每层都能落地。
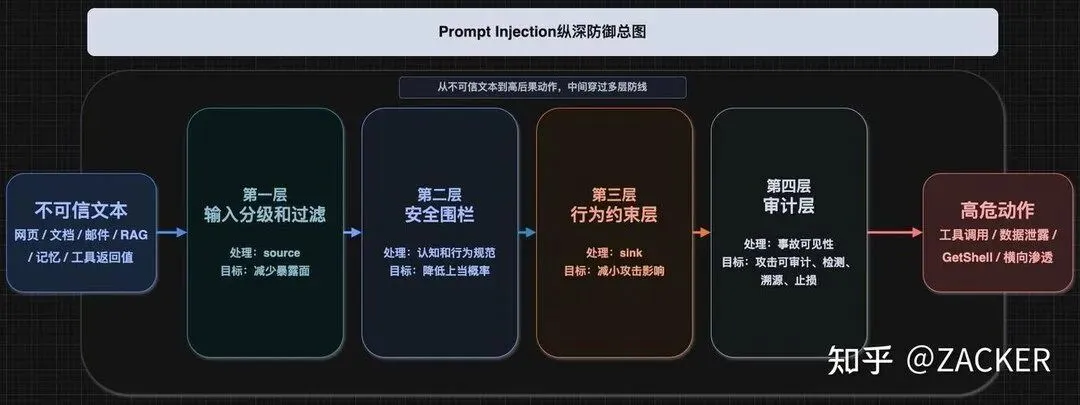
第一层:输入分级。 不要让所有输入走同一个通道。用户的话、检索到的文档、工具返回的结果,在数据结构上就该分开。哪怕你不用 LLMON,也可以在自己的 prompt 模板里把文档包进明确的标签,并在系统提示里固定"标签内只读"。
这不是绝对安全,但能挡掉最粗糙的那一批。
第二层:权限约束。 智能体不该拥有超出任务需要的权限。发邮件要二次确认,写数据库要限定表,调支付要限额,删文件要进回收站。
这一层的逻辑是:假设注入一定会成功,那它成功之后能造成的最大破坏是多少。把这个上限压住,比追求"零注入"现实得多。
第三层:审计。 每一次工具调用都留日志:谁触发的、读了什么、调了什么、结果是什么。异常行为要能被事后发现,也要能实时拦截。
LLMON 那套 exec 块的设计,本质就是让"哪条指令在执行、作用于哪些数据"变成可记录的结构。你不换模型,也可以在自己的框架里把这件事显式化。
回到那个最容易踩的坑。
很多人看到"注入成功率 0.02%",第一反应是换个模型。但如果输入方式不变,模型学到的结构就无从生效。
IBM 给的集成方式是:用它的 chat_template,把消息渲染成带标签的结构,靠每个块的 exec 标志区分"可执行"和"仅阅读"。
一句话:你要给模型一个机会,让它知道哪段是命令。
这也是这套东西最值得借鉴的地方——不是那个 0.02%,而是"把指令和数据在结构上分开"这个思路。这个思路不需要换模型,今天就能用。
该带走的三条
第一,提示注入的根因是结构问题,不是模型不够聪明。 模型分不清指令和数据,因为输入里本来就没有这个区分。加过滤器是治标,改结构是治本。
第二,看到"攻击成功率降到 0.02%",先问测的是什么攻击。 静态单轮,还是多轮自适应?这两个数字通常差一个数量级。
第三,智能体的安全,上限在权限,不在模型。 模型再强,也不该有它不需要的权限。这条比换任何模型都有效。
IBM 把这条路开了一个头。接下来要看的,是它在多轮对抗里能剩下多少。
参考来源
▪︎ IBM Granite 团队,LLMON 发布与技术博客,2026-11-12
▪︎ 论文《LLMON: Structured Input for Instruction-Data Separation》,arXiv 2610.38120
▪︎ AI in Context,《IBM's Granite LLMON Models Block 47% More Prompt Injection Attacks》,2026-11-12
▪︎ Tokenstrom,《Command or just text? IBM's LLMON wants to stop prompt injection with grammar》,2026-11-12
▪︎ Rohit AI,《IBM previews Granite models trained to separate instructions from documents》,2026-11-12
▪︎ 网易科技,《IBM 推 LLMON 标记语言,注入攻击成功率降至 0.02%》,2026-11-13
▪︎ Hugging Face 模型卡:granite-4.1-3b-llmon-preview、granite-4.1-8b-llmon-preview