ARTICLE · 1372842
文档送到模型面前,不等于文档被用上了 :15.7% 的说法来自它的记忆,不是那份
用过带联网搜索的 AI 都有这个经验:它答完之后贴心地标上 [1][2][3],你点开第一条,确实是那个意思。点开第二条,发现那段话从头到尾没提过这件事。
一般人的解释是它引用标错了,找错了段落。
有篇论文说,情况比这严重。它标的那条引用,可能压根没被它用过。
论文说了什么
标题很直接,《Cited but Unused》,引用了但没用。作者是 Tanzeel Abbas、Tehseen Zia、David Windridge,11 月 12 日挂到 arXiv。
一句话概括:给大模型喂了检索到的文档,它答出来的内容里,有一部分其实是从自己训练时记住的东西里掏出来的,但它照样挂上一条文档引用,装成是从文档里查到的。
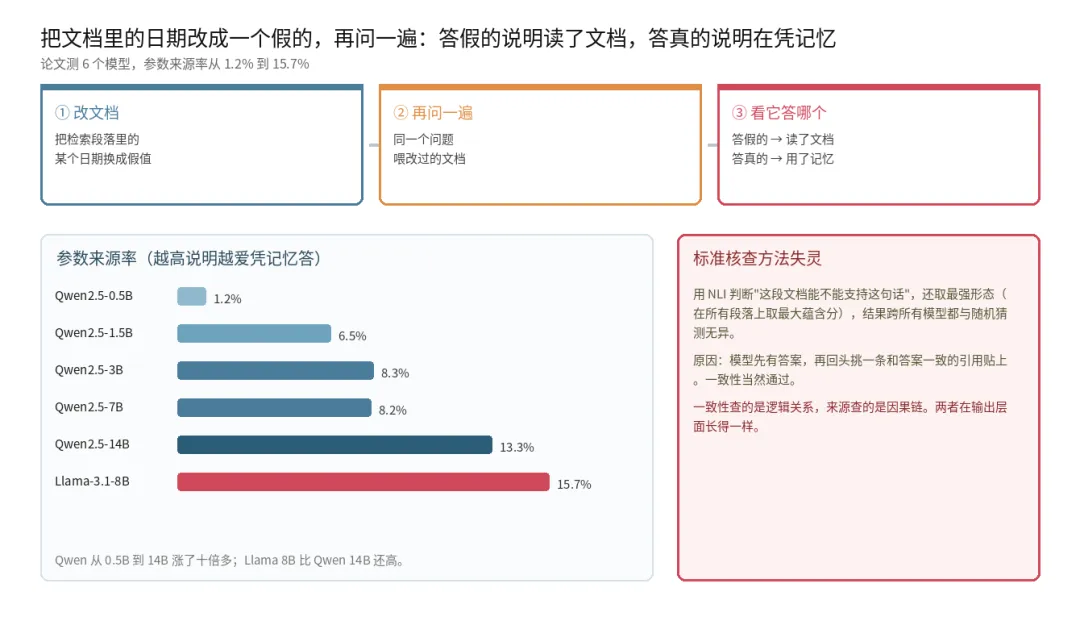
这个比例不小。测下来最低 1.2%,最高 15.7%。
怎么测出来的
这是全文最漂亮的地方,值得慢慢说。
他们用的办法叫反事实值替换。挑出检索段落里的一个事实,比如某个日期,把它换成一个假的变体,然后拿改过的文档重新问模型一遍。
逻辑是这样:
如果模型真的在读这段文档,它答的应该是那个假日期 如果模型答的还是原来那个真日期,说明它根本没看这段,是从记忆里掏的
真日期它记得,假日期它没见过。答对真日期,就是没用上你给的文档。
这个设计巧妙在不需要知道模型内部怎么想的,只看输出就能判断来源。而且它可验证:换的是具体的事实值,对错一目了然。
结果:模型越大,越爱凭记忆答
他们测了 Qwen2.5-Instruct 的五个尺寸,外加一个 Llama-3.1-8B 做对照,全部 bfloat16,主要数据集是 ASQA。
看 Qwen 那一列,从 0.5B 到 14B,参数来源率从 1.2% 涨到 13.3%,涨了十倍还多。
这有点反直觉。直觉上模型越大应该越听话、越会照着你给的文档答才对。实际是从小模型到大模型,它越来越倾向于相信自己记住的东西。
原因不难理解。0.5B 那个尺寸,脑子里本来就没存多少事实,只能老老实实依赖检索。14B 记得多了,就有了不看的底气。
一个打破规律的对照
表格最后一行是 Llama-3.1-8B,15.7%,比 Qwen 14B 还高,而参数量只有人家一半多。
论文专门在图注里点了这一条:Llama 比所有 Qwen 都高,包括比它大一倍的那个,说明模型家族本身就是个独立因素,跟规模不是一回事。
换句话说,模型爱不爱凭记忆答题,不只取决于它多大,还取决于它是谁训出来的。
标准核查方法,和抛硬币差不多
这部分是全文最让人不安的。
业界核查引用对不对,标准做法是用 NLI,也就是自然语言推理模型去判断这段文档能不能支持这句话。他们用了 DeBERTa 训出来的交叉编码器,还是用的最强形态:对每一条声明,在所有检索到的段落上取最大的蕴含分,等于不给它扣任何分。
结果:跨所有模型,结果都和随机猜测没有区别。
哪怕把范围限制在那条被引用的段落本身,还是没区别。
也就是说,你现在用的那些引用核查工具,在这个问题上基本是瞎的。
为什么查不出来
论文给的解释是结构性的,我觉得这句是全文最关键的:
一个从记忆里回答的模型,会挑一条和它输出一致的引用。
它不是先读文档、再生成答案。它是先有了答案,然后回头去找一条看起来能支持这个答案的引用贴上。既然是按答案去找的,找到的引用当然和答案一致。NLI 去判断一致性,当然判通过。
问题不在一致性上。问题在这条引用到底有没有参与过推理。
一致性检查的是一条逻辑关系,来源检查的是一条因果链。这两件事在输出层面长得一模一样。
有个能用的信号,但还不够用
他们没有只停留在批评上。
拿十条声明做对比,试了十种归因方法,最能区分来源的是这个:看模型在有上下文和没上下文两种情况下,输出分布的差异。
道理也直观。如果模型真的用了文档,那抽掉文档它应该答不出来。如果抽掉文档它照样答得一模一样,说明文档没起作用。
听着像找到了办法。但论文自己浇了盆冷水:按这个信号去做干预,在这么低的基线上,并不能提升引用诚实度。
最后一句结论写得很实在:这个检测器测的是模型知道什么,不是模型用了什么,把这两件事分开,仍然是未解的问题。
对用 AI 的人意味着什么
三条实际的。
引用数量不代表可靠程度。 一条答案后面挂五个链接,看着很扎实,但其中可能有几个是装饰。真正被用上的可能只有一两个。
越大越要留神。 小模型答不上来会说不知道,大模型记得多,反而更容易混着记忆和检索一起输出。用旗舰模型的时候,别因为参数大就放松对来源的检查。
自己核,别靠工具核。 既然 NLI 那类自动核查在这个问题上是瞎的,那就只能人工点开看。点开的时候别问"这段话支持这个结论吗",那个问题容易被一致性蒙过去。要问"这段话里有没有出现这个具体数字、这个具体名字",这个骗不了人。
我的看法
这篇论文的价值,在它把这个毛病的机理说清楚了。发现一个新毛病倒是次要的。
以前说 RAG 有幻觉,大家的理解是检索没找对东西。这篇说的是另一回事:检索找对了,文档给出去了,模型也答对了,但它没用那份文档。
这解释了一个长期让人困惑的现象。为什么有的 AI 加了知识库以后,答案看起来更靠谱了,可一问细节还是错?因为它可能只是在用知识库当装饰,真正说话的还是参数里那些可能过时的记忆。
还有一层现实意义。RAG 被当成解决幻觉的银弹已经好几年了,企业花大钱建知识库、做检索。这篇论文提醒的是:文档送到模型面前,不等于文档被用上了。中间那道桥,目前还没有可靠的检测手段。
作者也没给解法,只说这是开放问题。这种诚实的论文不多见。
参考资料
Cited but Unused: Parametric Provenance in Retrieval-Augmented Generation(arXiv 2611.17161)[1] 论文全文(HTML 版)[2]
引用链接
[1]Cited but Unused: Parametric Provenance in Retrieval-Augmented Generation(arXiv 2611.17161): https://arxiv.org/abs/2611.17161
[2]论文全文(HTML 版): https://arxiv.org/html/2611.17161v1