 夜雨聆风
AI CODING · WORKFLOW · 2026
AI编码越写越乱?用「干湿分离」重建工程秩序
探索时尽情发散 · 决策时严格收敛 · 实施时干净落地 · 验证时寸步不让
| 01 | THE PROBLEM问题提出:AI编码为什么越写越乱 |
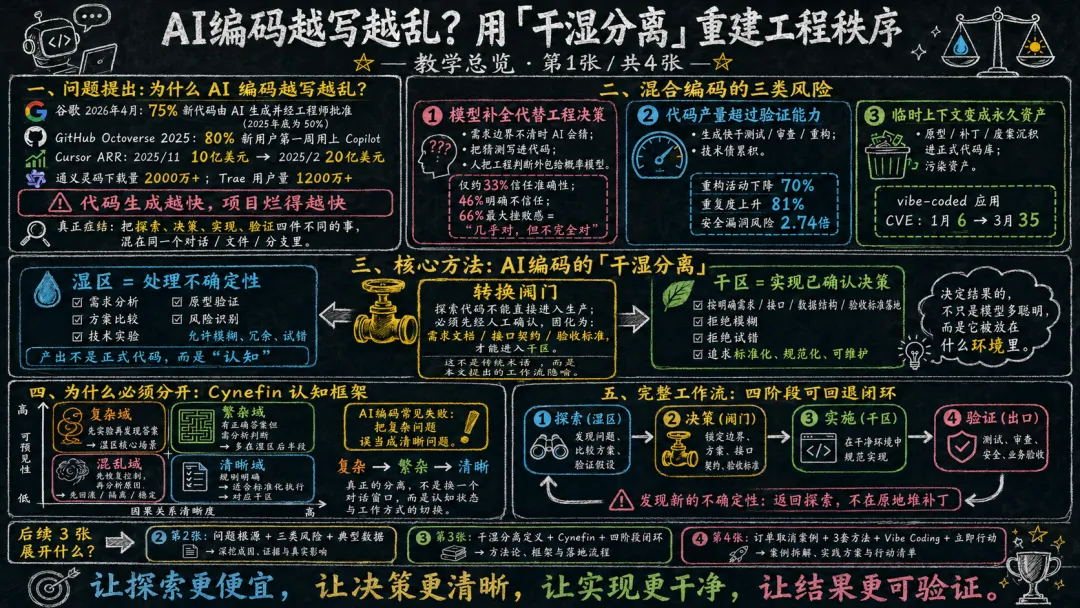
AI生成代码的速度提升是实打实的,先看四组数字:
| 75%谷歌2026年4月披露:新代码由AI生成并经工程师批准,而2025年底还是50%[1] | 80%GitHub Octoverse 2025:新用户第一周就用上 Copilot,平台每秒新增一位开发者[2] |
| $10亿→$20亿Cursor 年化收入:2025年11月至2026年2月,三个月翻倍[3] | 2000万+通义灵码插件下载量;字节 Trae 用户量突破1200万——国内同样爆发[4][5] |
从提速到失控:问题出在哪里
但几乎每个团队都遇到了同样的怪事:代码生成越快,项目烂得越快——改一处崩一片、逻辑前后重复、上下文互相污染、维护成本不降反升,最后只能重构重写。
问题的根源不只是模型能力。真正的症结在于:我们把探索、决策、实现和验证这四件性质完全不同的事,混在了同一个对话、同一个文件、同一个分支里。
本文把解决这个问题的核心方法称为:AI编码的「干湿分离」。在给出定义之前,先看清混合编码究竟会带来什么——具体是三类风险。
混合编码的三类风险THREE RISKS
RISK 01
模型补全代替工程决策
需求和边界不明确时,AI不会说“我不知道”,它会自行猜测业务规则、接口定义和数据结构,把猜测当作事实写进代码。Stack Overflow 2025年度官方调查显示,信任AI工具输出准确性的开发者只有约33%,而明确表示不信任的高达46%;66%的人把“AI方案几乎对、但不完全对”列为最大挫败感来源[3]。用得越多,越不信任——这在技术采纳史上极为罕见。本质上,这是把本该由人做的工程决策,悄悄外包给了概率模型。
RISK 02
代码产量超过验证能力
代码生成速度翻倍了,但测试、审查和重构能力并没有同步提高。GitClear在2026年6月发布的报告分析了2023~2026年间6.23亿次代码变更:与2022年相比,重构活动下降70%,而代码重复度上升81%[6];其2026年1月的研究还发现,重度AI用户产出4~10倍的持久代码,同时制造了9倍于普通开发者的代码“搅动”[6]。安全审计公司CodeRabbit的数据显示,AI协作的Pull Request安全漏洞是人工PR的2.74倍[3]。产量与验证能力之间的缺口,最终都变成了技术债。
RISK 03
临时上下文变成永久资产
原型代码、废弃方案、临时补丁不断沉积在正式项目里,逐渐污染整个代码库——你永远分不清哪段是最终方案、哪段是试错残留。佐治亚理工学院的追踪显示,归因于vibe-coded应用的CVE漏洞,从2026年1月的6个暴增到3月的35个[7]。正如安全公司Aikido创始人的警告:“两个工程师现在能产出过去50个工程师那么多的不安全、不可维护的代码。”[8]
| 02 | THE DEFINITION「干湿分离」的核心定义与理论依据 |
核心定义:湿区、干区与转换阀门
先说明:「干湿分离」是本文提出的工作流隐喻,并非传统软件工程的标准术语。它借用了 DRY / WET 这对经典概念的外衣,描述的是一种新的工作方式。
| WET ZONE / 湿区处理不确定性用于需求分析、方案比较、技术实验、原型验证和风险识别。湿区允许模糊、允许冗余、允许试错,它的产出不是代码,而是认知——验证可行性、排除错误方案、锁定最优逻辑。 | DRY ZONE / 干区实现已确认决策用于按照明确的需求、接口、数据结构和验收条件完成工程实现。干区拒绝模糊、拒绝试错,只做一件事:把已确认的方案标准化、规范化落地。 |
THE GATE / 转换阀门
两个区域绝不直接互通。探索代码不能直接进入生产,必须先经过人工确认,固化为工程决策和规范资产(需求文档、接口契约、验收标准),才能进入干区。
行业共识:2026年的 Harness Engineering 运动
这套思路在2026年已经从个人经验升级为行业共识:HashiCorp联合创始人Mitchell Hashimoto在2026年2月命名了Harness Engineering(驾驭工程)——指套在AI这匹“烈马”身上的约束规则、检测和反馈机制;随后OpenAI发布同名内部实验报告,Martin Fowler亲自为相关深度分析站台,一个月内它成了全球开发者社区的高频词[9]。新共识是:决定AI编码结果的,往往不是模型多聪明,而是模型被放在什么样的环境里。
理论依据:用 Cynefin 框架理解为什么必须分开
「探索」和「生产」不能混在一起,并不只是因为对话太长、代码太乱。更深层的原因是:它们处理的是两种性质不同的问题。
要理解这种差异,可以借助Cynefin认知框架。该框架由Dave Snowden于1999年在IBM提出,2007年经《哈佛商业评论》文章成为管理学主流工具[17]。它把问题所处的情境分为清晰、繁杂、复杂、混乱四类——不同类型的问题,不能使用完全相同的处理方式。软件开发的过程,本质上就是不断识别问题类型、并选择相应工作方式的过程。
清晰域CLEAR → 对应「干区」 规则已经明确,适合标准化执行。这类问题因果关系明确、正确做法已知:按既定模板增加字段、根据接口文档生成客户端代码、按项目规范补充参数校验。处理方式是“感知—分类—响应”:先识别任务属于哪种已知类型,再按已有规范执行。在这个阶段,AI非常适合承担重复性、标准化的实现工作——目标、规则和验收标准都已明确,模型不需要自行猜测业务信息。这对应干湿分离中的干区。 |
繁杂域COMPLICATED → 湿区的后半段 存在正确答案,但需要分析和专业判断。有些问题不是按模板就能完成,但仍存在可以通过分析找到的较优方案:在几种数据库索引方案中选择、分析系统性能瓶颈、决定接口拆分粒度、判断一次重构的影响面。处理方式是“感知—分析—响应”:收集信息、借助专业经验、比较方案后再做决定。AI可以帮助阅读代码、整理依赖、比较技术方案和总结风险,但最终仍需开发者结合真实项目做判断。这部分通常处于湿区的后半段——已经不是完全开放的创意探索,但也还没明确到可以直接进入生产实现。 |
复杂域COMPLEX → 湿区存在的意义 因果关系尚不明确,必须通过实验发现答案。很多AI编码任务在开始时都属于复杂问题:用户真正需要什么还不清楚、新功能会怎样影响旧系统无法判断、第三方接口在真实环境中的表现未知、模型给出的方案要跑起来才知道是否可行。复杂问题没有一开始就能确定的标准答案,Cynefin框架建议“探针—感知—响应”:先做成本可控、“失败了也安全”的小型实验,再根据实验结果决定下一步。这正是湿区存在的意义:同时尝试多种方案、制作最小原型、模拟接口、快速淘汰错误方向。湿区的代码并不一定“质量差”,它只是承担了不同的任务——帮助团队认识问题,而不是直接成为长期维护的生产资产。 |
混乱域CHAOTIC → 先恢复控制,再谈功能 还有一些情况已经不是正常探索,而是进入了混乱状态:生产系统严重故障、多个模块同时报错、AI连续修改后已无法确认哪一版逻辑有效。此时的首要目标不是寻找最优方案,而是“行动—感知—响应”:先回滚版本、隔离故障、恢复稳定,再分析原因。系统已经失控,却继续让AI大范围修改代码,通常只会引入更多变量,让问题更难定位。因此干湿分离还包含一条容易被忽视的原则:当项目进入混乱状态时,先恢复可观察、可回退的稳定环境,再重新进入探索阶段。 |
核心诊断:把复杂问题误当成清晰问题
回看很多失败的AI编码过程,会发现路径惊人地相似:需求仍然模糊、技术风险尚未确认,开发者却直接要求AI生成完整代码;AI根据不完整的上下文自行补全;运行后不断发现新的边界问题;团队继续在已有代码上叠加补丁。问题不在于AI没有生成代码,而在于团队使用了处理清晰问题的方式,去处理一个仍然复杂的问题——原本应该通过实验发现的答案,被模型的概率补全暂时代替了;原本应该经过分析做出的决策,被隐藏在了生成代码之中。
因此,AI编码并不是把代码从湿区简单地“搬运”到干区。更准确的过程是:
先用实验理解问题,再用分析确定方案,最后把已经明确的问题交给AI工程化实现。
回看转换阀门:判断的是认知状态,不是代码量
用Cynefin框架回看「转换阀门」,会发现它真正判断的,不是代码写了多少,也不是原型能不能运行,而是:这个问题是否已经从需要探索的复杂状态,转化为可以执行的清晰状态?如果核心需求仍有重大歧义、关键技术假设还没经过实验、候选方案还没完成比较,就说明任务仍处于复杂域或繁杂域——此时最应该做的不是让AI继续生成更多生产代码,而是继续实验和分析。这也解释了为什么干湿分离不能只是“换一个对话窗口”:真正的分离不是界面上的分离,而是认知状态和工作方式的切换。
| 03 | THE WORKFLOW完整工作流:四阶段可回退闭环 |
四个阶段,加上一条回退路径
干湿分离落地为一个四阶段闭环:
| 1 | 探索(湿区)EXPLORE 发现问题、比较方案、验证假设。允许多方案并行,允许快速试错。 |
▼
| 2 | 决策(阀门)DECIDE 确定需求边界、技术方案、接口契约和验收标准。这是从湿到干的唯一通道,缺一项都不放行。 |
▼
| 3 | 实施(干区)IMPLEMENT 在独立、干净的环境中完成代码、测试和规范化实现,严格依据决策阶段固化的材料。 |
▼
| 4 | 验证(干区出口)VERIFY 进行测试、审查、安全和业务验收,全部通过才算完成。 |
KEY POINT / 关键的第五点验证或实施中发现新的不确定性时,返回探索阶段重新处理,而不是在原地继续堆补丁。补丁堆砌正是“屎山”的形成机制;可回退的闭环,才能让系统长期保持干净。
为什么流程比模型更重要
OpenAI在2026年2月发布的Harness Engineering实践报告可以佐证这个分工的价值:模型能力之外,环境、上下文、工具和反馈机制同样会显著影响Agent的可靠性——该团队甚至估计,在搭建好这套环境之后,开发时间约仅为手写代码的十分之一[10]。把四阶段边界建清楚,比换更强的模型更能决定结果。
案例:为订单系统增加「取消订单」功能
用一个常见需求完整走一遍这个闭环。
✕错误做法:直接让AI改代码
第一轮AI写出基础取消逻辑;测试发现已支付订单没处理退款,追问补上;又发现库存没回滚,再补;接着优惠券返还、并发重复取消、取消中的订单被履约……问题此起彼伏,补丁越堆越高,代码里新旧逻辑交错,最后没人说得清取消一个订单到底会触发什么。
①湿区先梳理
正确的第一步是不写任何正式代码,先让AI(在探索模式下)协助梳理:订单有哪些状态、取消发生在哪些状态之间;涉及哪些外部依赖(支付网关、库存服务、优惠券系统、消息通知);有哪些异常场景(重复取消、取消与履约并发、部分退款失败)。
②通过转换阀门
把湿区的产出固化为工程决策:一张明确的订单状态机(哪些状态可取消、迁移方向);幂等规则(同一取消请求重复到达如何处理);补偿机制(退款、回滚库存、返还优惠券的顺序与失败重试策略);以及一组可测试的验收用例。清单确认无误,才进入干区。
③干区重新实现
开启干净的新对话、新分支,把状态机、幂等规则、补偿机制和验收用例作为输入,让AI严格按此生成正式实现——代码、注释、参数校验、测试用例一次成型。
④新问题回退探索
测试中如果发现新的边界场景(比如“发货后取消”需要拦截物流而不是退款),不就地打补丁,而是带着问题回到湿区重新梳理,更新决策材料,再回到干区实施。
同样的需求,前者越改越崩,后者一次成型、长期可维护——差别不在AI,在流程。
| 04 | THREE METHODS三套可直接执行的方法 |
METHOD 01
给AI设置两种工作模式
探索模式只分析方案和风险,明确“不写代码、不做定稿”;实施模式严格依据已确认材料编码,明确“不做方案变更、不引入新假设”。这个思路在2026年已经产品化:Karpathy开源的autoresearch项目(21K Star)中,人类只写一个program.md规则文件,AI据此自主行动[11];字节Trae 2.0的SOLO架构同样把“先方案确认、后代码生成”做成了默认流程[5]。
METHOD 02
建立转换确认清单
湿区内容进入干区前,逐项检查:需求边界是否明确、方案是否完成对比筛选、接口契约是否统一、状态与异常是否覆盖、安全要求是否列入、验收测试条件是否可执行。全部通过,才允许生成正式代码——这一步能规避大部分后续返工。
METHOD 03
物理隔离探索与生产
用独立对话、临时目录、开发分支或git worktree隔离探索与生产,坚决不在同一个对话里先试错再定稿。隔离的价值有两组2026年对照实验作证:LangChain的编码agent仅优化运行环境(不改模型一个参数),基准测试排名从全球第30跃升至第5;一位研究员仅改变Agent的代码编辑格式,某模型得分就从6.7%跃升至68.3%[9]。同一个模型,放在不同的环境里,表现天差地别。
国内团队的落地验证
国内头部团队已经跑通了这套流程:一汽集团90%研发人员启用通义灵码,AI代码占比25%,研发效率提升14%[4];喜马拉雅实测CodeBuddy代码采纳率44%[12]。共同点不是“让AI多写代码”,而是把AI嵌进了一套有边界、有阀门的工程流程。
| 05 | VIBE CODING重新理解 Vibe Coding |
“你完全沉浸于感觉,拥抱指数级增长,甚至忘记代码的存在。”
—— Andrej Karpathy,2025年2月创造 “vibe coding” 一词[13]
Vibe Coding 有它的正当场景
需要客观地说:Vibe Coding有它的正当场景——原型、实验、内部工具、快速验证。在这些场景里,速度就是正义,“忘记代码存在”反而是一种解放。
真正的风险:把实验代码直接当生产代码
问题从来不在于使用Vibe Coding,而在于把实验代码直接当作生产代码。2026年2月的Moltbook事件是代价最直观的注脚:一个完全由vibe coding建成、创始人“没写过一行代码”的网站,上线即被发现数据库完全公开,泄露150万个密钥和3.5万个用户邮箱[14]。
连命名者本人都转向了
连Karpathy本人都在2026年2月宣布vibe coding“已经过时”,转而提出agentic engineering——“既要从agent获得杠杆,又不在软件质量上做任何妥协”[15]。他在Sequoia Ascent 2026大会上的总结更直白:“vibe coding抬高的是下限,agentic engineering抬高的才是上限。你不被允许因为vibe coding而引入漏洞——你和以前一样,仍然要为自己的软件负责。”[16]
所以核心观点是:
“
把 Vibe Coding 留在湿区,把工程责任带进干区。
| 06 | TAKEAWAYS总结:三个立即可以开始的改变 |
| 1 | 编码前先判断当前处于探索还是实施阶段 方案不确定就是探索,方案已锁定就是实施,绝不混合推进。 |
| 2 | 让AI先输出需求边界、风险清单、接口契约和验收用例 在拿到任何代码之前,先拿到这些“决策材料”——它们才是从湿区进入干区的通行证。 |
| 3 | 将测试、审查和业务验收作为真正的完成标准 代码生成完毕不等于工作完成;通过验证,才算完成。 |
结语
AI编码的关键,不只是提高生成速度,而是建立明确的阶段边界:探索时尽情发散,决策时严格收敛,实施时干净落地,验证时寸步不让。
“
让探索更便宜,让决策更清晰,让实现更干净,让结果更可验证。
AI只是工具,混乱的从来不是工具,而是不加约束的使用方式。建好干湿分离的四阶段闭环,AI才会从烂代码制造机,变成真正的工程杠杆。
参考资料 REFERENCES
注:公众号正文不支持外链跳转,以上来源名称可供检索查证。
· END ·