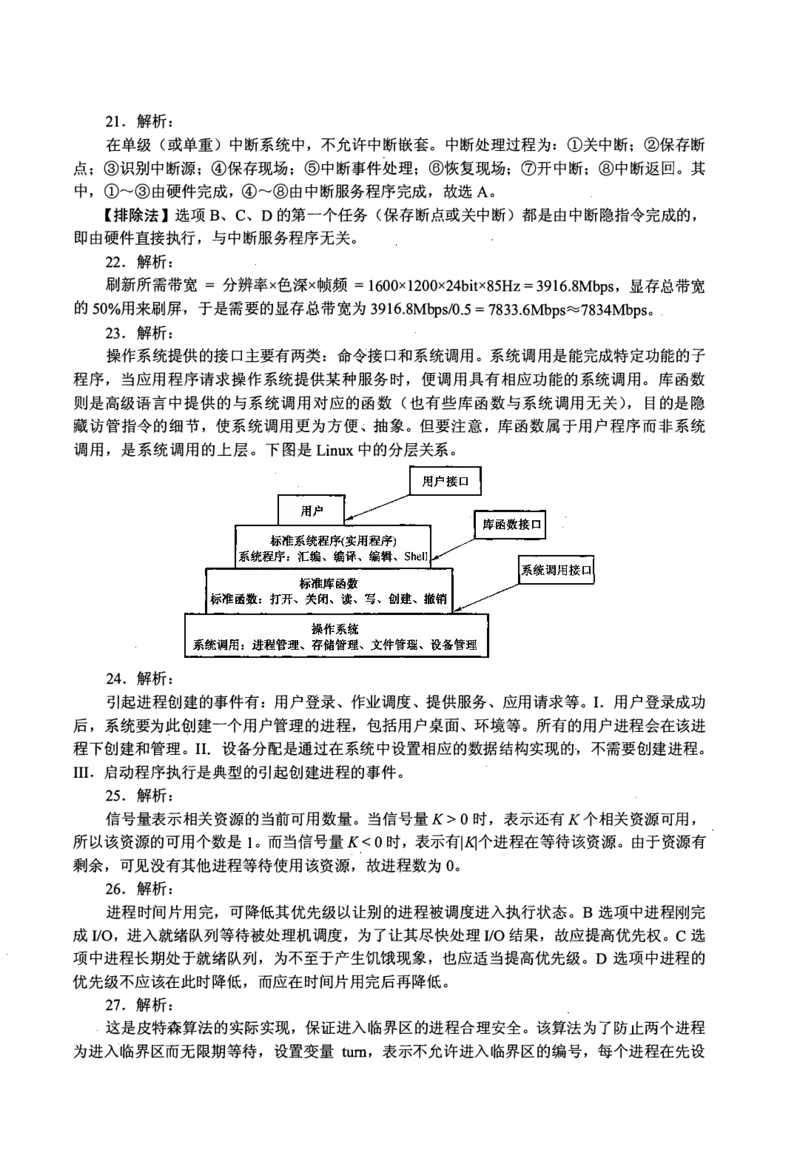
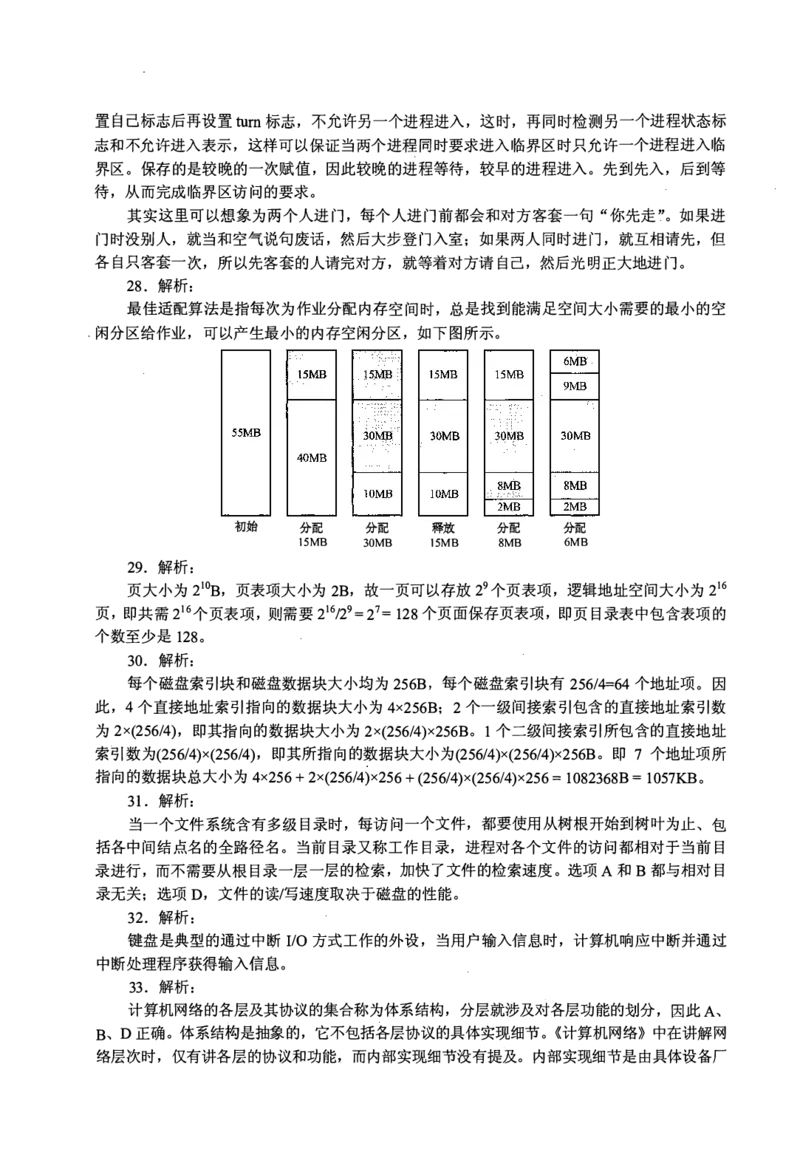
2010 年计算机学科专业基础综合试题参考答案
一、单项选择题
DBDBCC DBACD AADDC DDBCB BABBA BDCDC DACAB ACBA
1. 2. 3. 4. 5. 6. 7. 8.
9. 10. 11. 12. 13. 14. 15. 16.
17. 18. 19. 20. 21. 22. 23. 24.
25. 26. 27. 28. 29. 30. 31. 32.
33. 34. 35. 36. 37. 38. 39. 40.
1. 解析:
选项 A可由 in, in, in, in, out, out, in, out, out, in, out, out得到;选项 B 可由 in, in, in, out, out,
in, out, out, in, out, in, out得到;选项 C 可由 in, in, out, in, out, out, in, in, out, in, out, out 得到;选
项D可由in, out, in, in, in, in, in, out, out, out, out, out得到,但题意要求不允许连续三次退栈操作,
故 D 不可能得到。
【另解】先进栈的元素后出栈,进栈顺序为 a,b, c, d, e, f, 故连续出栈时的序列必然是按字
母表逆序的,若出栈序列中出现了长度大千等于 3 的连续逆序子序列,则为不符合要求的出栈
序列。
2. 解析:
本题的队列实际上是一个输出受限的双端队列。 A 操作: a 左入(或右入)、 b 左入、 c 右
入、 d 右入、 e 右入。 B 操作: a 左入(或右入)、 b 左入、 c 右入、 d 左入、 e 右入。 D 操作: a
左入(或右入)、 b 左入、 c左入、 d右入、 e左入。 C操作: a左入(或右入)、 b 右入、因 d 未
出,此时只能进队, c 怎么进都不可能在b 和 a之间。
【另解】初始时队列为空,第 1 个元素 a左入(或右入),而第 2 个元素 b 无论是左入还是
右入都必与 a相邻,而选项 D 中 a与 b 不相邻,不合题意。
3. 解析:
题中所给二叉树的后序序列为 d, b, c, a。结点 d无前驱和左子树,左链域空,无右子树,
右链域指向其后继结点 b; 结点 b 无左子树,左链域指向其前驱结点 d; 结点 c 无左子树,左链
域指向其前驱结点 b, 无右子树,右链域指向其后继结点 a。故选 D。
4. 解析:
插入 48 以后,该二叉树根结点的平衡因子由-1 变为-2, 在最小不平衡子树根结点的右子
树 CR) 的左子树 (L) 中插入新结点引起的不平衡属千 RL 型平衡旋转,需要做两次旋转操作
(先右旋后左旋)。
今
24
13 90
调整后,关键字 37 所在结点的左、右子结点中保存的关键字分别是 24、 53。5. 解析:
设树中度为i Ci=O, 1,2,3,4)的结点数分别为N;, 树中结点总数为N, 则树中各结点的度
。
之和等于N-1, 即N= 1 + N 1 + 2N 2 +3 N 3 + 4N4 = Ni+N尸岛+N 3 + N4, 根据题设中的数据, 即
可得到N。=82, 即树 T的叶结点的个数是82。
6. 解析:
哈夫曼树为带权路径长度最小的二叉树, 不一定是完全二叉树。哈夫曼树中没有度为1的
结点,B正确;构造哈夫曼树时, 最先选取两个权值最小的结点作为左、右子树构造一棵新的
二叉树,C正确;哈夫曼树中任一非叶结点P的权值为其左、右子树根结点权值之和, 其权值
不小千其左、右子树根结点的权值, 在与结点P的左、右子树根结点处于同一层的结点中,若
存在权值大于结点P权值的结点Q, 则结点Q的兄弟结点中权值较小的一个应该与结点P作为
左、右子树构造新的二叉树。 综上可知,哈夫曼树中任一非叶结点的权值一定不小千下一层
任一结点的权值。
7. 解析:
要保证无向图G在任何情况下都是连通的,即任意变动图G中的边,G始终保待连通,首
先需要G的任意6个结点构成完全连通子图GI, 需nn( -1)/2= 6x( 6-1)/2 = 15条边, 然后再添
一条边将第7个结点与Gl连接起来, 共需16条边。
8. 解析:
拓扑排序的过程如下图所示。
勹
三二
输出e 输妙, 出b
©�0---,
三 出b 输出 。 输 出c
衫
:
三出'�输出c输:
0 © ©
输出d,得到aebcd 输出d,得到abecd 输出d,得到abced
可以得到3个不同的拓扑序列, 分别为abced、abecd、aebcd。
9. 解析:
折半查找法在查找成功时进行的关键字比较次数最多为Llog 刓+1, 即判定树的高度;折半
2
查找法在查找不成功时进行的关键字比较次数最多为l1ogn」+ 1。 题中n= 16, 因此最多比较
2
L1og t6」+1=5次。 也可以画出草图求解。
2
思考:若本题题干改为求最少的比较次数呢?
10. 解析:
快递排序的递归次数与元素的初始排列有关。若每次划分后分区比较平衡,则递归次数少;
若划分后分区不平衡, 则递归次数多。但快速排序的递归次数与分区处理顺序无关, 即先处理
较长的分区或先处理较短的分区都不影响递归次数。
此外,可以形象地把快速排序的递归调用过程用一个二叉树描述,先处理较长或较短分区,可以想象为交换某一递归结点处的左右子树,这并 不会影响树中的分支数 。
11. 解析:
题中所给的三趟排序过程中,每一趟排序是从前往后依次比较,使最大值 “ 沉底 ” ,符合
冒泡排序的特点 。
看第一趟可知仅有88被移到最后。
• 如果是希尔排序,则12,88, 10应变为10,12, 88。 因此排除希尔排序。
• 如果是归并排序,则长度为2 的子序列是有序的。 因此 可排除归并排序。
• 如果是基数排序,则16,5, 10应变为10,5, 16。 因此排除基数排序。
提示:对于此 类题,先看备选项的排序算法有什么特征,再看题目中的排序过程是否符合
这一特征,从而得出答案。 一般先从选项中的简单排序方法(插入排序、起泡排序、选择排序)
开始判断,若简单排序方法不符合,再判断排序方法(希尔排序、快速排序、堆排序、归并排
序)。
12. 解析:
CPU时钟频率(主频)越高,完成指令的一个执行步骤所用的时间就越短,执行指令的速
度越快,I正确。 数据通路的功能是实现CPU内部的运算器和寄存器以及寄存器之间的数据交
换,优化数据通路结构,可以有效提高计算机系统的吞吐量,从而加快程序的执行,II正确。
计算机程序需要先转化成机器指令序列才能最终得到执行,通过对程序进行编译优化可以得到
更优的指令序列,从而使得程序的执行时间也越短,III正确。
【另解】定量分析:CPU执行时间=(程序指令条数x每条指令时钟周期数)/时钟频率。提
高时钟频率显然可以缩短CPU执行时间;编译优化可能减少程序的指令数或优化指令结构;优
化数据通路结构可能减少时钟周期,即提高时钟频率,故选D。
13. 解析:
本题的真正意图是考查补码的表示范围,而不是补码的乘法运算。 若采用补码乘法规则计
算出4个选项,是费力不讨好的做法,而且极容易出错。
8位补码所能表示的整数范围为-128�+12兀将4个数全部转换为十进制:rl =-2,r2=-14,
r3 = -112, r4 = -8, 得r2xr3 = 1568, 远超出了表示范围,发生溢出。
【提示】解题时,尤其是对于这种看似很复杂的题,不要轻易动笔,要弄清题目考查的真
正意图,而尽可能地 “ 走捷径 ” ,以免绕进命题者设计的 “ 死胡同 ” 。
14. 解析:
题中三种数据类型的精度从低到高为int-float-double, 从低到高的转换通常可以保持其
值不变,I 和III正确,而从高到低的转换可能会有数据的舍入,从而损失精度。 对于II, 先将
float型的f转换为int型,小数点后的数位丢失,故其结果不为真。 对于IV, 初看似乎没有问
o,
题,但浮点运算d+f时需要对阶 ,对阶后f的尾数有效位被舍去而变为 故d+f仍然为d,
o,
再减去d后结果为 故IV结果不为真。
此外,根据不同类型数据混合运算的 ” 类型提升 ” 原则,在IV中,等号左端的类型为double
型,结果不为真。
15. 解析:
用2Kx4位的芯片组成一个8Kx8位存储器,共需8片2Kx4位的芯片,分为4 组,每组由
2片2Kx4位的芯片并联组成2Kx8位的芯片,各组芯片的地址分配如下:
第一组(2个芯片并联): OOOOH�07FFH。
第二组(2个芯片并联):0800H�OFFFH。第三组(2个芯片并 联): 1O OOH-17FFH。
第四组(2个芯片并 联): 1800H-IFFFH。
地址OBIFH所在的芯片属于第二组,故其所在 芯片的最小地址为0800H。
16. 解析:
RAM( 分为DRAM和SRAM)断电后会失去信息,而ROM断电后不会丢失信息,它们
都采用 随机存取方式(注意,采用随机存取方式的存储器并不一定就是随机存储器)。 Cache一
般采用高速的SRAM制成,而ROM只可读,不能用作 Cache, III错误。DRAM需要定期刷新,
而ROM不需要刷新,故IV错误。
17. 解析:
Cache中存放的是主存的一部分副本,TLB(快表)中存放的是Page(页表)的一部分副本。在
同时具有虚拟页式存储器(有TLB)和Cache的系统中,CPU发出访存命令,先查找对应的
Cache块。
1)若Cache命中,则说明所需内容在 Cache 内, 其所在页面必然已调入主存,因此Page
必然命中,但TLB不一定命中。
2)若Cache不命中,并不能说明所需 内容未调入主存,和TLB、Page命中与否没有联 系。
但若TLB命中,Page也必然命中;而当Page命中,TLB则未必命中,故D不可能发生。
主存、Cache、TLB和Page的关 系如下图所示。
芦_尸尸三]
【提示】本题看似既涉及虚拟存储器又涉及Cache, 实际上这里并不需要考虑Cache命中与
否。 因为一旦缺页,说明信息不在主存, 那么TLB 中就一定没有该页表项,所以不存在TLB
命中、Page缺失的情况,也根本谈不上访问 Cache 是否命中。
18. 解析:
读者首先必须明白 “ 汇编语言程序员可见 ” 的含义,即汇编语言程序员通过汇编程序可以
对某个寄存器进行访问。 汇编程序员可以通过指定待执行指令的地址来设置PC的值,如转移
指令、子程序调用指令等。 而IR、MAR、MDR 是CPU的内部工作 寄存器,程序员无法直接获
取和设置它们的值,也无法直接对它们进行 其他 操作,所以对程序员不可见。
【提示】@指令寄存器 IR中的内容总是根据PC所取出的指令代码。@在CPU的专用 寄存
器中,只有PC和PSWR是汇编程序员可见的。
19. 解析:
采用流水线方式,相邻或相近的两条指令可能会因为存在某种关 联,后一条指令不能按照
原指定的时钟周期运行,从而使流水线断流。有三种相关可能引起指令流水线阻塞:@结构相
关,又称资源相关;@数据相关;@控制相关,主要由转移指令引起。
数据旁路技术,其 主要思想是不必待某条指令的执行结果送回到寄存器,再从寄存器中取
出该结果,作为下一条指令的源操作数,而是直接将执行结果送到其他指令所需要的地方,这
样可以使流水线不发生停顿。
20. 解析:
典型的总线标准有: ISA、EISA、VESA、PCI、PCI-Express、AGP、USB、RS-232C等。
A中的CRT是纯平显示器;B中的CPI 是每条指令的时钟周期数;C中的RAM 是半导体随机
存储器、MIPS是每秒执行多少百万条指令数。21. 解析:
在单级(或单重) 中断系统中, 不允许中断嵌套。中断处理过程为:@关中断;@保存断
点;@识别中断源;@保存现场;@中断事件处理;@恢复现场;@开中断;@中断返回。其
中, @~@由硬件完成,@~@由中断服务程序完成, 故选A。
【排除法】选项B、C、D的第一个任务(保存断点或关中断)都是由中断隐指令完成的,
即由硬件直接执行, 与中断服务程序无关。
22. 解析:
刷新所需带宽=分辨率x色深X帧频=1600x1 200x24bitx85Hz= 3916.SMbps, 显存总带宽
的50%用来刷屏, 于是需要的显存总带宽为3916.SMbps/0.5= 7833.6Mbps:=:::: 飞34Mbps。
23. 解析:
操作系统提供的接口主要有两类:命令接口和系统调用。系统调用是能完成特定功能的子
程序,当应用程序请求操作系统提供某种服务时, 便调用具有相应功能的系统调用。库函数
则是高级语言中提供的与系统调用对应的函数(也有些库函数与系统调用无关), 目的是隐
藏访管指令的细节,使系统调用更为方便、抽象。但要注意,库函数属千用户程序而非系统
调用, 是系统调用的上层。下图是Linux中的分层关系。
24. 解析:
引起进程创建的事件有:用户登录、作业调度、提供服务、应用请求等。I. 用户登录成功
后, 系统要为此创建一个用户管理的进程, 包括用户桌面、环境等。所有的用户进程会在该进
程下创建和管理。II. 设备分配是通过在系统中设置相应的数据结构实现的, 不需要创建进程。
III. 启动程序执行是典型的引起创建进程的事件。
25. 解析:
信号量表示相关资源的当前可用数量。当信号量K>O时,表示还有K个相关资源可用,
所以该资源的可用个数是1。而当信号量K<O时,表示有[K]个进程在等待该资源。由于资源有
剩余, 可见没有其他进程等待使用该资源, 故进程数为0。
26. 解析:
进程时间片用完, 可降低其优先级以让别的进程被调度进入执行状态。B选项中进程刚完
成1/0, 进入就绪队列等待被处理机调度,为了让其尽快处理1/0结果, 故应提高优先权。 C选
项中进程长期处于就绪队列, 为不至于产生饥饿现象,也应适当提高优先级。D选项中进程的
优先级不应该在此时降低, 而应在时间片用完后再降低。
27. 解析:
这是皮特森算法的实际实现, 保证进入临界区的进程合理安全。该算法为了防止两个进程
为进入临界区而无限期等待, 设置变量turn, 表示不允许进入临界区的编号, 每个进程在先设置自己标志后再设置tum标志,不允许另一个进程进入,这时,再同时检测另一个进程状态标
志和不允许进入表示,这样可以保证当两个进程同时要求进入临界区时只允许一个进程进入临
界区。保存的是较晚的一次赋值,因此较晚的进程等待,较早的进程进入。 先到先入,后到等
待, 从而完成临界区访问 的要求。
其实这里可以想象为两个人进门,每个人进门前都会和对方客套一句 “ 你先走 ” 。如果进
门时没别人,就当和空气说句废话,然后大步登门入室;如果两人同时进门,就互相请先,但
各自只客套一次,所以先客套的人请完对方,就等着对方请自己,然后光明正大地进门。
28. 解析:
最佳适配算法是指每次为作业分配内存空间时,总是找到能满足空间大小需要的最小的空
闲分区给作业,可以产生最小的内存空闲分区,如下图所示。
初始 分配 分配 释放 分配 分配
15MB 30MB 15MB 8MB 6MB
29. 解析:
页大小为i0B, 页表项大小为2B, 故一页可以存放29个页表项,逻辑地址空间大小为i6
页,即共需i6个页表项,则需要i6l29=27=128个页面保存页表项,即页目录表中包含表项的
个数至少是128。
30. 解析:
每个磁盘索引块和磁盘数据块大小均为256B, 每个磁盘索引块有256/4=64个地址项。因
此,4个直接地址索引指向的数据块大小为4x256B; 2个一级间接索引包含的直接地址索引数
为2x(256/4), 即其指向的数据块大小为2x(256/4)x256B。1个二级间接索引所包含的直接地址
索引数为(256/4)x(256/4), 即其所指向的数据块大小为(256/4)x(256/4)x256B。即7个地址项所
指向的数据块总大小为4x256+ 2x(256/4)x256 + (256/4)x(256/4)x256 = 1082368B = 1057KB。
31. 解析:
当一个文件系统含有多级目录时,每访问一个文件,都要使用从树根开始到树叶为止、包
括各中间结点名的全路径名。当前目录又称工作目录,进程对各个文件的访问都相对于当前目
录进行,而不需要从根目录一层一层的检索,加快了文件的检索速度。选项A和B都与相对目
录无关;选项D, 文件的读/写速度取决于磁盘的性能。
32. 解析:
键盘是典型的通过中断1/0方式工作的外设,当用户输入信息时,计算机响应中断并通过
中断处理程序获得输入信息。
33. 解析:
计算机网络的各层及其协议的集合称为体系结构,分层就涉及对各层功能的划分,因此A、
B、D正确。体系结构是抽象的,它不包括各层协议的具体实现细节。《计算机网络》中在讲解网
络层次时,仅有讲各层的协议和功能,而内部实现细节没有提及。内部实现细节是由具体设备厂家来确定的。
34. 解析:
分组大小为IOOOB, 其中分组头大小为20B, 则分组携带的数据大小为980B, 文件长度为
980000B, 需拆分为1000个分组,加上头部后,每个分组大小为IOOOB, 总共需要传送的数据
量大小为1MB。由于所有链路的数据传输速度相同,因此文件传输经过最短路径时所需时间最
少,最短路径经过2个分组交换机。
当t= 1Mx8/(100Mbps) = 80ms时,HI发送完最后一个比特。
当Hl发送完最后一个分组时,该分组需要经过2个分组交换机的转发,在 2次转发完成
后,所有分组均到达H2。每次转发的时间为t 0=1Kx8/(100Mbps)= 0 .08ms。
所以,在不考虑分组拆装时间和传播延迟的情况下,当t= 80ms + 2t
0
= 80.16ms时,H2接
收完文件,即所需的时间至少为80.16ms。
35. 解析:
RI在收到信息并更新路由表后,若需要经过R2到达netl, 则 其跳数为17, 由于距离为
16表示不可达,因此Rl不能经过R2到达netl, R2也不可能到达netl。B、C错误,D正确。
而题目中并未给出Rl 向R2发送的信息,因此A也不正确。
36: 解析:
ICMP差错报告报文有5种:终点不可达、源点抑制、时间超过、参数问题、改变路由(重
定向),其中源点抑制是当路由器或主机由于拥塞而丢弃数据报时,就向源点发送源点抑制报文,
使源点 知道应当把数据报的发送速率放慢。
37. 解析:
由于该网络的IP地址为192.168.5.0/24, 网络号为前24位,后8位 为子网号+主机号。 子
网掩码为255 .25 5 .25 5 .248, 第4个字节 248转换成二进制为11111000, 因此后8位中,前5位
用于 子网号,在CIDR中可以表示25 =32个子网;后3位用于主机号,除去全0和全l的情况,
可以表示i-2=6个主机地址。
38. 解析:
中继器和集线器工作在物理层,既不隔离冲突域也不隔离广播域。为了解决冲突域的问题,
人们利用网桥和交换机来分隔互联网的各个网段中的通信量,建立多个分离的冲突域,但当网
桥和交换机接收到一个未知转发信息的数据帧时,为了保证该帧能被目的结点正确接收,将该
帧从所有的端口广播出去,可以看出网桥和交换机的冲突域等于端口个数,广播域为1。路由
器工作在网络层,既隔离冲突域,也隔离广播域。
【提示】广播风暴产生于网络层,因此只有网络层设备才能抑制。链路层设备和物理层设
备对网络层的数据包是透明传输,对是否为广播报文是不可知的。
39. 解析:
发送方的发送窗口的上限值取接收方窗口和拥塞窗口这两个值中较小的一个,于是此时发
送方的发送窗口 为min{4000, 2000} = 2000B。由于发送方还没有收到第二个最大段的确认, 所
以此时甲还可以向乙发送的最大字节数为2000-1000= IOOOB。
40. 解析:
当采用递归查询时,如果主机所询问的本地域名服务器不知道被查询域名的IP地址,那
么本地域名服务器 就以DNS客户的身份,向 其他根域名服务器继续发出查询请求报文,而不
是让该主机自已进行下一步的查询。因此,这种方法用户主机和本地域名服务器发送的域名请
求条数均为1条。因此选A。二、 综合应用题
41. 解答:
1)由装载因子为0.7, 数据总数为 7, 得一维数组大小为 7/0.7= 10, 数组下标为0�9。所
构造的散列函数值见下表。
三
7 8 30 11 18 9 14
- - - 一 - -
0 3 6 5 5 6 0
采用线性探测再散列法处理冲突, 所构造的散列表见下表。
: I : I I I I
三
O 2 8 9
- :,。 -
7 4 ;I I: 9
2)查找成功时, 是根据每个元素查找次数来计算平均长度的, 在等概率的情况下, 各关
键字的查找次数见下表。
key 7 8 30 11 18 9 14
- -
次数 3 3 2
ASL成功 = 查找次数/元素个数=(1 + 2 + 1 + 1 + 1 + 3 + 3)/7= 12/7。
这里要特别防止惯性思维。 查找失败时,是根据查找失败位置计算平均次数, 根据散列函
数mod 7, 初始只可能在o�6的位置。 等概率情况下,查找0�6位置查找失败的查找次数见
下表。
H::'I: I: I: I: I: I:
6
4
ASL不成功 = 查找次数I散列后的地址个数=(3 + 2 + 1 + 2 + 1 + 5 + 4)/7= 18/7。
42. 解答:
1)算法的基本设计思想:
可以将这个问题视为把数组ab转换成数组ba Ca代表数组的前p个元素,b 代表数组中余
下的n-p个元素), 先将a逆置得到a-1b, 再将 b逆置得到a-1矿, 最后将整个a-1矿逆置得到
(a-1b -1r=1 ba。设Reverse函数执行将数组元素逆置的操作,对abcdefgh向左循环移动3 (p= 3)
个位置的过程如下:
Reverse(O,p一1)得到cbadefgh;
Reverse(p,n-1)得到cbahgfed;
Reverse(O,n一1)得到defghabc。
注: Reverse中, 两个参数分别表示数组中待转换元素的始末位置。
2) 使用C 语言描述算法如下:
void Reverse(int R[],int from,int 七o)
inti, 七emp;
for(i=O;i<(to-from+l)/2;i++)
{ ·t!:iinp=R[from+i] ;R[from+i]=R[to-i],;R[七o-i]=temp;}
}//Reverse
void Converse(intR[],int n,int p) {
Reverse (R, 0, p-1);
Reverse(R,p,n-1);
Reverse(R,0,n一1);3)上述算法中3个Reverse函数的时间复杂度分别为O(p/2)、O((n-p)/2)和O(n/2), 故所设
计的算法的时间复杂度为O(n), 空间复杂度为0(1)。
【另解】借助辅助数组来实现。
s,
算法思想:创建大小为p的辅助数组 将R中前p个整数依次暂存在S中 ,同时将R中
后n-p个整数左移,然后将S中暂存的p个数依次放回到R中的后续单元。
时间复杂度为O(n), 空间复杂度为O(p)。
43. 解答:
1) 操作码占4位,则该指令系统最多可有24= 16条指令。操作数占6位,其中寻址方式占3
位、寄存器编号占3位,因此该机最多有z3=8个通用寄存器。主存地址空间大小为128KB, 按字编
址,字长为16位,共有128KB/2B= 216个存储单元 ,因此MAl皂巨少为16位;因为字长为16位,
故MDR至少为16位。
2)寄存器字长为16位,PC和Rn可表示的地址范围均为o-2'6-I, 而主存地址空间为z16,
故转移指令的目标地址范围为OOOOH-FFFFH (0-216-1)。
3)汇编语句"add(R4), {RS)+", 对应的机器码为
字段 OP Ms Rs Md Rd
__ - -
内容 0010 001 100 010 101
• 一 ', - -
说明 add 寄存器间接 即 寄存器间接、自增 RS
将对应的机器码写成十六进制形式为00100011 0001 0101B = 2315H。
该指令的功能是将R4的内容所指存储单元的数据与R5的内容所指存储单元的数据相加,并
将结果送入R5的内容所指存储单元中。(R4)= 1234H, (1234H) = 5678H; (RS)= 5678H, (5678H) =
1234H: 执行加法操作5678H+ 1234H = 68ACH, 之后RS自增。
该指令执行后,RS和存储单元5678H的内容会改变 ,RS的内容从5678H变为5679H, 存
储单元 5678H中的内容变为该指令的计 算结果68ACH。
【注意】第3问中两个操作数的存储地址和数值有点令人晕头, 请读者务必保持清醒。
44. 解答:
1)每个Cache行对应一个标记项,如下图所示。
I 1 I I
有效位 脏位 替换控制位 标记位
不考虑用于Cache一致性维护和替换算法的控制位。地址总长度为28位(228=256M)
块内地址6位(26=64) , Cache块号3位(23=8)' 故Tag的位数为28-6:-3= 19位,还需使
用一个有效位,故题中数据Cache行的结构如下图所示。
口 I
19bit 64B=512bit
I I
』
标记位
该行对应的标记项 每行存储的数据
数据Cache共有8行,因此数据Cache的总容量为8x(64+ 20/8)B = 532B。
2) 数组a在主存的 存放位置及其 与Cache之 间的映射关系如下图所示。行号
。
320 '',
6 , , ' 一 , : , 一 一 , ' ' , , 、 、 , , ' - 一 , ' ,} , Y 一 ' , -Z 一 、 , , 夕, , - 夕 , ' 一 - , - z , _ , }/ , ' , ' 、 , 一 之 , - - z '
-
7
Cache
数组按行优先方式存放,首地址为320, 数组元素占4字节。a[0][31]所在的主存块对应的
Cache行号为(320 + 3Ix4)/64 = 6; a[l][l]所在的 主存块对应的Cache行号为(320 + 256x4 +
Ix4)/64 % 8 =5 。
【另解】由1)可知主存和Cache的地址格式如下图所示。
27 8 6 5 0
主存地址I 标记 1块号1块内地址I
8 6 5
Cache地址1块号1块内地址I
数组按行优先方式存放,首地址320,数组元素占4字节。a[0][31] 的地址为320 + 31x4 =1
10111100B, 故其对应的 Cache行号为llOB =6 ; a[l][l]的地址为320 + 256x4 + 1 x4 =1 348 =1 01
0100 OIOOB, 故其对应的Cache行号为101B=5 。
3)数组a 的大小为256x256x4B=2 18B, 占用 i8!64=i 2个主存块, 按行优先存放, 程序
A逐行访问数组a, 共需访问 的次数为i6 次 , 未命中次数为i12 次(即每个字块的第一个数未
命中),因此程序A的命中率为(i6-i2)!i6x100%= 93.75%。
【另解】数组a 按行存放, 程序A按行存取。 每个字块中存放16个int型数据, 除访问 的
第一个不命中 ,随后的15个全都命中,访问全部字块都符合这一规律,且数组大小为字块大小
的整数倍, 故程序A的命中率为15/16= 93.75%。
程序B逐列访问数组a, Cache总容量为64Bx8= 512B, 数组a 一行的大小为1KB, 正好
是Cache容量的2倍, 可知不同行 的同一列数组元素使用的是同一个 Cache单元, 故逐列访问
每个数据时, 都会将之前的字块置换出, 也即每次访问都不会命中 , 命中率为0。
由于从Cache读数据比从主存读数据快很多 , 所以程序A 的执行比程序B 快得多。
注意:本题考查Cache容量计算, 直接映射方式的地址计算, 以及命中率计算(注意:行
优先遍历与列优先遍历命中率差别很大)。
45. 解答:
1)用位图表示磁盘的空闲状态。每位表示 一个磁盘块的空闲状态, 共需要16384/32 = 512
字=512x4字节 =2KB, 正好可放在系统提供的内存中。
2)采用CSCAN调度算法, 访问磁道的顺序和移动的磁道数见下表。被访问的下一个磁道号 I 移动距离(磁道数)
120 20
-
30 90
-
50
20
90 -
40
移动的磁道数为20+9 0+ 2 0+ 4 0 = 170, 故 总的移动 磁道时间为170ms。
由千转速为6000rpm, 则平均 旋转延迟为Sms, 总的旋转延迟 时间 = 20ms。
由于转速为6000rpm, 则读取一个磁道上一个扇区的平均 读取时间为O.lms, 总的读取扇
区的时间为0.4ms。
综上, 读取上述磁道上 所有扇区所花的总时间为190.4ms。
3)采用FCFS (先来先服务)调度策略更高效。 因为Flash半导体存储器的物理结构不需
要考虑寻道时间和旋转延迟,可直接按1/0请求的先后 顺序服务。
46. 解答:
I)由于该计算机的逻辑地址空间和物理地址空间均为64KB=i6B,
按字节编址,且页的
大小为IKB=i0B, 故 逻辑地址和物理地址的地址格式均为
页号/页框号(6位) 页内偏移量(JO位)
I 1
17CAH = 0001 0111 1100 1010B, 可知该逻辑地址的页号为000101B= 5。
2)根据FIFO算法,需要替换装入时间最早的页,故需要置换装入时间最早的0号页, 即
将5号页装入7号页框中,所以物理地址为00011111 1100 1010B = lFCAH。
o,
3)根据CLOCK算法,如果当前指针所指页框的使用位为 则替换该页;否则将使用位
清零,并将指针指向 下 一个页框,继续查找。根据题设和示意图, 将从 2号页框开始,前4次
查找页框号的顺序为2--4--7--9, 并将对应页框的使用位清零。 在第5次查找中, 指针指向2
o,
号页框,因 2号页框的使用位为 故淘汰2号页框 对应的2号页,把5号页装入2号页框中,
并将对应 使用位设置为1, 所以对应的物理地址为0000 1011 1100 1010B = OBCAH。
47. 解答:
1)显然当甲和乙同时向 对方发送数据时,信号在信道中发生冲突后, 冲突信号继续向两
个方向传播。 这种情况下两台主机均检测到冲突需要经过的时间最短:
。
T(a)= lkm/200000km/sx2 = O.Olms =单程传播时延t
设甲 先发送数据, 当 数据即将到达乙时,乙也开始发送数据,此时乙将立刻检测到冲突,
而甲要检测到冲突还需等待冲突信号 从乙传播到甲。两台主机均检测到冲突的时间最长:
。
T l= 2km/200000km/sx2 = 0.02ms= 双程传播时延2t
(b
曰 卫巴 曰
曰 工 曰 � � 寸
巨仁 妇 巨仁 回
(a)时间最短的情况 (b)时间最长的情况
2)甲发送一个数据帧的时间, 即发送时延t = 1518x8bit/(10Mbps) = l.2144ms; 乙每成功收
1
到一个数据帧后,向甲发送一个确认帧, 确认帧的发送时延t = 64x8bit/10Mbps = 0.0512ms; 主
2
机甲收到确认帧后,即发送下 一 数据帧,故主机甲的发送周期T=数据帧发送时延t +确认帧 发
1
送时延t2+双程传播时延=t1 +t2 +2 t
0
= l.2856ms。 于是主机甲的有效数据传输率为1500x8/T=
12000bit/l.2856ms""'='9.33Mbps (以太网帧的数据部分为1500B)。