ARTICLE · 1032385
阿里开源了内部 AI 代码审查工具:3.4 万 Star,token 只要通用助手的九分之一
哈喽啊,朋友们!我是小成同学。
今年 5 月,阿里把内部跑了两年多的代码审查助手开源了,叫 Open Code Review(简称 OCR)。官方口径:内部几万名开发者用过,累计识别出数百万个代码缺陷。
用 AI 写代码的朋友应该都有同感:代码产出越来越快,审查跟不上。让同事细看吧大家都忙,让 Claude Code 这类通用助手顺便审一下,用过的都知道差点意思。这篇就聊聊这个 3.4 万 Star 的工具,实测口径到底强在哪。
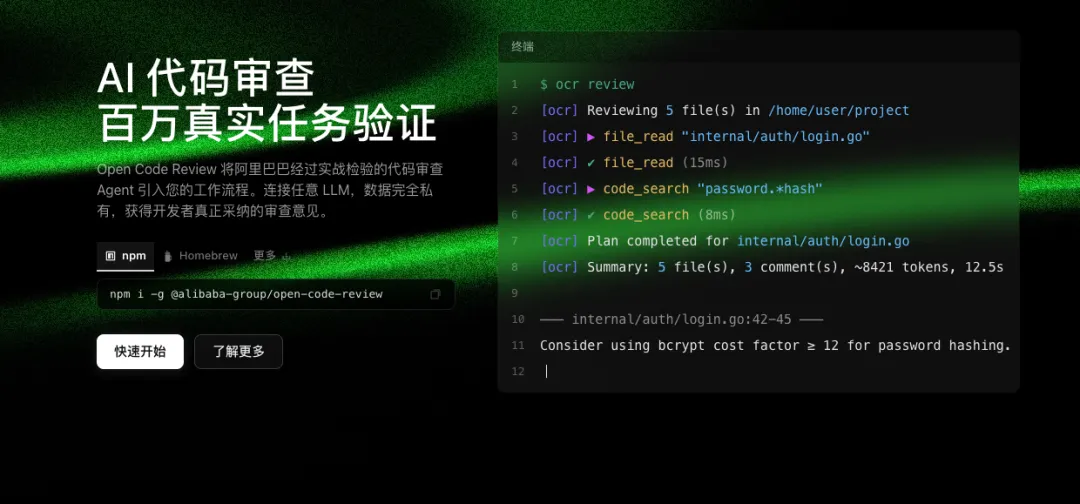
它是什么
先看看仓库数据:
通用助手审代码,问题出在哪
拿 Claude Code、Codex 配提示词审过代码的朋友,大概率撞上过这三件事:改动一多它挑着看,没看的文件有没有问题没人知道;报的问题位置对不上,说某行有空指针,点过去那行是空的;提示词稍微动一动,审出来的东西就变样。
根子在于:纯语言驱动的流程,对「审查该做什么」没有硬约束。文件看没看完、行号准不准、规则用没用对,全靠模型自觉。
OCR 的思路反着来:能用工程代码保证正确的环节,一律不交给模型决定。哪些文件要审、怎么分组、每组套什么规则、评论落在哪一行,全是程序做的。模型只负责一件事——看代码,判断有没有问题。
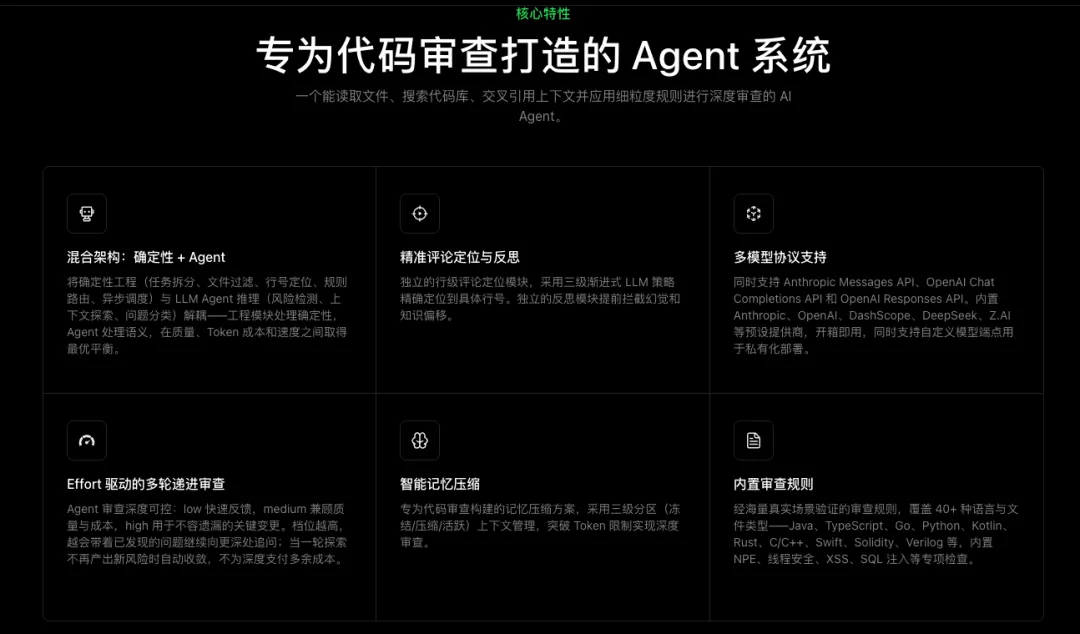
混合架构的几个实招
有几个设计细节值得单独说:
文件捆绑分组。大改动不是一口气丢给模型,而是把相关文件捆成组(比如中英文语言文件捆一起),每组交给一个独立上下文的子 Agent 分而治之,天然支持并发。超大 changeset 也不会崩。
评论定位不用模型报行号。模型对数字本来就不敏感。OCR 让模型给出有问题的代码片段,程序拿着片段去 diff 里精确定位,找不到就扫全文件,还不行才让模型重新定位一次。层层兜底下来,内部版本评论位置准确率超过 97%。
规则是模板引擎匹配的。内置规则按语言和文件类型分:Java 查空指针和线程安全,前端查 XSS,MyBatis 的 XML 查 SQL 注入,开箱即用。团队自己的规矩放进仓库的 .opencodereview/rule.json,比如金额计算必须用 BigDecimal、对外接口必须带鉴权注解,项目、个人、命令行临时规则四层优先级,覆盖关系文档写得明明白白。
日常怎么用
装就一条命令(注意 Git 要 2.41 以上,它靠 Git 做 diff 和代码搜索):
npm install -g @alibaba-group/open-code-review ocr config provider # 交互式配模型,阿里云百炼可选,自动测连通 ocr config model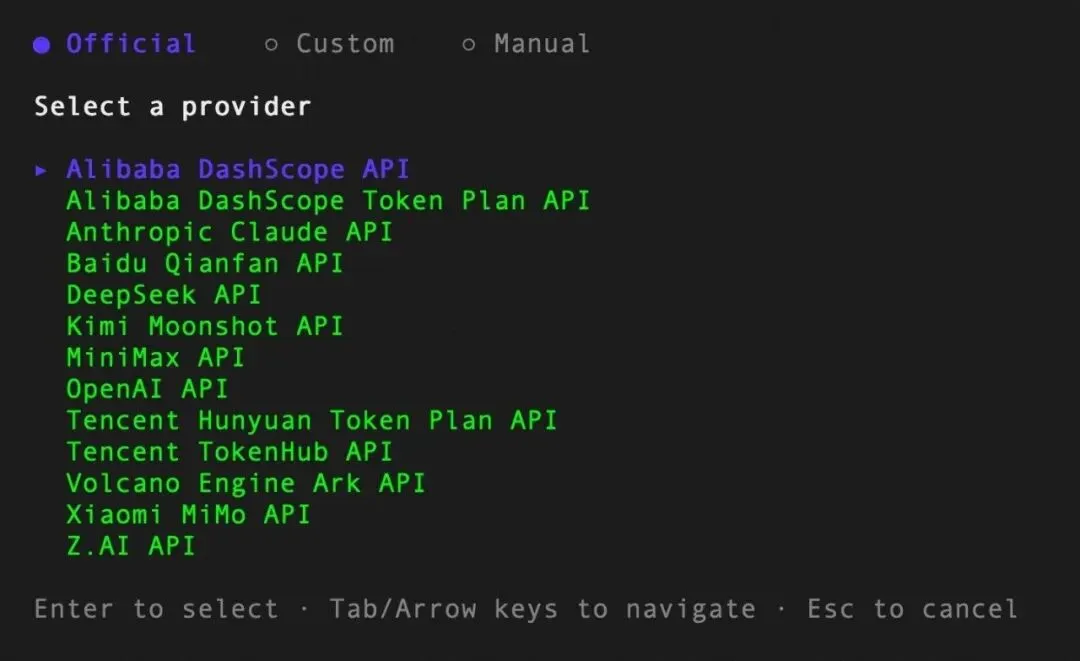
进项目里跑:
ocr review # 工作区模式:暂存+未暂存+未跟踪全审 ocr review --from main --to feature # 分支相对主分支的改动 ocr review --commit abc123 # 单个提交 ocr scan --path internal/agent # 全量扫目录,不需要 Git 历史两个实用参数:--background 带上这次改动的意图(比如「实现手机号登录验证」),模型能分清哪些是故意这么写的,误报少不少;第一次用先跑 ocr review --preview,看它选了哪些文件、不调模型不花钱。中断的审查还能 --resume 接着跑,长任务不用从头来。
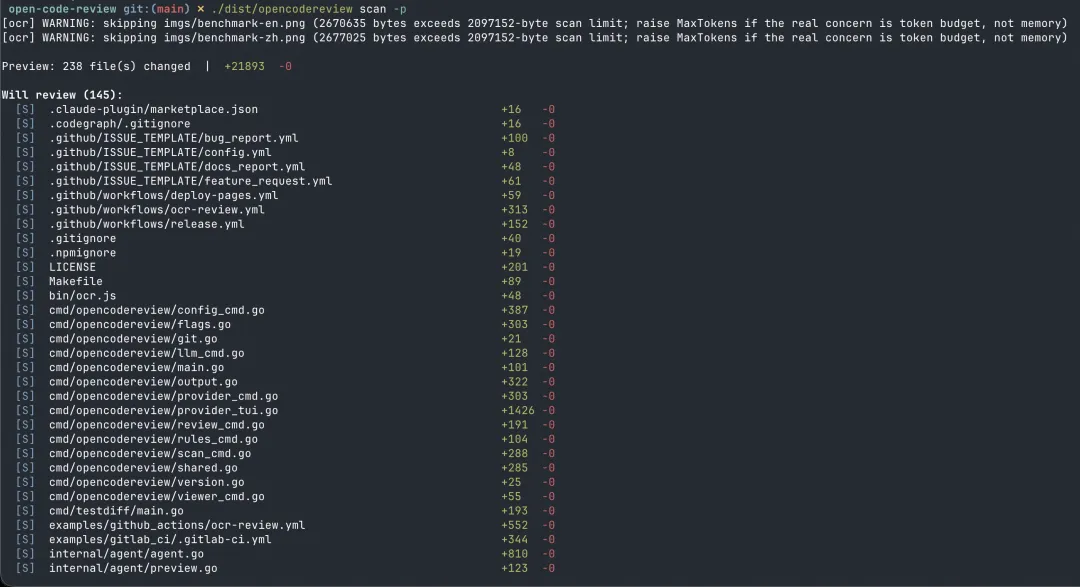
没配模型 key 也能用——委托模式下,OCR 只负责挑文件和匹配规则,真正的审查交给你自己的 Claude Code、Codex 去干。反过来也行:OCR 装成这些编码助手的插件,对话里直接调起。支持的还不止这两家,Cursor、Kimi Code、OpenCode 都有官方插件。
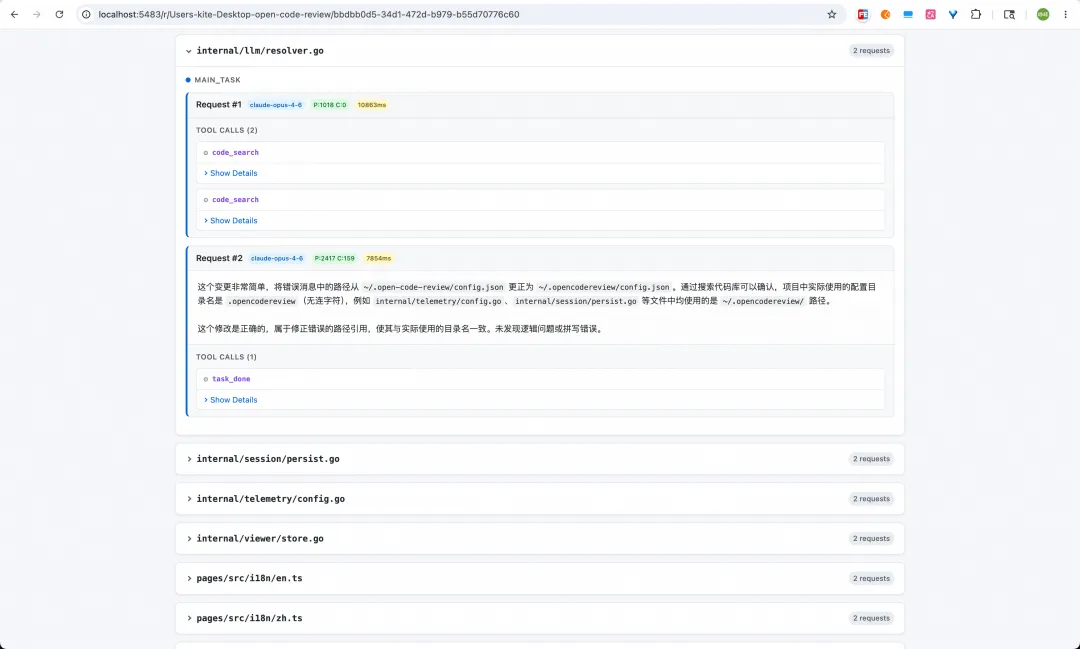
挂 CI 也现成:GitHub Actions、GitLab CI、甚至 Gerrit 的模板都给了,输出标准 JSON,每次 PR 自动过一遍。审过的记录跑 ocr viewer 在本地网页里回看,处理掉标记已修复,下次不重复报。
效果数据
开源版专门建了个评测集:50 个热门开源仓库、200 个真实 PR、10 种语言、80 多位资深工程师标注出 1505 个问题(数据集 AACR-Bench 放在了 HuggingFace 上)。同样底层模型下,OCR 的准确率和 F1 都比通用助手高,token 消耗大概只有九分之一,速度更快。
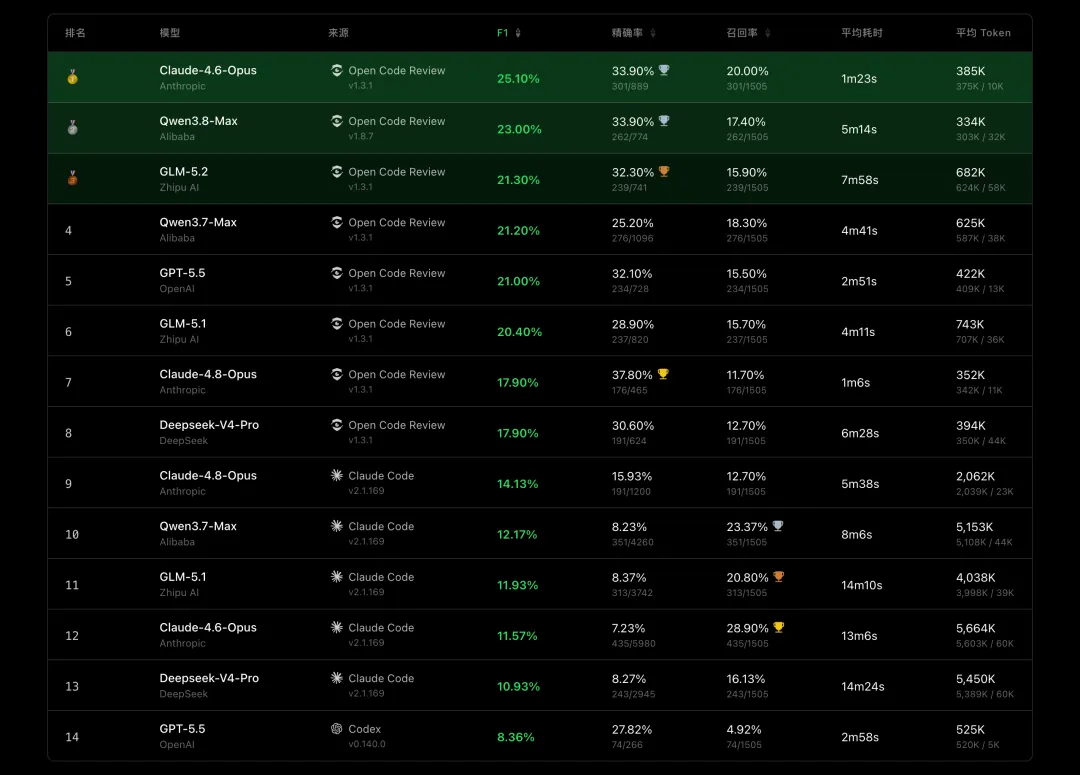
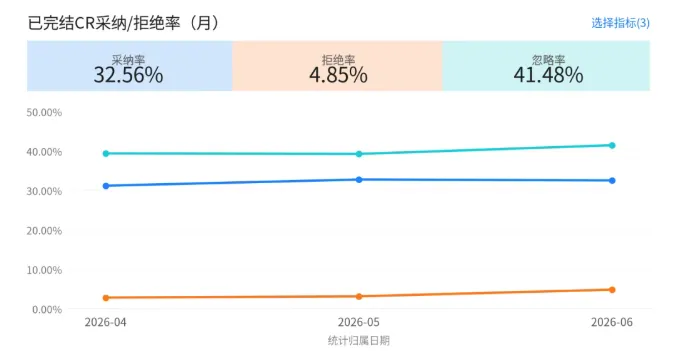
但有一样要挑明:它的召回率比通用助手低——有些问题它没报出来。这是刻意的取舍,宁少报不误报。官方口径的内部数据是月活两万、累计 370 万次真实评审、用户采纳率超 30%。
所以使用建议很清楚:日常审 PR,OCR 的取舍完全合理,误报轰炸比漏掉一两个小问题更消耗人;但安全审计这种不能漏的场景,它得搭配专门的工具一起用,不能单靠它兜底。
最后说句实在的,这个工具真正值钱的地方,是把「审查该怎么做」这件事工程化固定住了:文件一个不漏、位置精确、规则一致。这些听起来都是基本功,恰恰是通用助手最容易翻车的地方。AI 生成的代码越来越多,审查靠人盯肯定盯不住,让每个 PR 先被稳定地过一遍,就已经值回安装了。
资源链接
• OCR 仓库:https://github.com/alibaba/open-code-review
• 官网与文档:https://open-codereview.ai