ARTICLE · 1034797
GRPO:让 AI 自己刷题变强的算法,凭什么能省掉一半显存?
GRPO:让 AI 自己刷题变强的算法,凭什么能省掉一半显存?
你有没有想过一个问题:大模型是怎么学会"做数学题"的?
预训练阶段它只是在"读书"——看了海量文本,学会了续写。但读完书不等于会做题。
想让它真的会解题、会写代码,得让它自己练:出题 → 它做 → 判对错 → 改。这就是强化学习(RL)。
可问题是:让大模型自己练,极其费显存。 标准做法(PPO)要同时在显存里塞下四个模型。很多人的训练不是死在算法上,是死在显存不够。
GRPO 的办法很粗暴也很聪明:砍掉一个模型。
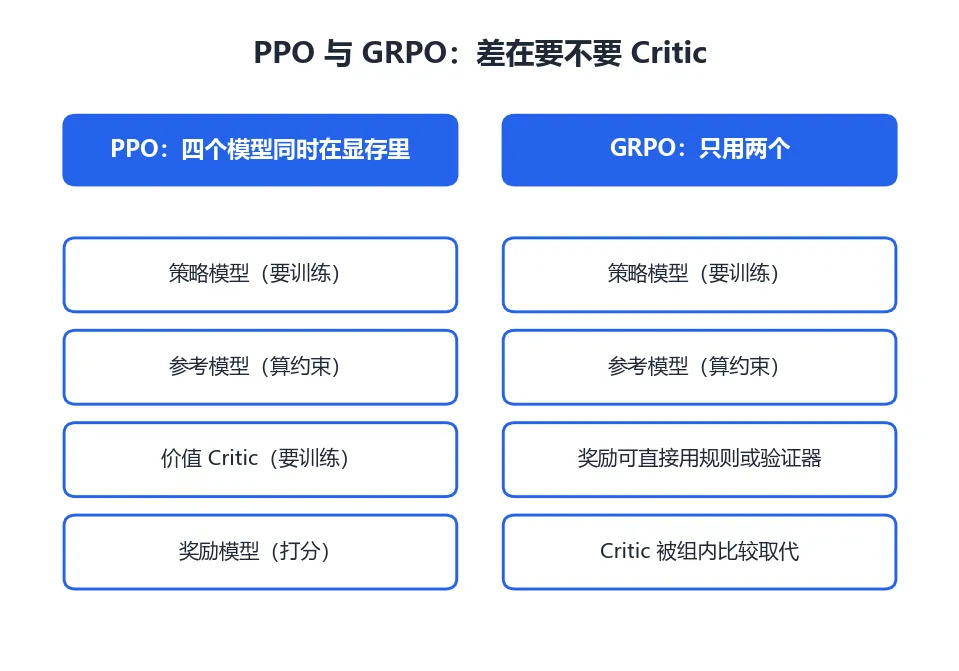
这张图怎么看:左边 PPO 要养四个模型,右边 GRPO 只用两个——省掉的 Critic 就是它省下的显存。
先说清楚:这技术是干嘛的
一句话版本的:
GRPO 是一种"让大模型自己刷题变强"的训练算法。它比传统 PPO 少用一个模型——不请"教练"打分,而是让同一道题的几个答案互相比较。
打个比方你就懂了:
| 不请教练 | ||
| 不用教练 |
所以 GRPO 的本质就是:用"多生成几份答案来比较",换掉"专门训一个模型来打分"。
省下来的是显存,多花的是算力。如果你的瓶颈是显存——GRPO 就是解药。
一、为什么需要它
先说传统的 RLHF/PPO 到底要几个模型:
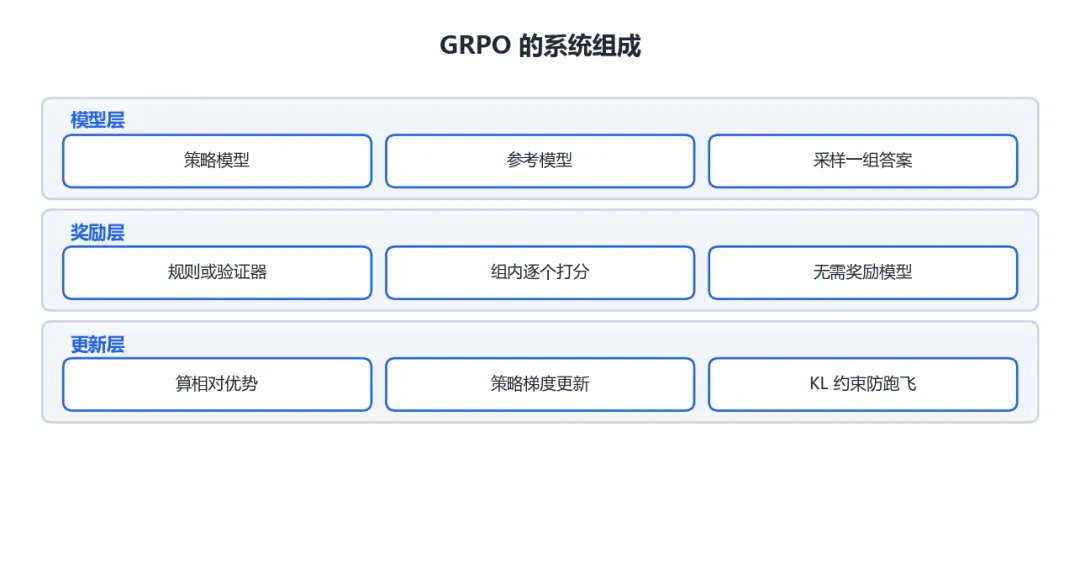
这张图怎么看:从上往下看:模型层负责采样,奖励层负责打分,更新层负责算优势。
① Policy —— 正在训练的模型(要练的那个"学生")② Reference —— 训练前的副本(用来防止学生跑偏)③ Reward —— 打分模型(判卷子的)④ Critic —— 价值模型(估"这题一般能拿多少分"的教练)
四个模型,其中两个(Policy 和 Critic)都要做前向+反向传播。
一个 7B 模型跑 PPO,显存里躺着四个 7B 级别的模型和它们的优化器状态——这还没算激活值和 KV Cache。
Critic 存在的唯一目的:告诉你"这个回答比平均水平好多少"。
而 GRPO 说:平均水平不用模型估,我直接多采样几条答案,一平均不就行了?
二、说人话的原理
GRPO 就三步,非常朴素:
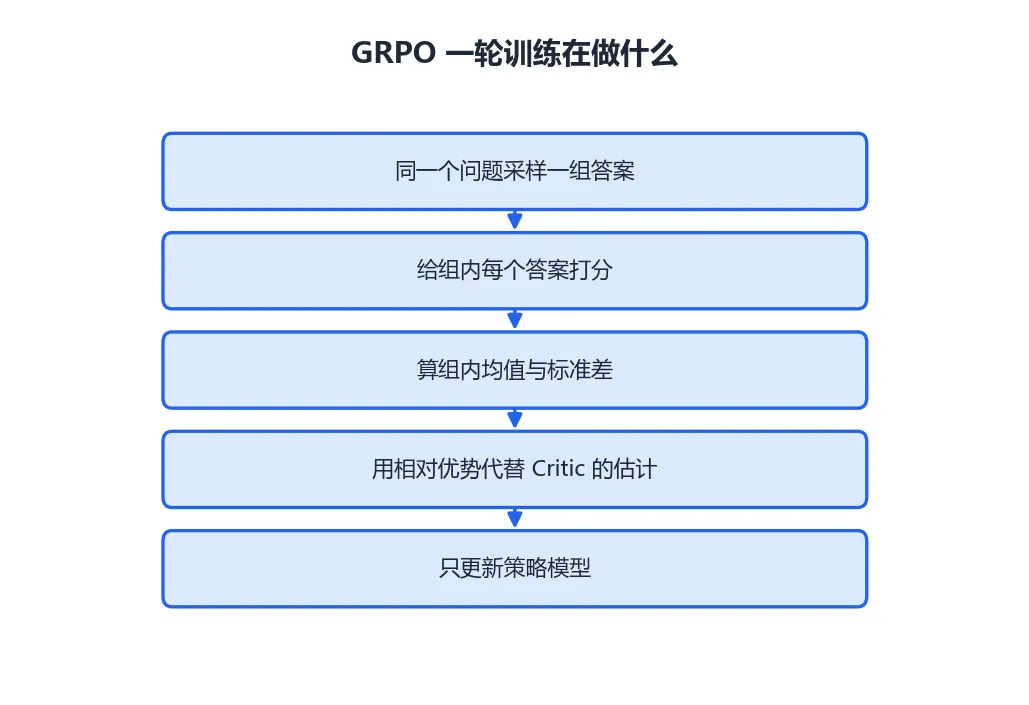
这张图怎么看:关键在第三步:用组内的均值和标准差算出相对优势,Critic 的活就被替代了。
① 同一道题,让模型生成 G 条不同答案(比如 G=8)② 给这 8 条答案各自打分③ 计算每条答案比"这组的平均分"高多少 —— 这就是它的"优势"
举例:
一道数学题,模型生成了 4 条答案,判分结果:
答案1: 对 → 1 分答案2: 错 → 0 分答案3: 对 → 1 分答案4: 错 → 0 分组内平均分 = (1+0+1+0)/4 = 0.5答案1 的优势 = 1 − 0.5 = +0.5 ← 比平均好,鼓励答案2 的优势 = 0 − 0.5 = −0.5 ← 比平均差,抑制
就这么简单——不需要 Critic 来估计"平均水平",平均水平直接从这一组里算出来了。
为什么这样做是合理的?
关键在于:同一道题,难度是一样的。
所以这 8 条答案之间的分数差异,不是因为题难,而是因为模型这次发挥得好不好。
用组内平均当基准,刚好把"题目难度"这个干扰因素抵消掉了。
💡 这也是为什么 GRPO 在数学、代码这类"有标准答案"的任务上特别有效:对错清楚,组内比较的含义就明确。
那它和 PPO 到底差在哪?
只有一处:优势(Advantage)怎么算。
PPO: 优势 = 得分 − Critic 估的"平均水平" ← 模型估的GRPO: 优势 = 得分 − 这一组答案的实际平均分 ← 采样统计出来的
其余部分(裁剪、防止跑偏的 KL 约束)完全照搬 PPO。
三、代码:核心就这几行
下面这段是 GRPO 损失函数的简化版,每一行都带了注释说明它在干嘛:
import torchdef grpo_loss(new_logprobs, # 模型"现在"生成每条答案的概率old_logprobs, # 采样时"当时"的概率rewards, # 每条答案的得分(比如 [1, 0, 1, 0])ref_logprobs, # 训练前那个副本的概率(防跑偏用)mask, # 标记哪些位置是真实 token( padding 不算)eps=0.2, beta=0.04):# ---- 第 1 步:算"组内优势"(GRPO 的灵魂,就这两行)----mean_r = rewards.mean() # 这一组的平均分std_r = rewards.std() # 这一组的分数波动adv = ((rewards - mean_r) / (std_r + 1e-4)) # 每条答案比平均好多少# adv 是每条答案一个数,要广播到这条答案的每个 token 上adv = adv.unsqueeze(1)# ---- 第 2 步:新旧策略的比值(这是 PPO 的老套路)----ratio = torch.exp(new_logprobs - old_logprobs)# ---- 第 3 步:裁剪更新(防止一次改太猛)----surr1 = ratio * advsurr2 = torch.clamp(ratio, 1 - eps, 1 + eps) * advpolicy_loss = -torch.min(surr1, surr2) # 取小的,再取负号做梯度上升# ---- 第 4 步:别跑太偏(和训练前的自己比)----log_ratio = ref_logprobs - new_logprobskl = torch.exp(log_ratio) - log_ratio - 1.0# ---- 第 5 步:只在真实 token 上算平均 ----per_seq = ((policy_loss + beta * kl) * mask).sum(dim=1) / mask.sum(dim=1).clamp(min=1)return per_seq.mean()
看不懂没关系,你只需要记住:
- 最核心的是第 1 步
—— rewards - mean_r,就是"比同组平均好多少" 其余步骤都是 PPO 本来就有的东西(防止更新过猛、防止跑偏)
四、它省了什么、又贵在哪
| 模型数量 | 2 个 | |
| 显存 | 明显更省 | |
| 训练稳定性 | 更稳 | |
| 采样量 | ||
| 适合任务 | 有标准答案 |
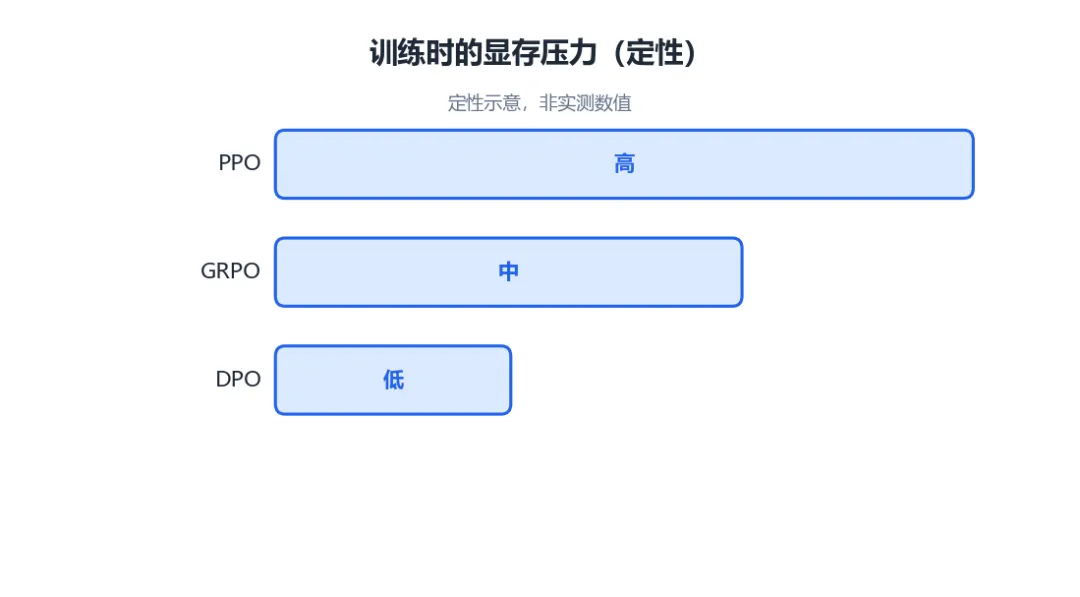
这张图怎么看:显存压力的差异,主要来自要不要额外养一个 Critic。
⚠️ 别把它当万能药:省的是显存,多花的是推理算力。如果你卡在算力而不是显存,未必划算。
五、什么时候该用
有标准答案(数学题、单元测试、SQL 执行结果)→ GRPO 很合适主观偏好(文风好不好、有没有礼貌) → DPO 更简单显存紧张、想要稳定的 RL → GRPO已有靠谱 Critic、追求极限效果 → PPO
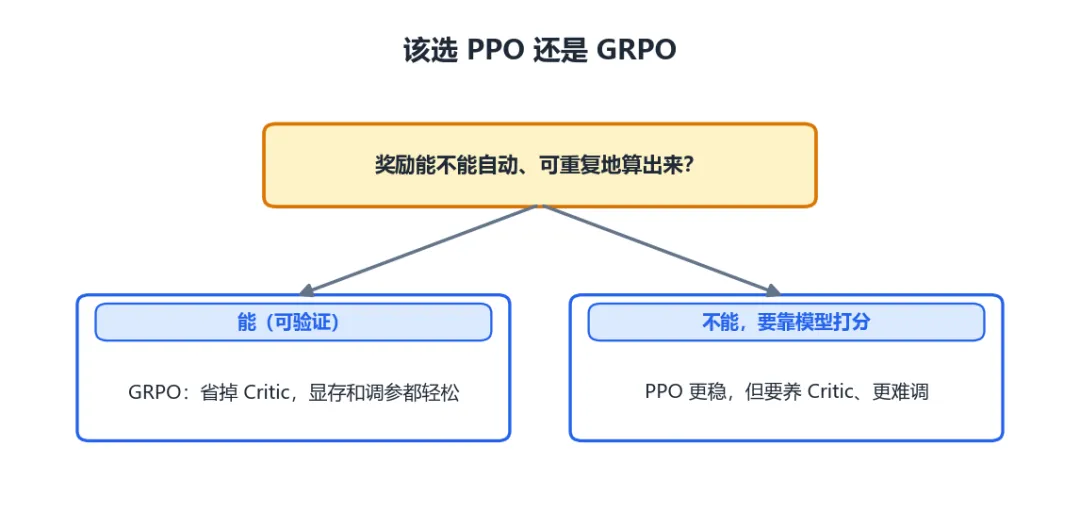
这张图怎么看:判断点只有一个:奖励能不能自动算。能算就 GRPO,不能算才考虑 PPO。
六、工程上容易踩的坑
| 每组采样太少 | ||
| 一组答案全对/全错 | ||
| 这一组分数完全一样 | 1e-4;或跳过这组 | |
| 防跑偏系数太大 | beta | |
| 模型钻规则刷分 | ||
| 回答越来越长 |
💡 "全对/全错的题直接扔掉"这条特别实用:8 条答案全对,意味着优势全是 0,反向传播没有梯度,纯浪费。过滤掉能省不少算力。
小结
GRPO 干了什么:把"请一个模型来估平均水平",换成"多生成几份答案自己平均"。
记住三句话就够了:
- 它是干嘛的
:让大模型通过自己刷题、自己对答案来变强 - 它省了什么
:删掉了最占显存的 Critic 模型 - 代价是什么
:每题要多生成好几条答案,推理量上去了
如果你的任务有标准答案(数学、代码、SQL),GRPO 基本是现在最省事的选择。
参考来源
DeepSeekMath 论文(GRPO 首次提出):DeepSeekMath: Pushing the Limits of Mathematical Reasoning(arXiv:2402.03300) DeepSeek-R1 论文(大规模实践):DeepSeek-R1(arXiv:2501.12948) PPO 论文:Proximal Policy Optimization Algorithms(arXiv:1707.06347)
关键词:GRPO强化学习RLHFPPO大模型训练DeepSeek推理模型