ARTICLE · 1042990
AI AGENT为什么会“使用工具”?它不是长出了手,而是在反复做四步循环
普通聊天模型只返回文字。Agent 却能搜索网页、读取文件、运行代码、填写表格。
它是怎么从“会说话”变成“会做事”的?
关键不是模型内部突然多了一只手,而是系统给它接上了一组工具,并允许它在回答前多轮调用。
一次工具调用到底发生了什么
假设用户说:“查一下上海明天的天气,并建议要不要带伞。”
系统会把可用工具描述提供给模型:
{"name": "get_weather","description": "查询指定城市和日期的天气","parameters": {"city": "string","date": "string" }}模型不会自己访问天气服务器,而是生成类似请求:
{"city":"上海","date":"2026-09-20"}外部程序校验参数、调用真实接口,再把结果交回模型。模型根据返回值组织最终回答。
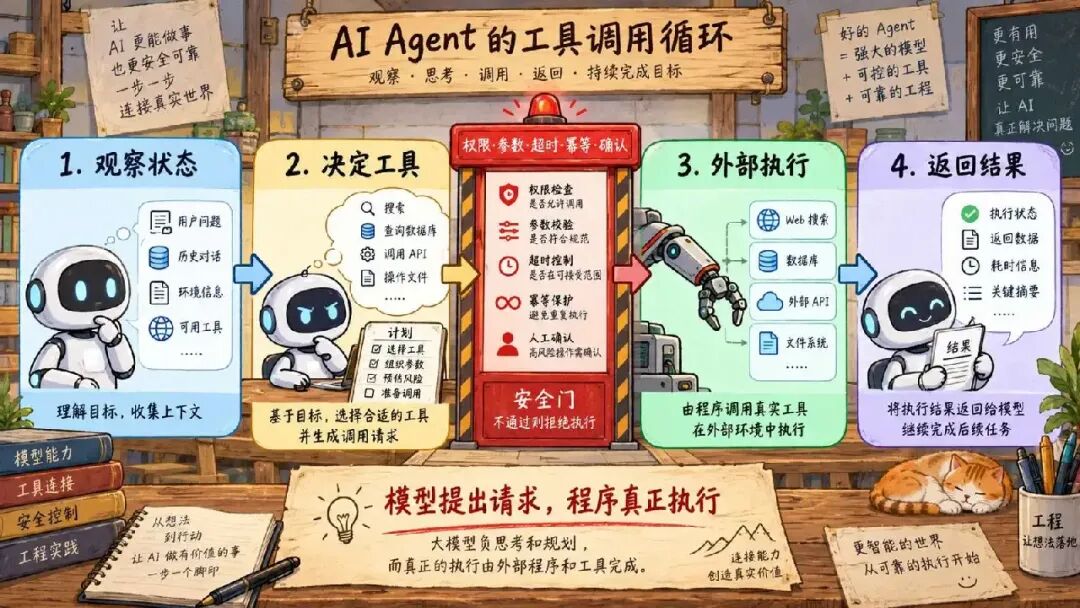
整个过程可以压缩成:
观察当前状态 → 决定下一步 → 外部执行工具 → 读取执行结果复杂任务会把这个循环重复很多次。
Function Calling不是执行
“函数调用”这个名字容易让人误会。模型输出一个函数名和参数,并不等于函数已经运行。
真正执行前,程序至少要做:
检查工具是否允许调用; 校验参数类型、范围和必填项; 验证当前用户权限; 设置超时、重试和幂等; 记录谁在何时执行了什么动作。
如果模型请求 delete_all_files,执行层不能因为 JSON 格式正确就照做。
Agent为什么会越做越偏
假设目标是“整理10份合同并生成风险表”。Agent 第一步误把附件目录识别错,后面所有分析即使逻辑正确,也建立在错误材料上。
长任务存在误差累积:
错误观察 → 错误计划 → 调错工具 → 得到无关结果 → 继续合理化因此,Agent 的质量不能只看最后一句话。还要评估轨迹:选了什么工具、参数是什么、工具是否成功、失败后怎样恢复。
最常见的四种工具故障
工具选择错。 有数据库查询工具,却调用网页搜索。
参数看似合理但不合法。 日期格式错、文件路径不存在、枚举值超范围。
工具成功但任务失败。 API 返回 200,只代表请求成功,不代表拿到了用户需要的数据。
重复执行副作用。 超时后重试,导致发了两封邮件、扣了两次库存。
最后一种尤其危险。写操作必须设计幂等键,查询与修改工具也应该分开授权。
哪些动作必须让人确认
可以按后果分级:
只读查询:通常可自动执行可恢复修改:执行前展示差异对外发送:确认收件人和正文付款、删除、发布:必须明确确认确认不能写成模糊的“是否继续”。应该把对象、范围和后果说清楚:
将向客户A、B、C发送这封邮件,共3人。是否发送?怎样判断一个Agent是不是真的可靠
不要只给它一道成功案例。测试集应包含:
信息不完整,需要追问; 工具返回空结果; 参数第一次校验失败; 两个工具都能完成任务但成本不同; 用户要求越权操作; 执行到一半网络中断; 同一请求被重复提交。
记录“任务完成率”之外,还要看错误动作率、平均工具调用次数、需要人工接管比例和副作用事故数。
Agent 本质上不是一个更会聊天的模型,而是一套“模型决策 + 工具执行 + 状态管理 + 权限控制”的系统。模型决定下一步,程序守住能不能做。只有两边都可靠,它才真的能替人办事。