ARTICLE · 1048998
三大思考模板:它到底怎么想(智能体十讲 04)
上一篇我们亲手接上了工具,看见了"思考-行动-观察"的循环。但你会发现,同样一颗引擎,有人调教出来的是复读机,有人调教出来的是老练的助手——差别不在模型,在于你给它的"思考套路"。
这一篇把业界真正跑通的三种套路拆给你看:边想边做的 ReAct、先规划再动的 Plan-and-Solve、做完再检讨的 Reflection。它们不是三套代码,而是三种关于"模型该怎么想"的设计取舍。
选哪种套路,直接决定你的智能体是稳还是乱。
一、直觉优先:三种套路,各管一类活
想象你让 AI 帮你查一家餐厅的评价。
ReAct(边想边做):像经验丰富的侦探。它拿到问题后不急着动手,而是先想"哦,这事儿我知识库里没有,得搜一下",然后真的去搜,拿到搜索结果后再想"原来是这家店差评集中在服务态度",再决定要不要再搜一次确认。每一步都是"想一步、动一步、看完再想"。它的循环长这样:Thought(思考)→ Action(行动)→ Observation(观察),不断重复,直到它自己觉得能给出答案了,才用 Finish 收尾。这种套路适合信息在外部、边查边变的活——查天气、看股价、翻最新新闻、问数据库。2022 年 Shunyu Yao 提出这个设计时,核心洞察就是:思考和行动应该绑在一起,行动的结果会反过来修正思考。
打个更具体的比方:你要查"今年新出的两款旗舰机,哪台拍照更好"。ReAct 的做法是:先搜一次,看到甲机的评测关键词是"影像",再决定要不要专门搜乙机的样张——它像侦探一样,根据上一步的线索决定下一步去哪里。
Plan-and-Solve(先规划再动):像建筑师画蓝图。它不急着一步步搜,而是先把整个任务拆成一张清晰的步骤清单。比如"写一份市场分析报告",它先列出"1. 收集竞品数据 2. 整理用户反馈 3. 画对比图 4. 撰写结论",然后按这张清单一步步求解。2023 年 Lei Wang 提出这个方法时,针对的是思维链的三种常见翻车:漏步、算错、把题目理解偏了——先把计划写出来再答,这三类错误会明显减少。先谋后动,适合结构清晰、能提前拆成明确步骤的活——数学题、代码生成、多步骤报告。(工程上常把它落成Plan-and-Execute架构:先出计划、再逐步执行,执行中还能按新情况改计划。)
同一个任务,换个做法:同样是"写一份市场分析报告",Plan-and-Solve 会,先花几分钟把整份报告的骨架想清楚(目录、分几部分、每部分要什么数据),然后按骨架一句一句填。它像写代码前先画流程图,骨架对了,细节才不会走样。
Reflection(做完再检讨):像写完初稿校对的人。它先老老实实用上面两种方式之一跑一遍,得到一个初步答案;然后它换个角色当"评审员",审视自己刚才的输出:"这个数据对吗?""推理有没有漏洞?""有没有更简洁的做法?"——把发现的问题写成反馈;再拿着初稿和反馈重写一版。这一套叫"执行→反思→优化",可以反复多轮,直到挑不出毛病为止。这套玩法有两篇经典论文:Self-Refine(Madaan 等,2023)——同一个模型既生成、又给自己挑错、再改一版;Reflexion(Noah Shinn 等,2023)——更进一步,把每次失败的教训写成语言化反馈存起来,下一轮带着这些教训重来(不更新模型权重)。先跑再改,特别适合对准确率要求高、不容许糊弄的活——代码审计、正式报告、关键决策。
这三个名字最容易混,一张表分清:
换个任务:让它查一个库函数的签名。Reflection 会先写一版,再自己质疑"这个参数名对吗",回头翻文档确认——多花一次调用,换掉一个编造出来的 API,这笔买卖划算。
三种套路的本质区别,就在于"它什么时候停下来想":ReAct 是每步都停,Plan-and-Solve 是开始前停一次,Reflection 是结束后再停一次。
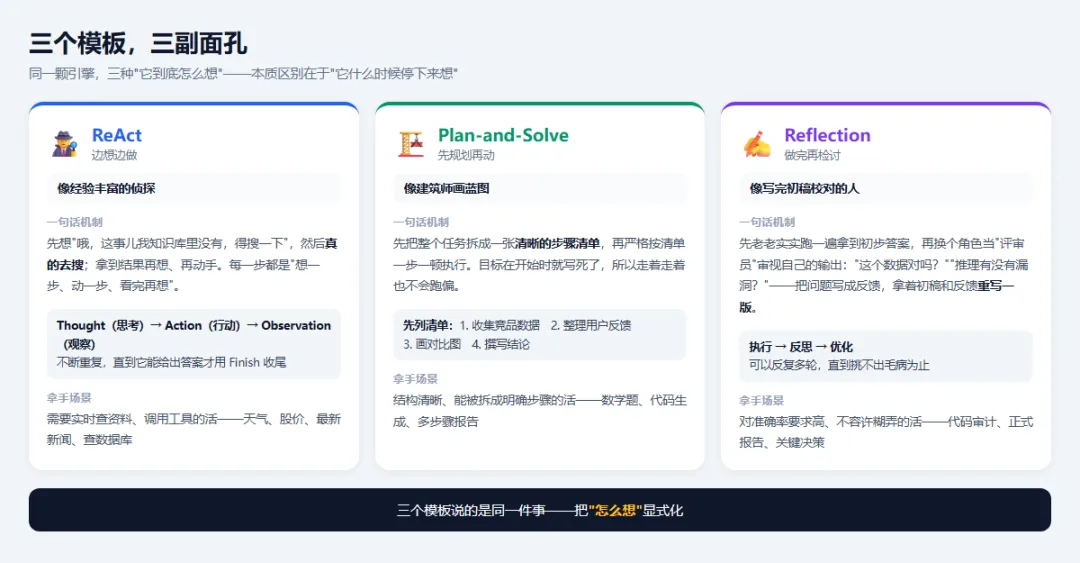
图1 同一颗引擎、三副面孔:ReAct 像经验丰富的侦探,Plan-and-Solve 像建筑师画蓝图,Reflection 像写完初稿校对的人——本质区别在于"它什么时候停下来想"
二、各自的天花板和软肋
每种套路都有它会翻车的场景,心里有数才能用对。
ReAct 的软肋有三:
强依赖模型本身。 它每一步都靠模型生成格式正确的 Thought 和 Action,模型一旦指令遵循能力不足,整个循环就断。这不是小问题——很多时候智能体"突然变蠢",不是模型变笨了,而是提示词里一个词的改动让它不再遵循格式。 串行成本高。 每一步都要调一次 LLM,任务步骤一多,耗时和费用一起涨。一个十步的任务,成本至少是一步任务的十倍,而且随上下文变长往往更高。 没有全局视角。 它只顾眼前这一步,可能走着走着选了条短期对、长期错的路径,甚至原地打转——因为它没有一张完整的"地图"告诉自己"终点在哪"。
Plan-and-Solve 的软肋在于:
规划阶段如果错了,全盘皆输。 它靠第一步的"列清单"定方向,清单本身要是写偏了,后面严格执行反而离题更远。模型如果一开始就没理解你要什么,列出的清单就是废纸。 缺乏灵活性。 计划一旦生成,它就按部就班,遇到计划外的新情况(比如搜索结果和预期不符)可能不会主动调整路线——它不像 ReAct 那样能根据新信息随时拐弯。
Reflection 的软肋最直白:
贵。 跑一遍还要再跑一遍反思、再跑一遍修改,LLM 调用量通常至少 2 到 3 倍(经验值)。任务越复杂,反思轮次越多,费用越可观。 反思模型自己也可能看错。 如果"评审员"水平不够,毛病看不出来,反而会把初稿往错误的方向改——等于一个不会挑错的人在帮你校对,越校对越离谱。 容易过度优化。 为了改一个小瑕疵,重写一大段,反而引入新的问题。
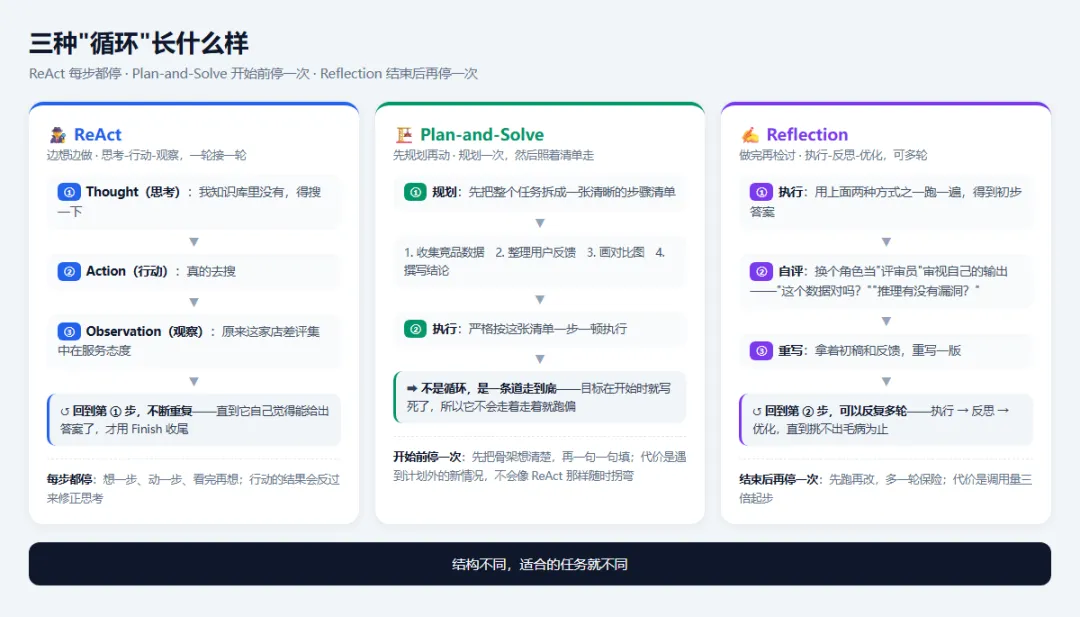
图2 结构不一样:ReAct 是思考→行动→观察不断重复、每步都停;Plan-and-Solve 是先全盘规划再按清单执行、开始前停一次;Reflection 是执行→自评→重写、结束后再停一次
三、实操:亲手跑一个 ReAct 循环
三种套路里,ReAct 是最经典的,也是教程里带完整代码的一种。核心逻辑就三行:格式化提示词 → 调 LLM → 解析它的 Thought/Action 并执行。下面给一个最精简的可运行骨架,你拿到就能改(配合第三篇的环境即可):
import re# 沿用第三篇的 llm() 和 SYSTEM(格式契约),只换一个任务、加一个占位工具per_turn = [{”role”: ”system”, ”content”: SYSTEM},{”role”: ”user”, ”content”: ”帮我查一下 MCP 协议的最新进展”}]def search(query):# 占位工具:换成 SerpApi、百度搜索、自家 API 都行return f”(示意)搜到 3 条关于「{query}」的结果”TOOLS = {”search”: search}MAX_STEPS = 4# 硬刹车:模型开始说胡话时,循环不会自己停for step in range(MAX_STEPS):out = llm(per_turn)# ① 调 LLM,拿回一段纯文本if ”Finish” in out:print(”答案:”, out.split(”Finish:”)[-1].strip())breakm = re.search(r”Action:\s*(\w+)\((.*?)\)”, out)# ② 正则解析出 Thought 和 Actionif not m:print(”格式不对,直接终止:”, out)# ③ 解析失败就不跟着错误往下跑breakname, arg = m.group(1), m.group(2).strip(”\”'”)result = TOOLS[name](arg) if name in TOOLS else f”没有这个工具:{name}”print(f”[观察] {result}”)per_turn += [{”role”: ”assistant”, ”content”: out},{”role”: ”user”, ”content”: f”Observation: {result}”}]
这段代码里有两处值得多说:
第一,MAX_STEPS = 4 是硬刹车。因为 ReAct 是"想一步动一步"的循环,模型一旦开始胡话,循环不会自己停。设一个上限,是防止它无限转圈白烧钱。教程里的正式版本还会配合正则解析:用 re 从 LLM 返回的纯文本里提取 Thought 和 Action;如果模型输出格式不对,解析失败就直接终止,不会跟着错误输出继续跑。
第二,search 函数在这里只是占位。真实世界里你换成 SerpApi、百度搜索,或者自家内部 API 都行——工具的具体实现不重要,重要的是"Thought/Action/Observation"这个循环格式。只要格式固定,换什么工具都能跑。
你会看到它一步步地想、搜、看、再想。这就是 ReAct 的全部秘密——不是模型更聪明了,是给它套上了一个"想一步动一步"的纪律。
跑不跑都行,但记住三行格式就够:Thought 让它"说理由",Action 让它"交工具名和参数",Finish 让它"交答案"。这三行,就是整个 ReAct 智能体的契约。
四、怎么选:一张对照表
实际产品里,这三种套路经常混着用。比如一个智能体先 Plan-and-Solve 列好步骤,中间用 ReAct 去调用工具查每一步的数据,最后用 Reflection 自查一遍再交付给你。
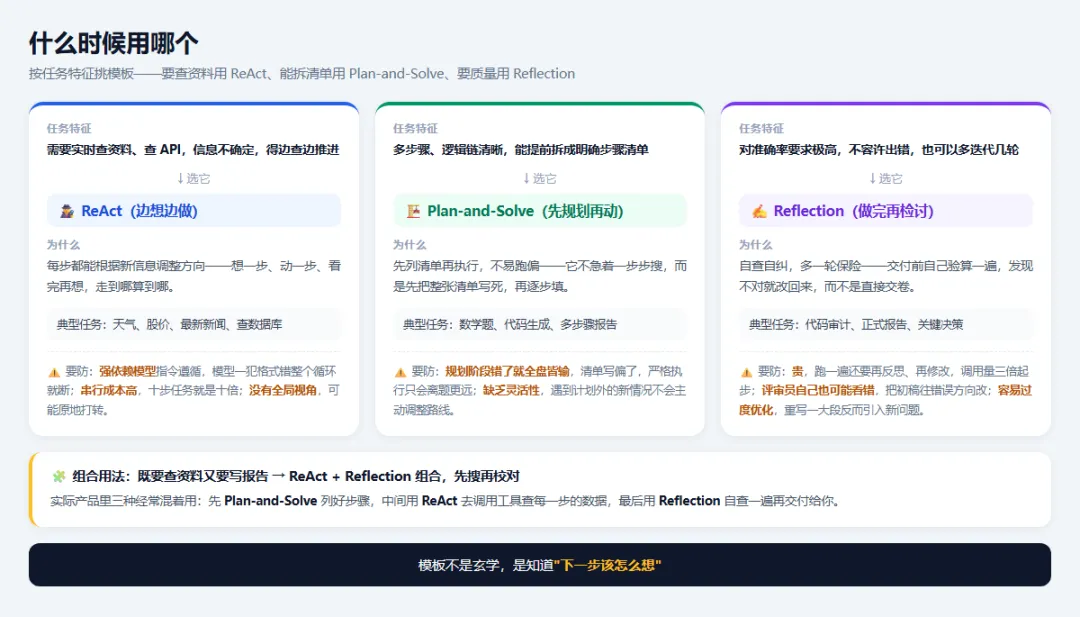
图3 按任务特征挑:要实时查资料、信息不确定用 ReAct;能提前拆成清单用 Plan-and-Solve;对准确率要求极高用 Reflection;既要查资料又要写报告就 ReAct + Reflection 组合——三种也经常混着用
写在最后
这一篇把"它到底怎么想"的三种套路讲透了。下一篇不再讲原理,直接给你看现成的轮子——Dify、Coze、n8n 这些低代码平台,到底把这三种套路封装成了什么模样,你不需要写一行代码就能搭出自己的智能体。
(十讲进度:01 划界 ✓ 02 为什么是现在 ✓ 03 有限引擎 ✓ 04 三大思考模板 ✓ —— 下一篇:不写代码也能搭:Dify/Coze/n8n)
本文事实核查时间:2026 年 9 月。三种套路分别依据 ReAct(Yao 等,2022)、Plan-and-Solve(Wang 等,ACL 2023)、Self-Refine(Madaan 等,2023)与 Reflexion(Shinn 等,2023)。