ARTICLE · 1049314
论文不只是 PDF:ARA 让 AI Agent 直接理解、复现并延续一项研究
论文正越来越多地由 AI 辅助完成,也越来越多地被 AI 阅读。随之而来的问题是:我们是否还应把完整的科研过程,压缩成一份只适合人类顺序阅读的 PDF?
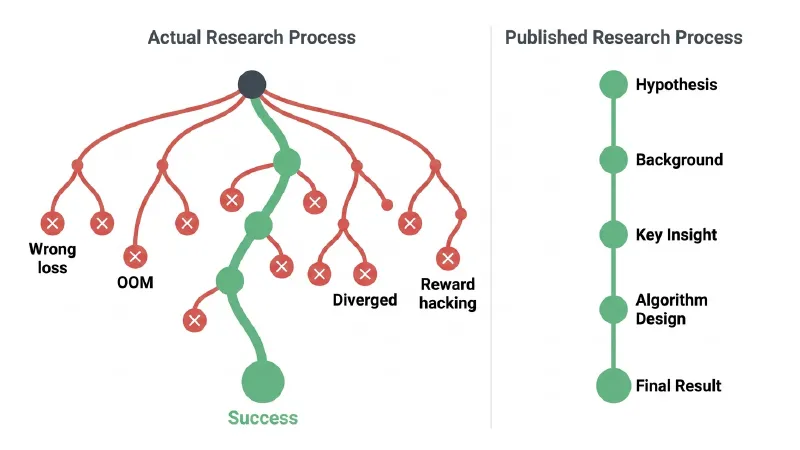
真实的研究很少沿着“提出问题—设计方法—实验成功—得出结论”的直线推进。研究者会提出不同假设,经历 OOM、训练发散和指标异常,放弃无效方案,也会在新证据出现后调整方向。论文发表时,这些分支通常被删去,只留下最终走通的那条路径。
近期,来自多所高校和研究机构的联合团队在论文 The Last Human-Written Paper: Agent-Native Research Artifacts中提出:未来科研的核心产物,或许不应只是一篇定稿论文,还可以是一个供 AI Agent 查询、执行、验证和继续扩展的研究对象——Agent-Native Research Artifact(ARA)。
论文压缩了多少科研信息?
作者用两个概念概括传统论文造成的信息损失:Storytelling Tax和 Engineering Tax。
Storytelling Tax(叙事税),指论文为了形成清晰、连贯的叙事,会删去失败实验、被否定的假设、没有走通的方向和中途发生的设计调整。这种压缩有助于人类阅读,却可能让准备继续实验的 Agent 失去重要线索:哪些路径已经尝试过、失败原因是什么、哪些工作没有必要从头再做。
论文统计了 METR 的 RE-Bench 公开数据。在 24,008 次 Agent 运行中,失败运行消耗了 90.2% 的总 API 成本和 59.2% 的 token。这些失败并非无关紧要的副产品,而是研究过程中成本高昂、又很容易随论文叙事一起消失的知识。
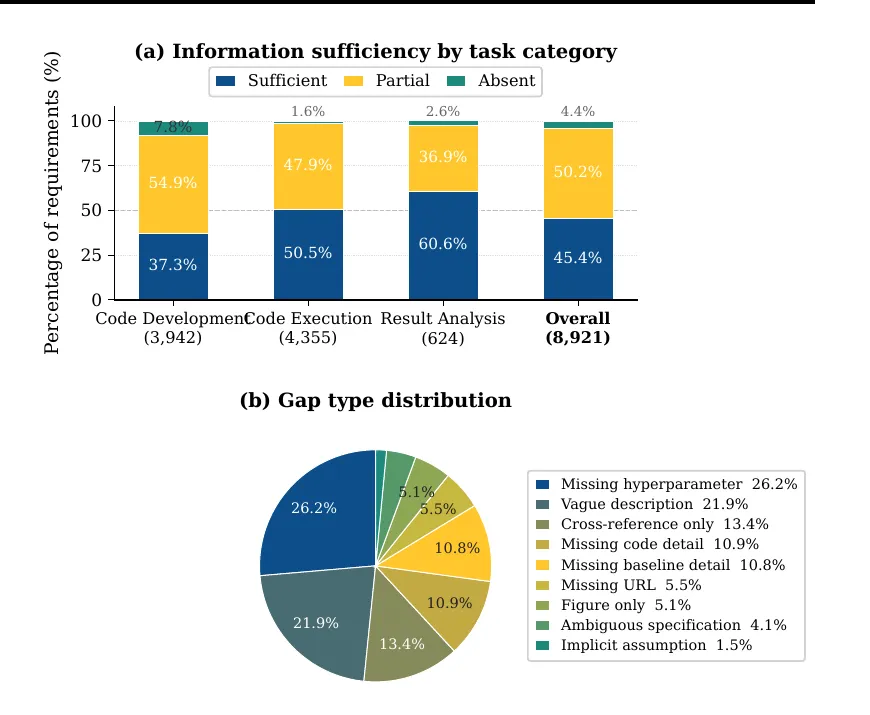
Engineering Tax(工程税)则来自论文描述与实际执行之间的差距。论文往往写到足以让审稿人理解和判断,却未必精确到另一个 Agent 可以据此运行。作者分析了 PaperBench 中 23 篇 ICML 2024 论文、8,921 条专家标注的复现要求,发现只有 45.4%的要求能从论文中获得完整说明;代码开发相关要求的完整率仅为 37.3%。在全部缺失信息中,超参数缺失占 26.2%。
由此出现一个明确的矛盾:
一篇论文可以足以让人相信,却仍不足以让机器准确执行。
当 AI Agent 开始承担论文阅读、实验复现乃至后续研究时,这一差距会直接转化为搜索、试错和计算成本。
ARA 不是加长论文,而是重组科研数据
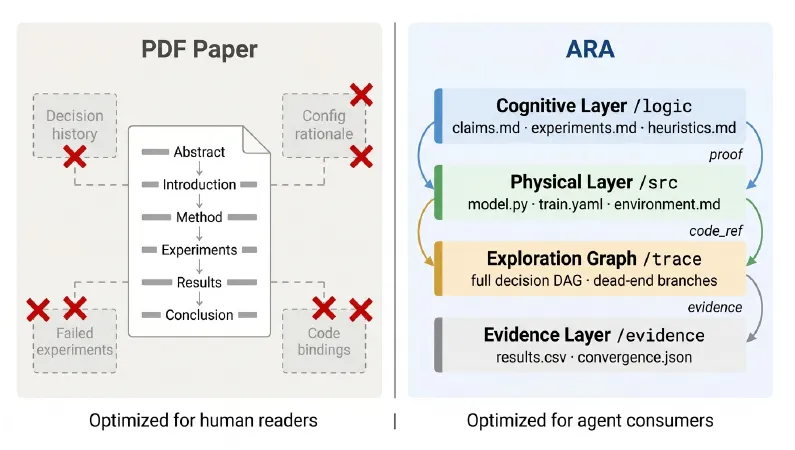
ARA 并不打算把 PDF 写得更长。它把科研成果从线性文本改造成结构化、可操作的文件系统,并分为四个彼此关联的层次:
/logic:研究为何成立。保存问题定义、核心假设、可证伪的 claims、实验计划、算法和关键 heuristic。/src:研究如何运行。保存核心代码、配置、环境、依赖、随机种子,以及选择超参数的依据。/trace:研究如何走到当前状态。保存完整的探索 DAG,包括 question、decision、experiment、dead-end 和 pivot。/evidence:结论由什么支撑。保存原始结果、训练日志、指标表和实验输出,而非只保留论文中经过四舍五入或文字概括的数据。
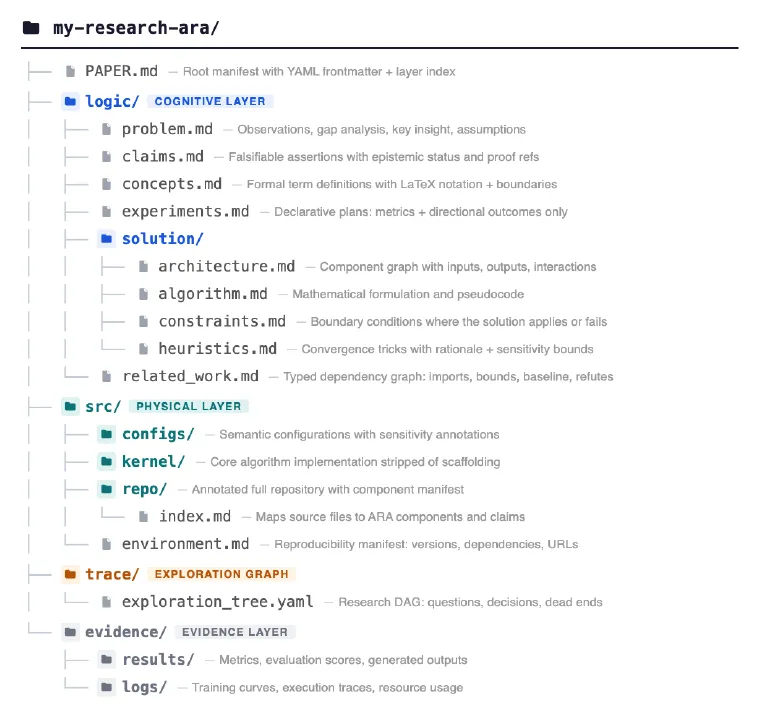
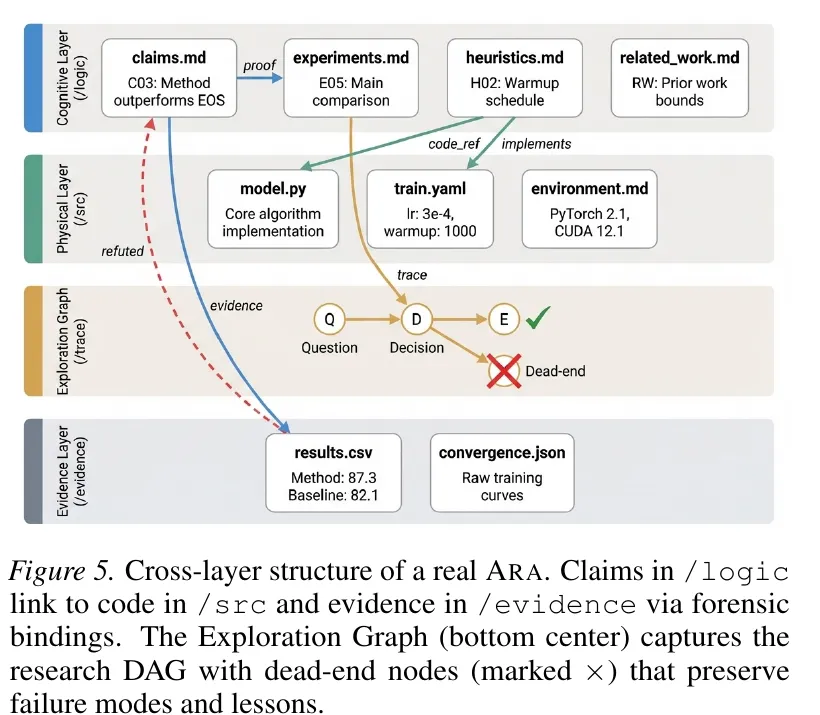
其中的关键设计是作者所说的 forensic binding。在传统论文中,结论、实验和实现细节往往分散在正文、附录、代码仓库与配置文件中。ARA 则建立一条可追踪链路:
Claim ↓Experiment ↓Code / Config ↓Raw EvidenceAgent 可以从某个 claim 出发,找到用于验证它的实验,再定位到相应代码、配置和原始结果,不必先读完几十页 PDF 后再猜测材料之间的对应关系。
/trace可以理解为一份“科研版 Git log”。它既记录最终采用了什么,也保留尝试过什么、失败原因以及转向依据。原本容易被当作噪声删除的失败实验,由此成为可复用的 negative knowledge。
让研究过程自动沉淀为记录
如果研究者必须每天手动维护大量 YAML 和 Markdown,ARA 很可能演变成新的文档负担。为此,作者设计了 Live Research Manager,让记录在日常的人机协作中自动生成。
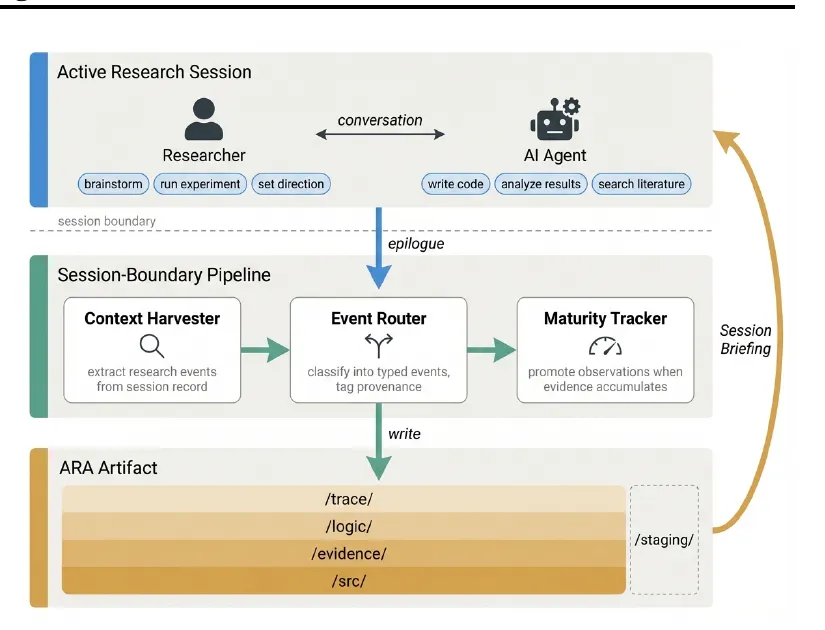
一轮研究会话结束后,系统分三步处理信息:
Context Harvester从对话、tool outputs、实验结果和代码 diff 中提取具有研究价值的事件;Event Router判断事件属于 claim、experiment、decision、dead-end 还是其他类型,同时记录来源;Maturity Tracker则根据证据积累更新观察的成熟度,避免把 Agent 的每个猜测立即写成事实。
ARA 还明确标注信息来源,例如 user、ai-suggested、ai-executed或 user-revised。记录不仅说明结论是什么,也交代结论由谁提出、如何形成,以及经过了哪些验证。
针对已有的传统论文,作者还设计了 ARA Compiler,可将 PDF、代码仓库、实验日志乃至既有 trajectory 重新编译为 ARA;配套的 ARA Seal依次检查结构完整性、论证严谨性和可执行复现性。它并非要用 AI 取代审稿人,而是把引用是否对应正确实验、claim 是否有证据、代码能否运行等机械检查交给机器,让人把注意力放在 novelty、significance 和 research taste等需要判断的问题上。
从理解论文到运行实验,ARA 带来了多大帮助?
作者把 Agent 使用科研成果的能力分为三个逐步提高的层次:
Understanding → Reproduction → Extension
在理解实验中,作者构造了 450 个配对问题。ARA 的总体准确率为 93.7%,“PDF + 代码仓库”基线为 72.4%。分项结果也呈现出清晰差异:
对论文原本包含的信息,ARA 与基线分别为 95.6% 和 80.8%; 对实现和配置细节,分别为 92.6% 和 67.8%; 对失败实验和 dead-end,分别为 81.4% 和 15.7%。
最后一项差距说明,ARA 的作用不只在于帮助 Agent 更准确地读取 PDF。更重要的是,它让以往不会进入论文的研究过程,首次成为可检索、可利用的正式资产。
随后,作者要求 Agent 复现 15 篇 PaperBench 论文中的 150 个子任务。按难度加权后,ARA 将复现成功率从基线的 57.4% 提高到 64.4%。
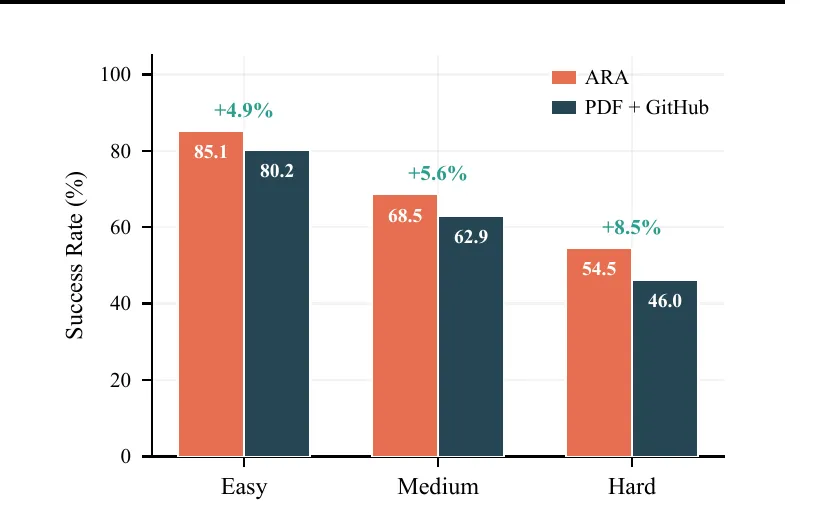
这一趋势比单一总分提供了更多信息。安装环境、实例化模型等简单任务,通常依靠代码仓库就能完成;任务复杂后,缺失的配置、实现细节和工程经验开始成为主要障碍,结构化研究信息的价值也随之显现。
失败经验也可能限制更强的 Agent
在最后的 Extension实验中,作者让 Agent 在 5 个 RE-Bench 开放式任务上继续寻找比既有结果更好的方案。结果显示,ARA Agent 在 5 个任务中都更早找到第一个有效改进,但最终只有 3 个任务取得了更好的最佳成绩。
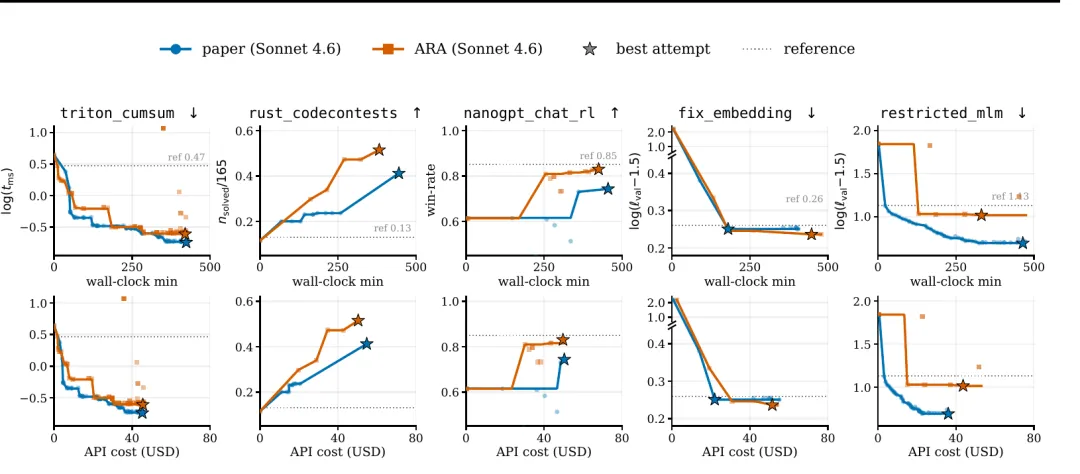
在 triton_cumsum任务中,ARA Agent 沿着历史记录推荐的方向继续优化;缺少这些提示的 paper Agent 则持续重新设计 kernel,最终发现 trace 从未记录的 int8 input compression,并在后期反超。
restricted_mlm中出现了相似情况。ARA Agent 逐一尝试历史 heuristic 中列出的替代架构,paper Agent 则没有受既有选项限制,把大部分计算投入自己提出的新路径,最终获得更好的结果。
这些结果表明:
Research memory 不必然带来更强的 research ability。它可以加速探索,也可能形成锚点。
当 Agent 的独立探索能力有限时,失败经验和有效 heuristic 可以显著缩小搜索空间;当 Agent 已经有能力跳出旧经验,过于明确的历史轨迹又可能形成 exploration bias,使其倾向于沿着已有方向继续搜索。
论文在能力较弱的 Sonnet 4.5 上进一步观察到:在上述两个任务中,历史 trace 重新带来了优势。因此,一段科研记忆的价值,取决于既有记录所包含的信息与当前 Agent 自主发现能力之间的关系。
问题也由“如何保存更多信息”推进到了下一层:Research Agent 不能只是把所有历史经验放进上下文,还要判断哪些经验值得继承、哪些只应作为参考,以及何时需要暂时放下已有路径,重新探索。
从 Paper-centric 转向 Research-state-centric
ARA 关注的并非新增几类 Markdown 或 YAML 文件,而是重新安排论文在科研系统中的位置。
传统论文模式与 ARA 所设想的研究状态模式,可以用下面这张图概括:
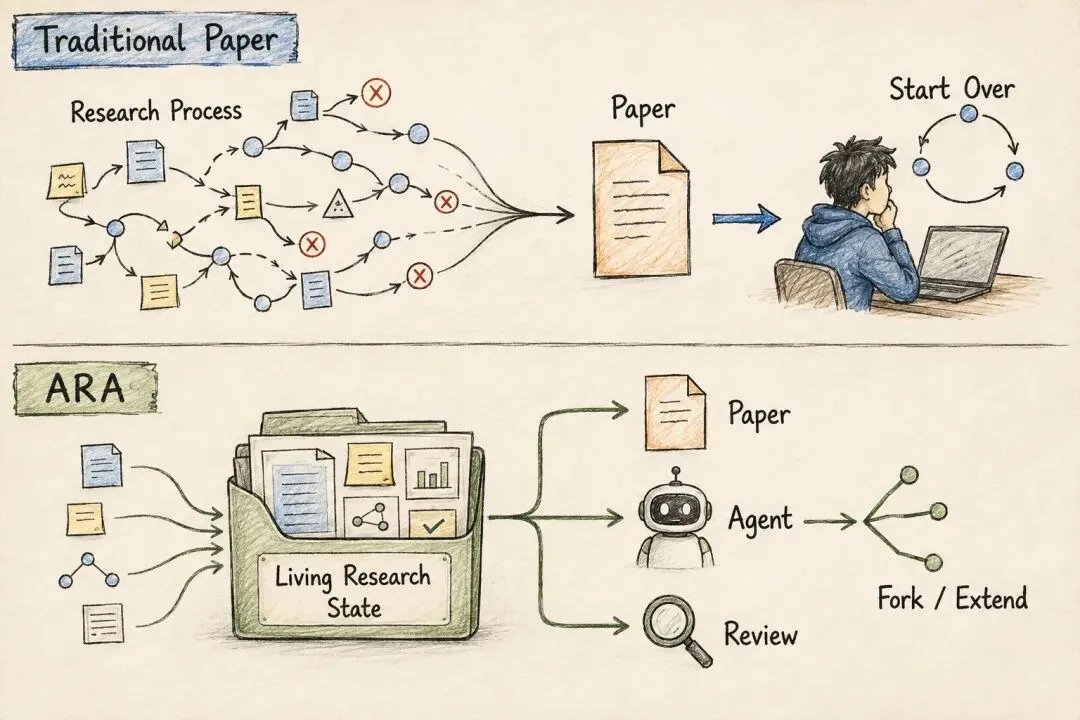
在这一框架下,paper 不等于研究本身,而是底层 research state 面向人类阅读的一种视图。
如果这种模式成立,未来的科研成果可以像软件一样被 fork、diff、验证和继续开发。新的 Agent 不必从论文中重新“考古”整个项目,而能直接加载上一项工作的研究状态,在完整的 claims、代码、证据和失败记录上继续推进。
论文题为 The Last Human-Written Paper,讨论的重点却不是“AI 会不会取代人类写论文”,而是另一个更基础的问题:
当科研的生产者和使用者都开始包含 AI Agent,我们是否仍应把三百年来为人类阅读设计的线性文档,作为科研知识唯一的核心载体?
ARA 的回答是:让论文回到“视图”的位置,把可执行、可追踪、可继承的研究知识放在科研系统的中心。
这或许比让 AI 自动写出一篇更好的论文,更值得讨论。
论文:The Last Human-Written Paper: Agent-Native Research Artifacts
代码:ARA-Labs/Agent-Native-Research-Artifact