ARTICLE · 1049323
AI不再比谁大了:小模型开始替大模型分担
这两天我一直在盯一个不那么热闹的方向。
过去两年,AI的新闻几乎都长一个样:谁的参数更大、谁的榜单更高、谁的集群更多卡。大家都在往"更大"这个方向使劲。
但让我觉得真正有意思的事,发生在另一头——那些"更小"的模型,忽然被派上了主力岗。
本期导读
一件小模型干活的真事 被忽略的那笔账:搬运 我的判断:主线从"更大"转向"更省" 一手推理:分工是怎么发生的 一个新角度:算力之争,掺进了物流味 对普通人和企业意味着什么 留个问题给你
一件小模型干活的真事
据公开报道(2026年9月),一个由菲尔兹奖得主参与的创业团队,做了一件挺取巧的事:他们没去训练一个更大的模型,而是把手机端的4B小模型(Qwen-3.5)和云端的753B大模型(GLM-5.2)配成一对用。
据这家团队的说法,这个组合小模型补上了和大模型之间约一半的性能差距,而推理成本被压到大约二十分之一。
同期,端侧芯片这条线也在往前走。据2026年9月的公开报道,有嵌入式芯片用多颗联合带动6710亿参数级模型、16B模型运行功耗不到5瓦;有车规芯片做到5nm、650TOPS,端侧大模型预处理速度约为Mac Mini(M4 Pro)的2.4倍;还有存算一体路线,本地算力190TOPS、最高支持1220亿参数本地部署,无网环境每秒约50 tokens、功耗约30瓦。
这几条单看都像产品新闻,且均为厂商自述口径、第三方尚未跟进核验。但把它们摆在一起看,是一件事:小模型开始有底气接活了。
💡 我的判断:AI竞争的下一条主线,可能不是"谁更大",而是"谁分工更省"。大模型包打天下的时代,正在悄悄松动。
被忽略的那笔账:搬运
让我把这件真事里最有意思的一段单独拎出来。
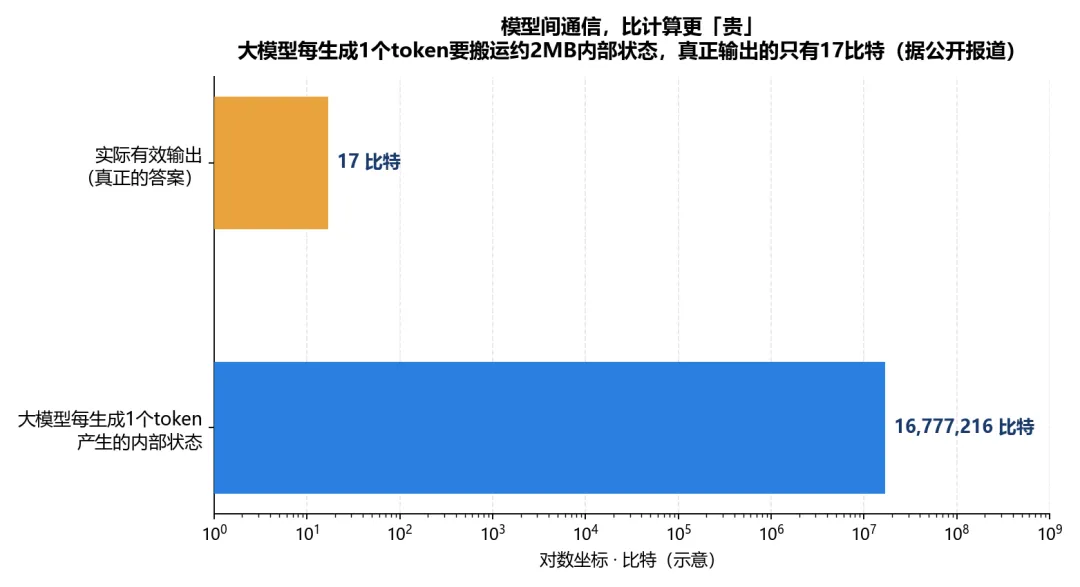
这个团队解决的问题,不是算得不够快,而是"模型之间说话"太不划算。有个说法我看了好几遍才转过弯:大模型每生成1个token,内部会产生约2MB的状态,而它真正输出的有效信息,只有17比特。
2MB 换来 17 比特。 这意味着,真正的负担往往不在"算",而在"搬"——把一大堆内部状态从这儿挪到那儿。
(上述数字均转引自2026年9月的公开报道与厂商公开表述,属说明性的量级示意,非精确统计。)
顺着这个思路,很多事一下子说得通了:为什么端云协同会比"什么都丢给云端"更划算,为什么"把简单活留在本地"能省下大笔开销。
⚠️ 提醒:这里容易搞反。省下来的不是计算能力,而是通信与搬运那一环。计算依旧贵,只是很多计算压根不必跑到大模型那边去做。
我的判断:主线从"更大"转向"更省"
我自己的看法是,行业的胜负手正在换挡。
前两年的大模型公司,逻辑是"更大=更强=更贵=更有壁垒",谁的参数大谁就站在台上。现在,这条逻辑开始被算账打断——当通信和搬运的成本被摆上台面,"更省"比"更大"更容易被买单。
一句话概括:不是小模型变强了,是"把活分下去"这件事终于划算了。
一手推理:分工是怎么发生的
我试着把这个变化推下去,大概是这么一条链:
第一步,通信/搬运成为瓶颈——模型越强,内部状态越大,挪一次越贵。
第二步,既然搬运贵,最省的办法就是"让活留在原地":能在端上做的(回消息、认图、清数据、跑小批任务),就别上云。
第三步,出端的量骤降,响应变快,数据也不必全往外走——顺带把隐私顾虑压下去一截。
第四步,大家发现"大模型包打天下"并不经济,模型开始走向分工:大模型管难题,小模型管日常。
四步走下来,结论挺朴素:这是"分工省下来的钱,最后落到用的人头上"。 和大厂砍AI预算的逻辑是一回事,只是这次省的不是模型选型的钱,而是"搬运"的钱。
一个新角度:算力之争,掺进了物流味
媒体常见的解读是"端侧芯片更强了""手机也能跑大模型了"。我觉得这说得没错,但没说到点上。
更本质的变化,是边界被重划了——哪些活必须出端、哪些活不必出端,正在被重新定义。过去因为端上跑不动,什么都往上送;现在很多活就地解决,"出端"从默认选项变成了需要论证的选择。
有意思的是,这跟物流挺像。同样的货,有人比"谁的车更能装",有人比"谁的仓库放得近"。当搬运本身成了大头,比"谁更大"就会输给比"谁更近"。
🚨 红线:话说回来,"本地跑"三个字现在被用得很泛。真要落到复杂长任务、专业判断、严谨复核,端侧小模型还差得远。分工不等于小模型能独立顶大梁,把它当主力会翻车。
对普通人和企业意味着什么
说回实在的。
对普通人:你手里的AI会更便宜、更快、更私密。离线也能用上的能力会变多,响应会更利索,很多东西不必再"上传了才能用"。这些变化不会敲锣打鼓,但会一点点渗进日常。
对企业:选型的逻辑要改。过去是"能上最强就上最强",现在是"哪层活配哪层模型"。会用大模型的团队多,会给模型"派活分工"的团队少——这道题的难度,不比当年学Prompt低。
生成能力越来越不稀罕之后,真正拉开差距的,是你能不能把活拆开、派对、再验收。 模型再小也一样,得有人安排它干什么。
换个角度想:这两年我们盯着"模型能长多大",可能不如盯着"模型能分多细"。
因为"更大"是厂商的比赛,"更省"才是你的红利。
最后留个问题:你手上那些每天都在重复的活,有没有哪些其实根本不必动用最强的大模型?
说明:本文由AI辅助创作并经过人工审核修改,数据均标注来源。
关注「拙勤守新」· 用AI认知提升工作效率!