ARTICLE · 1050408
Linux 6.12 源码深度剖析: handle_mm_fault
Linux 6.12 缺页异常核心机制:handle_mm_fault 深度解析
在 Linux 内核中,虚拟内存管理(Virtual Memory Management)的核心魔术之一就是按需分页(Demand Paging)。而 handle_mm_fault 函数则是这场魔术的幕后总指挥。无论是用户态程序首次访问未分配物理内存的虚拟地址,还是写保护(Copy-on-Write)触发的页面复制,最终都会汇聚到这个函数中。
本文将基于 Linux 6.12 源码,深入剖析 handle_mm_fault 的架构设计、源码实现、跨模块协同机制以及生产环境中的调优实战。
📌 技术点速览
解决什么问题:
handle_mm_fault解决了虚拟地址空间(VMA)与物理内存页(Page Frame)之间的动态映射问题。当 CPU 访问某个虚拟地址遭遇 MMU 翻译失败(缺页中断)时,该函数负责分配物理内存、建立多级页表映射、或从外存(Swap/磁盘文件)将数据加载到内存中。处于系统什么位置:它处于体系结构相关异常处理层(如
Arch_ARM64的do_page_fault)与通用内存管理子系统(MemoryManagement)的交界处,是硬件异常向软件逻辑过渡的关键枢纽。软件模块归属:
接口声明与非 MMU 桩函数归属于
Include(通用头文件模块)。核心业务逻辑实现归属于
MemoryManagement(内存管理系统,具体在mm/memory.c)。硬件异常捕获与上下文装配归属于
Arch_ARM64/Arch_ARM32(体系结构相关模块)。
🗺️ 软件功能架构图
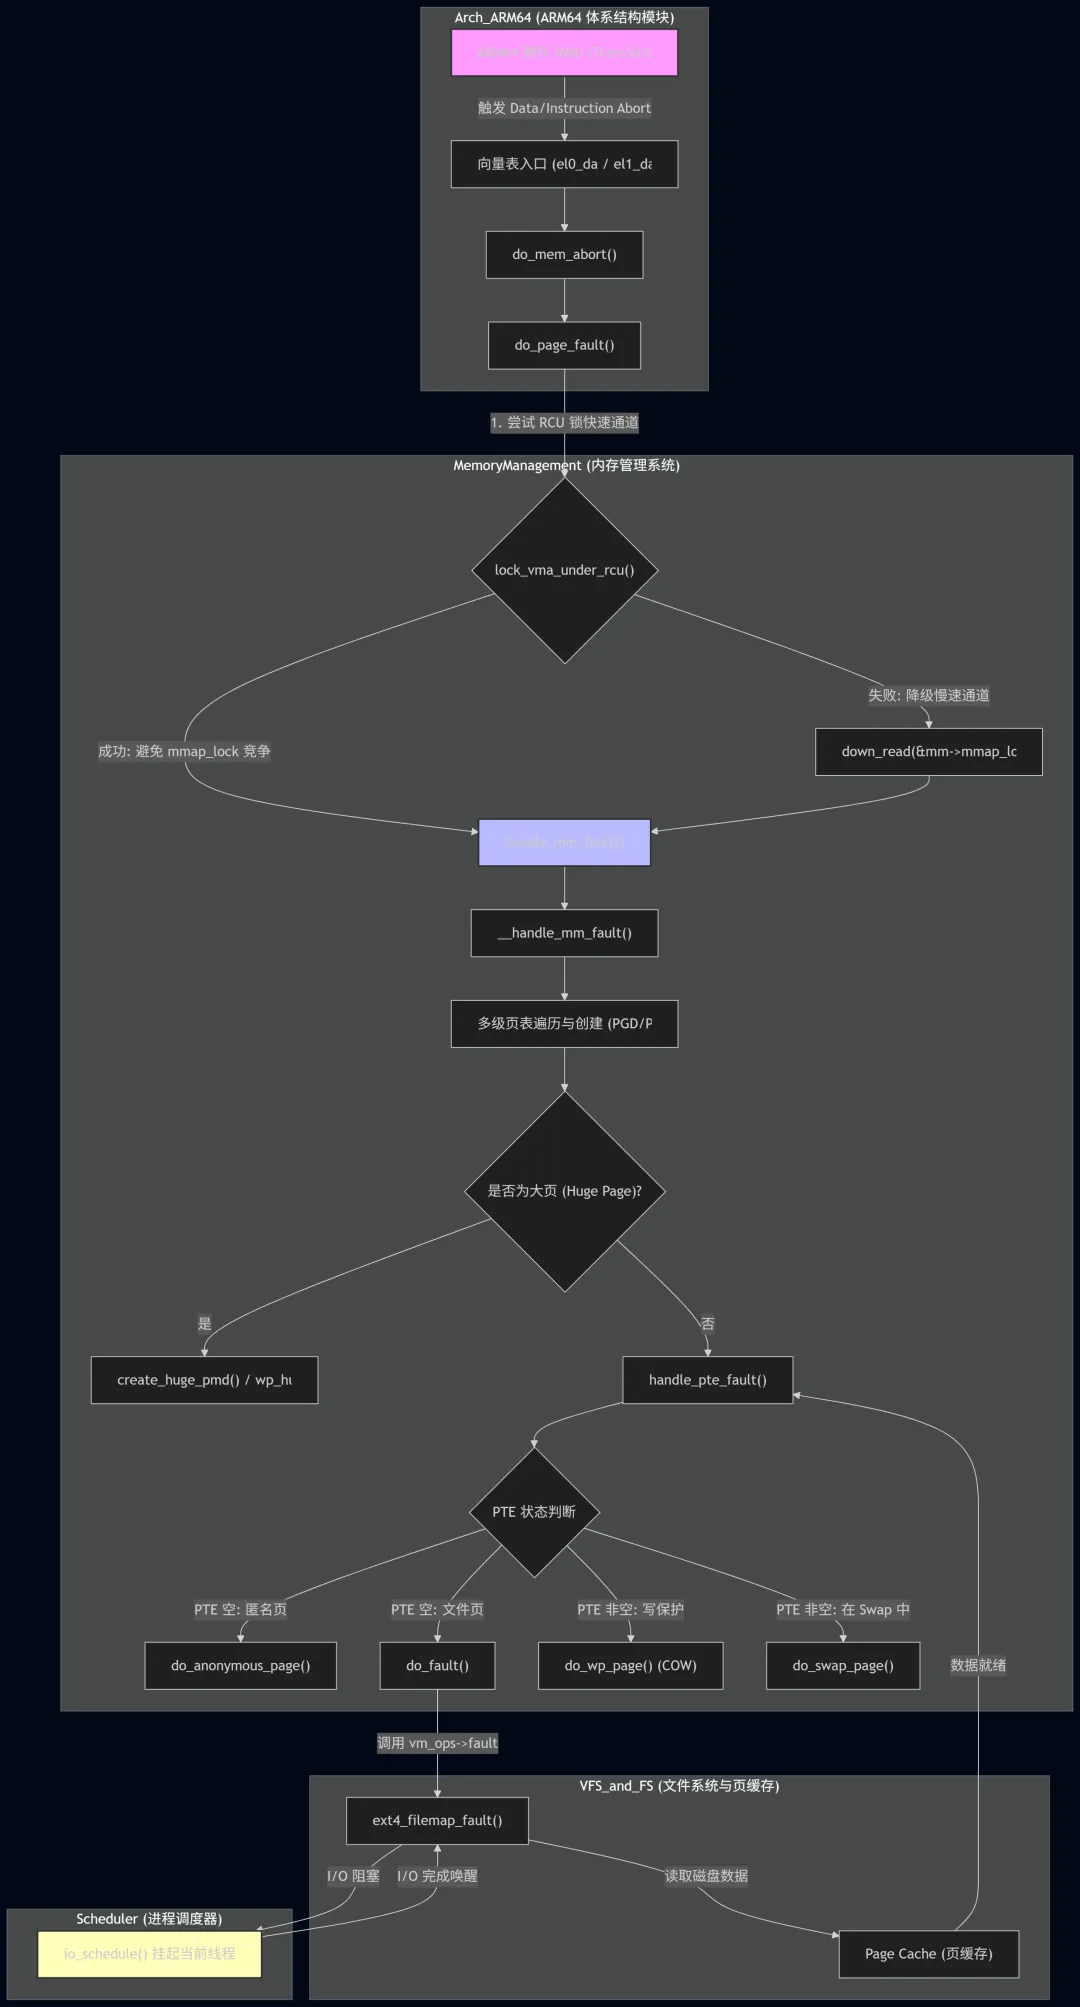
以下架构图展示了从 ARM64 硬件触发缺页异常,到内核跨模块协同处理,最终通过 handle_mm_fault 解决异常的完整生命周期。
🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 中,如果系统未启用 MMU(例如某些微控制器),include/linux/mm.h 中会提供一个内联桩函数:
// 路径: include/linux/mm.hstaticinlinevm_fault_thandle_mm_fault(struct vm_area_struct *vma,unsigned long address, unsigned int flags,struct pt_regs *regs){/* 没有 MMU 的系统不应该走到这里,直接触发内核 BUG */BUG();return VM_FAULT_SIGBUS;}
然而,在支持 MMU 的主流架构(如 ARM64)中,真正的核心入口位于 mm/memory.c。下面我们重点解析 mm/memory.c 中的 __handle_mm_fault 及其核心子函数 handle_pte_fault。
1. 核心入口:__handle_mm_fault 源码解析
// 路径: mm/memory.c (Linux 6.12)static vm_fault_t __handle_mm_fault(struct vm_area_struct *vma,unsigned long address, unsigned int flags, struct pt_regs *regs){struct vm_fault vmf = {.vma = vma,.address = address & PAGE_MASK, // 屏蔽低位,获取页对齐的虚拟地址.flags = flags,.pgoff = linear_page_index(vma, address), // 计算文件偏移量.gfp_mask = __get_fault_gfp_mask(vma), // 根据 VMA 属性获取内存分配掩码};struct mm_struct *mm = vma->vm_mm;pgd_t *pgd;p4d_t *p4d;vm_fault_t ret;// 1. 增加当前进程的缺页计数器 (统计信息收集)count_vm_event(PGFAULT);count_memcg_event_mm(mm, PGFAULT);// 2. 遍历并创建全局页目录 (PGD)pgd = pgd_offset(mm, address);// 3. 遍历并创建 P4D 目录 (针对 5 级页表架构,ARM64 常用 4 级,此处通常直接返回 pgd)p4d = p4d_alloc(mm, pgd, address);if (!p4d)return VM_FAULT_OOM;// 4. 遍历并创建上级页目录 (PUD)vmf.pud = pud_alloc(mm, p4d, address);if (!vmf.pud)return VM_FAULT_OOM;// 5. 处理 PUD 级别的大页 (如 1GB 巨页)if (pud_none(*vmf.pud) && __transparent_hugepage_enabled(vma)) {ret = create_huge_pud(&vmf);if (!(ret & VM_FAULT_FALLBACK))return ret;}// 6. 遍历并创建中间页目录 (PMD)vmf.pmd = pmd_alloc(mm, vmf.pud, address);if (!vmf.pmd)return VM_FAULT_OOM;// 7. 处理 PMD 级别的大页 (如 2MB 巨页 / THP)if (pmd_none(*vmf.pmd) && __transparent_hugepage_enabled(vma)) {ret = create_huge_pmd(&vmf);if (!(ret & VM_FAULT_FALLBACK))return ret;}// 8. 降级到标准的 4KB 页表 (PTE) 处理return handle_pte_fault(&vmf);}
💡 核心职责解析:
多级页表按需创建:Linux 采用惰性分配机制。进程创建时,并不会为其分配完整的页表。
__handle_mm_fault的核心职责之一就是在运行时动态建立页表结构(通过pud_alloc、pmd_alloc)。如果物理内存不足,直接返回VM_FAULT_OOM。透明大页(THP)支持:在分配 PMD/PUD 时,内核会尝试检测是否可以建立大页映射(2MB 或 1GB),以减少 TLB 缓存失效,提升性能。
2. 细粒度分流器:handle_pte_fault 源码解析
当确定缺页发生在标准的 4KB 页面级别时,handle_pte_fault 负责根据当前 PTE(Page Table Entry)的状态,将请求分流到具体的处理函数。
// 路径: mm/memory.c (Linux 6.12)staticvm_fault_thandle_pte_fault(struct vm_fault *vmf){pte_t entry;// 1. 如果 PMD 此时为空,说明对应的页表项(PTE Table)还未分配if (unlikely(pmd_none(*vmf->pmd))) {vmf->pte = NULL;} else {// 2. 否则,获取 PTE 的虚拟地址并加锁 (PTE Lock)vmf->pte = pte_offset_map_lock(vmf->vma->vm_mm, vmf->pmd,vmf->address, &vmf->ptl);if (!vmf->pte)return 0;vmf->orig_pte = *vmf->pte; // 记录原始的 PTE 值}// 3. 情况 A: 页表项完全为空 (说明该虚拟地址从未映射过物理内存)if (!vmf->pte || pte_none(vmf->orig_pte)) {if (vmf->pte)pte_unmap_unlock(vmf->pte, vmf->ptl);// 判断是匿名页还是文件映射页if (vma_is_anonymous(vmf->vma))return do_anonymous_page(vmf); // 分配零页 (Anonymous Page)elsereturn do_fault(vmf); // 从文件系统加载数据 (File-backed Page)}// 4. 情况 B: 页表项不为空,但 Present 位为 0 (说明页面被置换到了 Swap 空间)if (!pte_present(vmf->orig_pte)) {if (vmf->pte)pte_unmap_unlock(vmf->pte, vmf->ptl);return do_swap_page(vmf); // 从 Swap 分区换入内存}// 5. 情况 C: 页面在内存中,但发生了写操作且该页是只读的 (Copy-on-Write)if (vmf->flags & FAULT_FLAG_WRITE) {if (!pte_write(vmf->orig_pte))return do_wp_page(vmf); // 触发写保护,复制页面}// 6. 清理并释放页表锁if (vmf->pte)pte_unmap_unlock(vmf->pte, vmf->ptl);return 0;}
💡 核心职责解析:
并发安全保障:通过
pte_offset_map_lock获取细粒度的页表锁(PTE Lock),防止多线程并发访问同一虚拟地址时发生竞争(Race Condition)。精准状态机分流:通过对
pte_none、pte_present和pte_write的组合判断,完美覆盖了首次分配、写时复制、内存换入三大核心内存管理场景。
⚙️ 系统运行背景与上下文
handle_mm_fault 不是孤立运行的,它处于一个高度复杂的跨模块协同网络中。以下是其与中断处理、文件系统、进程调度等模块的协作流程:
[ 硬件层 ] CPU 执行指令 -> MMU 翻译失败 -> 触发 Data Abort 异常│▼[ 体系结构 ] Arch_ARM64: 捕获异常 -> 读取 FAR_EL1 (故障地址) -> 进入 do_page_fault()│▼[ 内存管理 ] MemoryManagement:│ 1. 尝试 RCU 锁 (Per-VMA Lock) 快速解析│ 2. 若失败,获取 mmap_lock 读锁│ 3. 调用 handle_mm_fault() -> 分配页表 -> 发现是文件映射页▼[ 文件系统 ] VFS_and_FS: 调用 vma->vm_ops->fault() (如 ext4_filemap_fault)│ 1. 检查 Page Cache 是否命中│ 2. 若未命中,向块设备驱动发起异步 I/O 请求▼[ 进程调度 ] Scheduler:1. 发现 I/O 未就绪,调用 io_schedule()2. 将当前进程设为 TASK_UNINTERRUPTIBLE,让出 CPU3. 磁盘 I/O 完成,中断处理程序唤醒进程4. 进程重新调度,完成页表映射,返回用户态重新执行指令
1. 现代内核优化:Per-VMA Lock (Linux 6.12 核心特性)
在传统的 Linux 内核中,进入 handle_mm_fault 前必须持有进程的 mmap_lock 信号量。在高并发多线程场景下(如多线程 JVM 或数据库),mmap_lock 会成为严重的性能瓶颈。
Linux 6.12 深度优化了 Per-VMA Lock 机制。在 do_page_fault 中,内核首先尝试调用 lock_vma_under_rcu()。如果成功,将无需获取全局 mmap_lock,直接在 RCU 锁保护下调用 handle_mm_fault。这极大地释放了多核 CPU 的并发吞吐量。
💡 10年老兵避坑指南/实战案例
案例一:高并发服务中的 mmap_lock 锁竞争导致 CPU 暴涨与服务雪崩
1. 生产环境背景
某高并发 Go 语言微服务,在业务高峰期突然出现响应时间(RT)飙升,CPU 使用率达到 100%,但实际业务吞吐量却急剧下降。通过 top 观察到系统调用(sy%)占比极高。
2. 根因分析
Go 运行时(Runtime)频繁进行堆内存申请和释放,底层会触发 mmap / munmap 系统调用,这些调用需要获取 mmap_lock 的写锁。 与此同时,高并发的业务线程在访问新分配的内存时,频繁触发缺页中断,进入 handle_mm_fault。这需要获取 mmap_lock 的读锁。
当写锁请求排队时,所有的读锁请求(缺页中断处理)都会被阻塞。数千个线程同时卡在 down_read(&mm->mmap_lock) 上,导致严重的自旋和上下文切换,CPU 被无意义地消耗在锁竞争上。
3. 排查方法 (使用 bpftrace 追踪锁延迟)
我们可以编写一个简单的 eBPF 脚本,实时监测 mmap_lock 的获取延迟:
/* mmap_lock_monitor.bt */#include<linux/mm_types.h>kprobe:__down_read_common {@start[tid] = nsecs;}kretprobe:__down_read_common {$start = @start[tid];if ($start != 0) {@latency_us = hist((nsecs - $start) / 1000);delete(@start[tid]);}}
运行结果输出:
@latency_us:[128, 256) 1203 |@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@|[256, 512) 854 |@@@@@@@@@@@@@@@@@@@@@@@@@@@@ |[512, 1024) 2301 |@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@|[1024, 2048) 15432 |@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@| -> 极高延迟!
可以看到,大量获取读锁的操作延迟超过了 1 毫秒(正常应在微秒级)。
4. 解决方案与调优
启用 Per-VMA Lock:确保内核版本为 Linux 6.2+(本例使用的 6.12 默认已高度优化此特性)。
调整内存分配器:将 Go 的
GODEBUG参数或 C/C++ 的内存分配器替换为jemalloc/tcmalloc,减少底层mmap的调用频次,通过内存池进行内部复用。预分配内存(Mlock):对于延迟极度敏感的系统,在启动时通过
mlockall(MCL_CURRENT | MCL_FUTURE)锁定内存,强制提前触发所有缺页中断(handle_mm_fault),避免在运行时动态分配。
案例二:大页(Transparent Huge Pages, THP)引发的系统卡顿(Latency Spikes)
1. 生产环境背景
某 Redis 缓存集群,在开启透明大页(THP = always)后,偶尔出现毫秒级的命令响应延迟,导致客户端连接超时。
2. 根因分析
当 handle_mm_fault 发现需要分配内存,且 THP 开启时,它会尝试调用 create_huge_pmd 分配 2MB 的连续大页。 然而,如果系统运行时间较长,物理内存存在严重的碎片化,无法直接找到连续的 2MB 物理页。此时,handle_mm_fault 会在内核态直接触发同步内存规整(Direct Compaction)。 这会导致当前分配路径被阻塞数毫秒甚至数十毫秒,用于在后台移动物理页以拼凑出连续空间,从而引发严重的延迟毛刺。
3. 调优方案
修改内核参数,将 THP 的配置从 always 改为 madvise,或者直接关闭:
# 1. 仅在程序显式调用 madvise(MADV_HUGEPAGE) 时才使用大页echo madvise > /sys/kernel/mm/transparent_hugepage/enabled# 2. 严禁在缺页中断中触发同步内存规整,将其降级为后台 kcompactd 异步处理echo defer > /sys/kernel/mm/transparent_hugepage/defrag
通过此项调优,handle_mm_fault 在无法直接获取大页时会迅速降级(Fallback)到普通的 4KB 页面分配,彻底消除了同步规整带来的延迟毛刺。