ARTICLE · 1051478
全球爆火JEV,他更可能是另外一个OpenClaw时刻,当“决策”被抽象为数据,判断变成概率,他只是理想状态的演绎
作者前言:
全球爆火JEV,他更可能是另外一个OpenClaw时刻,当“决策”被抽象为数据,判断变成概率,他只是理想状态的演绎。
AI在不停地发展,似乎总是有许多新的概念出现在我们面前,本来是机构与资本的竞逐,但普通人的“焦虑”,“欲望”,“变好的想法”被化身为新时代的“鞭子”,抽动着每个人不由自主地将自己情绪落在具体的行为上,我们成价值本身,这是一个好的时代,但又是被演绎的时代。
JEV 是什么、插在流程哪一步,以及我把它落到自己流水线上的完整方案。
先不看概念,看一个具体的动作。
你的 Agent(Intelligent Agent,智能体,能自己决定下一步做什么的程序)每决定下一步干什么,都要让大语言模型吐一段 JSON(JavaScript Object Notation,JavaScript 对象表示法,一种用文本表示结构化数据的格式),再把它解析成代码能用的东西。
这一步慢、贵,而且格式一歪就解析失败。
JEV 换掉的就是这一步。
JEV 是 TypeSafe 公司的 System One 判定模型。它只做一件事:读一段状态,返回一个带概率的类型化答案。它不写文章、不写代码、不解释理由。
先说清这篇的成色:21 个开源项目,我实读了 17 个仓库的原文,另 4 个只看到介绍;我自己那部分是真做过的事,但这条流水线我只出了方案、还没上线。
现在的 Agent 里,这三件事是混在一起的——笼统地说,都是"问大模型"。
JEV 把它们拆开:
| 生成 | ||
| 判断 | ||
| 执行 |
JEV 手里只有三把工具,官方叫三种原语:
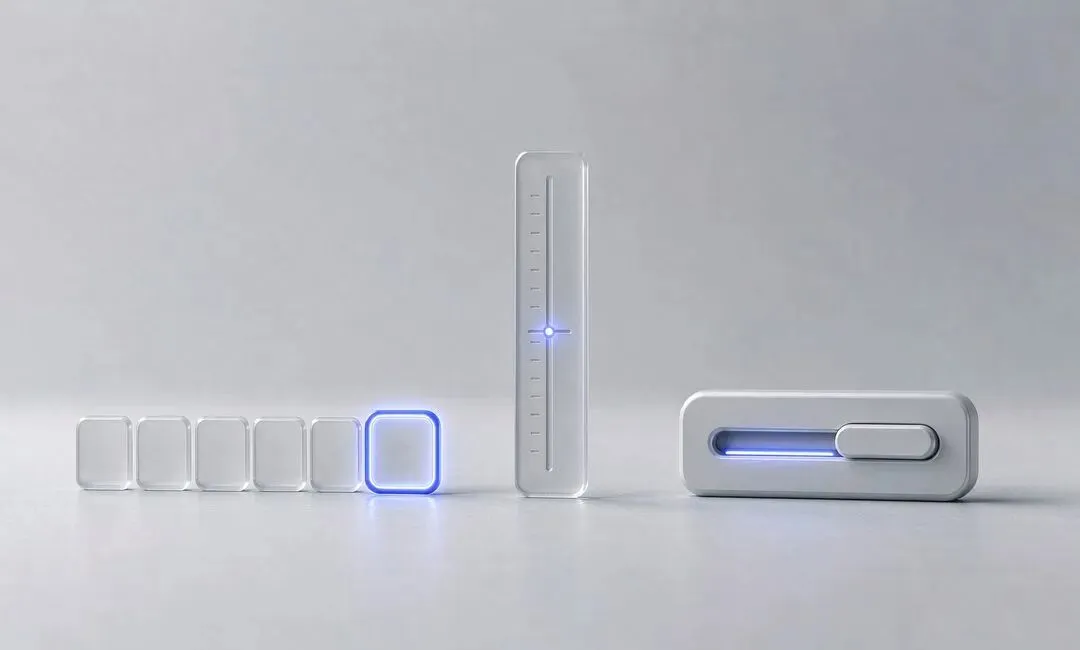
三种答案形状:选中一个 / 定在某一档 / 开或关
三条原语有一个共同点:只输出类型化答案 + 概率 + 置信度,不生成任何文本。
这句话要念两遍——它替掉的是"让大模型吐 JSON 再解析"这个环节,不是大模型本身。你要写文案、想方案,还是得靠大模型。JEV 只是把那些本来就不该由生成模型负责的微决策,从生成里摘出来。
把 Agent 的循环摊成一条时间轴,JEV 的介入位置可以归成五种。
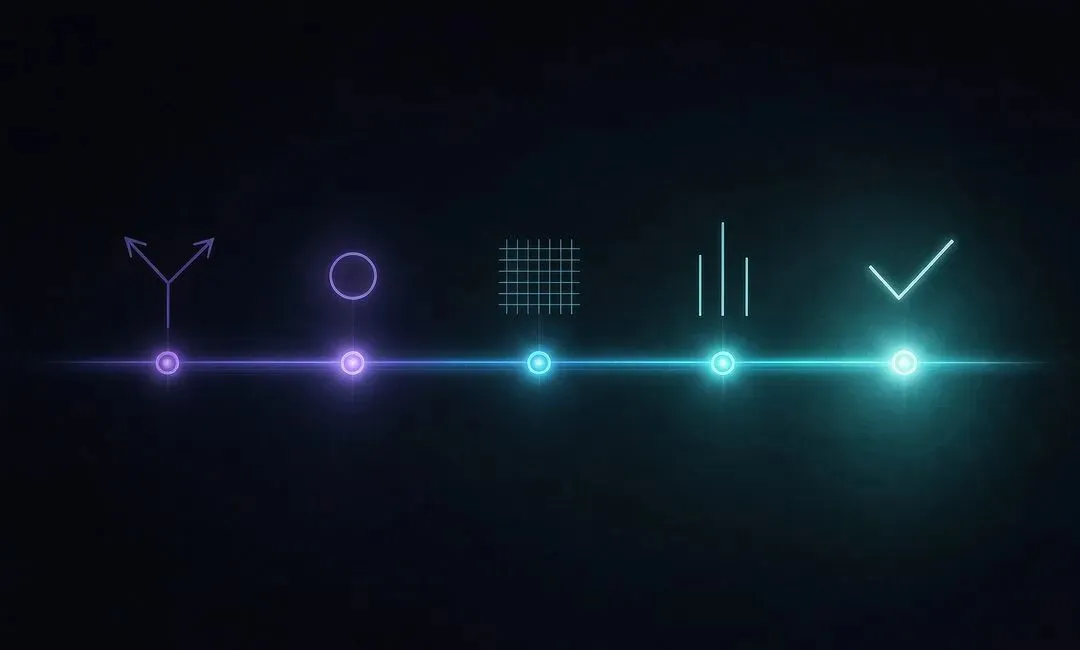
五个介入位,沿 Agent 循环的时间轴排开
② 最多不是巧合。Agent 里最高频的动作就是"每步选下一步干什么",而它又恰好是"让大模型吐 JSON 再解析"用得最密的地方。你要找一个改造点,从这里开始,命中率最高。
每个都按同一个套路看:送什么 → 问什么 → 拿到答案怎么走。
状态进 → 判定 → 答案出:四个案例共用同一条流水线
送:当前页面所有真实存在且可交互的元素的编号表([1] button · Change ticket type、[2] combobox · Where from?……)
问:一次请求,同时问"用哪个操作"和"目标是谁"
走:只执行与所选操作匹配的那一个目标;只有操作为"打字"时,才叫小模型写文字
数字上,它报过同一任务的浏览器协议调用从 1092 次降到 101 次、中位耗时从 9.450 秒降到 7.092 秒。它自己注明了:这是同一任务、同一浏览器配置下的重复测量,不是通用可靠性基准。
送:各模型的能力先验 + 当前请求 + 最近的助手意图 + 可用的工具结果
问:一个 Choice,在 15 个「模型档位 × 推理深度」组合里一次性选定
走:合法决策原样执行,即使多个组合很接近;另有影子模式(只记录不生效)和急停开关
它明确拒绝了一堆机械规则:没有关键词规则、没有低置信度回落。它报出的 −60% 是历史模拟,作者自己标注"不是实测节省的配额"——这句必须带上。
送:一段工具输出,切成约 25 行一块
问:每块一条 Noul——"这段对当前任务还需要吗"
走:低于 0.1 才隐藏,0.1 到 0.5 之间的一律保留;被隐藏的原文缓存起来,附一个恢复命令
它和"摘要式压缩"的区别是根本性的:摘要会丢东西(一个路径、一条报错、一个约束),筛子不会——只删不改,删错了能捞回来。
送:一份证据账本(文件变没变、命令跑没跑、退出码是多少)+ 最后一条消息
问:这条消息算不算在"宣称完工"
走:算 → 拦;至少 90% 确定不算 → 放行
它的 README 开篇记了一个真实场景:某个编码 Agent 用 shell 写了文件、什么都没跑,然后报告「Done. Skipped tests」。
④ 判分那一型,最好的样本是 monteduro/killmyidea:8 个维度各打 0–4 分,加权平均后给 KILL / FIX / SHIP。它有一个最该抄的设计——清晰度闸门:如果"这段需求能不能被理解"低于 0.3,它不给分也不给结论,只要求补充信息。
JEV 只吃文本 state(状态,喂给判定模型的全部输入)。送进去什么,决定答案对不对。
真正的门槛:从杂乱的一堆里,只挑出少数几条送进去
—— typesafe-computer-use 的作者自己写下的一句话
Canny 把它的核心规则写成了一句话,我认为这是整个生态里最值钱的一条:
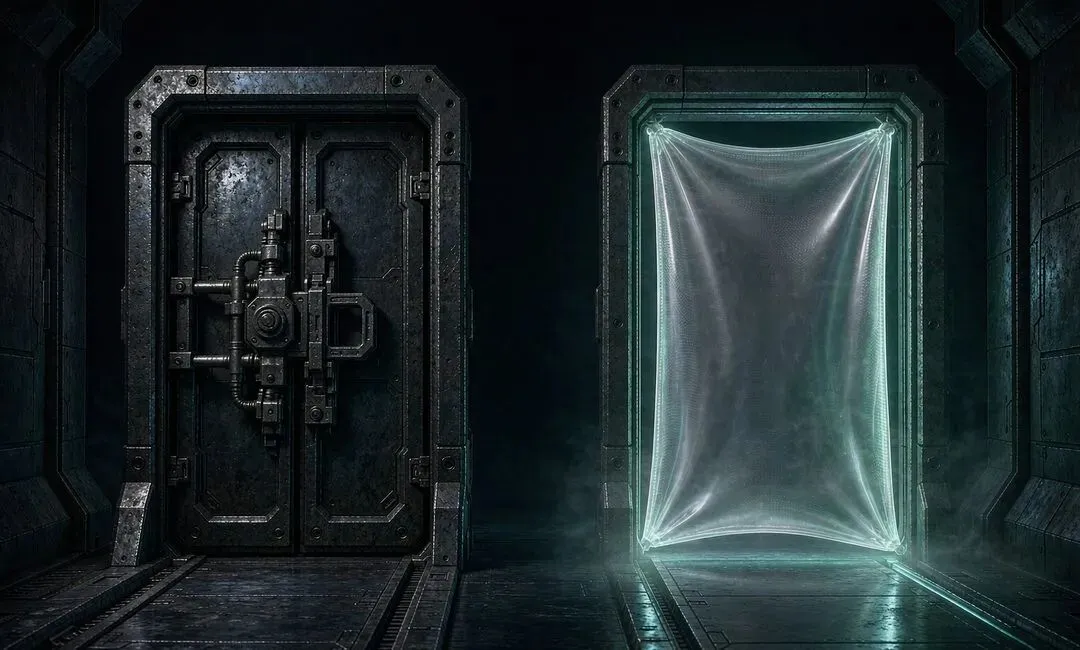
硬闸门(只有事实能否决)与软阀门(模型只能放宽)
拆开看:文件变了没有、命令跑了没有、退出码是 1 还是 0、正则数得出几个残留标签——这些是事实,代码离线就能判,不需要联网、不需要 API Key(Application Programming Interface Key,应用程序编程接口密钥,调用服务时用来验证身份的凭证)。
这条消息算不算在宣称完工、这句话会不会踩广告法的极限词——这些是判断,交模型。
怎么分?就问三句:
三个都答"能",它就是事实——留在代码里,别交给模型。
关键在最后半句:拦截权归确定性的规则,模型只能让门禁更宽松,不能更严。Canny 自己就是这么钉的——模型唯一能碰门禁的地方是它可以放行。
这样设计的好处是,模型出错的最坏结果是少拦一次,而不是乱拦。
上面全是别人的项目。下面是真做过的事——我把跑过的 7 篇文章的返工记录翻出来,9 条真实返工按"事实 / 判断"二分,5 条是事实。
按可行性分三档,从近到远:
反过来,这些别交给它:
三句话:
三个坑:当便宜 GPT 用、问综合大问题、让模型决定拦不拦。
标 ⭐ 的是我实读过仓库原文并做了拆解的;没标的只看到项目介绍。按介入位置分组。
微信正文里的外链不可点。想访问就复制 github.com/ 再加上表里的仓库名。
另有 harshwasan/pi-jev-sentinel(入口守卫 + 前置脱敏 + 失败关闭),不在原始清单里,但值得单独看。
这篇里的东西,一半是读别人代码读出来的,一半是我自己流水线上真踩的坑,肯定不是最优解。
如果你也在做 Agent 或者 AI 内容——路由、上下文压缩、质检、打分——欢迎在评论区说说你卡在哪一步。"模型不够聪明"只是表象,底下的该不该让模型决定每家都不一样,你的情况可能比我的更有意思。
如果你想让 AI 判断层落到自己的业务流程里,或者想先把那部分"其实该用代码写的检查"补齐,也可以直接联系我。这种事聊开了才有答案,欢迎找我一探究竟。
信的不是 AI 有多强,是一个普通人用 AI 能把手伸多远。
扫码关注「青山杂谈二三事」
一个普通人用 AI 做内容的真实记录。不吹不黑,踩过的坑都写下来。
这一篇讲的是判断层该插在哪、以及我落地方案的思路。
下一篇我把第 0 步做出来:写一份能跑的质检脚本,把"事实"从稿子里全部扫一遍,看它当年漏掉了多少。
一手实践(我做的):公众号流水线的 7 篇返工复盘、三型幻觉的划分、这张五型地图的整理方式,以及"先写脚本再接模型"这个结论。文中提到的我那套流水线改造方案,只出了方案、没有上线,相关推论请按"待验证"读。
整理 + 推演(别人的):21 个案例与五型地图,来自对第三方仓库原文的阅读和一条社交媒体帖子的整理。其中 17 个我实读了仓库原文;jkudish/jev-mcp、RomanSlack/jev-drone、emrickgarrett/OneVOneJev、irfndi/prism-liquidity-agent 只看到项目介绍,没有读到原文,附录 A 里已用未标 ⭐ 区分。文中所有成本、延迟、比例等数字,除官方定价外全部来自各项目作者自测,没有第三方复现;jev-codex-router 的 −60% 作者自己标注为"历史模拟,不是实测节省的配额"。
关于文中的判定结果:我对 JEV 的判断是用一份自建数据集跑出来的(22 条论断核验 + 21 个案例分诊 + 标题与标语选择 + 成稿逐节判分),原始输入输出都留了档。但要说清:证据文本是我准备的,它只能判断"论断有没有超出我给的证据",判断不了"我把证据截得对不对"。
平台提醒:各平台的界面与规则会变,以你操作时看到的为准。
版权:本文原创,转载请注明出处。© 2026 聂无双 · 青山杂谈二三事