ARTICLE · 1054621
承认落后!谷歌AI新统帅罕见摊牌:我们确实不如对手,但Gemini 4必夺回第一
科技巨头的大厂公关,向来习惯了粉饰太平。
但这一次,谷歌最核心的AI掌门人,直接把那块遮羞布扯了个粉碎。
在一段面向全球开发者的访谈视频里,刚刚接管 Google DeepMind 日常大权的高级副总裁兼首席 AI 架构师科雷·卡武克奥卢(Koray Kavukcuoglu),没有打任何官腔,直截了当地对着镜头承认:
“我能理解,显而易见,我们现有模型的质量确实略逊于最前沿(frontier)水平。坦率讲,外界这样评价十分公允。”
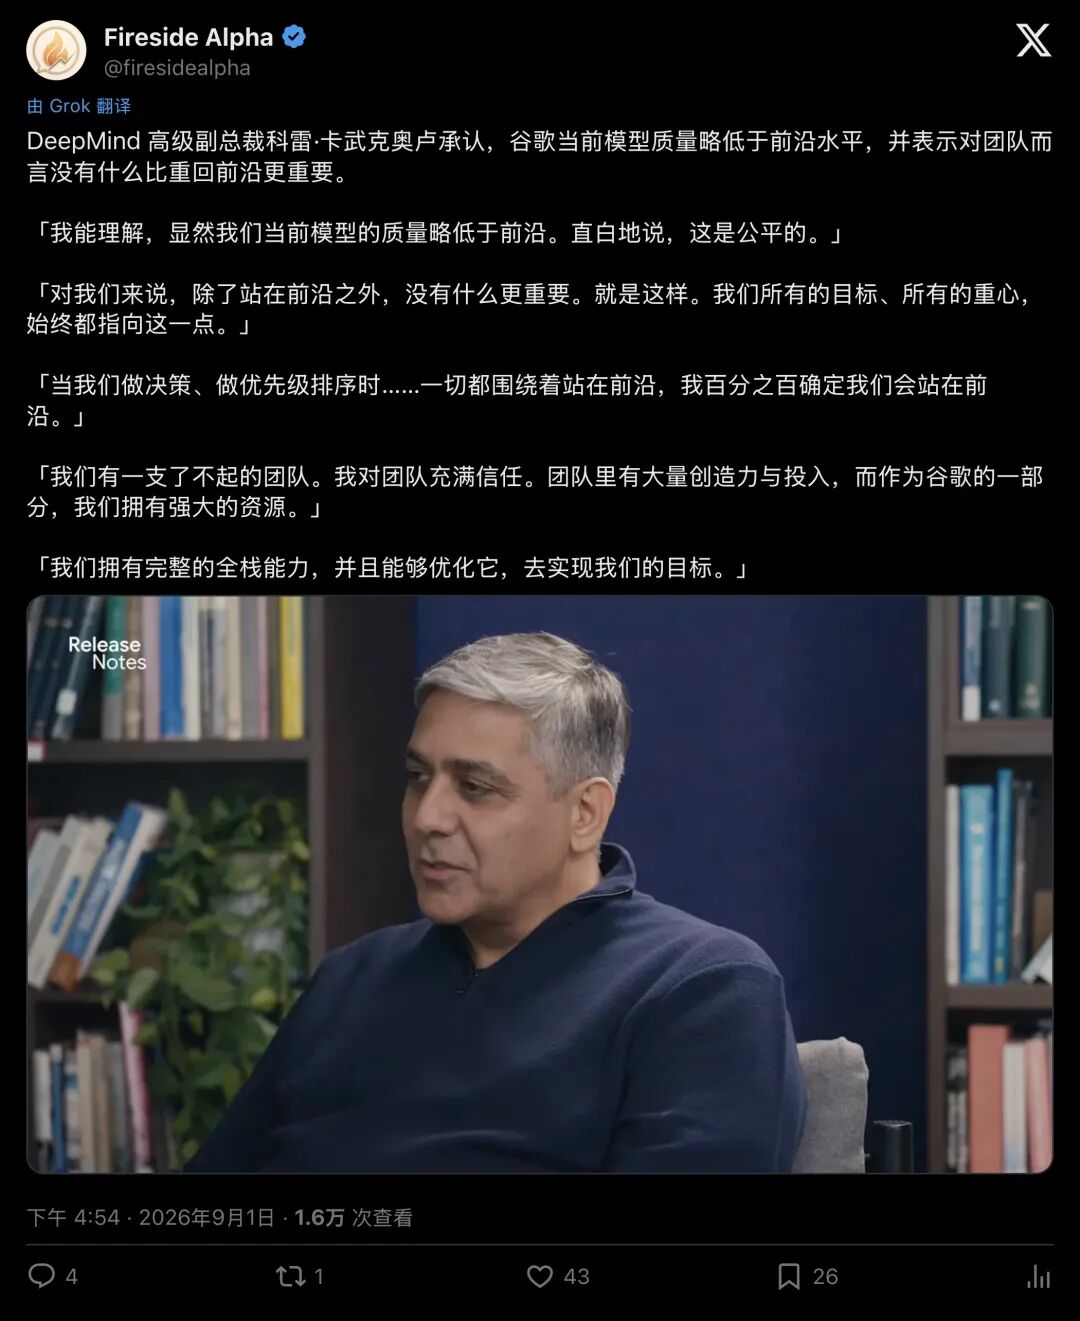
▲ 卡武克奥卢在访谈中罕见承认:当前模型质量略低于行业前沿
此话一出,硅谷震动
这是大模型竞赛打响以来,谷歌最高层极罕见的“公开认输”。但卡武克奥卢话锋一转,语气带着不容置疑的决绝:
“对我和我的团队来说,除了站在最前沿,其他一切都不重要。这是我们唯一的狂热,唯一的优先级。我百分之百确定,我们一定会夺回前沿。”
这是一场事关万亿巨头尊严的生死突围。
在经历人事剧震、资源错配的内部反思后,这头算力巨兽正处于一种极其罕见的“狂热与混乱并存”的战时状态。代号 Gemini 4 的下代核弹级模型,正在超大规模算力集群中日夜轰鸣。
谷歌究竟落后在哪里?它凭什么敢夸下海口“100%杀回第一”?
帝国换将:科学家退居幕后,工程狂人上前线
要看懂卡武克奥卢的底气,必须先看懂谷歌不久前发生的一场深层人事裂变。
2026年8月,谷歌首席执行官桑达尔·皮查伊(Sundar Pichai)发布了一封重磅全员信:DeepMind 创始人德米斯·哈萨比斯(Demis Hassabis)卸任日常运营,改任 DeepMind 主席兼 Alphabet 首席科学家;而接管整个实验室实际兵权的,正是卡武克奥卢。
与此同时,深度学习泰斗杰夫·迪恩(Jeff Dean)等人也选择淡出,另立独立探索机构。
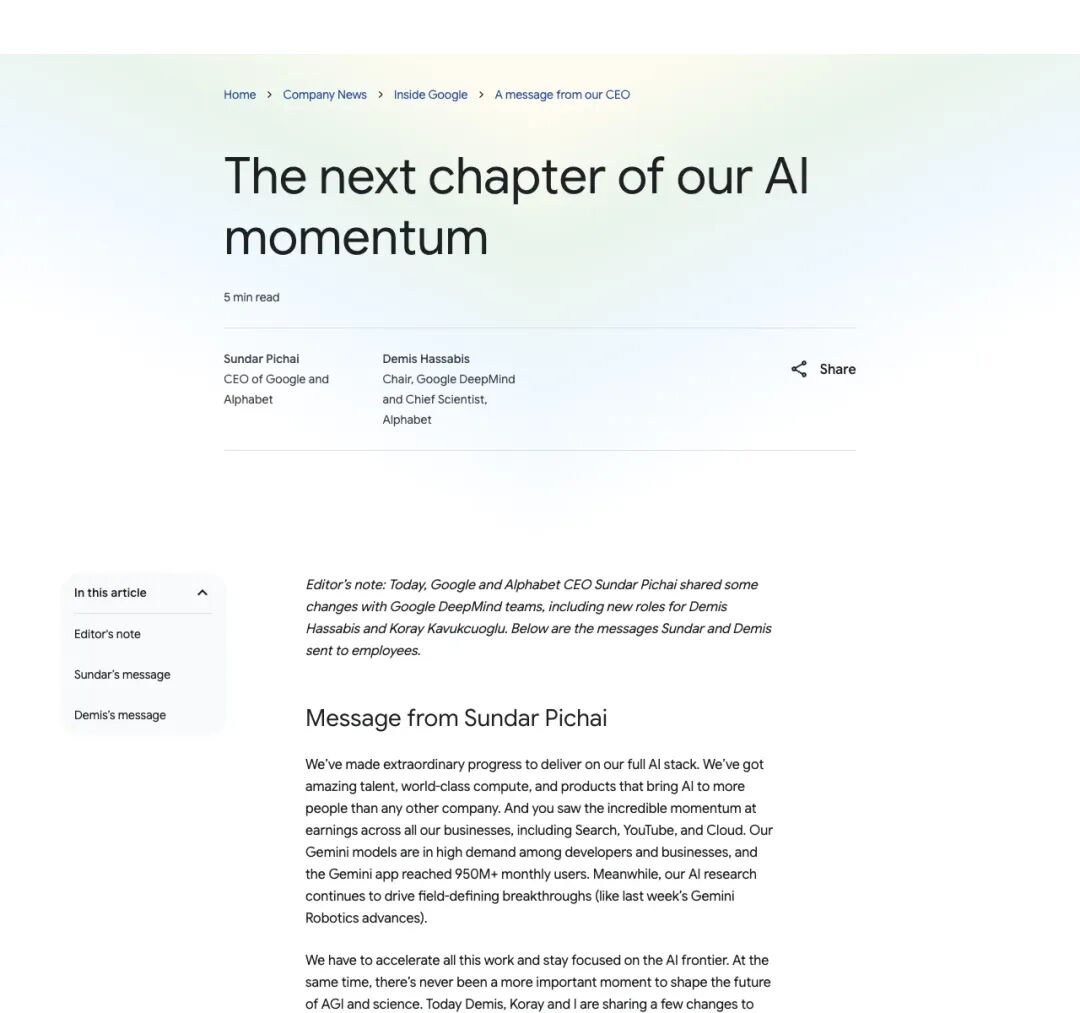
▲ 谷歌官方博客宣布人事变动:哈萨比斯退居宏观战略,卡武克奥卢接棒日常运营
这一人事剧震的本质,是谷歌 AI 战略从“象牙塔探索”全面倒向“战时工程交付”。
哈萨比斯是天才科学家,脑子里装的是用 AI 破解蛋白质结构、攻克物理极限、探索通用人工智能(AGI)的科学边界;但华尔街和全球开发者等不及了巨额的算力资本支出(Capex)必须转化为真金白银的商业回报,谷歌必须在每一天的 API 战场上,与 OpenAI 和 Anthropic 的 Claude 肉搏。
卡武克奥卢,正是那个最适合打硬仗的人。
他师从深度学习泰斗扬·勒昆(Yann LeCun),早年是让 AI 学会打街机游戏的 DQN 论文作者之一,后来又主导了革命性语音模型 WaveNet 落地谷歌产品的全过程。
他既懂顶层算法,又极其擅长“把极其复杂的模型工程化、塞进数亿人使用的产品里”。
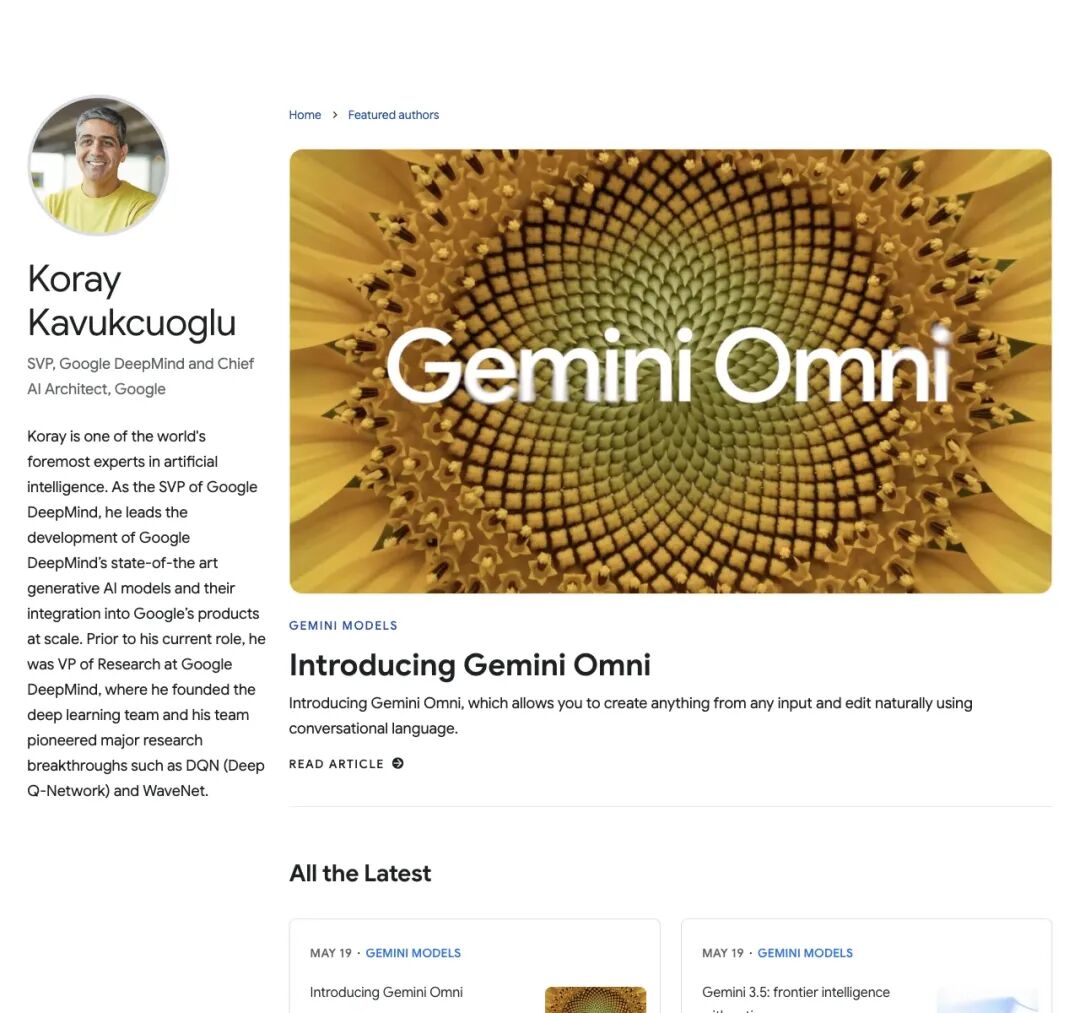
▲ 谷歌官方资料:卡武克奥卢升任 SVP 兼首席 AI 架构师,曾主导 DQN 与 WaveNet 研发
现在的 DeepMind,正蜕变为一支目标高度收敛、甚至有些冷酷的产品工程突击队,全力服务于商业落地与前沿交付。
致命失误:“我们把算力浪费在了花拳绣腿上”
为什么坐拥顶级人才与全球最大计算集群的谷歌,会在这一轮竞赛中“略低于前沿”?
谷歌 AI 开发者生态负责人洛根·基尔帕特里克(Logan Kilpatrick)在另一场对谈中,吐露了极为坦诚的内部反思:谷歌在过去一段时间,点错了技能树。
基尔帕特里克坦言,团队在资源分配上出现了战略误判。他们把庞大的算力和顶尖研究员,倾斜给了类似 Nano Banana 这样的消费级图像模型。
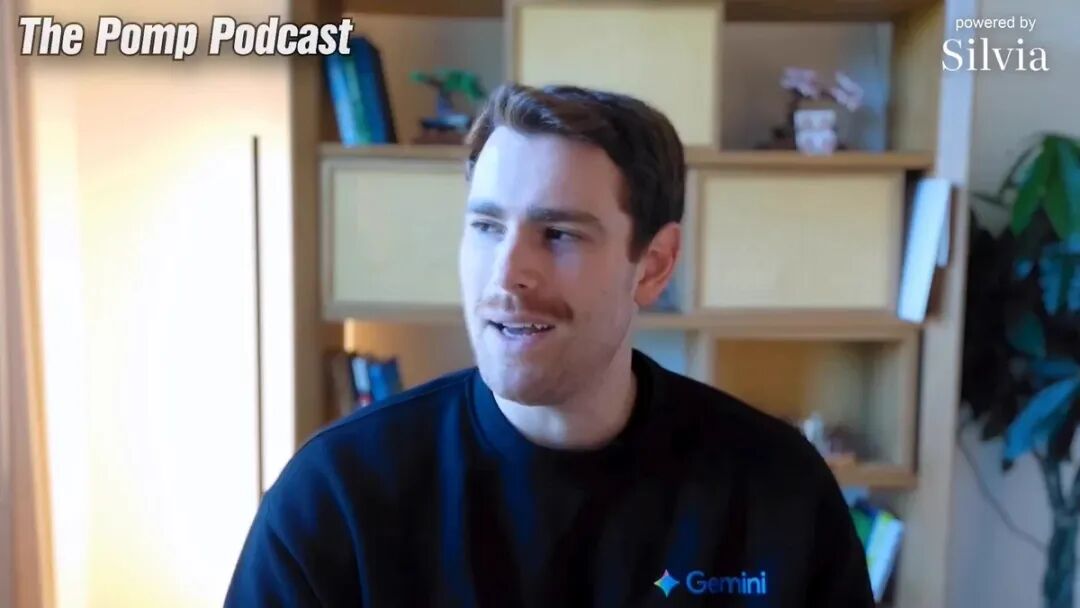
▲ 谷歌开发者生态负责人基尔帕特里克在播客对谈中反思:过度倾斜图像模型是战略失误
不可否认,图像模型发布后瞬间席卷社交网络,给消费端带来了惊人的流量和喝彩。
但狂欢掩盖了暗伤
这轮大模型角逐的核心制高点,集中在代码能力(Coding Agents)与复杂长程推理。纯粹的图像生成并不能构筑起长期壁垒。
代码是检验 AI 智商的最高硬指标,它具有极度严密的逻辑闭环、可自动验证对错,更是企业愿意为算力掏钱的最核心场景。
当 Anthropic 靠着写代码极其凶悍的 Claude 牢牢占据全球程序员心智、OpenAI 狂推编程工具时,谷歌才猛然惊醒:消费级的热闹是虚的,开发者与企业端的心智才是江山。
基尔帕特里克事后感叹:“现在回头看,一切都很明显。从资源分配的数量级来看,我们本该更早、更坚决地把更多资源投向编程智能体。”
狂热与混乱:Gemini 4 在烈火中预训练
亡羊补牢,未为晚也意识到差距的谷歌,正在内部掀起一场代号为 Gemini 4 的风暴。
据产品高管 Tulsee Doshi 透露,整个 Gemini 团队目前正处于一种极其罕见的状态,极度的兴奋,与不可避免的混乱并存。
为了夺回王座,谷歌把模型迭代节奏压缩到了极限,甚至保持着三到四周就发布一次小版本的“战时步调”。
更令工程师们心跳加速的是,他们已经观察到了“递归自我改进(Recursive Self-Improvement)”的早期迹象:
更聪明的 AI 模型开始反哺工程,帮助工程师自动编写训练管线、优化评测工具、构建更干净的数据集。这让下一代模型的进化速度,呈现出非线性的陡峭上升。
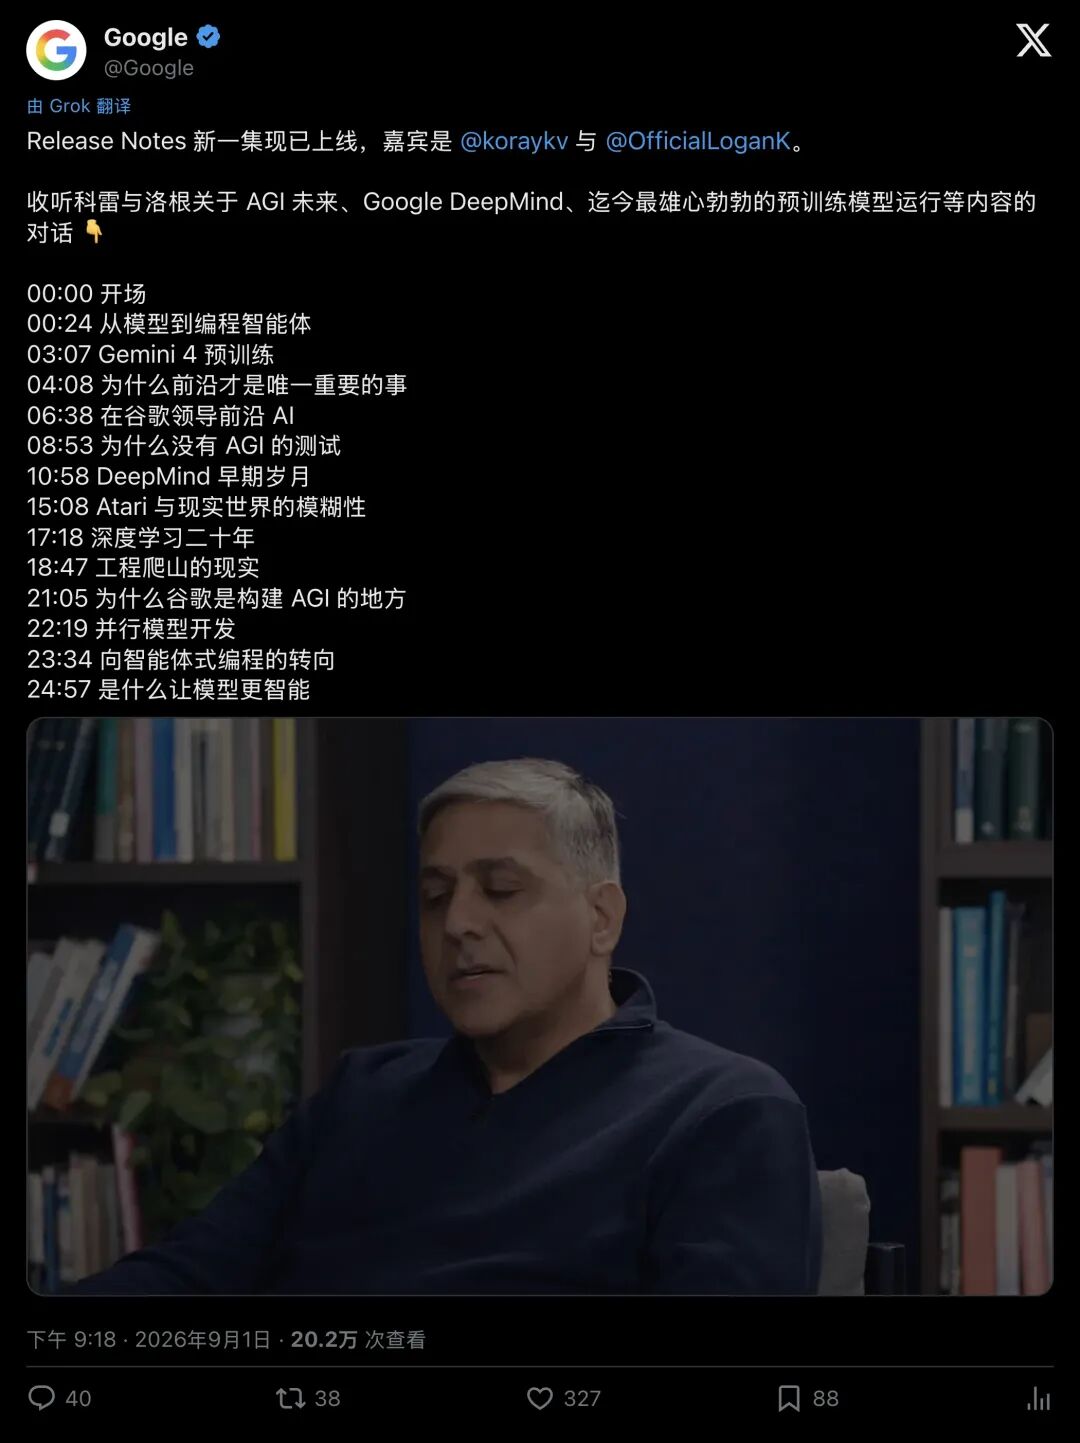
▲ Google 官方推送的《Release Notes》节目,全景展现了 Gemini 4 预训练与智能体转向
卡武克奥卢在节目中证实:Gemini 4 是谷歌有史以来规模最宏大、最雄心勃勃的一次预训练(Pre-training)。
在深度学习的世界里,“预训练”就像是打地基。一个在海量高质量数据与海量算力上完成淬炼的基础底座,将决定模型的智商上限。
目前 Gemini 4 的训练进展顺利,整个团队展现出务实的专注,将全部研发力量收束在代码执行、工具调用与科学推理等实打实的硬核能力上。
终极底牌:“全栈”是堡垒,还是沉重铁甲?
面对来势汹汹的初创企业,卡武克奥卢说出“100%重回前沿”的底气究竟在哪里?
他给出的答案只有两个字:全栈(Full Stack)。
放眼全球科技界,几乎没有任何一家公司,拥有谷歌这样恐怖的垂直整合能力:
- 底层硬件
:拥有自主迭代多年、摆脱对外部芯片唯一依赖的自研 TPU 算力集群; - 系统基建
:全球顶级的数据中心、极低成本的内部互联与推理优化网络; - 算法底座
:并行动员的 Gemini 核心研发团队; - 终端分发
:坐拥 Android、搜索、Workspace 以及月活超 9.5 亿 的 Gemini 原生应用。
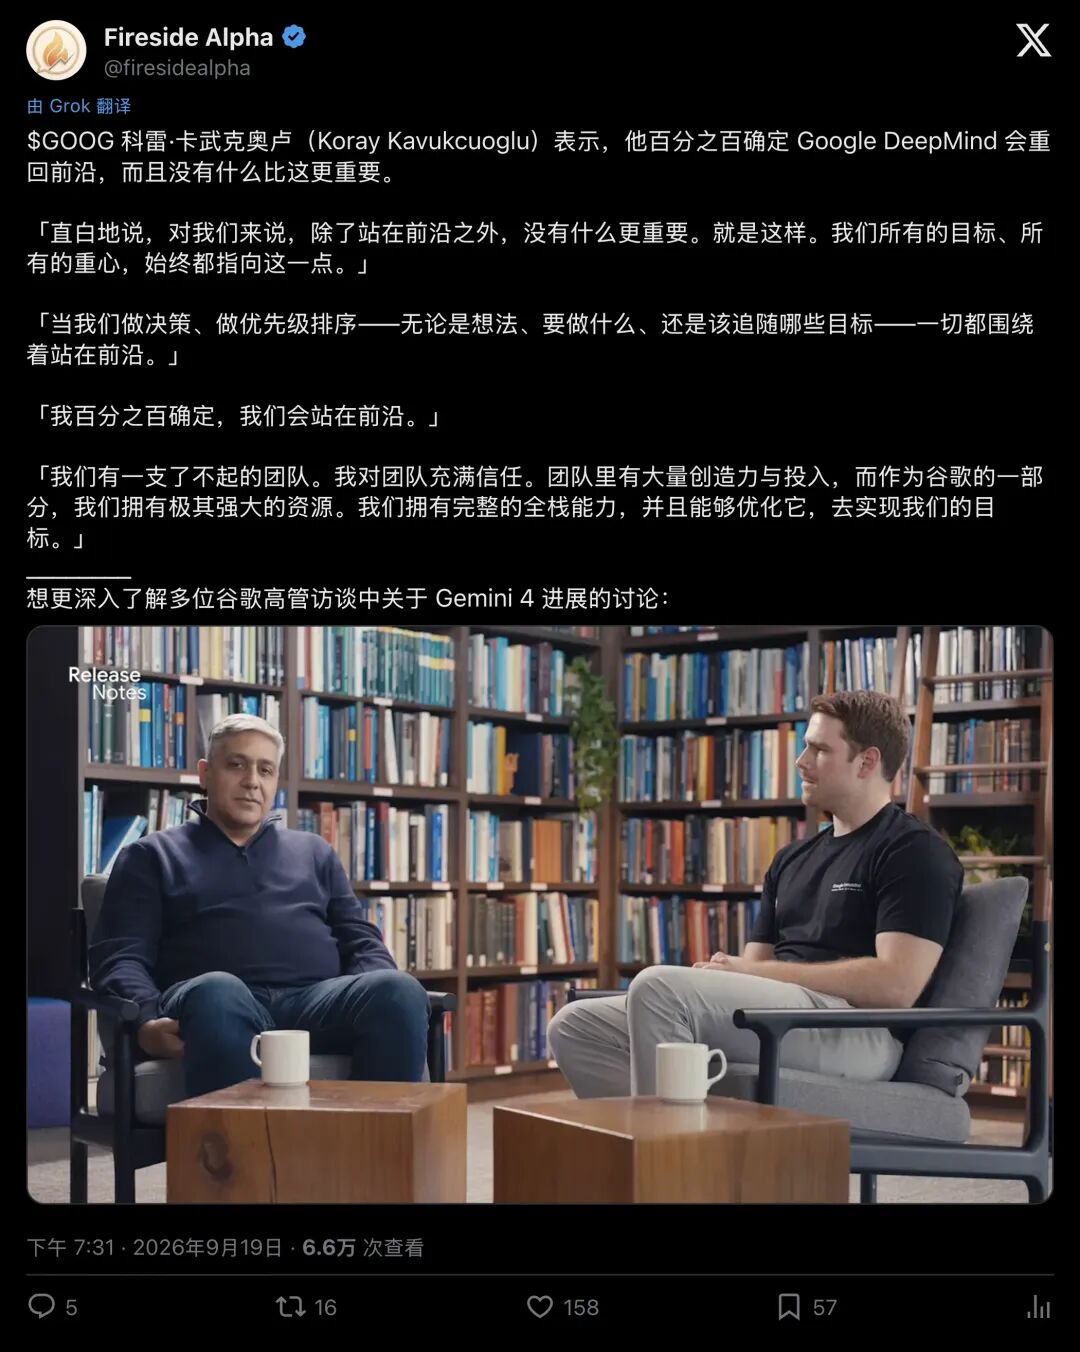
▲ 卡武克奥卢强调:谷歌拥有全栈资源,并且能够对其进行整体优化以实现目标
用卡武克奥卢的话说:“我们拥有整个全栈,而且我们有能力把从芯片到产品的每一层都进行整体优化。”
得益于全栈整合能力,即使谷歌在某一个弯道上慢了半拍,庞大的生态飞轮也能以极低的边际成本迅速追赶,并把领先模型直接推送到数亿用户的日常应用中。
但“全栈”也是一把双刃剑
大公司的全栈,往往意味着部门林立的沟通内耗、庞大产品线的兼容包袱,以及对品牌声誉与安全合规的如履薄冰。
正如 Semafor 曾经犀利指出的那样:AI 模型的能力曲线可以一夜翻倍,但服务全球数十亿人的成熟产品却不能随便掀桌子。
这头大象能否在狂暴奔跑的同时完成优雅转身,正是卡武克奥卢必须回答的命题。
决战前夜:第二名就是最大的输家
在通用人工智能的竞技场上,第二名没有任何安全感。
这是一场赢家通吃的超级战役开发者用脚投票的速度比任何人想象的都要快:谁的模型写代码更少报错,谁的推理逻辑更严密,全球的 API 调用和算力账单就会在几天之内倒向谁。
卡武克奥卢罕见地坦露短板,吹响了内部破釜沉舟的反击号角。
他卸下学术实验室的包袱,正视战略节奏的差距,砍掉细枝末节的非核心项目,将这家科技帝国的全部精锐资源,倾注于“重返前沿”的核心主线。
风暴已经形成当 Gemini 4 走出预训练机房的那一刻,这场大模型诸神之战的高潮才正式降临。