ARTICLE · 1054869
AI 不聊天,专门做判断!TypeSafe AI 从零到实战:手把手教你构建一个智能决策系统
我们平时使用 ChatGPT、DeepSeek 或 Qwen,主要是让模型回答问题、生成文章、编写代码,或者完成复杂的推理任务。但在真正开发 AI 应用时,你会发现,很多场景其实根本不需要模型长篇大论。
比如,一个智能客服系统收到客户投诉后,需要判断这条消息属于哪个部门、问题是否紧急、客户的情绪有多激烈;一个 RAG 知识库检索到十段文档后,需要判断哪些内容真正与用户问题相关;一个 Agent 接收到用户指令后,需要判断应该调用数据库、搜索工具,还是交给另一个模型处理。
这些任务有一个共同点:我们需要的不是一段精彩的回答,而是一个能直接被程序使用的判断结果。
最近,我发现了一个专门解决这类问题的 AI 项目——TypeSafe AI。
它推出了一种名为 Jev 的决策模型,不再以生成开放式文本为主要目标,而是让开发者提前定义问题和候选答案,由模型直接输出分类结果、评分、概率等结构化数据。
这篇文章就带大家从零开始体验 TypeSafe AI,使用 Python 编写一个真实的智能客服分类器,并进一步了解它如何接入 RAG、Agent 和 AI 安全护栏。
整个过程不需要训练模型,也不需要准备 GPU。只要有 Python 环境和 TypeSafe API Key,就可以跟着操作。
一、TypeSafe AI 到底是什么?
先来看一个实际场景。
假设我们正在开发一个 SaaS 平台,客户发来了这样一条消息:
“我的支付接口已经连续三天无法使用,订单都没办法支付了,请尽快解决!”
如果你负责开发这个系统,首先需要做什么?
很显然,我们希望程序能够自动判断出,这是一条技术故障相关的消息,客户表达了明显的紧急性,而且情绪比较激动。接下来,系统应该把工单交给技术部门,并设置相应的处理优先级。
传统做法是直接调用一个通用大模型,要求它返回 JSON。
例如:
请分析下面的客户消息,返回 JSON。要求:1. 判断问题属于哪个部门。2. 判断客户是否紧急。3. 评估客户情绪。输出格式:{"department": "technical","urgent": true,"emotion": "angry"}
这种方法当然可以使用。现在不少大模型还支持 Structured Outputs,可以通过 JSON Schema 约束输出格式。
但实际业务中,我们还可能希望知道:模型为什么在技术问题和支付问题之间选择了前者?模型对不同候选类别的判断概率分别是多少?当分类不够明确时,应该如何让程序自动进入人工复核?
TypeSafe AI 就是针对这类结构化判断任务设计的。
它的核心模型叫作 Jev,官方将其定义为 System One 决策模型。开发者提供待分析的数据和需要回答的问题,模型返回类型化的判断结果,而不是生成一段自由文本。
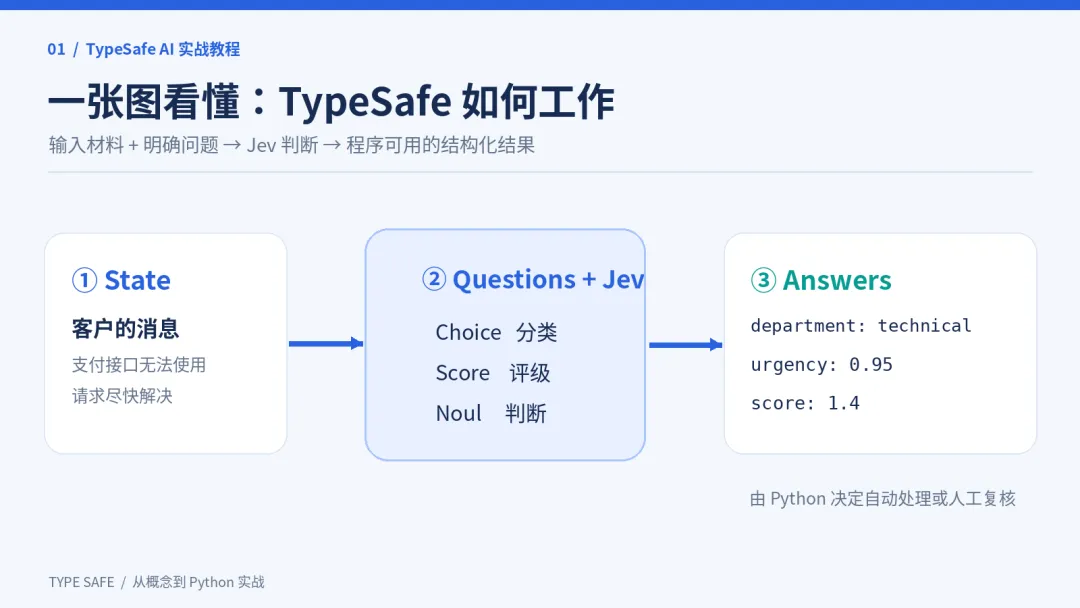
它的基本工作流程可以概括为:
State + Questions → Jev → Answers这里面有三个非常重要的概念。
State 表示需要分析的数据,例如一条客户投诉、一段合同内容,或者用户当前的请求。
Questions 表示我们希望模型回答的问题。例如,客户属于哪个类别?这条消息是否紧急?客户情绪有多激烈?
Answers 则是模型最终返回的结果,包括分类、评分和概率等信息。
需要注意,TypeSafe 并不是要全面替代 ChatGPT 或 Qwen。
它不适合编写长篇文章、生成复杂代码或完成开放式推理。它更适合处理答案范围明确、能够被结构化定义的判断任务。
简单理解就是:通用大模型负责生成和推理,TypeSafe 负责特定类型的判断,Python 负责执行实际业务逻辑。
二、搞懂三个核心功能,就理解了 TypeSafe 的大部分用法
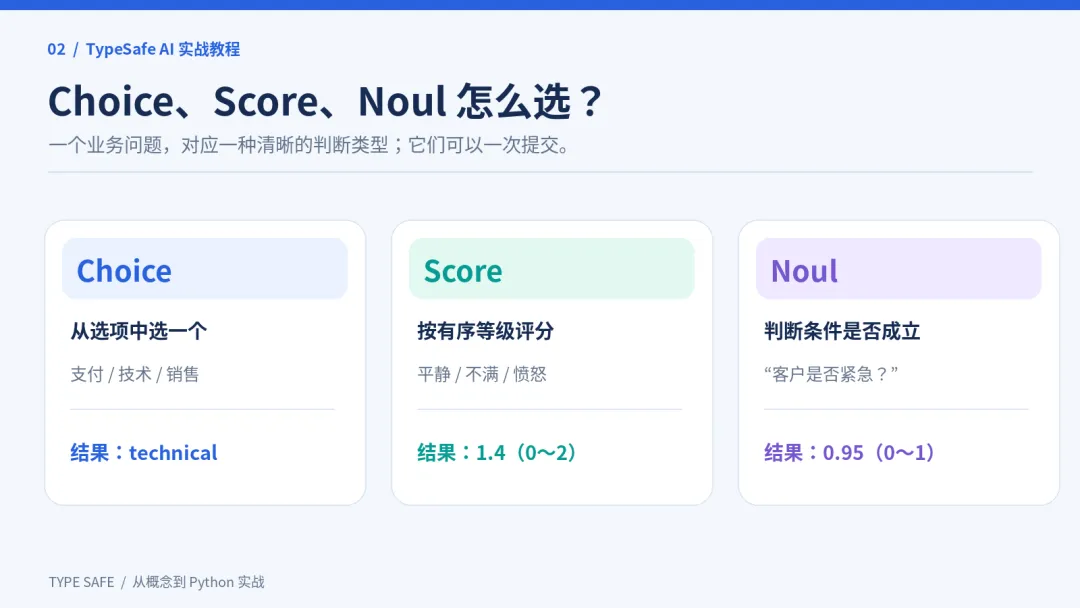
TypeSafe 最重要的设计,是把判断问题分成三个基本类型:Choice、Score 和 Noul。
这三个名字第一次看到可能有些陌生,但其实非常容易理解。
1. Choice:从多个候选答案中选择一个
假设我们要判断一条客户消息应该交给哪个部门。
候选答案只有四个:
billing 支付与账单问题technical 技术问题sales 销售咨询other 其他问题
这就是一个典型的 Choice 问题。
我们可以这样定义:
{"department": {"type": "choice","instructions": "Which team should handle this ticket?","criteria": {"billing": "Payment, invoices and refunds","technical": "Software bugs and integration failures","sales": "Pricing and subscription questions","other": "None of the above"}}}
其中,department 是问题名称,type 表示问题类型,instructions 告诉模型应该判断什么,criteria 则定义所有候选答案。
模型会从这些候选项中选择一个,并返回相应的概率分布。
例如:
{"type": "choice","choice": "technical","confidence": 0.86,"probabilities": {"billing": 0.05,"technical": 0.92,"sales": 0.01,"other": 0.02}}
注意,上面的数值只是教学示例,并不是实际调用结果。
从这个结果中,我们不仅知道模型选择了 technical,还能够看到它对其他类别的判断概率。
不过,confidence 并不等于最高类别的概率。它反映的是整个概率分布的确定性程度,后面我们还会专门解释。
实际开发中,我建议在分类任务里尽量提供一个 other 选项,以避免模型被迫从几个明显不合适的类别中选择答案。
2. Score:按照预设等级进行评分
接下来,我们想判断客户的愤怒程度。
这个问题与刚才的分类有所不同,因为情绪程度具有明确的顺序。
我们可以定义三个等级:
{"frustration": {"type": "score","instructions": "How frustrated is the customer?","criteria": ["Calm and neutral","Frustrated but polite","Very angry"]}}
这三个等级分别对应 0、1、2。
假设模型认为客户处于第二个等级的概率为 60%,处于第三个等级的概率为 40%,那么评分结果就是:
ounter(lineounter(lineounter(lineScore = 0 × 0 + 1 × 0.6 + 2 × 0.4Score = 1.4
因此,Score 并不是简单地让模型随便生成一个数字,而是根据预设等级的概率分布计算加权结果。
这种设计适合情绪强度、风险程度、文档质量等需要进行有序评级的任务。
但是,如果你要预测一个精确数值,例如明天的电价、某个设备的实际温度,就不应该直接用 Score 替代回归模型。
3. Noul:判断一个条件是否成立
第三种类型是 Noul。
假设我们只想判断一件事:
“这条消息是否表达了紧急性?”
可以这样定义:
{"urgency": {"type": "noul","instructions": "Does this message express urgency?"}}
假设返回:
JSON
{"type": "noul","noul": 0.95}
这表示模型认为“消息表达了紧急性”这一命题成立的概率为 0.95。
Noul 的结果位于 0 到 1 之间。
越接近 1,模型越倾向于认为命题成立;越接近 0,则越倾向于认为命题不成立。
这里有一个很容易混淆的地方。
如果你问“客户是否愤怒”,Noul 返回 0.5,代表模型对真假判断存在不确定性,而不是说客户的愤怒程度刚好是中等。
如果你需要知道程度,应当使用 Score。
到这里,可以总结一下:Choice 解决“选哪个”,Score 解决“什么程度”,Noul 解决“是不是”。
掌握这三种类型,后面写代码就非常容易了。
三、先别急着写代码,打开 Playground 体验一下
理解基本概念以后,我们开始实际操作。
TypeSafe 提供了在线 Playground,可以先在浏览器里测试模型,不需要配置 Python。
官方地址:
👉https://console.typesafe.ai/playground
打开网站,按照页面提示登录,然后进入 Playground。
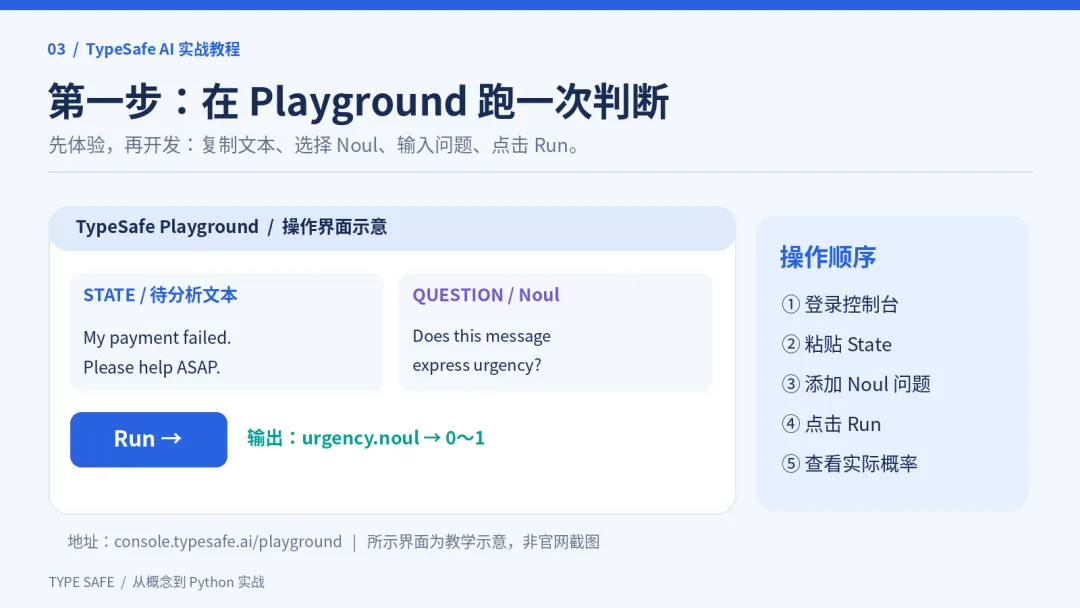
第一步:输入测试文本
找到 State 输入区域,粘贴下面这段英文:
ounter(lineounter(lineounter(lineounter(lineounter(lineHi, I've been trying to connect my Stripeaccount for 3 days and the integrationkeeps failing.I'm losing sales. Please help ASAP.
这段话的意思是:客户尝试连接 Stripe 支付账户已经三天,但集成一直失败,正在损失销售额,希望立即获得帮助。
这里建议先使用英文,因为 TypeSafe 官方表示,Jev 目前在英语任务上的表现更好。中文虽然也可以使用,但需要通过真实业务数据单独评测。
第二步:创建判断问题
在 Questions 区域添加一个问题,将问题类型设置为 Noul。
问题内容填写:
Does this message express urgency?它的意思是:
这条消息是否表达了紧急性?
如果你使用的是 JSON 编辑方式,对应的问题定义如下:
{"urgency": {"type": "noul","instructions": "Does this message express urgency?"}}
这里展示的是问题定义,不是完整的 HTTP 请求体。
第三步:运行测试
点击 Playground 提供的运行按钮,查看模型返回结果。
结果结构类似:
{"urgency": {"type": "noul","noul": 0.98}}
其中 0.98 只是示意数值。真正的概率以你实际运行的结果为准。
看到结果以后,可以尝试把客户消息改成:
Hello, thank you for your help.再次运行,观察紧急概率是否发生变化。
这样,通过两次简单测试,你应该就能理解 Noul 是如何工作的。
接下来,可以继续添加 Choice 和 Score 问题,让模型对同一条消息进行多个判断。
TypeSafe 的一个重要机制,就是允许我们在一次请求中提交多个独立问题,而不必先调用一个分类模型,再依次调用情绪判断和紧急程度判断。
四、准备开发环境:使用 uv 安装 Python SDK
网页体验完成以后,就进入真正的代码开发环节。
我们要编写一个 Python 程序,输入客户消息以后,自动输出所属部门、情绪评分、紧急概率,以及最终的业务处理路径。
首先,需要准备 API Key。
第一步:创建 API Key
进入官方控制台:
👉https://console.typesafe.ai/
登录以后,在控制台中找到 API Key 管理入口,按照页面提示创建密钥。
由于密钥管理界面需要登录账户,这里的具体按钮名称和位置以你的实际页面为准。
创建完成后,复制 API Key。
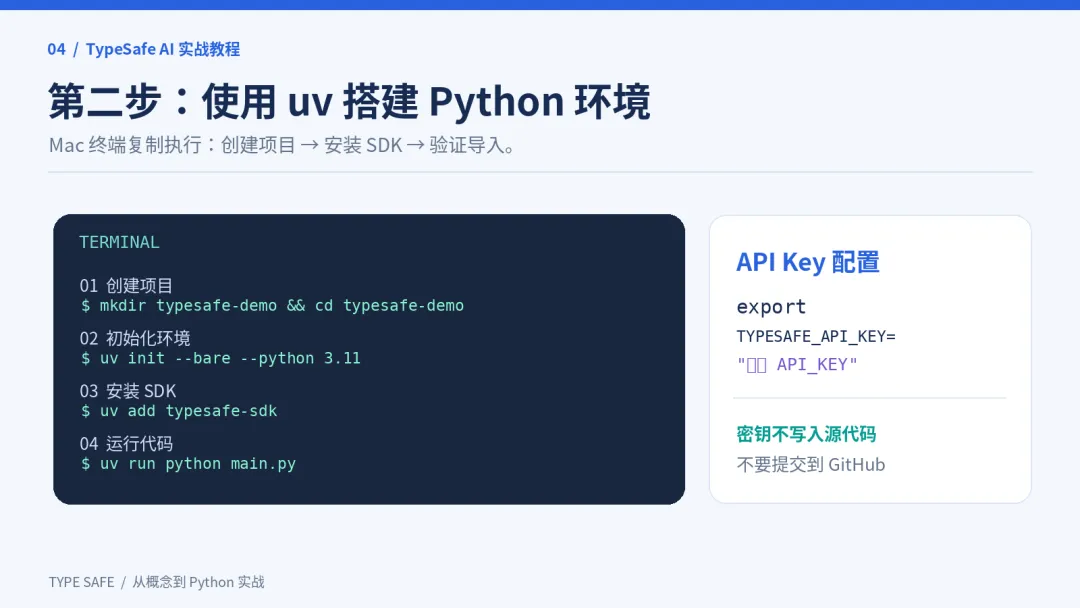
打开 Mac 终端,执行:
Bash
export TYPESAFE_API_KEY="你的API_KEY"将引号中的内容替换成真实密钥。
之所以使用环境变量,是为了避免把 API Key 直接写在源代码里。
尤其要注意,不要把真实密钥提交到 GitHub,也不要放到前端 JavaScript 中。
第二步:创建项目
这里使用 uv 管理 Python 项目。
先检查是否安装 uv:
uv --version如果没有安装,可以参考 uv 官方安装文档:
👉https://docs.astral.sh/uv/getting-started/installation/
安装完成以后,执行:
mkdir -p ~/projects/typesafe-democd ~/projects/typesafe-demo
这两条命令会在用户目录下创建项目,并进入项目文件夹。
接着初始化项目:
Bash
uv init --bare --python 3.11再安装 TypeSafe 官方 SDK:
uv add typesafe-sdkTypeSafe SDK 要求 Python 3.10 或更新版本,我们这里使用 Python 3.11。
如果电脑尚未安装 Python 3.11,可以先执行:
uv python install 3.11最后验证 SDK 是否安装成功:
uv run python -c "from typesafe_sdk import TypeSafeClient; print('OK')"如果终端输出:
OK说明 Python 已经能够成功导入 SDK。
此时,开发环境就准备好了。
五、完整实战:写一个智能客服分类器
接下来是本文最重要的部分。
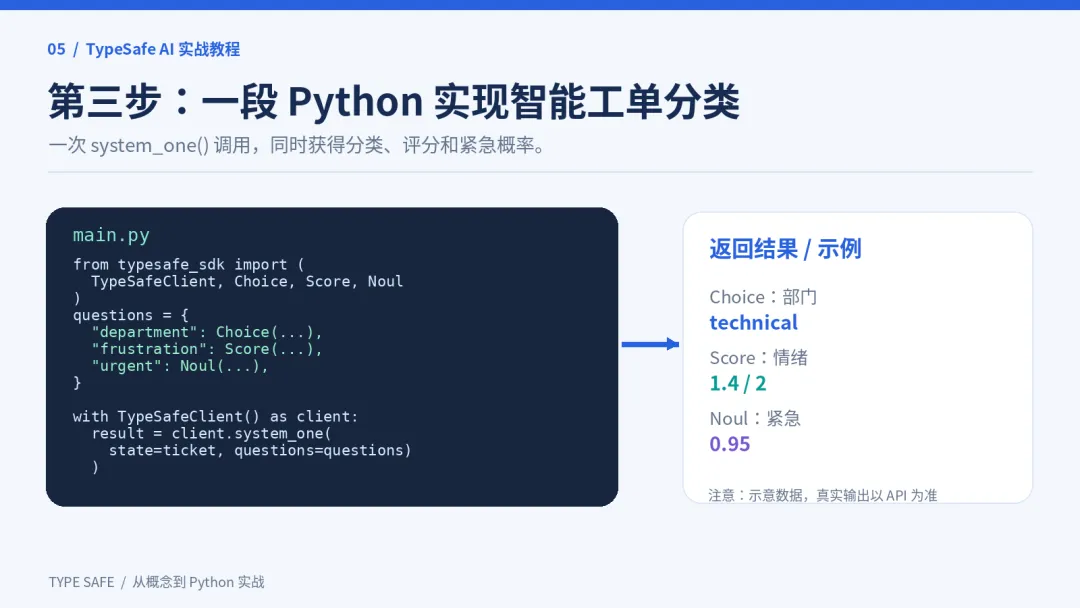
我们将使用刚才介绍的 Choice、Score 和 Noul,对一条客服消息同时进行三项判断。
模型负责返回判断结果,Python 负责决定工单应该自动分配给哪个部门,或者交由人工复核。
第一步:创建 Python 文件
在当前项目目录执行:
touch main.py使用 VS Code、Cursor 或其他代码编辑器打开 main.py。
然后将下面的代码完整复制进去。
第二步:编写完整代码
from typesafe_sdk import (TypeSafeClient,Choice,Score,Noul,)# ==================================# 1. 准备客户消息# ==================================ticket = """Hi, I've been trying to connect my paymentaccount for 3 days.The integration keeps failing.I'm losing sales. Please help ASAP."""# ==================================# 2. 定义需要判断的问题# ==================================questions = {# 问题一:工单应该交给哪个部门?"department": Choice(instructions=("Which department should ""handle this ticket?"),criteria={"billing": ("Payment, invoices and refunds"),"technical": ("Software bugs and ""integration failures"),"sales": ("Pricing and subscription questions"),"other": ("None of the above"),},),# 问题二:客户有多生气?"frustration": Score(instructions=("How frustrated is the customer?"),criteria=["Calm and neutral","Frustrated but polite","Very angry",],),# 问题三:客户是否表达了紧急性?"urgent": Noul(instructions=("Does this message express urgency?"),),}# ==================================# 3. 检查 API Key# ==================================if not os.getenv("TYPESAFE_API_KEY"):raise SystemExit("请先配置 TYPESAFE_API_KEY 环境变量")# ==================================# 4. 调用 TypeSafe API# ==================================with TypeSafeClient() as client:response = client.system_one(model="jev-latest",state=ticket,questions=questions,)# ==================================# 5. 提取模型判断结果# ==================================department = response.answers["department"]frustration = response.answers["frustration"]urgent = response.answers["urgent"]# ==================================# 6. 编写业务分流规则# ==================================# 以下阈值仅用于教学演示# 正式上线应通过真实数据确定if department.confidence < 0.7:route = "human_review"elif 0.2 < urgent.noul < 0.8:route = "human_review"else:route = department.choice# ==================================# 7. 判断优先级# ==================================if (urgent.noul >= 0.8or frustration.score >= 1.5):priority = "high"else:priority = "normal"# ==================================# 8. 整理输出结果# ==================================result = {"department": department.choice,"department_confidence": (department.confidence),"department_probabilities": (department.probabilities),"frustration_score": (frustration.score),"urgent_probability": (urgent.noul),"route": route,"priority": priority,}# ==================================# 9. 打印 JSON# ==================================print(json.dumps(result,ensure_ascii=False,indent=2,))
这段代码虽然有一些长度,但核心逻辑其实非常简单。
首先,我们准备一条客户投诉,并将它作为 State。
接着,在 Questions 中定义三个问题:Choice 判断所属部门,Score 评估客户情绪,Noul 判断紧急性。
然后,调用 TypeSafe 的 system_one() 接口。三个问题在同一次请求中提交,最终返回对应的结构化结果。
最后,通过 Python 编写业务规则,把模型结果转换为实际的工单处理路径和优先级。
需要注意,代码中的 0.7、0.8、1.5 等阈值仅用于展示业务逻辑,并不是 TypeSafe 官方推荐的生产阈值。
第三步:运行程序
保存 main.py,回到终端执行:
Bash
uv run python main.py如果 API Key 有效、网络连接正常,并且账户具有相应权限,就会得到模型的判断结果。
输出结构可能类似:
"department": "technical","department_confidence": 0.86,"department_probabilities": {"billing": 0.05,"technical": 0.92,"sales": 0.01,"other": 0.02},"frustration_score": 1.4,"urgent_probability": 0.95,"route": "technical","priority": "high"}
以上是示例数据,不是本文实际调用 API 得到的结果。
从结果中可以看到,程序将客户消息归类为技术问题,同时判断客户表达了较高的紧急性,因此最终处理路径是技术部门,工单优先级为 high。
到这里,我们就完成了一个可以通过 TypeSafe API 进行智能分类和自动分流的 Python 程序。
六、最容易踩坑的地方:Confidence 不等于准确率
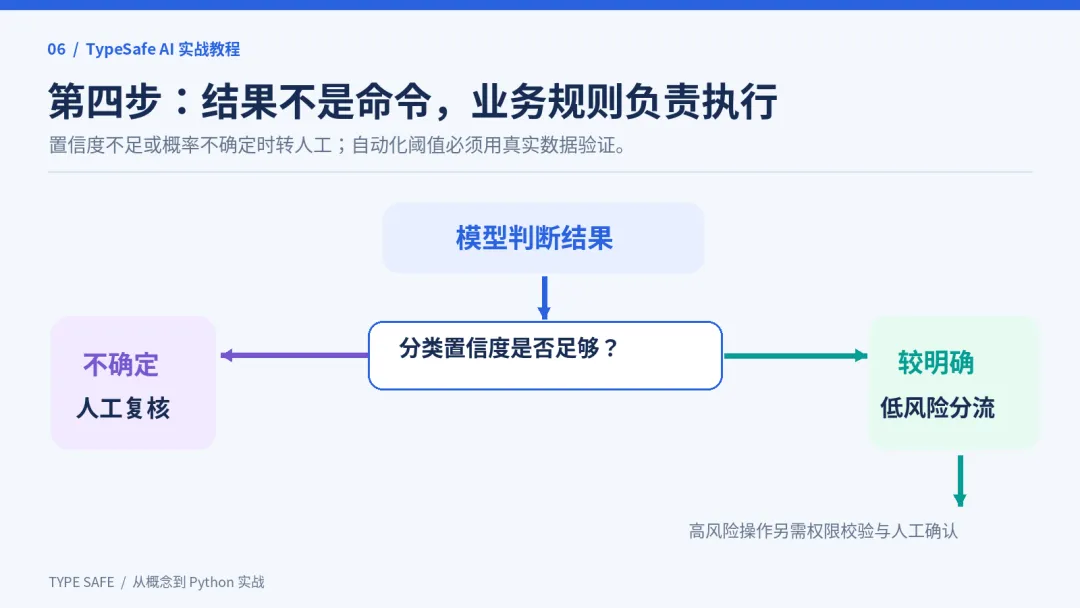
前面的代码中,有这样一段逻辑:
if department.confidence < 0.7:route = "human_review"
很多开发者第一次看到这里,可能会直接把 confidence 理解成准确率。
实际上,两者不是一回事。
假设 Choice 返回以下结果:
{"choice": "technical","probabilities": {"technical": 0.95,"billing": 0.03,"sales": 0.02}}
模型将绝大部分概率分配给 technical,说明判断比较集中。
但如果模型返回:
{"choice": "technical","probabilities": {"technical": 0.40,"billing": 0.35,"sales": 0.25}}
虽然最后仍然选择了 technical,但三个候选类别的概率十分接近,说明模型在不同选项之间存在明显的不确定性。
TypeSafe 的 Choice 和 Score 会返回单独的 confidence 字段,它与整个概率分布的集中程度有关,而不等于最高类别的概率。
同时,confidence 也不能直接代表模型在真实业务数据集上的准确率。
例如,某一次预测的 confidence 为 0.99,并不意味着你的客服系统整体准确率已经达到 99%。
如果准备把它真正部署到生产环境,应该先准备一批人工标注的工单,将真实类别和模型预测结果进行对比,再计算 Accuracy、Precision、Recall、F1 等指标。
只有经过实际测试,才能判断某个置信度阈值是否足以支持自动分流。
这也引出了一个重要的工程原则:模型负责提供判断结果,实际业务操作仍然应该受到代码、规则和必要的人工审核控制。
七、进一步实战:把 TypeSafe 接入 RAG 系统
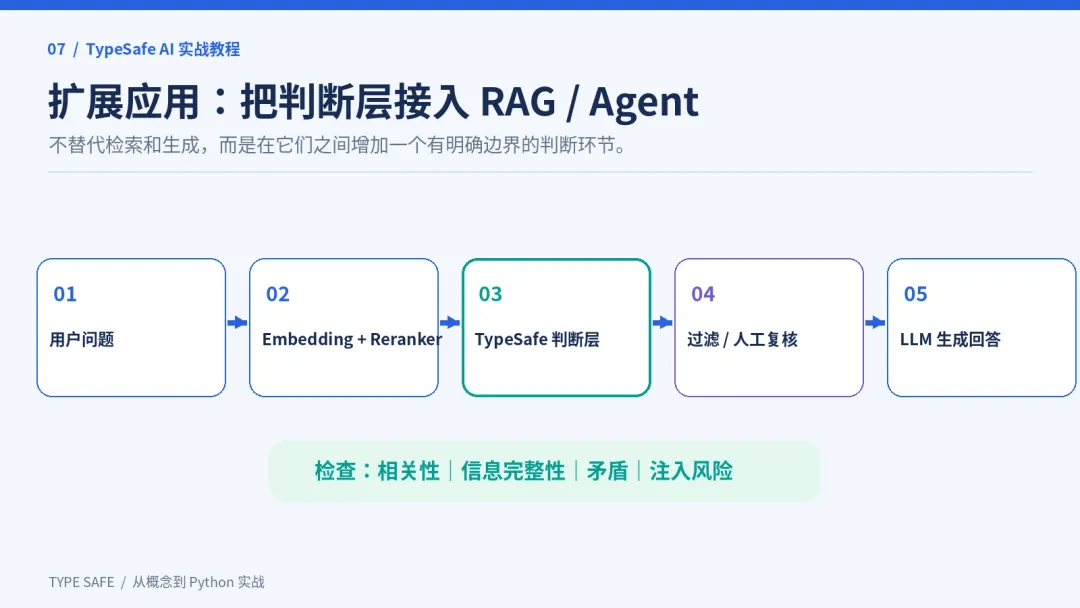
除了智能客服,TypeSafe 还可以放在 RAG 知识库中。
我们知道,一个典型的 RAG 系统通常包含用户提问、向量检索、重排序和大模型生成几个环节。
但是,即使经过 Embedding 检索和 Reranker 排序,最终检索到的文档也不一定全部具有价值。
有些文档可能只是包含了相同关键词,有些文档可能已经过时,还有些内容可能包含恶意构造的提示词。
这时,可以在检索和生成之间加入 TypeSafe 判断层。
整体流程就变成了:
用户提问↓Embedding 向量检索↓Reranker 重排序↓TypeSafe 判断↓筛选和标记候选文档↓LLM 生成最终答案
例如,用户提问:
“公司支持哪些退款方式?”
系统检索到三段文字:
passages = ["Refunds are returned to the original payment method.","Our company was founded in 2020.","Refund processing normally takes several business days.",]
第一段描述退款方式,第二段介绍公司成立时间,第三段介绍退款处理周期。
我们希望模型判断每段文字是否有助于回答当前问题。
可以这样构建问题:
questions = {}for i in range(len(passages)):questions[f"relevant_{i}"] = Noul(instructions=(f"Does `passages[{i}]` contain ""information that helps answer ""`question`?"))
然后准备 State:
state = {"question": "What refund methods are supported?","passages": passages,}
调用模型:
withTypeSafeClient() as client:response = client.system_one(model="jev-latest",state=state,questions=questions,)
最后,通过代码筛选:
selected = []for i, passage in enumerate(passages):probability = response.answers[f"relevant_{i}"].noulif probability >= 0.8:selected.append(passage)print(selected)
这里的 0.8 同样只是教学阈值,需要根据真实检索数据进行评测。
需要强调的是,TypeSafe 不一定要替代现有的 Reranker。
它可以作为独立的判断环节,针对相关性、内容矛盾、证据完整性和提示词注入风险等问题进行额外分析。
但是,增加这一层也会产生额外的调用成本和延迟,是否值得加入,应当以实际评测结果为准。
八、TypeSafe 还能接入 Agent 和 AI 安全护栏吗?
当然可以。
在 Agent 系统中,一个常见问题是:收到用户请求后,应该调用哪个工具?
比如用户说:
“帮我查询昨天的订单。”
这类任务可能只需要调用数据库,不一定需要进行复杂推理。
但如果用户说:
“帮我分析最近三个月订单转化率下降的原因,并提出优化方案。”
这就可能需要一个具有数据分析和推理能力的 Agent。
我们可以使用 Choice 判断用户意图。
intent = Choice(instructions=("Which tool should handle ""this user request?"),criteria={"database": "Simple data queries","analysis": "Complex data analysis","general": "General conversation","other": "Unsupported requests",},)
模型返回意图以后,再由 Python 根据结果调用相应工具。
类似的方式也可以用在 AI 安全护栏中。
例如,系统需要判断用户输入是否试图覆盖原有指令、是否要求泄露机密信息,或者是否包含其他安全风险。
我们可以通过 Noul 定义这些真假问题,再根据业务规则决定继续处理、拒绝操作还是转人工审核。
不过,模型自身也可能受到对抗性输入影响,所以 TypeSafe 不应该成为唯一的安全防线。
对于敏感业务,还需要配合确定性规则、权限校验、专门的安全检测模型,以及真实的攻击样本测试。
九、上线之前,还需要了解这些限制
虽然 TypeSafe 的设计比较有意思,但它并不是万能的。
首先,Jev 当前主要接收文本输入,并不直接处理图片、音频和视频。如果业务中存在 PDF、图片或视频,可以先使用文档解析、OCR、ASR 等工具提取文字,再交给模型判断。
其次,TypeSafe 不适合承担复杂数学计算、精确日期比较和开放式文本生成。这些任务应该交给 Python、专门的算法或者其他大模型完成。
此外,中文场景需要额外关注。官方表示,Jev 以英语作为主要训练语言,其他语言的表现可能存在差异。
如果你的业务是中文合同审核、中文客服分类或工业缺陷分析,建议先准备带有人工标签的中文测试集,检查分类准确率、漏判率、误判率以及不同阈值下的表现。
最后,生产环境还需要考虑模型版本。
学习阶段可以使用:
model="jev-latest"这个别名指向最新稳定版本。
如果系统已经完成测试,并针对某个模型版本确定了业务阈值,可以考虑在生产环境中固定具体版本,避免模型更新后出现未验证的行为变化。
当然,固定版本时也应当确认服务商仍然提供该版本。
十、这套技术值不值得用?
回到最初的问题:为什么我们需要一个专门负责判断的模型?
因为在实际应用中,并不是所有问题都需要复杂推理。
有些任务只需要分类,有些任务只需要评级,还有些任务只需要判断一个条件是否成立。
如果把这些范围明确的任务全部交给通用大模型,虽然也能实现,但可能需要额外的提示词、结果解析和业务约束。
TypeSafe 提供了另一种方式:通过标准化的问题类型,直接获得程序能够使用的结构化结果,并允许开发者进一步利用概率和置信度设计业务流程。
不过,它是否比现有的通用大模型、传统分类模型或者专门的 Reranker 更合适,仍然要从准确率、延迟、成本和系统复杂度等方面进行实际比较。
对于已经拥有成熟分类模型的项目,没有必要仅仅因为出现了一种新技术就立即替换。
更合理的做法是,选择一个小范围的业务场景进行验证。
比如先拿出几百条已经标注的客服工单,分别使用现有模型和 TypeSafe 分类,再对比预测结果、平均延迟、调用成本和人工复核比例。
这样才能知道它究竟能够带来什么价值。
写在最后
从最初的提示词工程,到 Structured Outputs,再到今天介绍的 TypeSafe,我们能够看到 AI 应用开发中的一个变化:开发者越来越关注模型输出如何真正进入业务系统,而不只是模型能否生成一段看起来正确的回答。
在这篇文章中,我们从 TypeSafe 的基本概念入手,理解了 Choice、Score 和 Noul 三种判断类型,然后通过 Playground 完成第一次体验,使用 uv 搭建 Python 环境,并编写了一个智能客服分类器。
最后,我们还了解了如何使用置信度进行人工分流,以及如何把同样的思想应用在 RAG、Agent 和 AI 安全护栏中。
如果用一句话总结 TypeSafe 的核心价值,我认为是:
把 AI 的判断能力转化为结构化数据,再通过确定性的业务代码,完成真正可控的应用流程。
AI 不需要负责每一步,也不应该替代所有业务规则。让不同组件承担适合自己的工作,往往比试图用一个大模型解决全部问题更容易测试和维护。
对于正在开发智能客服、知识库、Agent 或企业 AI 平台的工程师来说,TypeSafe 提供了一种值得动手验证的实现思路。
代码跑通只是第一步,真正决定这套技术能否落地的,还是后续的数据评测、异常处理和工程化设计。
项目与学习资料
TypeSafe 官方文档:
👉https://docs.typesafe.ai/introduction
官方 Quick Start:
👉https://docs.typesafe.ai/introduction/quickstart
TypeSafe Playground:
👉https://console.typesafe.ai/playground
官方 Python SDK:
👉https://docs.typesafe.ai/sdk/python