ARTICLE · 1054967
重新理解 AI 系列番外01:传统软件工程到底在解决什么?
副标题:从输入、输出、接口、状态、错误和测试开始,理解为什么可靠 AI 应用离不开工程系统
引言
在上一篇《重新理解 AI 系列40:不是所有任务都需要 Agent:什么时候 Workflow 更好?》里,我们讨论了一个很重要的判断:不是所有任务都值得交给 Agent。
有些任务路径稳定,Workflow 更可靠;有些任务风险很高,需要验证和人工确认;有些任务结果很难验证,就不能轻易放大模型的自主性。
讲到这里,我觉得有必要稍微绕一步,把镜头拉回到一个更老的问题:传统软件工程到底在解决什么?
不是为了掉书袋,也不是为了突然把这个系列变成软件工程课。原因很简单:后面我们要讨论的 Harness,并不是从天上掉下来的新词。
它背后有一套很老、但很有生命力的工程直觉:一个系统要在真实世界里可靠运行,不能只关心“正常情况下怎么成功”,还要关心输入是否可靠、接口是否清楚、状态如何变化、错误如何暴露、结果如何验证。
这些问题,在 AI 出现之前,传统软件工程已经处理了很多年。
你不需要把它当成程序员内部黑话。我们可以先这样理解:
软件工程不是把代码写得更复杂,而是让逻辑在真实世界里可理解、可测试、可维护、可交付。
后面我们讲 AI Harness,其实就是把这套直觉,重新放到 LLM 和 Agent 系统里。
一、程序不是只有“成功路径”
很多人刚开始理解程序时,会把程序想得很简单:
输入一个东西,程序处理一下,输出一个结果。
这个理解没有错,但它只看到了最顺利的一面。真实系统里,事情经常不会这么听话。
用户可能少填一个字段,金额可能填成负数,文件可能太大,网络可能断开,接口可能超时,权限可能不够,审批人可能离职,某个外部服务可能突然返回一段奇怪的数据。
这时候,一个系统如果只会处理“所有条件都刚刚好”的情况,就很脆。
比如一个报销流程。正常路径当然很简单:填写金额,上传发票,提交审批,审批通过,进入付款。
但真实情况会复杂得多:发票可能重复,金额可能超标,部门预算可能不足,审批人可能不在,付款接口可能失败。软件工程要处理的,恰恰是这些“不那么理想”的情况。
所以可靠系统不是假设一切顺利,而是承认事情经常不会顺利,并提前为这些情况留下处理空间。
这和 AI 应用的关系很直接。AI 应用里的“不顺利”更多:用户需求说不清,模型可能理解偏,检索材料可能冲突,工具调用可能失败,生成结果可能看起来合理但事实不对。
如果我们只做一个漂亮 Demo,只展示最顺的一次回答,当然会觉得 AI 很神奇。但一旦进入真实业务,真正考验系统的,往往不是那条成功路径,而是失败路径来了以后,系统还能不能稳住。
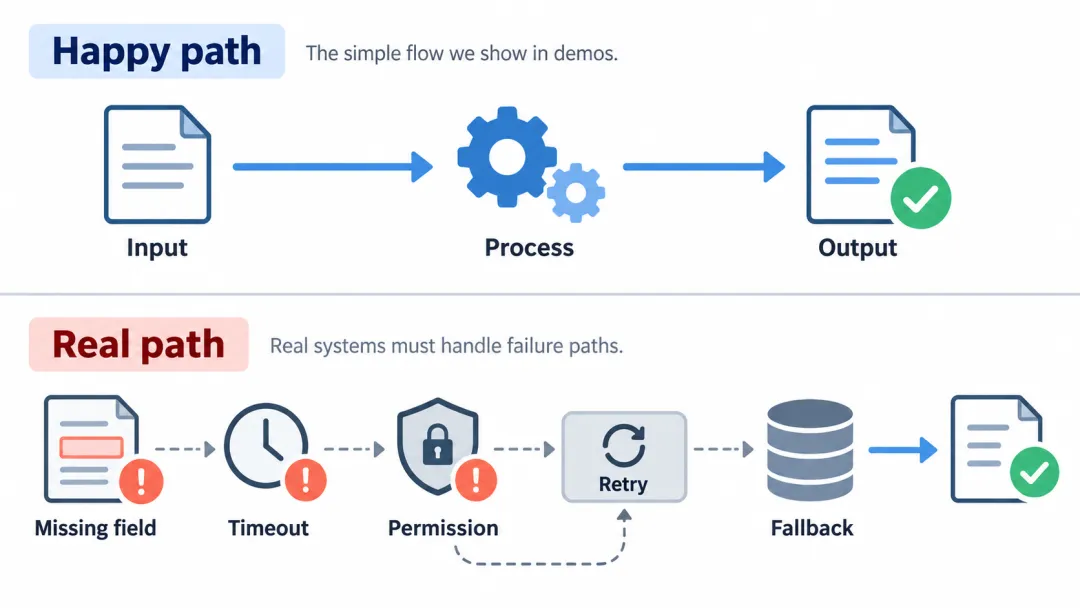
图注:这张图想说明,Demo 里的路径通常是“输入、处理、输出”的顺滑直线;真实系统里更常见的是缺字段、超时、权限失败、重试和降级。工程系统要处理的,正是下面这条更真实的路径。
二、接口和契约:系统不能只靠“差不多能懂”
第二个关键概念,是接口和契约。
听起来有点硬,但它其实很生活化。
你去餐厅点菜,不能只跟服务员说:“给我来点好吃的。”当然,熟人可能能猜,但一个稳定系统不能靠猜。
更稳定的表达是:菜名是什么,几份,要不要辣,几号桌,有没有忌口。这样前台、后厨、收银才能围绕同一件事协作。
软件系统也是这样。
一个模块调用另一个模块,必须说清楚:我要传什么字段,字段是什么类型,哪些必填,成功返回什么,失败返回什么,错误原因怎么表达。
这就是接口和契约的价值:不是为了让系统变麻烦,而是为了让协作不再靠猜。
没有接口契约,系统之间就会变成“我以为你懂”“你以为我会传”“出了问题再人工排查”。这在小 Demo 里可能还能凑合,在真实系统里很快就会失控。
回到 AI,你会发现 Function Call、Tool Schema、MCP,其实都在解决类似问题。
模型不能只说“帮我查一下库存”。它需要生成一个结构化的工具调用:查哪个商品,查哪个仓库,时间范围是什么,返回字段有哪些。
外部工具也不能只丢回来一句“失败了”。它最好能告诉模型:是参数不合法、权限不足、网络超时,还是没有查到数据。
Prompt 再聪明,也不能替代接口边界。
如果接口不清楚,模型就只能靠猜。让模型猜,通常不是工程设计,而是把风险交给运气。
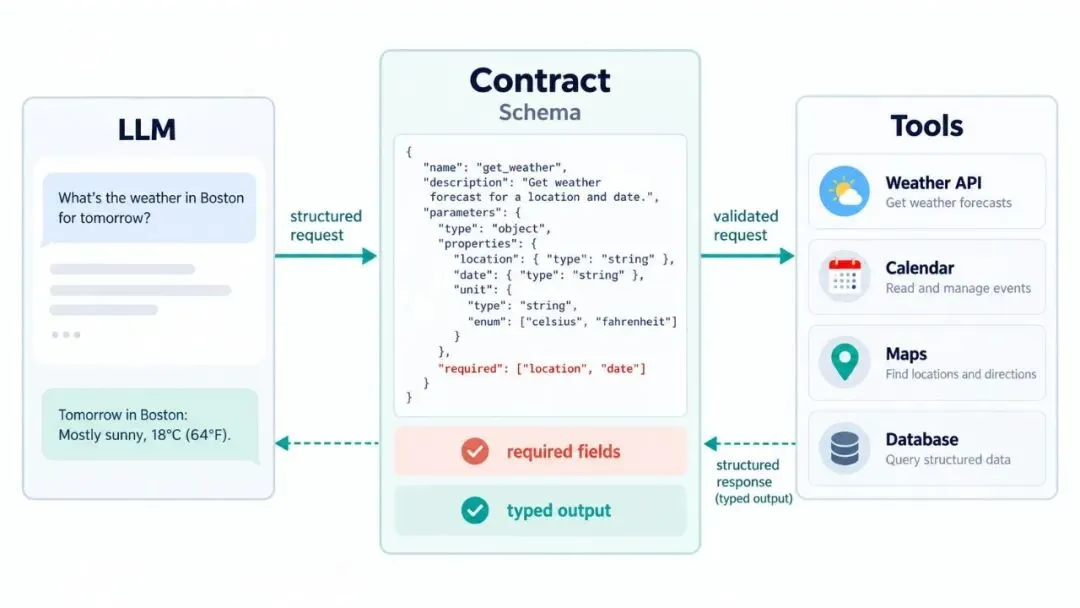
图注:LLM 不是直接“凭感觉”访问工具,而是要经过 Contract / Schema 这一层,把自然语言意图变成结构化请求。接口越清楚,模型和工具之间的误解空间就越小。
三、状态和副作用:为什么“做事”比“回答”复杂
只回答一个问题,很多时候没有外部副作用。
回答错了,重新回答一次就好。哪怕文字不够好,改一改也行。
但一旦系统开始“做事”,情况就不一样了。因为做事会改变状态。
比如购物车里多了一件商品,订单从“待支付”变成“已支付”,审批从“草稿”变成“已提交”,文档从“未发布”变成“已发布”,文件从旧版本被覆盖成新版本。
这些变化会影响后续步骤,也会影响其他人看到的世界。所以同样是 AI,聊天式问答和 Agent 调用工具,是完全不同的风险级别。
模型写错一句总结,最多是文字问题;但如果 Agent 调错工具、改错配置、发错消息、覆盖错文件,它改变的就不只是文本,而是外部世界的状态。
这也是为什么我们后面要单独讲 Memory / State Harness。
所谓状态管理,不是一个高级术语,而是一个朴素问题:系统做过什么,现在停在哪里,下一步应该基于哪个状态继续,如果做错了能不能恢复。
可以记住一句话:
回答错了,可以改一句话;状态改错了,可能要回滚一整条链路。
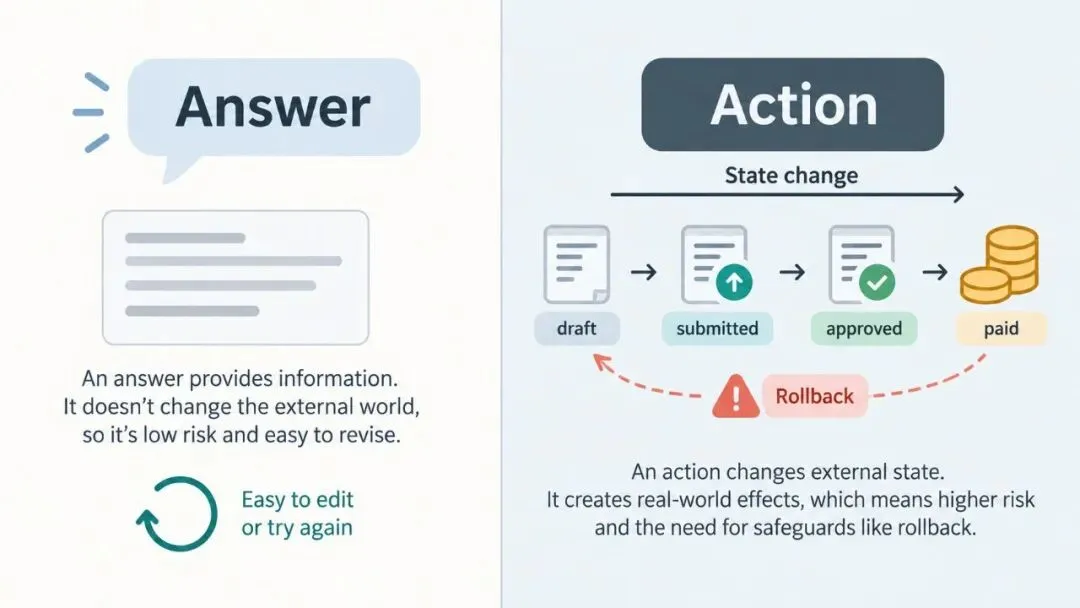
图注:回答通常只是生成信息,改起来比较容易;动作会改变外部状态,比如从草稿到提交、审批、付款。只要开始改变状态,系统就需要记录、确认、回滚和责任边界。
四、错误处理:可靠系统不是不出错,而是知道怎么失败
很多人对可靠系统有一个误解:可靠,就是不出错。
但真实世界里,完全不出错几乎不可能。更实际的目标是:错误能不能尽早暴露,能不能说清楚原因,能不能被隔离,能不能恢复。
一个不太好的系统,遇到问题只会告诉你:“操作失败。”
但失败在哪里?是字段没填?格式不对?权限不够?接口超时?额度不足?不知道。
这时候用户不知道怎么改,开发者也很难定位,系统只能靠人肉排查。
一个更好的系统,会把错误说清楚。
比如:“发票号码重复”“上传文件超过 10MB”“当前账号没有发布权限”“库存接口超时,请稍后重试”。
错误信息本身,也是系统协作的一部分。
这件事放到 AI Agent 里,会变得更重要。
因为 Agent 是要根据反馈决定下一步的。如果工具只返回“失败”,模型很难知道该重试、换参数、换工具、询问用户,还是直接停止。
如果错误信息足够清楚,Agent 才有机会修正路线;如果错误信息模糊,Agent 就可能在错误方向上继续努力。
所以,一个系统是否可靠,不只看它成功时多顺滑,还要看它失败时多清楚。
真正可靠的 Agent,不是永远不会失败,而是失败以后能停下来、说清楚、被检查,并且有机会恢复。
五、测试和验证:不能只相信“看起来能跑”
还有一个老问题:为什么要测试?
因为“看起来能跑”,真的不够。
一个表单正常填写能提交,不代表它可靠。你还要测试少填字段会怎样,金额超限会怎样,重复提交会怎样,权限不足会怎样,接口失败会怎样。
这不是挑刺,而是在系统真正面对用户之前,先替它见一见那些迟早会出现的麻烦。
AI 应用也一样。
一个模型回答了一次,看起来不错,不代表这个能力就稳定。你还要看它换一种问法是否仍然正确,遇到边界问题会不会乱答,引用资料是否真实,格式是否符合要求,调用工具后结果能不能对得上。
所以后面我们讲 Verify Harness 时,它不是一个额外的“审稿环节”。
它其实继承的是软件工程里的测试和验证思想:不要只相信输出看起来合理,要让结果接受检查。
对于可验证的任务,AI 自动化可以更大胆一些。比如代码可以跑测试,数据可以对账,结构化输出可以校验字段。
但对于很难验证的任务,比如战略判断、价值判断、敏感表达、高风险决策,就不能轻易把自主性放大到最后一步。
这也是《重新理解 AI 系列40:不是所有任务都需要 Agent:什么时候 Workflow 更好?》里我们讨论过的判断:能验证的任务,才更适合放大自动化。
“看起来没问题”不是验证,只是问题还没有暴露。
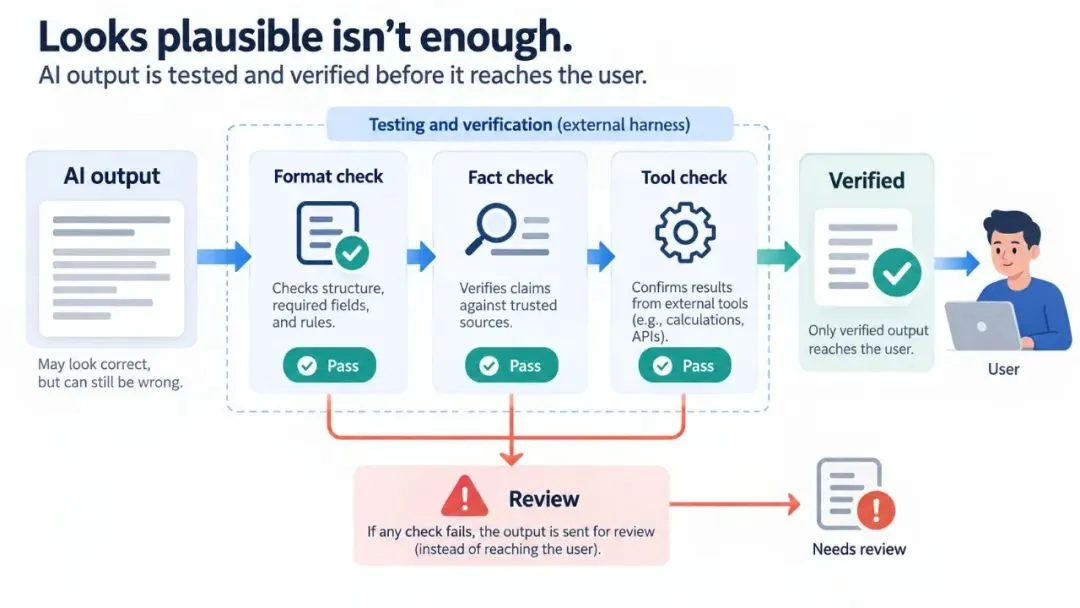
图注:这张图对应 Verify Harness 的直觉:AI 输出不能只因为“看起来合理”就直接交付,而应该经过格式、事实、工具结果等检查。检查不通过,就进入 Review,而不是继续假装没问题。
六、软件工程的底层直觉:把不确定性变成可管理的约束
讲到这里,我们可以把这些概念收回来。
输入校验、接口契约、状态管理、错误处理、测试验证,看起来是很多不同的工程术语。
但它们背后其实在做同一件事:
把不可控的不确定性,变成可管理的约束。
用户输入不可靠,所以要校验;系统协作容易误解,所以要接口;外部动作会改变世界,所以要状态管理;错误一定会发生,所以要错误处理;结果可能看起来对但实际错,所以要测试和验证。
这就是软件工程的底层直觉:它不是为了制造复杂性,而是为了管理复杂性。
AI 出现以后,这个问题没有消失,反而变得更明显。
因为 LLM 本身就带有生成的不确定性。同样的任务,不同上下文、不同材料、不同工具结果、不同中间步骤,都可能让输出发生变化。
当 AI 只是回答问题时,这种不确定性已经会带来幻觉和误解;当 AI 开始调用工具、修改文件、查询系统、生成报告、提交审批、影响真实流程时,它就不再只是“回答质量问题”,而会变成工程风险。
所以,AI 越像是在“做事”,就越不能只靠模型自己聪明。
它需要外面的系统帮它准备材料、限制边界、管理状态、处理错误、验证结果,并在必要的时候把控制权交还给人。
这就是我们后面要讨论 Harness 的原因。
结语
这一篇我们没有讲新的 AI 概念,而是回头看了一眼传统软件工程。我觉得这一步很有必要。
因为如果不理解软件工程在解决什么,就很容易把 Harness 误解成又一个新潮词,或者把 Agent 的可靠性完全寄托在模型能力上。
但真实情况是:AI 系统没有绕开软件工程,只是把软件工程里的老问题放大了。输入还是会脏,接口还是要清楚,状态还是会变化,错误还是会发生,结果还是需要验证。只是这一次,中间多了一个更强、也更不确定的模型。
所以后面当我们讨论 Harness 时,不要先把它想成又一个 AI 新名词。
你可以先把它理解成:当模型开始参与真实任务,我们把软件工程里那些关于输入、输出、接口、状态、错误和验证的老问题,重新放到 AI 系统里解决一遍。
这也是我想写这两篇番外的原因:先把地基讲清楚,后面再谈 Harness,才不会只是在追一个新词,而是在理解 AI 系统可靠性的来龙去脉。
参考资料
• IEEE Computer Society. SWEBOK Guide V4.0. https://www.computer.org/education/bodies-of-knowledge/software-engineering • IEEE Standards Association. IEEE Std 1012-2024: Standard for System, Software, and Hardware Verification and Validation. https://standards.ieee.org/ieee/1012/7810/ • P. Naur and B. Randell, eds. Software Engineering: Report on a Conference Sponsored by the NATO Science Committee, 1968. https://homepages.cs.ncl.ac.uk/brian.randell/NATO/nato1968.PDF