ARTICLE · 1056996
大模型:算力硬件的终极软件载体
前面我们完整走完了 AI 算力硬件全链条:CPU 调度中枢、GPU 计算核心、晶圆制造、先进封装、存储 + HBM 高速数据底座、PCB、高速铜缆。
所有昂贵的芯片、精密的产线、复杂的封装、海量存储,本质上都是硬件底座。而大模型,就是跑在这套算力硬件之上的软件灵魂。
如果把整套智算集群比作一座超级发电厂:GPU、HBM、服务器是发电机组;存储是燃料仓库;CPU 是调度控制系统;大模型就是发电厂最终向外输出的电力,是算力硬件价值的最终载体。
什么是大语言模型?从参数、训练、推理讲清楚
大模型(当前产业主流为大语言模型 LLM,延伸至多模态大模型),是基于 Transformer 架构,通过海量文本、图像、音视频数据训练出来的巨型神经网络。
模型里面的参数,就是从海量数据中学到的知识、逻辑、语言规则、事实记忆。参数规模越大,理论上知识储备、逻辑推理、多任务能力越强。
大模型完整生命周期分为两大阶段:预训练 和 推理
1、预训练(训练阶段):烧算力的 “读书学习期”
预训练就是投喂海量互联网文本、书籍、论文、多模态素材,让模型自主学习语言、常识、逻辑。
特点:算力消耗巨大,需要千卡级 GPU 集群,HBM 带宽是核心瓶颈;
硬件需求:大量高端 GPU,充足 HBM,高速互联网络,海量 SSD 存储训练数据集;
产出:基础大模型基座,具备通用理解与生成能力,但还没有对齐人类偏好。
训练阶段,硬件是最大成本。一次千亿参数模型预训练,需要持续占用大量高端 GPU 数月,HBM 带宽不足会直接导致训练速度大幅下降。
2、推理(应用阶段):面向用户的 “回答输出期”
基座模型训练完成之后,经过微调、RLHF 人类偏好对齐,就可以对外提供服务。用户提问、AI 生成内容,这个过程就是推理。
特点:并发请求多,对单卡显存、访问延迟要求高;
硬件需求:GPU/CPU 均可承载,中小模型推理甚至可以跑在 CPU 上;HBM 不再是硬性刚需,但显存容量决定单次能处理的上下文长度;
产出:用户看到的对话、文案、代码、图片、视频。
很多人误区:大模型只看参数。现在行业共识:不是参数越大越强,数据质量、模型架构、对齐效果、推理优化同样决定最终体验。
大模型与算力硬件的强绑定关系
前面所有硬件章节,最终都服务于大模型的训练与推理:
1.GPU:大模型训练首选,海量矩阵并行计算,是训练的核心算力单元;
2.HBM:解决内存墙,训练时模型参数、中间激活值高速读写,HBM 带宽直接决定训练吞吐;
3.普通存储(NAND SSD+HDD):存放训练数据集、模型权重、向量知识库;
4.CPU:负责任务调度、数据预处理、业务逻辑、Agent 智能体多步骤决策;
5.先进封装 + 晶圆制造:决定 GPU、HBM 芯片能不能造出来、良率、产能;
6.高速铜缆 / 互联:多卡、多服务器集群之间高速数据互通,分布式训练离不开高速互联;
7.液冷:高密度 GPU 集群散热,保障 7×24 小时不间断稳定运行。
一句话总结:没有大模型,算力硬件只是一堆昂贵芯片;没有算力硬件,大模型只是纸上的数学公式。软硬件二者互相定义,互相约束。
大模型技术路线:基座、微调、Agent 智能体、多模态
1、基座大模型
通用基础模型,在海量通用数据上完成预训练,具备通用能力。例如通用大语言基座,能够对话、写代码、做推理。行业竞争早期,大家比拼基座参数规模。
2、微调(SFT)
在基座之上,用行业领域小数据集做二次训练,把通用大模型改造成为行业专用模型。例如金融、医疗、工业、法律垂直大模型。微调不需要千亿级算力,成本远低于预训练。
3、RLHF 人类反馈强化学习
基于人类打分数据,对齐模型输出风格,让模型回答更符合人类价值观,减少幻觉,提升回答实用性。
4、AI Agent 智能体
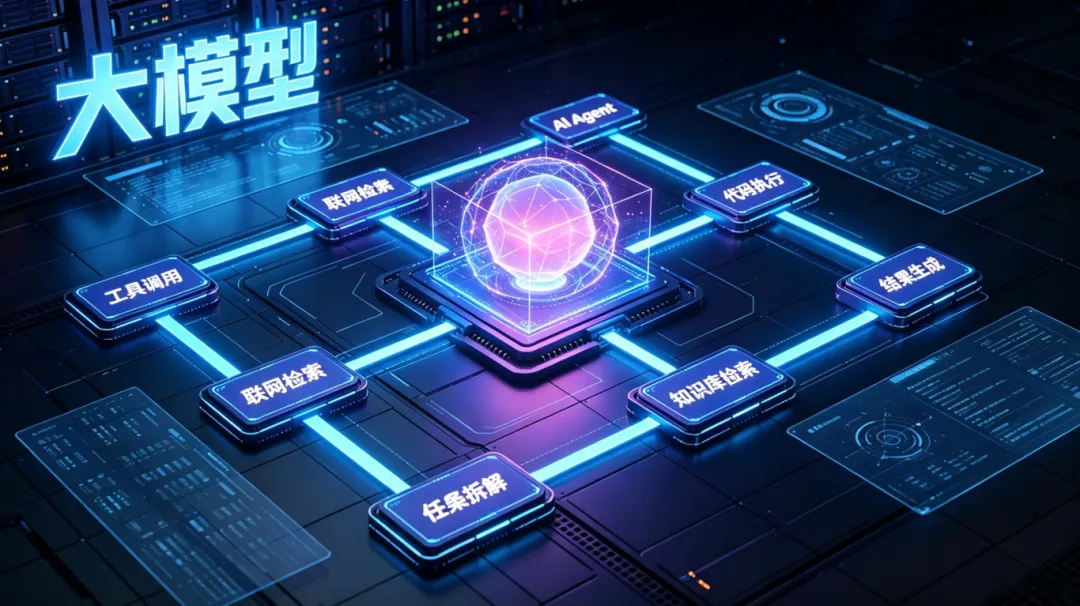
大模型不再只做问答,能够自主拆解任务、调用工具、联网检索、执行代码、多步骤完成复杂目标。
Agent 时代,CPU 的价值进一步放大,大模型负责思考生成,CPU 负责逻辑调度、工具调用。
5、多模态大模型
融合文本、图片、音频、视频,模型可以看图理解、生成图像、识别视频内容,是下一代大模型的主流演进方向。
国内大模型头部厂商梳理
1、百度文心一言
国内最早落地的大模型之一,文心大模型体系完整,覆盖基座、多模态、行业模型,产业落地案例丰富,面向政企、工业、搜索引擎等场景深度落地。
2、阿里通义千问
阿里通义系列,基座能力强,多模态能力完善,依托阿里云算力底座,广泛服务企业私有化部署、行业应用开发。
3、腾讯混元
腾讯自研大模型,在长文本、代码、多模态方向持续迭代,依托腾讯生态,面向企业服务、数字人、内容创作场景落地。
4、字节豆包
字节自研云雀大模型,侧重对话交互、多模态、智能体应用,面向 C 端用户,同时开放 API 给 B 端开发者,轻量化模型丰富。
5、科大讯飞星火
主打行业落地,深耕教育、医疗、工业等垂直领域,长文本理解能力突出,软硬一体,面向政企本地化部署。
6、智谱 AI
智谱清言,千亿基座大模型,学术底子扎实,GLM 系列基座长上下文、代码、科研场景优势明显,主打国产算力适配,可在国产 GPU 集群上完成训练与推理。
7、DeepSeek(深度求索,幻方量化)
源自幻方量化,依托量化领域积累的并行计算、算力调度能力,DeepSeek 系列在数学推理、代码、科研领域实力突出,MoE 混合专家架构,开源模型生态活跃,面向开发者、科研、工程场景。
8、月之暗面(Moonshot AI)Kimi
以超长上下文能力出圈,Kimi 系列原生支持百万级 token 长文本阅读、多模态,主打文档分析、复杂长任务、Agent 智能体,开源旗舰模型参数规模位居全球前列,适合知识库、长报告深度分析场景。
9、百川智能
由王小川创立,百川大模型兼顾基座能力与轻量化模型,开源体系完善,长文本、代码能力优秀,适配私有化部署,面向企业知识库、行业应用。
10、零一万物(01.AI)
李开复博士创立,Yi 系列模型,早期凭借 Yi-34B 开源基座在国际榜单取得亮眼成绩;拥有 Yi-Large、Yi-Lightning 等千亿级 MoE 模型,推理能力突出,兼顾开源生态与企业级落地,发力企业一号位 AI 决策平台,面向政企经营决策场景。
11、MiniMax
聚焦多模态生成,文本、语音、视频生成能力突出,在对话、数字人、多媒体内容创作方向优势显著,面向 C 端与 B 端多媒体 AI 应用。
12、阶跃星辰(StepFun)
Step 系列大模型,采用 MoE 混合专家架构,兼顾推理性能与算力成本,Agent 智能体、复杂分析能力表现亮眼,原生多模态,开源模型持续迭代,在复杂任务推理赛道快速追赶。
13、昆仑万维
天工大模型,轻量化基座与多模态并行,开源路线,面向开发者生态,降低大模型二次开发门槛。
补充:除大厂与上述头部初创模型企业之外,还有大量专注垂直行业的小模型厂商,聚焦细分场景,不需要超大参数基座,在行业知识库、私有化推理场景具备很强竞争力。
赛道机遇与现实挑战
✅机遇
1.大模型从 “预训练竞赛” 转向产业落地,垂直行业模型、Agent 智能体、多模态应用持续爆发,拉动推理算力需求。
2.国产算力硬件逐步成熟,国产 GPU、存储、服务器配套完善,越来越多基座模型可以在国产智算集群完成训练与推理。
3.模型轻量化、稀疏化、蒸馏技术发展,中小模型可以降低硬件门槛,推动 AI 普惠落地,大量企业私有化部署需求增长。
⚠️挑战
1.幻觉问题:大模型会编造事实,在金融、医疗等高可靠场景落地受限,需要向量数据库、检索增强 RAG 技术弥补。
2.训练成本高昂:基座预训练资本投入巨大,模型迭代、数据清洗都需要大量资金。
3.数据短板:高质量中文、行业高质量数据供给不足,优质数据获取、清洗、版权都是难题。
4.应用落地鸿沟:很多行业场景,大模型单独无法解决业务问题,需要和业务系统、知识库、工具链深度结合,落地周期长。
结语:算力硬件承载模型,大模型定义产业价值
回顾整套算力产业链:硅原料→晶圆制造→先进封装→HBM / 存储→PCB + 高速铜缆→AI 服务器集群 →大模型(软件)
前面所有硬件,都是为大模型提供算力土壤。硬件决定模型能不能跑起来;模型决定硬件有没有商业价值。
AI 产业不是单一芯片竞赛,是软硬件一体化的系统之战。未来的竞争,既要持续攻克 GPU、HBM、晶圆制造等硬件短板,也要打磨基座模型、行业微调、智能体应用,打通从底层芯片到上层模型应用的完整闭环。
文末提示:文中企业信息来自公开产业资料,不构成任何投资建议。行业存在技术迭代、落地不及预期、算力成本波动、合规监管等不确定性风险。
END
关注我们
微信号:nwxx88