ARTICLE · 1084832
Jev 不是答案,但它问对了问题:当 AI 的消费者从人变成代码
刷屏的原因跟以往的新技术不同:这个模型不会聊天,不会写文章,不会写代码,连一段像样的文字都生成不出来。它主动砍掉了大模型过去四年里最核心的一项能力,也就是生成文本。发布当天,创始人 Diogo Almeida 的帖子在 X 上有四百多万次浏览,接近两万次点赞,Hacker News 上挂了一整天,点赞近两千、评论五百多条。
一个什么都不会说的模型,凭什么火成这个样子?
因为它在做一件整个行业四年都没人敢做的事:不再讨好"人"这个消费者,转而讨好"代码"这个消费者。
这句话我们慢慢说,因为 Jev 真正重要的地方,不在于它是不是一个更好的模型,在于它把一条被聊天范式遮蔽了很多年的分界线,第一次亮到了台面上。
01 过去四年,所有人都在讨好同一个人
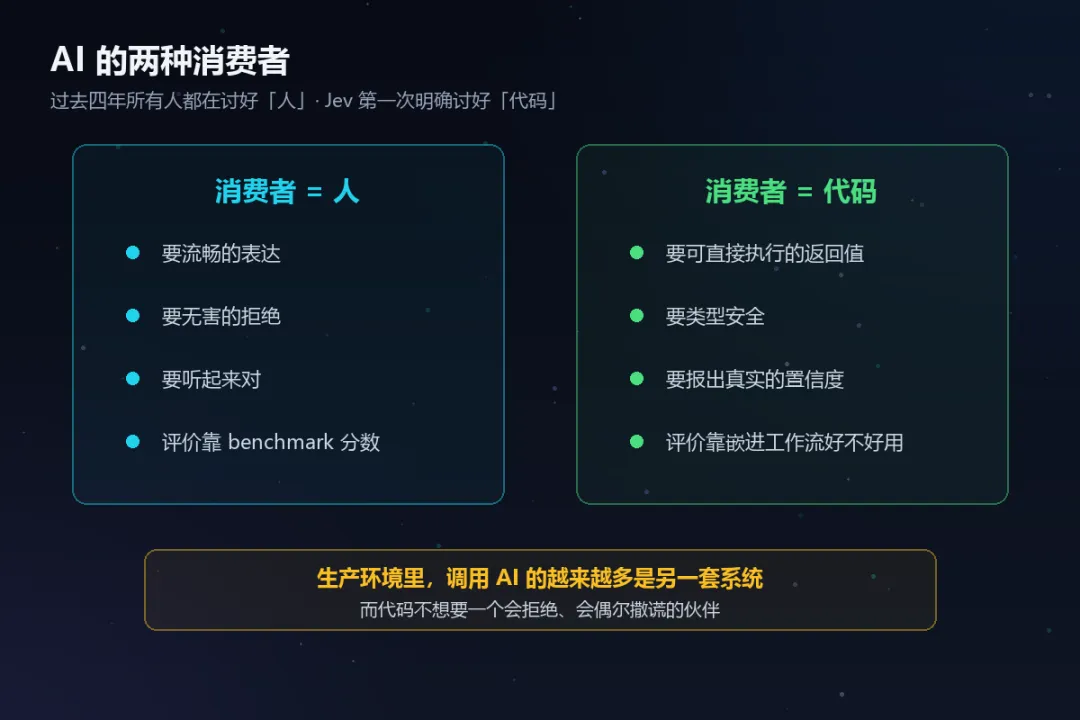
先看一个被忽略的事实:ChatGPT 之后,整个 AI 行业的产品设计,几乎全部围绕同一个消费者展开,那就是坐在屏幕前敲字的"人"。
要让人觉得它聪明,所以追求流畅的表达;要让人觉得它有用,所以让它写邮件、写代码、写周报;要让人觉得它安全,所以做了大量的"对齐",让它拒绝回答不该回答的问题。这三件事,全都是在伺候人的感受,而不是伺候机器的工作。
这里有一个几乎没人点破的矛盾。一个模型到底算不算"好",评价它的是人。但真正在生产环境里调用它的,越来越多的是另一套系统:一个 agent 在判断下一步点哪个按钮,一个风控系统在判断这笔交易可不可疑,一个客服路由在判断这封邮件该分给哪个部门。
这些调用方,不关心这个模型说话好不好听。它们要的是一件事:一个可以写进代码里、可以直接拿来执行判断的返回值。
而大模型给它们的是什么?是一段文本。然后开发者要写一堆代码,去解析这段文本,去验证格式对不对,去处理"对不起,我无法回答这个问题"这种突然冒出来的拒绝。这四年,行业做的所有"结构化输出""function calling""JSON mode",本质上都是在给一个自由的文本生成器打补丁,想把它驯化成一个可靠的接口。
Jev 的做法是反过来:不打补丁,直接把文本生成这个能力砍掉。
先把三个词说清楚,后面全文都按这个口径来。本文区分三件事:
格式正确:输出符合预定义 schema,不会出现非法 JSON、拒绝语、开放文本。
判断正确:在语义上选对了类别,或概率校准准确。
幻觉:通常指自然语言生成里编造事实。Jev 不生成自然语言,所以没有这种幻觉空间,但仍可能判断错误。
Jev 消除的是第一类问题,不是第二类问题。这个区别,是全篇最重要的前提,忘掉它,后面所有讨论都会错位。
02 它到底是个什么东西
Jev 来自 TypeSafe AI,一家旧金山公司,创始人 Diogo Almeida 是前 OpenAI 研究员,也是 2022 年 InstructGPT 论文的主要作者之一,换句话说,ChatGPT 背后那套 RLHF 训练流程,有他的一份。公司拿了四千万美金种子轮,隐身做了两年,才掏出这第一个产品。
它的定位,官方叫"System One 模型",名字借自卡尼曼《思考,快与慢》:System 1 是快速直觉,System 2 是慢速推理。传统大模型无论多快,本质上都是 System 2,一个字一个字往外吐;Jev 要做 System 1,看一眼就下判断。
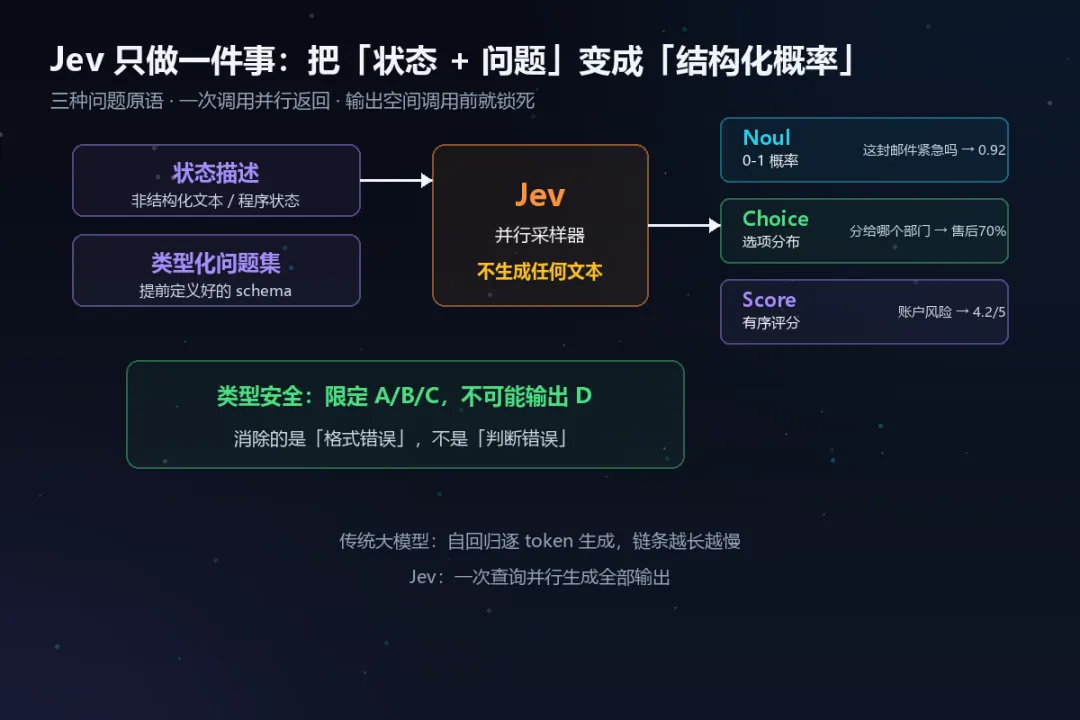
具体怎么工作,一句话就能说清楚:给它一段状态描述,加一组提前定义好的问题,它一次性返回结构化的、带概率的答案。它只有三种"问题原语"。
第一种是判断一个陈述是否成立,返回 0 到 1 的概率,比如"这封邮件需要紧急处理吗",答案是 0.92。第二种是从一组选项里选一个,返回每个选项的概率分布,比如"这个客服请求该分给哪个部门",答案是售后 70%、技术 20%、销售 10%。第三种是打分,返回一个有序尺度上的概率,比如"这个账户的风险有多高",答案是 4.2 分。
就这三种。没有第四种,也没有"解释一下为什么"这个选项。
它最大的卖点,藏在"类型安全"这四个字里。因为输出空间在调用前就被锁死了,它从结构上不可能输出预定义之外的类别,也不可能吐出格式错误的 JSON 或拒绝语。官方有一句话说得挺狠:结构化输出错误率,我们可以给大模型图表加上 0%。
但这个 0% 只指格式错误,不指判断错误。Jev 完全可能把"技术"判成"售后",并且以一个合法 JSON 的形式返回,格式上挑不出一点毛病。
举一个具体的例子。一封客服邮件写着"我的账单扣了两次"。Jev 返回:部门是售后,概率 0.92。
格式完美,没有幻觉,没有拒绝。但正确部门完全可能是技术,因为重复扣费往往是个支付系统的问题。这就是判断错误。校准的意义,从来不是让 0.92 永不犯错,而是让报 0.92 的那一批里,大约 92% 是对的。它消除的是格式错误这一整类问题,不是判断错误。
03 它反对的,是自己当年做的东西
Jev 在技术上的狠,不在架构,在训练目标。
主流大模型的后训练,走的是两条路。RLHF 优化的是"人类评委喜不喜欢这个回答",要的是流畅、有帮助、无害。RLVR 优化的是"这个答案能不能被程序验证为正确",要的是数学证明、代码正确性。Jev 走的是第三条,它自己起的名字叫 RLCD,Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习。
这名字我第一次看也觉得绕。说白了,RLCD 优化的不是"人喜不喜欢",也不是"答案对不对",而是"它报的概率,准不准"。一个模型说"我有 90% 把握",那它在这类判断里,就应该真的错大约一成。这个"说的概率和实际对的概率对得上"的性质,叫校准。
为什么要单独优化这个?Almeida 给了一个很尖锐的解释,他反的正是自己当年参与做的那套东西。RLHF 训练出来的模型,目标是让人类评委觉得好。而人类评委天然喜欢自信的、完整的、顺着自己的回答。于是模型被训练成了"看起来对",而不是"真的对"。他自己的原话是:过度承诺是特性,是设计出来的。
放到生产环境里,这个"看起来对"就是灾难。一个模型能做对 95% 的任务,但它不告诉你哪一次落在剩下那 5% 里,你就没法让它自动跑,只能留个人在环里盯着。TypeSafe 在发布文章里写了句大实话:如果模型 95% 的时候能做对,但不说它什么时候处在 5% 里,它就没法自动化这个任务。
这就是 Jev 声称要补的东西:一个以校准为训练目标、敢说"这次我只有 40% 把握"的模型。但它是否真的敢说、说准,要看 TypeSafe 是否公开可靠性图、ECE、Brier 分数和足够的样本量。目前这些,一样都没有公开。
这里必须把话说清楚:RLCD 让 Jev 优化的是"报的概率准不准",这是一个训练目标,不是一个已经达成、可以兑现的结果。目标不等于结果。如果校准成立,代码就能写阈值逻辑:高于阈值自动放行,低于阈值转给人工,或者扔给一个更贵更强的推理模型二次判断。
而校准是否成立,光靠一句"我们是校准的"说不清楚,得看四项硬东西。
第一项是可靠性图。横轴把模型报出的置信度分成桶,比如 0.5 到 0.6 一桶、0.6 到 0.7 一桶,纵轴是这一桶里实际正确的比例。理想情况是一条对角线,报 60% 的那桶就该有 60% 是对的。
第二项是 ECE,期望校准误差。把每个桶里"实际正确率"和"置信度"的差,按样本量加权平均,得到一个总的偏差数字,越小越准。
第三项是 Brier 分数,概率预测的均方误差,也是一个越低越好的整体指标。
第四项是样本量。每个置信度桶里有多少样本、总样本有多少、覆盖了哪些任务分布,这些决定了前三个数字到底有没有统计意义。
没有这四样,就只能说 Jev 的优化目标是校准,不能说它已经校准。这是两件完全不同的事,也是这篇稿子里最容易被一句话糊弄过去的地方。
04 但这套说法,还没经过验证
到这里,Jev 的故事都是自洽的,甚至有点动人。问题是,一个自洽的故事,不等于一个可信的产品。真正把 Jev 和"又一个融资故事"分开的,是几件它还没证明的事。这里得诚实一点。
最硬的那块没公开,恰恰就是上一节说的那四样东西。整个产品的卖点是"校准的概率",但 TypeSafe 没有发布任何可靠性图、任何期望校准误差、任何 Brier 分数,也没有交代样本量和任务分布。Hacker News 上有人把这个问题说得很准:如果模型标了 0.9 置信度一千次,其中大概九百次应该是对的,这个计数,除了 TypeSafe 自己,没人见过。
换句话说,Jev 证明了它优化的是校准,但还没证明它真的校准了。这两者之间隔着可靠性图、ECE、Brier 和样本量这四份材料,而它们至今一份都没有。
性能数字,官方在其自设任务上声称快 193.6 倍、便宜 444.6 倍;独立机构在另一组条件下测得约 2.9 倍和 12 倍。两个数字差了快两个数量级,但差距主要来自任务、基线、硬件、成本口径和价格补贴,而不是一个简单的"谁在说谎"。
把两边的口径摆开看,差别就清楚了。
这两个数字,很可能测的根本不是同一件事。官方比的是自家设计任务上,Jev 与两个最贵大模型平均预测的差距;独立测试可能换了任务、换了基线、换了硬件,或者把端到端解析、重试、网络都算了进去。
真正有意义的从来不是倍数,而是:在目标生产任务上,端到端延迟、单次决策成本、准确率和校准,能不能同时过线。离开这些条件,193 倍和 2.9 倍都不能直接采信。Jev 的真实优势,可能是个位数到十几倍,也可能在特定任务上接近两个数量级,但前提是任务、基线和成本口径完全透明。而这份透明,目前同样没有。
输出也不稳定。有开发者发现,把同一个问题的选项顺序换一换,同一个答案的概率会从 0.43 跳到 0.63。还有人用一个小开源模型加上提示词,就能复现它的大部分接口,跑在单张消费级显卡上。HN 上最狠的一句评论是,这不就是个带概率头的高级分类器吗。
这些质疑,每一条都成立,但每一条也都没法直接判 Jev 死刑。校准没公开,不代表没有;基准自己评分,但人家也承认"数据不公开、价格可能被补贴";输出不稳定,TypeSafe 自己在测的是"语义相同的输入,输出要稳定",而不是死磕逐字确定性。至于"分类器"这个说法,反过来看,一个不需要每个任务单独训练数据的通用分类器,本身可能就值一家公司。
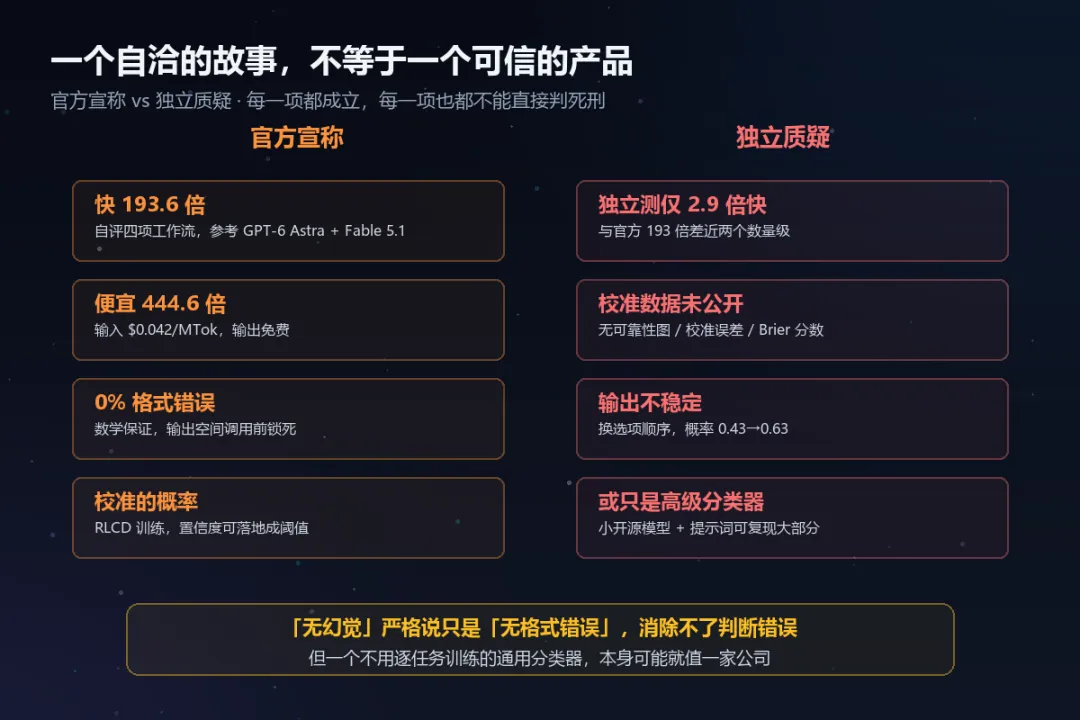
真正要拎出来说的一句是:Jev 的"不会幻觉",严格说只是"不会产生自然语言幻觉",也就是不会格式错误,它消除不了判断错误。The Register 有句评论一针见血:拿"无幻觉"跟大模型比,本来就不公平,结构化输出和自然语言是两套体系,没有幻觉空间,不等于更聪明。换成更准的说法,是没有幻觉空间,不等于更会判断。
05 真正的问题,藏在消费者变了之后
把质疑先放一边,Jev 提出来的那个问题,才是真正绕不过去的。
如果 AI 的消费者,真的从"人"转向了"代码",会发生什么?
第一件事是,安全这件事要重写。我们现在说的"对齐",说到底是让模型对人类安全。可如果模型不再直接面对人,而是躲在另一个系统背后,那它对谁对齐?一个拒绝回答,返回给一个人,是礼貌;返回给一段代码,就是一次随机的崩溃。Almeida 把拒绝叫"类型错误",一个拒绝突然冒出来,下游的软件根本不知道该怎么接。这个说法戳中了一个很现实的痛点。但它解决的是下游代码接不住拒绝这件事,不是保证判断正确。拒绝是格式层面的问题,判断正确是语义层面的问题,两者还是那两条线。
第二件事是,评价体系要重写。过去四年,所有人都在挤 benchmark,比谁分数高。但一个给代码用的模型,benchmark 分数高不高,和它嵌进工作流里好不好用,是两回事。TypeSafe 干脆拒绝公开 benchmark,理由是说它"极度可被操纵"。这话从一个想做生意的公司嘴里说出来,当然有立场,但它点破的那层窗户纸是真的:当一个东西的商品化程度高到人人都在刷分,分数本身就开始失真了。
第三件事,也是最慢但最重的一件,是分工要重写。大模型这四年,其实在做一件很奢侈的事:让最贵的智能,去干最廉价的活,组织语言、维持格式、生成又解析 JSON。Jev 把这层纸捅破之后,一个更朴素的分工浮了出来:让代码做逻辑,让模型做判断。判断单独定价到每一百万 token 四美分、输出免费的时候,大量过去因为"规则写不完"而只能靠人力的决策点,突然变得可以外包给一个便宜的、有自知之明的函数了。
这三件事,没有一件是 Jev 一家能决定的。它现在只是个刚走出隐身的早期产品,能不能活下来、会不会被巨头顺手做掉,都还是未知数。
这个模型教会我们的一件事
回到开头那个问题:一个什么都不会说的模型,凭什么火。
因为它第一次把话说破了。过去四年,我们默认 AI 的消费者是人,于是我们优化表达、优化好感、优化无害。但真正的生产环境里,AI 越来越多地面对的不是人,是另一段代码。而代码不想要一个会聊天、会拒绝、会偶尔撒谎的伙伴,代码想要一个格式稳定、概率若校准则可用于 if 语句的函数。它仍可能判断错,只是错得可以被阈值和人工兜底接住。
Jev 未必是这个答案。它可能是个早产儿,可能是个过度包装的分类器,可能几个月后就被巨头的一个更新盖过去。但它问出的那个问题,会留下来:
当 AI 的消费者从人变成了代码,我们过去四年为"讨好人类"而建立的那一整套东西,对齐、偏好、基准、甚至安全本身,还有多少是仍然成立的。
这个问题,才是 Jev 真正值四千万美金的地方。