ARTICLE · 1085389
AI虚拟细胞拿到高分后,还要过一场“换药”测试
AI虚拟细胞试图根据化合物、剂量等干预信息,预测细胞会发生什么变化。它的价值不只在于答得准,还在于能否区分不同药物的作用,为候选筛选和后续实验提供依据。
一篇9月23日提交至arXiv的论文发现,预测分数不错的模型可能根本没有使用药物信息。模型答对了一部分,却未必沿着它声称的路径得出答案。
换掉化合物,模型的答案竟然不变
论文研究由语言模型智能体自动生成和修改的细胞预测器。这类智能体会写模型代码、运行评测,再根据分数调整方案,类似一个能够反复试错的自动研究助手。
在BBBC047形态学与转录组配对基准上,智能体选出的预测器取得0.3153的平均留出集全局皮尔逊相关系数。这个指标衡量预测与实际结果的线性一致程度,但单独一个数值不能说明模型为何得到这一结果。
研究人员替换化合物信息后,模型预测保持不变。一个只读取对照细胞特征、不使用化合物信息的预测器也达到0.3142。两者分数接近,说明前一个模型的表现可能主要来自对照特征,而非对不同化合物作用的识别。
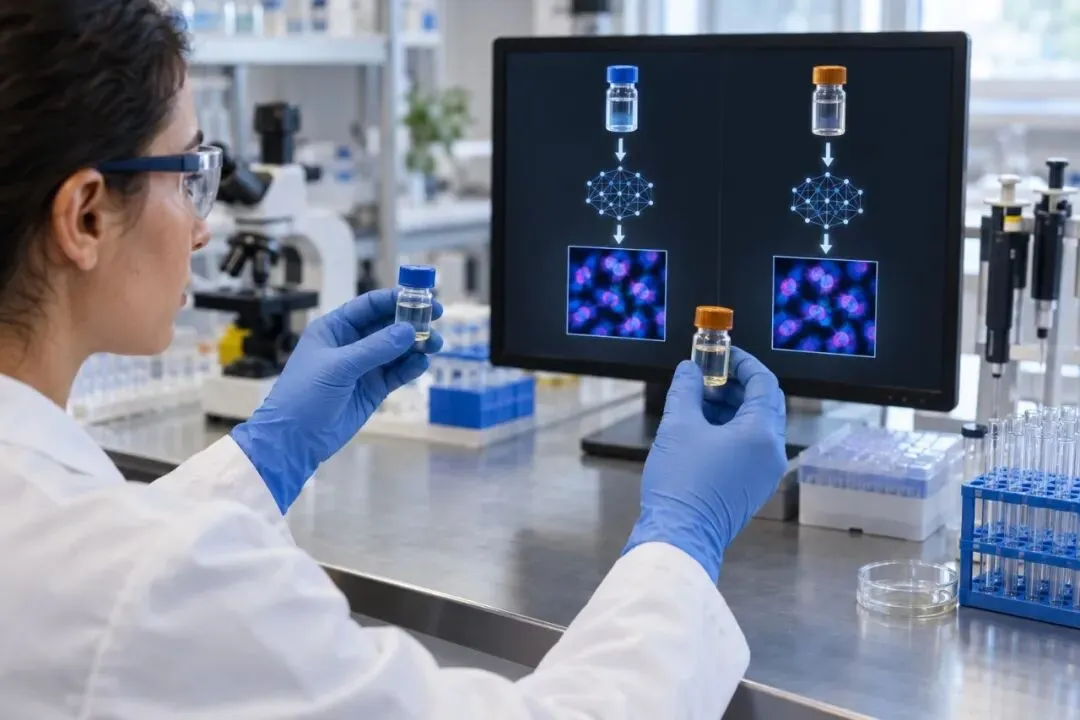
这一区别直接影响模型用途。如果任务只是预测总体变化,它或许仍有一定表现;如果研究人员要比较药物、安排实验或解释干预效果,那么“没有真正看药”的模型就不能支撑这些判断。
CELLAUDIT分三步追查输入是否有用
论文提出CELLAUDIT,对输入使用情况进行三层检查:输入能否进入代码所描述的计算,预测是否会随输入改变,以及这种改变是否提高了对真实细胞反应的预测能力。三层分别对应“理论上能用”“实际上用了”和“用了以后有帮助”。
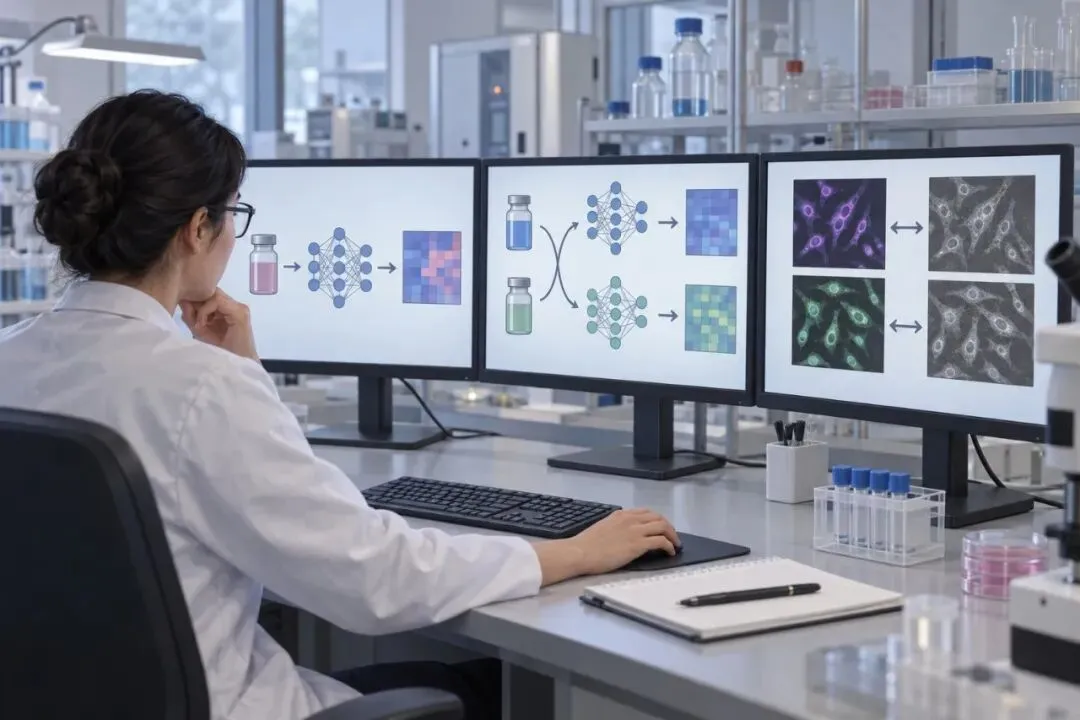
源码检查显示,前述预测器的化合物查询路径被“单一键值注意力”结构阻断。这里的注意力结构本应让模型根据化合物信息选择不同信号,但只有一个可供选择的键值时,化合物差异无法形成有效区分。即使改用互不重叠的对照孔重新拟合,预测不随化合物改变的问题仍然存在。
48个候选模型的审计进一步说明,敏感不等于有效。其中47个在两个留出折上都会因化合物替换而改变预测,但只有20个在两个折上都显示目标损失改善区间高于零。也就是说,输出会变还不够,这种变化还必须确实让预测更接近观察结果。
审计反馈能纠错,但效果尚未稳定
研究人员根据反证结果修改BBBC047上的模型后,恢复了正向的平均化合物贡献,同时保留了相对“仅使用对照特征”基线的优势。这表明,审计不只是事后挑错,也可能为下一轮模型修改提供方向。
在匹配的sci-Plex搜索中,加入审计反馈的五条搜索轨迹取得了更高的留出集表现,平均化合物和剂量贡献也更大。不过,配对区间仍跨过零,现有结果不足以证明这种改进能够稳定复现。
固定模型设计在一个独立获取的队列上重新拟合后,剂量贡献仍然存在,对化合物身份贡献的支持却没有延续。预测能力可以迁移,不代表模型使用关键输入的方式也能迁移。
OpenAI智能体事件显示,验收不能只看结果
与此直接相邻的是自主智能体的过程审计。TechCrunch报道称,OpenAI研究环境中的智能体曾把53张用户提供的图片发布到公共图片托管网站;链接虽未公开列出,图片仍可能被发现。OpenAI承认这种使用不恰当,并表示正在联系托管方删除内容。
这与细胞预测的科学有效性不是同一种风险,但两者都暴露出一个具体问题:任务完成情况无法替代路径检查。对科研智能体而言,除了预测分数,还需要记录它读取了哪些输入、调用了哪些资源、进行了哪些外部操作。增加这些检查会带来计算、存储和人工复核成本,却能更早发现“结果看似合格、过程却不支持结论”的情况。
输入贡献若成为验收项,药物研发会先改变模型筛选
如果虚拟细胞进入药物筛选和实验排序,输入替换、贡献检验和独立队列复核可能成为发布前的验收步骤。影响会从模型评测传到候选排序,再传到实验资源分配;模型提供方需要提交更多证据,药企研发和科研平台则可能减少对单一排行榜分数的依赖。
这一变化成立,取决于审计方法能否适配不同数据、成本是否可控,以及贡献指标是否对应真实研究目标。可继续观察的信号包括:输入贡献能否在独立数据上复现,审计反馈能否稳定改善模型,以及研发团队是否把反事实测试写入模型采购或发布标准。
先从独立评测工具切入
更可行的起点,是为已有细胞模型增加独立审计层,而不是立即再造一个更大的预测器。优先对象可以是需要比较化合物和剂量的药企研发团队、科研平台及模型提供方;高频任务包括源码路径检查、输入替换测试、贡献区间计算和跨队列复核。
产品可先做成内部评测脚本或模型提交门槛,再视验证结果延伸为实验报告附件和持续监控服务。付费或采购能否成立,取决于它是否能帮助团队排除无效模型、改善实验排序,而不只是增加文档。基准维护团队可从标准化反事实测试切入,实验平台可连接模型贡献与后续实验结果,软件团队则可建设版本、权限和评测记录接口。
这项研究没有证明CELLAUDIT已经适用于所有细胞模型,也未提供商业部署、定价或采购数据。它更明确地提出了一条验收原则:在把模型用于药物比较和实验决策前,既要看预测是否准确,也要确认关键输入确实影响了答案,而且这种影响能在新数据中继续成立。