ARTICLE · 1090207
VSpector:让 AI 通过 RISC-V 规范审计 RISC-V CPU RTL
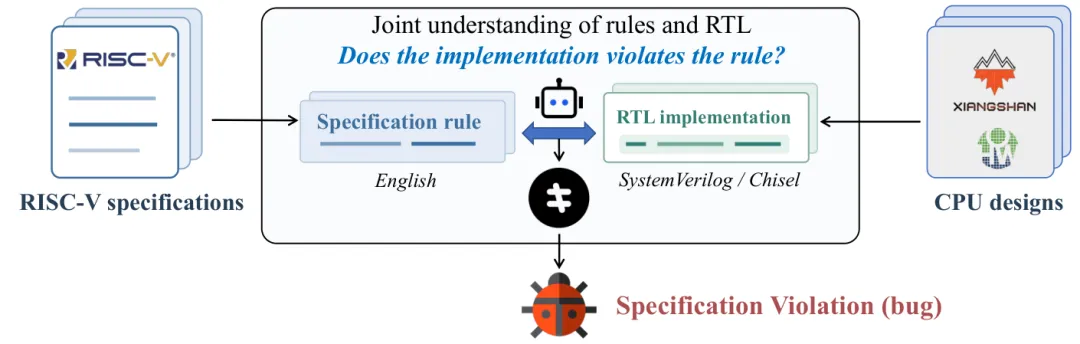
Figure 1:规格违规检测的基本思路——从规范中提取规则,在 CPU 仓库中定位实现,用 LLM 判断实现是否遵守规则。
中国人民大学研究团队在 arXiv 上发布了一个叫 VSpector 的工具,做的事情说起来不复杂:把 RISC-V International 维护的官方自然语言规范当作“裁判”,直接去审开源 CPU 的 RTL 代码,看实现有没有违背规范规定的规则。不需要参考模型,不需要手写形式化属性,也不需要预定义 bug 模式。
在 CVA6 和香山(XiangShan)两款工业级 RISC-V CPU 上跑下来:报出 217 个候选违规,人工复核确认 148 个为真,精确率 68.2%,对应 73 个独立 bug,其中 42 个是此前无人知晓的新 bug。这 42 个新 bug 全部上报了上游,开发者已经修复 19 个、确认 11 个(合计 30 个)。对照实验更扎眼:最先进的 RISC-V CPU fuzzer DiveFuzz 在每个 CPU 上跑 24 小时,这 42 个新 bug 一个都没找到。
为什么现有手段都有天花板
CPU 出 bug 是个很尴尬的问题。软件出 bug 可以打补丁,CPU 流片之后基本没法改,只能禁用受影响的功能,代价往往是显著的性能损失。
现在检测 RISC-V CPU bug 主要有三条路:
- CPU fuzzing
:把同样的输入向量喂给被测 RTL 和参考 ISA 仿真器,比对寄存器、内存等架构状态的差异; - 形式化验证
:证明 RTL 是否满足预先写好的正确性属性; - 静态分析
:借鉴软件分析思路,用总结出的 bug 模式扫描 RTL。
问题在于,这三条路全都依赖“预制工件”——参考模型、属性、bug 模式——而这些工件本身并不可靠。参考模型自己就可能实现有偏差:NEMU(香农团队维护的 ISA 仿真器)和 Spike 都把性能计数器简化成了只读零,这虽然符合规范(规范允许这样实现),但意味着靠差分比对永远抓不到溢出中断相关的 bug。手写的属性和模式则容易出错、覆盖不全。
规范本身倒是个被忽视的高质量信息源。RISC-V 官方规范独立于任何具体实现,用自然语言全面定义了合规 CPU 必须遵守的规则,覆盖指令语义、特权模式、控制寄存器、中断、地址转换、外部调试。RTL 没遵守某条规则,大概率就是一个 bug——论文称之为“规格违规”(specification violation)。论文举的例子是香农的 HFENCE.GVMA:规范要求 fence 忽略操作数 rs2 的保留位,但对应的 Chisel 实现却让两个保留位参与了选择待刷新转换项的比较。
跨领域理解自然语言规范和 RTL 代码,正是 LLM 能做的事。但有个绕不开的权衡:一节规范往往包含多条相互关联的规则,对应实现可能散落在多个模块里。把交织的规则和大范围 RTL 直接塞给 LLM,模型对关键逻辑的注意力会被稀释;上下文切太窄,又会漏掉必要细节,产生误报。
四段式流水线怎么工作
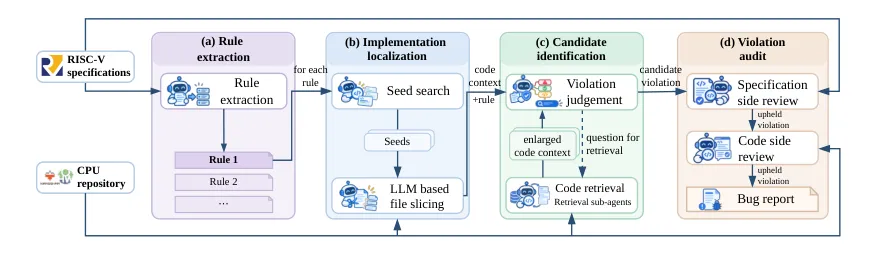
Figure 4:VSpector 总览。规则提取(a)对每节规范运行一次;实现定位(b)和候选识别(c)对每条规则运行一次;违规审计(d)对每个候选违规运行一次。带机器人图标的方框是 LLM 调用,(b)–(d) 各阶段会检索并读取 CPU 仓库。
VSpector 的解法是逐步细化,分四个阶段:
规则提取。不靠 must、shall、if 这类关键词,而是按节标题切分文档,逐节喂给 LLM,让它提取该节要求 CPU 遵守的规则——可能是单条陈述、语义紧密相连的连续陈述、示例代码片段,也可以是寄存器位设置表格。比如 cm.jt 的跳转目标 bit 0 必须清零,是从一段伪代码里提出来的;一条没点名指令的 rs2 保留位规则,LLM 会根据所在章节补全成针对 HFENCE.GVMA 的自包含规则。
实现定位。对每条规则,先由 LLM 生成 grep 搜索模式,从仓库里找与规则直接对应的核心代码片段(种子)。一轮搜不完就进 ReAct 风格的多轮循环——规范和代码对同一实体的命名经常不一致。论文给了一个很实在的例子:查“中断唤醒 WFI 后 hart 必须先取中断”这条规则,第一轮搜 wfi 在 41 个文件里返回 196 个命中、4 个相关;从这些代码里 LLM 学到了设计里的命名(hasWFI、wfiEvent),第二轮据此搜出了 CSR 单元发出的中断请求信号 intrBitSet,第三轮才找到决定性的代码——ROB 只在 intrEnable 时取中断。找到种子后,再用 LLM 切片(每文件一次调用):1708 行的 Rob.scala 只保留 10 个代码块共 227 行,其中红色的判定代码说明 load/store/fence/CSR 访问/原子操作永远不可中断(因为内存访问可能已到达设备),于是 WFI 之后的 load 会先执行完再取中断——mepc 指向了本不该执行的指令,规则被违反。
候选识别。LLM 对每条规则给出三种判决:违规、无违规、代码不足。代码不足时必须列出阻碍判决的具体问题,每个问题分配一个独立的 ReAct 检索子代理去搜仓库。为了防止 LLM 复制代码出错,子代理只报告代码位置(文件加行号范围),由 VSpector 从仓库原样读回。Figure 7 的例子很典型:HFENCE.GVMA 那条规则定位后,上下文里看不到标识符掩码,但宽度声明在上下文之外——若标识符和 VMID 等宽,保留位会被丢弃、规则其实满足。第一轮判决只能是“代码不足”,两个子代理分别去查标识符宽度/掩码情况和 VMIDLEN/VMIDMAX 常量,答案是 16 位对 14 位。扩上下文后,LLM 判违规并正确定位根因。
违规审计。每个候选在上报前过两道独立复核。规范侧复核把候选放回完整规范语料中理解,防止“断章取义”——实际案例是 Privileged ISA 说 mnstatus.NMIE 为零时 M-mode 陷入 critical-error 并输出信号,香农在 dcsr.cetrig 置位时不输出信号被报为违规,但复核在 Debug Specification 的 dcsr 字段表里找到了决定性条款:cetrig 置位时应进 Debug Mode 而不是输出信号,候选被驳回。代码侧复核独立验证分析本身:违规是否真的会在该设计中发生、是否架构可观测。比如 CMO 扩展要求 prefetch 不抛异常、不做 accessed/dirty 位检查,香农 TLB 确实对 prefetch 做了权限检查并标记 page fault,但复核追踪流水线发现 prefetch 的所有异常在提交前都被清除,永远不会变成 trap——候选被驳回。
实验结果:数字都在这
实验设置上,两款被测 CPU 分别是 SystemVerilog 写的顺序执行应用级核 CVA6 和 Chisel 写的高性能乱序核香农,覆盖不同 HDL 和微架构。规范语料用 RISC-V International 发布的四份文档:指令集手册第一卷(非特权架构)、第二卷(特权架构)、RISC-V 高级中断架构(AIA)和 Debug Specification。审计范围按各 CPU 实际支持的扩展裁剪:CVA6 是 410 节 2400 条规则,香农是 580 节 3285 条规则。实现基于 Python 和 LangGraph,模型用 DeepSeek-V4-Flash(0731 版)的思考模式,文档用 GLM-OCR 从 PDF 转 Markdown。
六个 campaign 合计检查了 5685 条规则,识别阶段产出 1083 个候选,审计后剩 217 个,人工复核 148 个为真。六个 campaign 的精确率从香农非特权 ISA 的 40.0% 到香农 AIA 的 100% 不等。42 个新 bug 覆盖全部四份文档:6 个是接受了本应抛 illegal-instruction 的保留编码或错误基宽编码;6 个是合法指令产生错误结果或状态更新;8 个是 CSR 字段的复位值、合法值集合或写/trap 返回时的更新有问题(比如 CVA6 的 MRET 返回 M-mode 时仍从 mstatus.MPV 恢复虚拟化模式 V,而此时 V 必须为 0);8 个是 trap 取错、取晚或中断丢失;7 个在地址转换、权限检查和 fence;7 个在调试扩展(从 trigger 匹配到复位后的 halt 序列)。
69 个误报里,24 个是对规范读得过于严格(规范其他地方有例外或更宽松的许可,比如允许用 trap 模拟实现 time),30 个是读错了 RTL,15 个在源码上成立但实践中不会发生(14 个依赖不被支持的参数组合,如 CVA6 的 RV32 加 hypervisor 扩展;1 个依赖软件栈永远不会产生的状态)。
和 fuzzing 的对比里,DiveFuzz 在相同 commit 上每 CPU 跑 24 小时(CVA6 用 Spike 做参考、香农用 NEMU),生成了 CVA6 的 320,384 个程序和香农的 41,984 个程序。73 个 bug 里 DiveFuzz 找到 2 个(都是已知 bug:ecall/ebreak 写指令字到 mtval、无大端数据通路时大端控制位仍可写),42 个新 bug 一个没找到。DiveFuzz 另外找到了 4 个 VSpector 未报告的 bug,全是已上报的。
组件消融方面,两道复核拒绝的候选 largely 不同:866 个被拒候选中只有 416 个被两道复核同时拒绝。单用规范侧或代码侧复核,剩下的候选分别是 384 个(精确率 38.5%)或 500 个(29.6%);两道串联后 217 个、精确率 68.2%,无审计则是 13.7%。整节检查(一节规范当作一条规则)的对照组在包含 73 个 bug 的 94 节上只覆盖了其中 34 个 bug(召回 46.6%),说明逐条规则检查多找到了 39 个 bug。
成本方面,六个 campaign 总计 909 美元,平均每条规则约 0.16 美元。单 campaign 从香农 AIA 的 29 美元到香农特权 ISA 的 229 美元。规则定位和识别占了 870 美元(95.7%),合计 66,448 次模型调用、7.083 亿输入 token 和 12.132 亿输出 token;审计只花了 39 美元(4.3%)。每条规则从种子搜索到最终判决平均 20.5 分钟。
为什么 fuzzer 抓不到这些 bug
论文对 NEMU 做了一次很有意思的剖析:把香农的 25 个 bug 逐一对照 NEMU 源码,分成三类。
第一类,9 个 bug 在识别时 NEMU 里同样存在——非幂等区域的非对齐访问抛 address-misaligned 而非 access-fault、HLVX 在 PMP/PMA 阶段只查读权限、地址 trigger 在 pointer masking 之前比较地址。RTL 和参考模型一起错,差分测试无从发现差异。
第二类,7 个 bug 涉及 NEMU 简化掉的行为:NEMU 实现了 Sdtrig trigger 但没有 Debug Module 和 Debug Mode(dmode 硬连零),性能计数器只读零、mip.LCOFIP 从 RTL 拷贝,中断注入跟随 RTL,WFI 是空操作。这些行为从不参与比对。
第三类,剩余 9 个 bug NEMU 遵循规范,差分测试原则上能查到,但触发仍需要精心构造的程序——24 小时 DiveFuzz 就没触发出来。
这基本上宣告了:基于参考模型的差分测试,在“参考模型自己也不全对”这一点上有个结构性盲区,而 VSpector 直接对着规范审计,绕开了这个依赖。
总结评论
这项工作的真正价值不在于 68.2% 这个精确率——比这高的方法很多——而在于它证明了官方规范本身就是一种不需要额外构建、且独立于参考模型错误的验证工件,这在差分测试统治 RISC-V 验证多年的背景下是方法论层面的补充。909 美元审出 42 个新 bug 的成本结构,意味着开源 CPU 社区可以把规范审计当作每次发版前的例行检查。对做自研 RISC-V 核的团队,更现实的启示是:这类工具迟早也会指向私有实现,而私有规范往往远不如 RISC-V 规范写得完整自洽——规范质量本身会成为 LLM 审计效果的上限。短板也明显:精确率无法度量召回,且检测器和复核用同一个模型,误读可能被系统性放大。
参考来源
arXiv: VSpector: Specification-Driven Bug Detection for RISC-V CPUs