ARTICLE · 1093948
从静态 PDF论文 到可交互 AI Agent(斯坦福实操案例)
从静态 PDF论文 到可交互 AI Agent(斯坦福实操案例)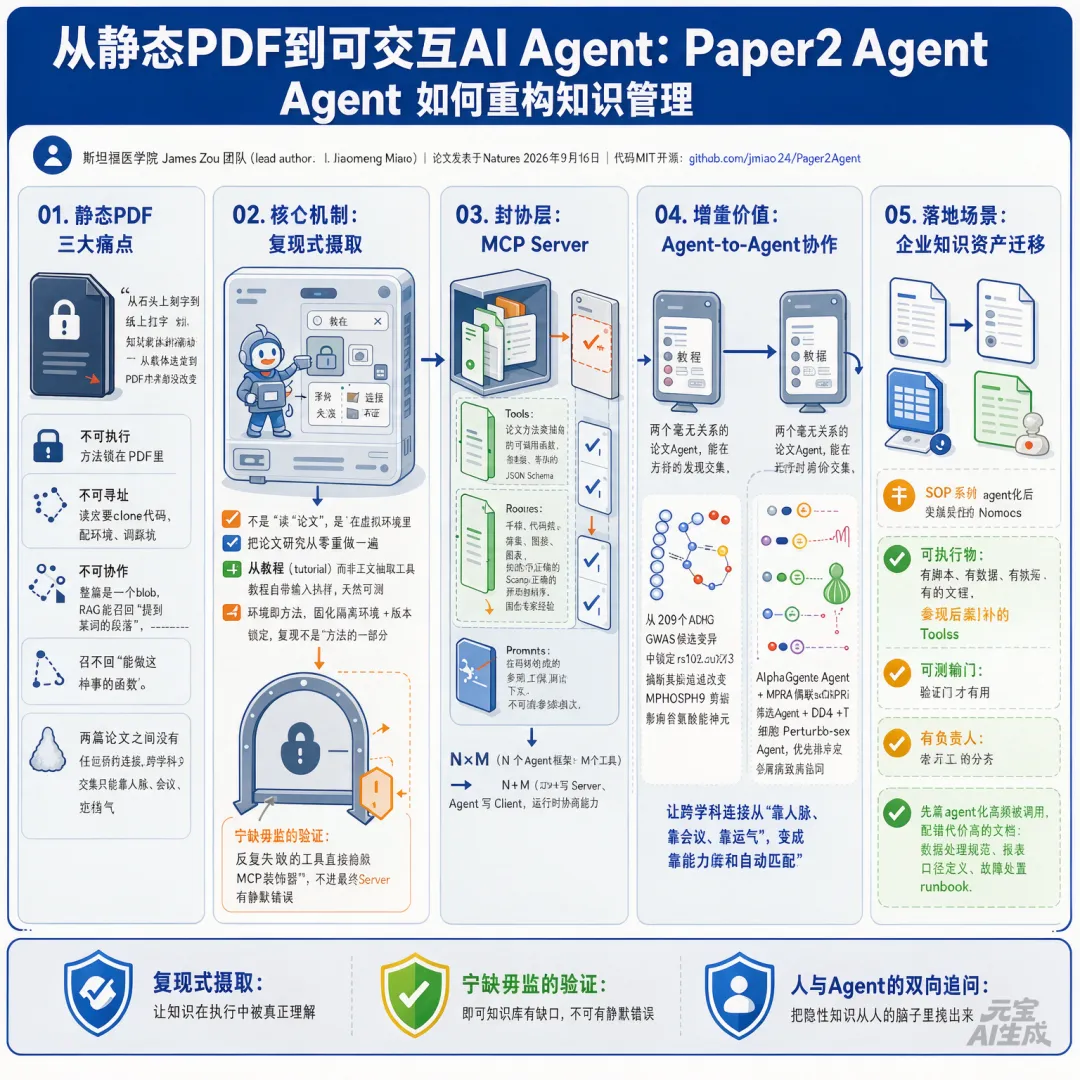
斯坦福医学院教授 James Zou 有一句很尖锐的话:"从石头上刻字到纸上打字,纸并不比石头好多少。" 一篇 2024 年发表的论文,和一篇 1994 年的论文,在载体上有什么区别?PDF 翻页更快了,搜索更方便了,仅此而已。 知识的形态仍然是被动的:它描述结论,但不执行结论;它记录方法,但不运行方法;它引用前人,但不与前人对话。 Zou 团队在 2026 年 9 月发表于《Nature》的论文里,给出了一个截然不同的答案:Paper2Agent——把一篇学术论文(正文、图表、代码、数据)自动转换成一个 MCP Server。 任何支持 MCP 协议的 AI Agent(比如 Claude Code、Codex)挂载之后,就可以用自然语言直接调用这篇论文里的方法。
Paper2Agent 给自己的定位很巧妙——"虚拟通讯作者"。 它不是你常见的"论文问答机器人"。 问答机器人做的事情是 RAG:把论文切块,召回相关段落,让大模型基于段落生成答案。本质上还是在"读文本"。 而 Paper2Agent 做的事情是:让一个 AI Agent 变成这篇论文的"化身"——它知道知识是怎么被生产出来的,能解释每一步选择,能把方法应用到你的新数据上,甚至能主动找到其他论文的 Agent 并与之协作。 用 Zou 的话说,知识载体从"描述结论的文本"变成了"能跑出结论的系统"。
整个流水线由中央 orchestrator 调度多个专职子 agent 并行工作,分为四个阶段。 第一阶段:代码库识别与抽取。 Agent 不是从正文中"理解"方法,而是直接定位论文关联的 GitHub 仓库、补充材料里的脚本和数据。代码才是方法最精确的说明书。 第二阶段:环境配置。 在隔离的虚拟环境里安装所有依赖,记录版本号。环境本身就是方法的一部分。 第三阶段:工具合成与 MCP Server 生成。 这是最关键的一步。Agent 从论文的教程(tutorial)而非正文里抽取工具。教程是论文方法最接近"可执行规范"的形态——自带输入输出样例,天然可测。Agent 把教程里的每一步操作包装成带参数的 MCP 工具,配上 JSON Schema 描述。 第四阶段:测试、精炼与部署。 专职的 Test-Verifier-Improver agent 生成测试用例、执行、诊断失败、打补丁,循环迭代。参照标准只用教程自带的样例——确保对数值结果和可视化结果的忠实复现。 反复失败的函数,直接摘除 MCP 装饰器,不进最终的 server。 宁可少几个工具,也不能让一个会静默出错的工具有机会被调用。 这个"宁缺毋滥"的策略是整个系统可信度的基石。
Paper2Agent 最让我兴奋的设计,是它对论文的摄取方式。 传统思路是让 AI "读"论文。 但论文里没写的东西远比写了的多: 为什么阈值取 0.25 而不是 0.3?哪组参数试过不行?Supplement 里的默认值、数据版本、随机种子——这些决定结果的东西,正文里往往一笔带过。 Paper2Agent 的做法是: 让 worker agents 在隔离虚拟环境里,把论文的研究从零复现一遍。 复现一遍,等于把那些隐性的执行细节在执行轨迹里显式化。 这一步把"文档理解"问题转成了"程序合成 + 测试"问题——而后者有明确的是非判定标准。这是它能做到可靠的底层原因。 知识不是被"理解"的,是被"执行"的。只有跑通了,才算真正拿到了这篇论文的方法。
MCP(Model Context Protocol)是一个开放标准,让 AI 应用以统一接口连接外部系统。 它把 N 个 agent 框架和 M 个工具之间的集成问题,从 N×M 压缩到 N+M。 每个生成的 Paper2Agent server 暴露三类原语: Tools——论文方法包装成的可调用函数,带参数、带校验。让方法真正可执行,而不是被描述。 Resources——手稿、代码链接、数据集、图表。保留可溯源的原始上下文,随时可以 @ 引用。 Prompts——编码好的多步工作流。比如 Scanpy 数据分析里"正确的预处理顺序",这种专家才知道的操作次序,被固化成模板,新人直接调用就不会踩坑。 为什么是 MCP 而不是 RAG? RAG 返回的是"文本片段",模型拿到后仍需自己推断怎么做; MCP 返回的是可调用的能力加结构化结果。 前者是"告诉你别人怎么做的",后者是"替你做一遍"。
前面说的都是单篇论文的 agent 化。 但 Zou 团队最看重的,是第三件事——Agent-to-Agent 协作。 传统科研里,跨学科的知识连接受限于人类注意力带宽。你不知道某篇论文存在,或者知道但没精力读完并动手试。Agent 化之后,连接成本从"读一篇论文、配环境、跑通"降到"一次工具调用"。 论文里给出了两个案例。 案例一:ADHD 研究。 两篇毫无关系的论文被 agent 化——一篇是预测基因突变如何影响基因组的工具(AlphaGenome),一篇是 ADHD 患病风险的 GWAS 研究。两个 agent 自动对接后,从 209 个候选变异中锁定了 rs1626703,并推断其通过改变 MPHOSPH9 基因的剪接与表达来影响谷氨酸能神经元。这个关联此前未被报道。 案例二:银屑病研究。 三个 paper agent 串联协作——AlphaGenome agent、MPRA 偶联 scCRISPRi 筛选 agent、CD4+ T 细胞 Perturb-seq agent——共同优先排序银屑病的致病基因。 Zou 的愿景是大规模的"手稿相亲":数百万个 paper agent 在运行时互相发现交集、自动协作。这本质上是把"跨学科合作"从靠人脉、靠会议、靠运气,变成了靠能力发现和自动匹配。
团队在 AlphaGenome 上生成了 22 个 MCP 工具,在个人笔记本上约 3 小时、无人干预完成。 教程查询和新颖查询均达到 100% 成功率。运行耗时中位数方面,教程类基准较 Claude+Repo 快 1.8 倍,较 Biomni 快 3.1 倍;新颖查询快 3.2 倍和 4.6 倍。 Scanpy agent 生成 7 个工具约 45 分钟,在四个公开数据集上的细胞数、基因数、top marker gene 结果均与人类研究者一致。 规模化测试覆盖 100 篇 bioRxiv 计算生物学论文,无需人工策展。团队目前已创建 100 多个 paper agent。
论文信息:Miao et al., "Paper2Agent: autonomous generation of machine-actionable scientific papers", Nature, September 2026. 代码 MIT 开源:github.com/jmiao24/Paper2Agent
关于作者:本文基于斯坦福医学院 2026 年 9 月 16 日发布的 Paper2Agent 研究及 James Zou 团队公开访谈整理解读。 James Zou 团队介绍
James Zou(邹佳城) 职位:斯坦福大学医学院生物医学数据科学副教授(Associate Professor of Biomedical Data Science),斯坦福人工智能实验室(SAIL)核心成员。 学术背景:哈佛大学应用数学博士,曾在微软研究院、Broad Institute 从事计算生物学研究,后加入斯坦福。 研究方向交叉性极强:横跨机器学习理论、计算基因组学、医学 AI 三大领域,长期关注"AI 如何改变科学研究本身的方式"。 公众影响力:经常在 Nature、Science、NEJM 等顶刊发表评论与论文,是"AI for Science"方向最具公众能见度的学者之一。 Jiacheng Miao(苗佳程) 职位:斯坦福医学院博士后学者,Paper2Agent 论文的第一作者(lead author)。 角色:负责框架的核心工程实现,包括多 agent 编排、MCP server 生成流水线的设计与开发。
Zou 实验室的全称是Zou Lab, Stanford Medicine,官方定位是: 但更准确地说,这个团队做的事情可以概括为三层: 第一层:用 AI 理解生物医学数据。早期工作集中在基因组学、蛋白质结构预测、单细胞测序等方向的算法开发。 第二层:用 AI 评估和改进医疗 AI 系统本身。包括医学大模型的可信度、公平性、幻觉检测、临床决策支持的安全性——这是 Zou 近年来非常活跃的方向。 第三层:用 AI 重新设计"科研流程"本身。Paper2Agent 属于这一层,也是目前最具范式突破性的一条线。核心问题是:如果 AI 已经能读论文、能写代码、能跑实验,那"做科研"这件事的架构应该怎么重新设计? 主要资助方包括Chan-Zuckerberg Biohub、NIH、NSF 等; 实验室隶属于斯坦福大学医学院生物医学数据科学系,同时与斯坦福 AI Lab、Chan-Zuckerberg Biohub San Francisco 有紧密合作关系; 团队规模不大但产出密度极高,常年保持每年多篇 Nature/Science 子刊级别论文。
一、从"刻在石头上"到"活在系统里"
二、核心命题:从 passive artifact 到 active embodiment
三、它是怎么做到的:四个阶段,一群 worker agent
四、最反直觉的一步:不是"读懂",是"重做"
五、MCP:给知识一个"文件系统"
六、真正的增量:Agent 之间会互相找
一、核心人物
二、团队定位
"Developing machine learning methods to analyze and design biomedicine."