ARTICLE · 1097350
花成本搭建企业内部AI助手,员工却不愿意用,4个真实原因
企业AI, RAG, 大模型落地, 知识库, AI应用,迪飞特科技
前言
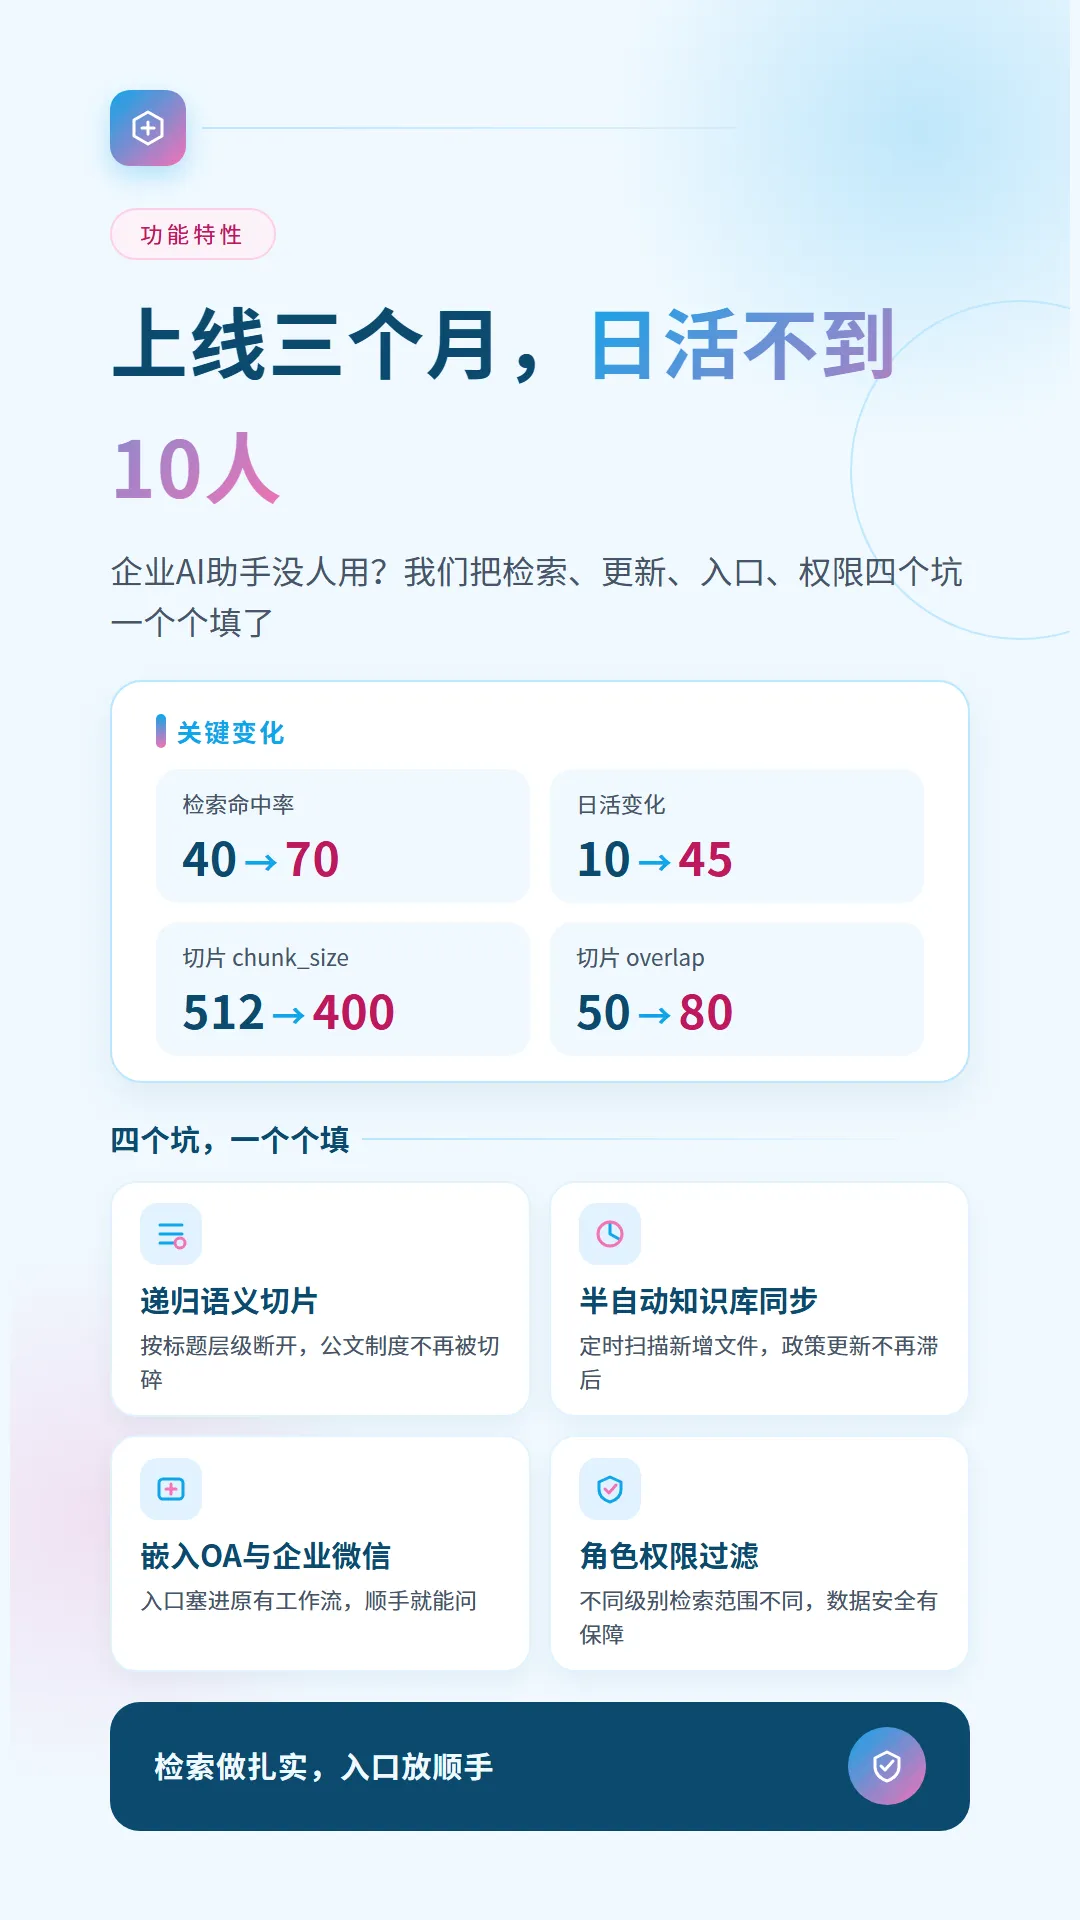
去年帮一家做文旅监管的客户搭了套内部AI助手,预算批了,模型也部署了,结果上线三个月,日活不到10个人。这事挺打击人的。
如果你也在推企业内部的AI问答、知识库或者智能助手,不管是给政务单位还是私企用,这篇文章应该能帮你少走点弯路。我会把我们踩过的坑、后来怎么调整的,一条条拆开讲。
问题背景:钱花了,人不用
那个客户在西部某省会,团队规模一百来号人,业务涉及景区客流分析、视频汇聚、跨部门数据共享这些。他们内部文档散得到处都是——OA里一堆、共享盘里一堆、还有几个老同事的电脑里藏着“祖传”Excel。
老板的想法很直接:搞个AI助手,大家问它就行了,省得天天找人。
我们当时也挺兴奋,选了开源模型做本地部署,接了个RAG框架,把能扒的文档全灌进去了。演示的时候效果不错,问“景区客流预警阈值是多少”能答上来,问“跨部门数据共享的审批流程”也能给个大概。
然后,就没有然后了。
后台数据很诚实:上线第一周还有二三十个人试了试,第二周掉到十几个,第三周基本只剩我们自己在测。有个做运营的小姑娘跟我说了句大实话:“我搜关键词在共享盘里翻,都比问它快。”
这话扎心,但确实是问题所在。
原理:为什么问答不准、知识库滞后是致命的
企业AI助手这东西,底层逻辑不复杂。无非是文档切片、向量化、检索、拼上下文、丢给大模型生成答案。
但问题出在“检索”这一步。
我们当时用的切片策略是按固定长度切,512个token一块,重叠50。听起来挺标准对吧?可实际操作中,一份《跨部门数据共享管理办法》被切成了十几块,用户问“视频汇聚分析的数据共享要走什么审批”,检索出来的可能是“本办法自发布之日起施行”这种废话段落。
大模型再聪明,你给它喂的是垃圾,它也吐不出金子。
更麻烦的是知识库更新。客户那边政策文件一个月能出三四份新的,我们一开始是手动重新灌,后来发现根本跟不上。有个做审批的同事问了个新出的流程,AI答的是旧版,他直接截图发群里吐槽:“这玩意儿还不如不答。”
说白了,问答不准和知识库滞后,本质上是一个问题:检索增强生成(RAG)的“检索”环节没做好,后面的“生成”全是空中楼阁。
实操:我们后来怎么调的
1. 切片策略从“按长度”改成“按语义”
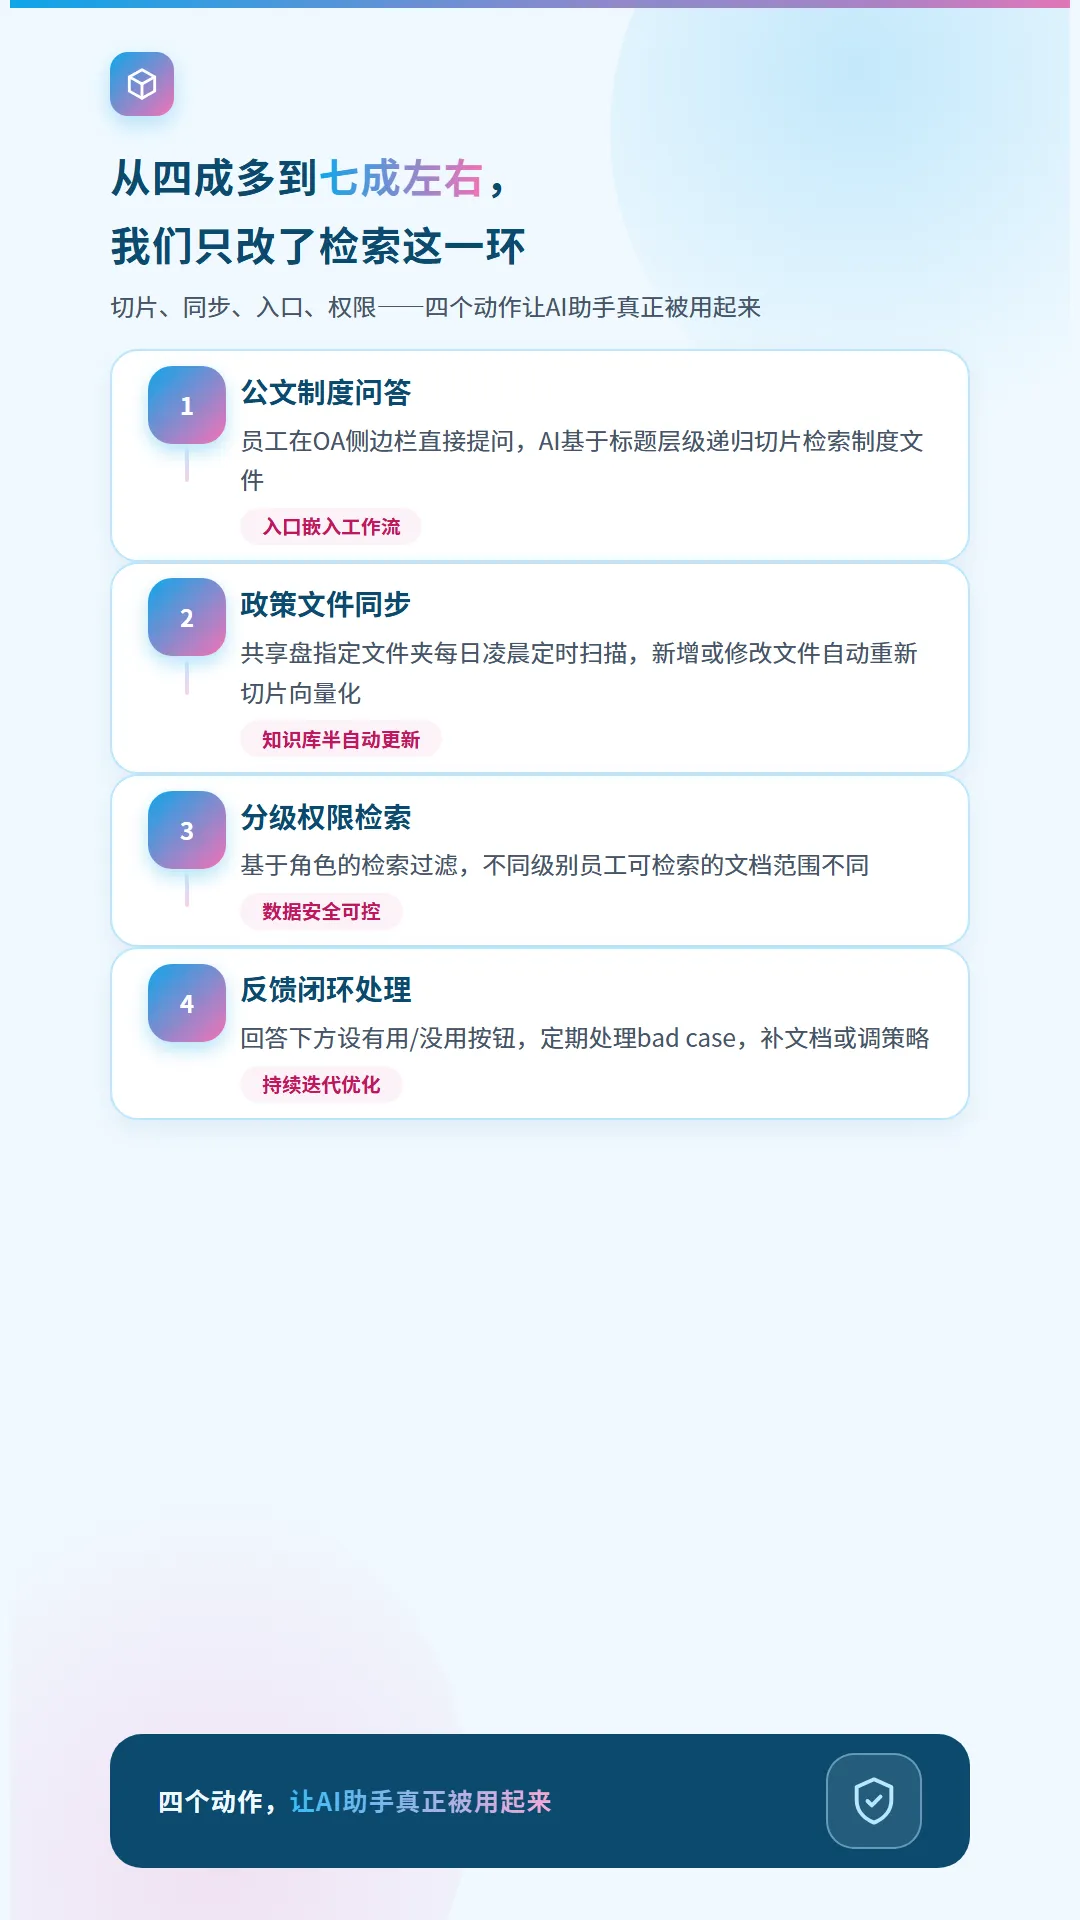
固定长度切片对公文、制度文件特别不友好。我们后来换成了基于标题层级的递归切片,遇到“一、”“(一)”“1.”这种结构就断开。
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 针对中文公文优化的分隔符
separators =[
"\n一、","\n二、","\n三、",
"\n(一)","\n(二)","\n(三)",
"\n1.","\n2.","\n3.",
"\n\n","\n","。",";"
]

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=400,
    chunk_overlap=80,
    separators=separators,
    length_function=len
)
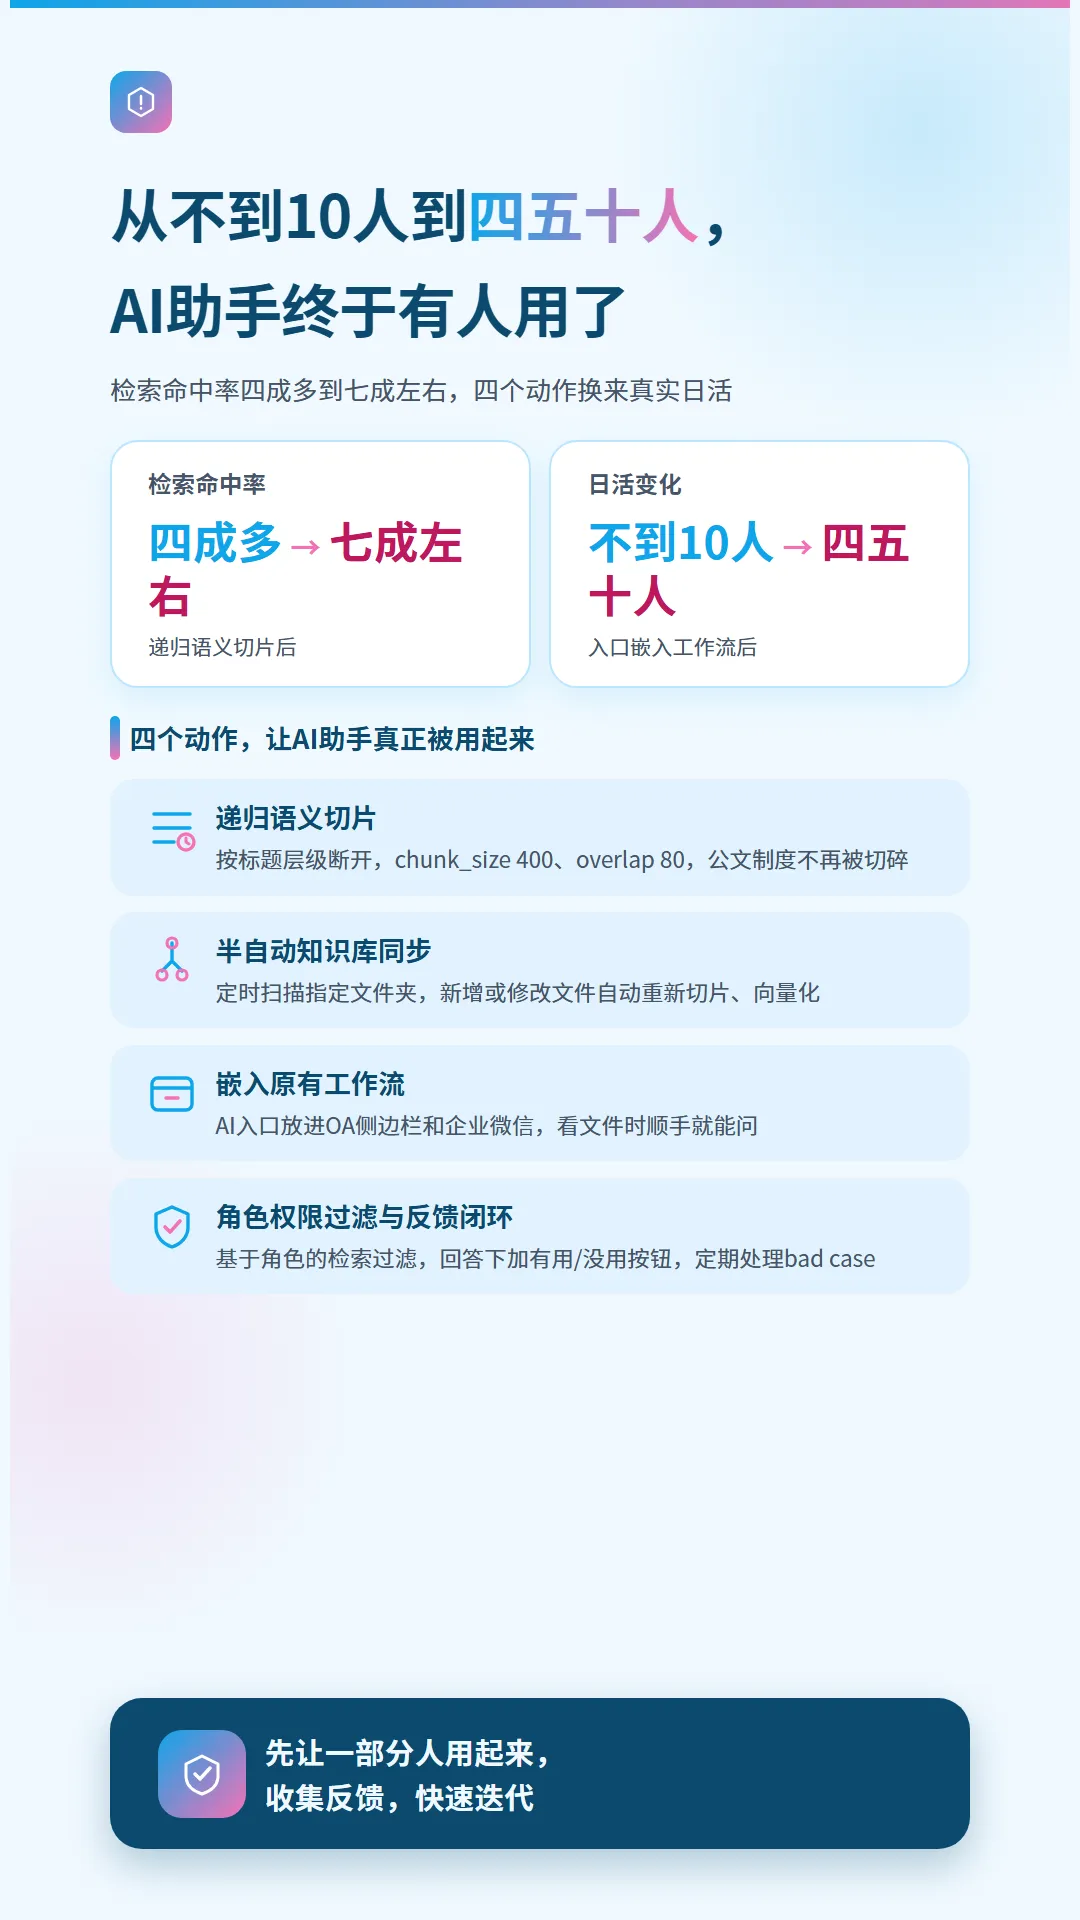
改完之后,检索命中率大概从原来的四成多提到了七成左右。不是完美,但至少能用了。
2. 知识库更新做成半自动
我们给客户搭了个简单的同步流程:共享盘里指定一个“AI知识库”文件夹,他们那边有人负责往里丢新文件,我们写了个定时任务,每天凌晨扫一遍,有新增或修改就重新切片、重新向量化。
import os
import hashlib
from datetime import datetime

defsync_knowledge_base(watch_dir, vector_store):
for root, _, files in os.walk(watch_dir):
for f in files:
if f.endswith(('.docx','.pdf','.txt')):
                filepath = os.path.join(root, f)
                mtime = os.path.getmtime(filepath)
                file_hash = hashlib.md5(open(filepath,'rb').read()).hexdigest()

# 对比上次同步记录,只处理新增或修改的文件
if need_update(filepath, file_hash):
                    docs = load_and_split(filepath)
                    vector_store.add_documents(docs)
                    update_sync_record(filepath, file_hash, mtime)
这个改动看着不起眼,但效果很明显。以前是“问啥啥不对”,现在是“偶尔有偏差,但大体靠谱”。
3. 把入口塞进他们本来就在用的地方
这是最关键的。
我们一开始做了个独立的Web页面,还配了个挺好看的登录页。结果呢?没人登。
后来我们把它嵌到了他们OA系统的侧边栏,又接进了企业微信。用户在OA里看文件的时候,右边直接有个“问AI”的按钮,点开就能问当前文档相关的问题。
使用率一下就上来了。
有个做审批的同事说:“以前要切出去开网页,现在顺手就问了。”
踩坑:那些我们没预料到的事
坑一:以为技术问题解决了,业务问题就解决了。
其实不是。我们花了很多时间调模型、调检索,但真正影响使用率的,是“员工觉得这东西跟我没关系”。有个做视频汇聚分析的同事,他的日常工作是看监控、写报告,AI助手对他最大的价值可能是“帮我写周报”,但我们当时没做这个功能。
坑二:权限没做细,有人不敢用。
政务单位对数据安全特别敏感。我们一开始没做细粒度的权限控制,导致一个普通员工问“某景区客流数据”,AI把管理层的分析报告片段给吐出来了。虽然没造成实际泄露,但这事传出去之后,好几个人就不敢用了。
后来我们加了基于角色的检索过滤,不同级别的人能检索到的文档范围不一样。
坑三:没有反馈闭环。
用户问了个问题,AI答错了,然后呢?没有然后。用户不会专门跑来告诉你“你答错了”,他只会默默关掉,下次不再用。
我们后来在回答下面加了两个按钮:“有用”和“没用”。点“没用”会弹个框让用户补充正确答案。攒了一批之后,我们定期把这些bad case拿出来,要么补文档,要么调检索策略。
坑四:期望值管理没做好。
演示的时候我们挑的都是能答对的问题,客户领导一看,觉得这东西无所不能。结果员工一用,发现问“帮我算一下这个月景区收入同比”它算不对,落差感就来了。
其实大模型本来就不擅长精确计算,这事我们在之前的文章里也聊过。但用户不管这些,他觉得你既然叫AI,就应该什么都会。
总结
企业AI助手用不起来,技术问题只是一部分。更多时候,是产品设计和业务融入的问题。
问答不准,那就把检索做扎实,别指望大模型自己悟。知识库滞后,那就把更新流程自动化,别靠人肉维护。脱离工作流,那就把入口塞到用户手边,别让他多一步操作。
还有一点挺重要的:别指望一开始就完美。先让一部分人用起来,收集反馈,快速迭代。我们那个客户后来日活稳定在四五十人左右,不算多,但至少有人在用了。
如果你也在搞类似的东西,欢迎在评论区聊聊你们踩过的坑。