ARTICLE · 1106077
觉得AI Agent都差不多?错!大错特错!
觉得AI Agent都差不多?大错特错!
如果把同一句话——“帮我把这个项目改好”——分别丢给五个都叫 Agent 的产品,你会得到五种完全不同的东西。
豆包可能先给你一份改造方案。
Codex 会进入代码仓库,阅读文件、修改代码、运行测试。
Claude Code 更像一个坐在终端里的搭档,边看仓库边执行命令。
ZCode 会把规划、编码、评审和上线放进一条工作流。
DeepSeek Harness 却可能先让你选择模型、工具、插件和权限。这里的 Harness,可以先理解成让模型真正跑起来的“运行骨架”。
差异看起来是“谁更聪明”,实际很多时候是架构不同。
一、先把模型和 Agent 拆开
大多数人比较 AI 产品时,看的都是模型:
GPT、Claude、Gemini、GLM、DeepSeek、豆包大模型,谁推理更强,谁写代码更准。
但今天被称为 Agent 的产品,通常不只包含一个模型。
一个完整 Agent,至少由六部分组成:
基础模型、Agent Harness、工具系统、运行时环境、权限系统、产品界面。
Harness 原本指马具、挽具。放进 Agent 语境,它指模型之外的一整套运行骨架:如何组织上下文、调用工具、观察结果、判断下一步、处理报错、申请权限,以及何时停止。
没有 Harness,模型更像一个能回答问题的 API;有了 Harness,模型才会形成“计划—执行—观察—修正”的循环。
模型负责理解和生成。
Harness 负责把模型接进一个能持续工作的循环。
工具系统负责读写文件、搜索网页、执行命令、操作软件。
运行时决定它在哪里工作,以及能工作多久。
权限系统决定哪些动作需要人确认。
产品界面决定你是在聊天框、终端、IDE 还是云平台里使用它。
可以把它想成一辆车。
模型是发动机,Harness 是底盘、传动、刹车和方向盘,工具是车轮,运行时是道路,权限系统是交通规则。
发动机很强,不代表这辆车就能把人安全送到目的地。
所以,Codex 不等于 GPT,Claude Code 不等于 Claude 模型,ZCode 也不等于 GLM。
它们都是“模型 + Harness + 工具 + 运行时 + 权限 + 界面”的组合产品。
而 DeepSeek Harness 选择了一条更靠近底层的路:不只卖车,也把底盘和装配方式开放出来。
我认为,今天大多数 Agent 的差距,不在模型那一个零件,而在整套系统如何协同。
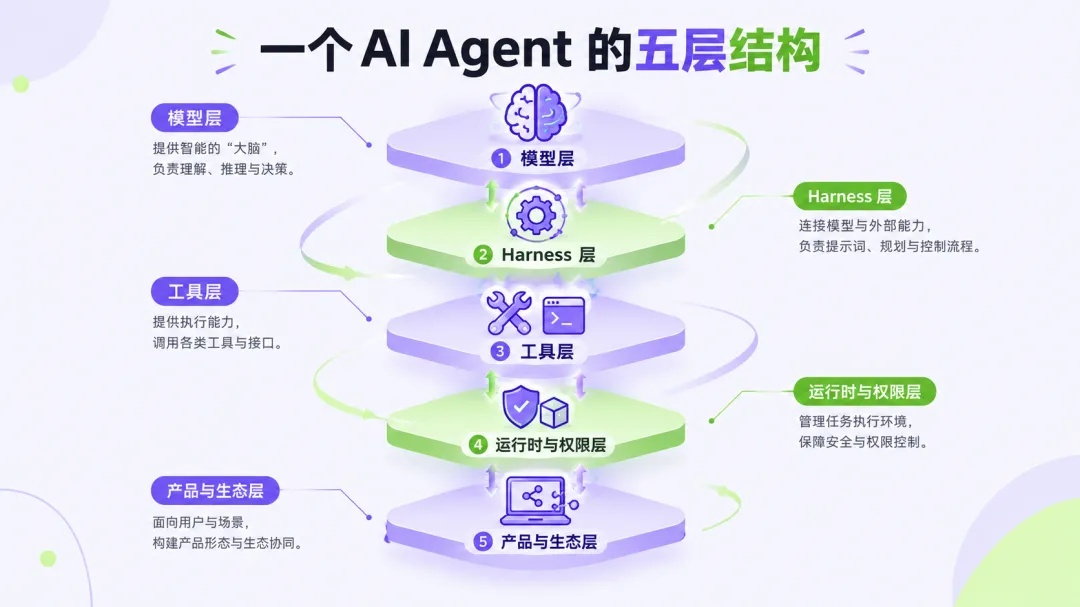
二、看一个 Agent,先拆成五层
要比较 Agent,先别问“谁最强”,先看它在哪一层解决问题。
第一层:模型层
这一层决定理解、推理、生成和代码能力。
同一个 Harness 接不同模型,任务效果可能明显不同。
第二层:Harness 层
Harness 决定 Agent 如何拆任务、保存上下文、调用工具、检查结果和处理失败。
它还会决定是否支持子 Agent、并行任务、长期记忆、自动重试和人工接管。
很多产品最核心的竞争力,其实在这里。
第三层:工具层
只会聊天,不算完整的工作能力。
能读文件、改代码、跑测试、查数据库、发消息、操作浏览器,才算进入执行层。
今天常见的连接标准是 MCP,它让不同工具可以接入不同 Agent。
第四层:运行时与权限层
任务在云沙箱、本地电脑,还是公司内网运行,风险完全不同。
能不能读敏感文件,能不能执行命令,能不能联网,是否需要逐步确认,也完全决定产品边界。
第五层:产品与生态层
同一种能力,放进聊天框、命令行、IDE、桌面端和企业平台,使用体验会相差很大。
生态还决定它能连接哪些模型、工具、账号和业务流程。
一句话总结:模型决定“会不会想”,Harness 和运行时决定“能不能做完”。
三、按架构,常见 Agent 分成五类
这不是永久分类。
产品会进化,边界会互相渗透。
这里按它们当前最核心的架构重心来划分。
我更愿意用架构重心分类,因为功能会重叠,但架构重心更能解释能力边界。
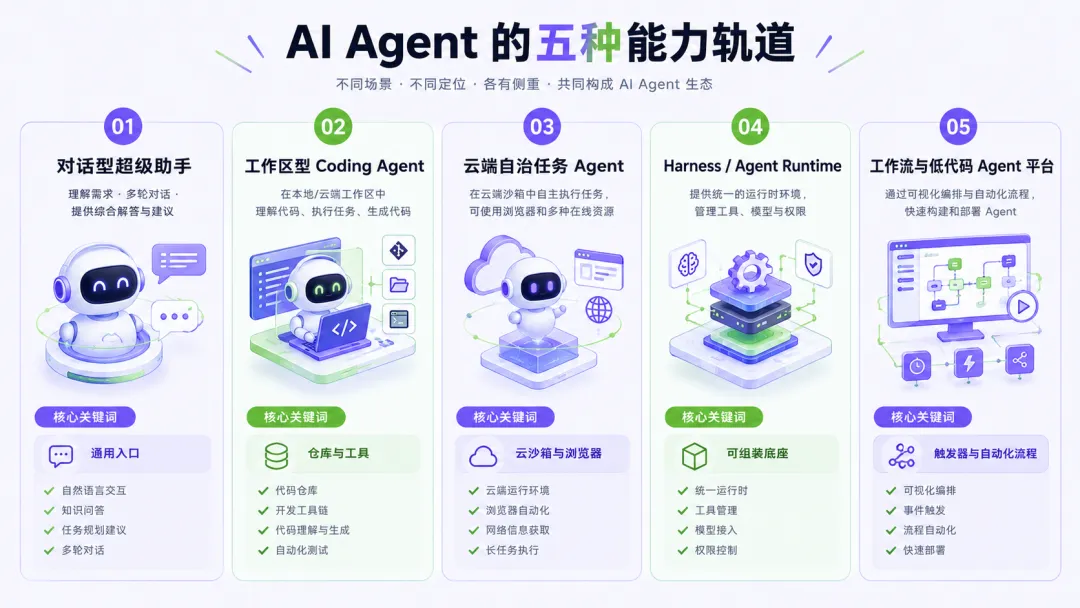
1. 对话型超级助手
代表产品:豆包、ChatGPT、DeepSeek App、Kimi 等。
这类 Agent 的入口通常是聊天框。
优势是门槛低、覆盖广,写作、搜索、总结、图片、视频、办公文件都能碰。
它们追求的是“一个入口解决很多日常问题”。
局限也很明显:任务一长,跨软件步骤一多,上下文、权限和验证就容易断。
豆包更像消费级多模态工作台,强项是内容生产、搜索问答和办公辅助。
它正在从“回答问题的助手”走向“能拆任务、能联动工具的干活搭子”。
但它的产品重心,仍然首先是通用入口,不是深度的代码仓库工作流。
2. 工作区型 Coding Agent
代表产品:Codex、Claude Code、ZCode、Cursor Agent、Gemini CLI 等。
这类 Agent 的关键,不是聊天,而是进入一个真实工作区。
它能读取项目、修改文件、执行命令、查看报错、运行测试,再根据结果继续修改。
它们之间也有明显差异。
Codex 更强调把本地终端、IDE 和云端任务放进同一套编码代理体系。
Claude Code 最早以终端和代码仓库为中心建立心智,适合围绕项目持续对话和执行。
ZCode 是智谱围绕 GLM 推出的官方 Harness,覆盖桌面、终端和开发工作流。
Cursor 的根在 IDE,优势是编辑器上下文、代码补全和人机协作。
Gemini CLI 则把终端 Agent 与 Google 生态连接起来。
这里最容易出现的误区,是拿模型跑分直接替代产品比较。
同一个模型,接进不同 Harness,记忆策略、工具调用、权限设计和失败恢复都不一样。
最终体验可能比换一个模型更大。
3. 云端自治任务 Agent
代表产品:ChatGPT Agent、Manus 等。
这类 Agent 通常会获得浏览器、云虚拟机或远程桌面。
你交给它一个目标,它在后台自己搜索、打开网页、整理资料、生成文件,最后交付结果。
它们适合跨网站、跨应用、耗时长、步骤不固定的任务。
问题是账号权限、支付动作、敏感数据和执行透明度,都需要更严格的设计。
所以,云端自治 Agent 的核心竞争力,不只是模型能不能想出来,而是运行时安不安全、过程可不可控。
4. Harness / Agent Runtime
代表产品:DeepSeek Harness、LangGraph、OpenAI Agents SDK、Claude Agent SDK 等。
这类产品的用户,很多时候不是普通消费者,而是开发者。
它们不承诺“打开就能替你干完某件事”,而是提供组装 Agent 的零件。
DeepSeek Harness 的官方定位就是开源 Agent Harness。
它强调插件化组合,可以接入不同模型,并把文件、终端、沙箱和任务流程装配起来。
它还能处理文档、表格、代码和定时任务,但重点仍是提供运行底座。
你可以把它理解成一套可组装的底盘,而不是一辆出厂即用的完整汽车。
LangGraph 更偏编排和状态管理,Agents SDK 更偏开发者接口,侧重点并不完全相同。
这类产品比较时,不能只看演示效果,还要看插件生态、可观测性、权限模型和维护成本。
5. 工作流与低代码 Agent 平台
代表产品:Coze、Dify、n8n、Zapier Agents,以及飞书、钉钉等企业平台中的智能体。
这类 Agent 的核心是触发器、节点、知识库和系统集成。
比如收到表格新增行,先判断内容,再查数据库,最后通知负责人。
它的优势是流程清楚、权限可控、结果稳定,适合重复性业务。
局限是面对完全开放的问题时,灵活度不如通用 Agent。
所以,它更像“会调用模型的自动化流水线”,而不是一个自由发挥的数字员工。
如果用一句话区分:
四、最容易混淆的三组对比
第一组:豆包 vs Codex
表面看,两者都能写代码。
实际架构重心完全不同。
豆包首先是面向大众的通用助手,代码只是它的能力之一。
Codex 则围绕工作区、终端、代码变更和验证闭环来设计。
一个更像全能前台,一个更像驻场工程师。
这不代表谁绝对更强,而是任务是否落在它们的架构中心。
第二组:DeepSeek Harness vs Codex、Claude Code、ZCode
这组最容易被误比。
DeepSeek Harness 更接近运行时和装配框架。
Codex、Claude Code、ZCode 更接近已经组装好的产品。
前者给你控制权,也把集成成本交给你。
后者替你做好大量默认选择,但灵活度和数据边界受产品设计影响。
如果你要快速干活,成品 Agent 更直接。
如果你要把 Agent 嵌入自己的系统,Harness 和 SDK 更值得研究。
第三组:ZCode vs Claude Code vs Codex
这组不能只比底层模型。
ZCode 是 GLM 官方 Harness,和模型、账号及智谱生态协同更紧密。
Claude Code 的强项是围绕代码仓库的终端式工作流,以及 Anthropic 的工具生态。
Codex 则把 OpenAI 模型、编码代理、云端任务和开发工具连接起来。
真正要比较的是四件事:
你的代码在哪里,你的数据能不能出域,你的团队用什么工具链,你需要多深的自动化。
只要这四件事没想清楚,模型跑分再高,也很难直接得出正确选型。
五、判断一个 Agent,问这四个问题
第一个问题:它的上下文在哪里?
只在聊天记录里,还是能持续读取一个项目、一个知识库、一个浏览器会话?
第二个问题:它能做什么,而不只是说什么?
能给出建议,还是能修改文件、调用系统、执行动作?
第三个问题:出了错,它怎么收场?
有没有权限确认、沙箱、日志、回滚、人工接管和结果验证?
第四个问题:它是产品,还是零件?
你买的是开箱即用的能力,还是需要自己搭建的底座?
我的判断是:如果上下文、执行、收场和产品化四项里缺两项,它更像聊天机器人,而不是可托付任务的 Agent。
这四个问题,比“哪个 Agent 最强”有用得多。
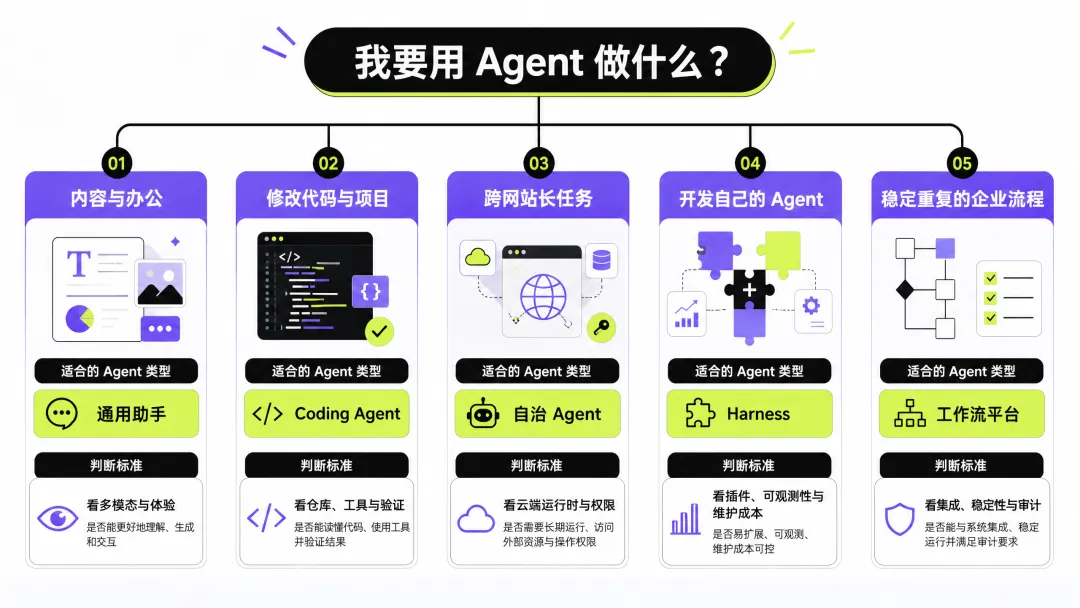
六、怎么选,不必站队
做内容、搜索、总结、图片和日常办公,优先选对话型超级助手。
要改代码、跑测试、处理仓库,优先选工作区型 Coding Agent。
要跨网站执行长任务,考虑云端自治任务 Agent。
要把 Agent 嵌进自己的产品,研究 Harness、SDK 和编排框架。
要做稳定重复的企业流程,选工作流和低代码平台。
同一类里再比较模型、价格、权限、隐私、生态和稳定性。
这里还要承认一个边界:
五类架构只是观察工具,不是产品身份证。
豆包会继续增强执行能力,Codex 也会处理更多非代码任务,Harness 也可能长出完整产品界面。
边界会越来越模糊。
但底层判断不会失效:模型、Harness、工具、运行时和权限,仍然决定一个 Agent 能走多远。
结语
AI Agent 之间的差异,不只是“谁更聪明”。
更关键的是,谁拥有合适的上下文,谁能调用正确的工具,谁能在权限边界内持续执行,谁能在失败后继续修正。
我最后给一个判断:模型是大脑,Agent 是把大脑接进真实世界的整套系统。
下一次看到两个产品都自称 Agent,不要先问它们用了什么模型。
先问它们把模型放进了怎样的架构。
这,才是“都差不多”这句话真正错得最厉害的地方。