ARTICLE · 1111994
使用门槛最低的AI绘图工具 Qwen-Image 2.1
连 ComfyUI 的节点都拖不明白?我给 Qwen-Image 2.1 焊了个双击就能用的壳
大家好,我是你们的老朋友,一个画图五分钟、配环境两小时的画图狗。
想用 Qwen-Image 2.1 出张图,正规流程是这样的:装 Python、装 CUDA 版 torch、clone diffusers、下十几个 G 的权重……好不容易跑起来了,还得面对一屏节点连线。
「这个 LoRA 该接在哪个节点上?」「VAE 呢?」「为什么我出的图是全黑的?」
那一刻我只有一个想法:我是来画图的,不是来当运维的。
于是我给 Qwen-Image 2.1 焊了个壳 —— 一个双击就能跑的 Windows 程序,不用装 ComfyUI,不用连线,整个目录拷到别的电脑上照样能用。
先说清楚:Qwen-Image 2.1 到底强在哪
这是阿里 Qwen 团队 2026 年 9 月放出来的图像模型。跟 FLUX、SDXL 那些比,有三个地方是真的不一样:
① 它原生懂中文。文本编码器用的是 Qwen3VL,中文是它的母语。你用 FLUX 写中文提示词,得先翻成英文才出得来东西;Qwen 这边直接写中文就行,翻译反而会丢细节。
② 一个模型同时干两件事:文生图 + 图片编辑。不是两个模型、两套权重 —— 就是同一个 pipeline,给不给参考图就是两个模式。这也是它能「改图」的原因。
③ 输出是 RGBA,原生支持 2K。扩散主干 32 层,512 维的 RoPE 按 (16, 56, 56) 切分处理坐标,所以宽高能做得比较自由 —— 但有个硬性约束,后面会讲。
说人话就是:中文用户用它,比用 FLUX 少一道翻译的损耗。
整个主界面就这么点东西
左边参数、右上预览、右下日志。没有节点、没有连线、没有 workspace 要你摆。
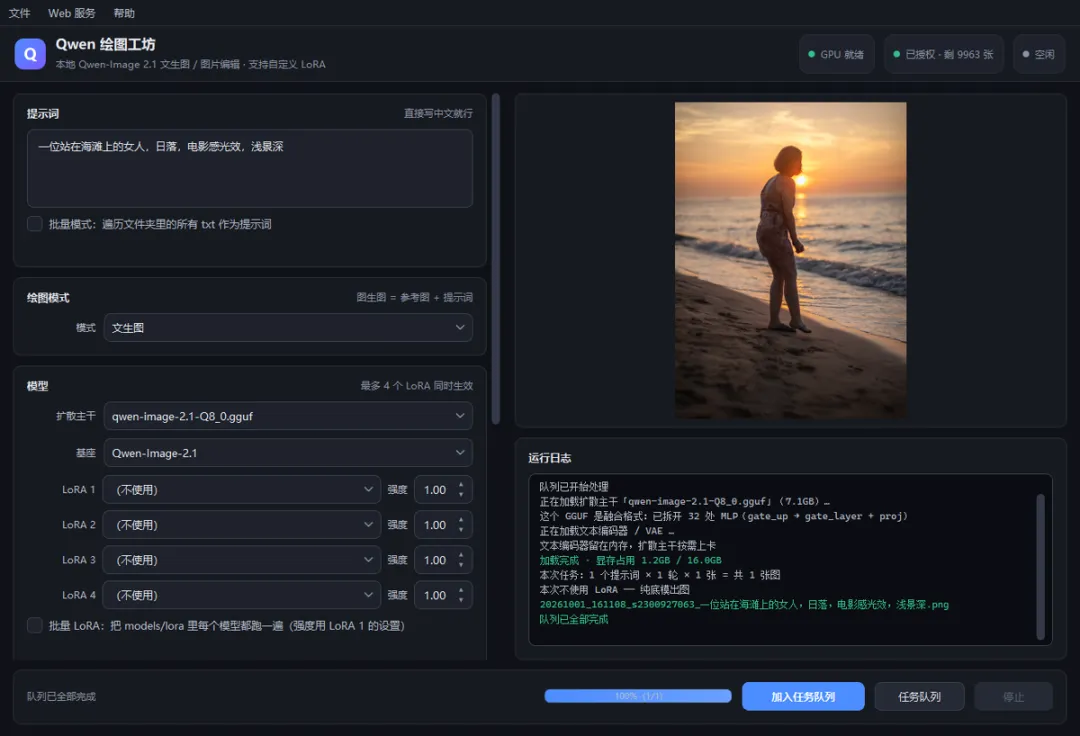
跑完一张之后的样子:右边预览、下面日志、进度条都在
模型路径一个都不用填。程序启动时自己扫 models 目录,扫到什么就进下拉框。
尺寸有个小坑要提前说:宽高必须是 32 的倍数(VAE 下采样 16 倍,再叠一个 2 倍打包)。你填 720 它会给你改成 704 —— 下拉框... 不,输入框旁边就是提示,改完直接显示对齐后的值。
中文提示词,直接写,不用翻译
上面那张截图里的提示词是这么写的:
一位站在海滩上的女人,日落,电影感光效,浅景深
就这一句,没有翻译这一步。FLUX 那套「先翻英文」的理由,在 Qwen 上不成立。
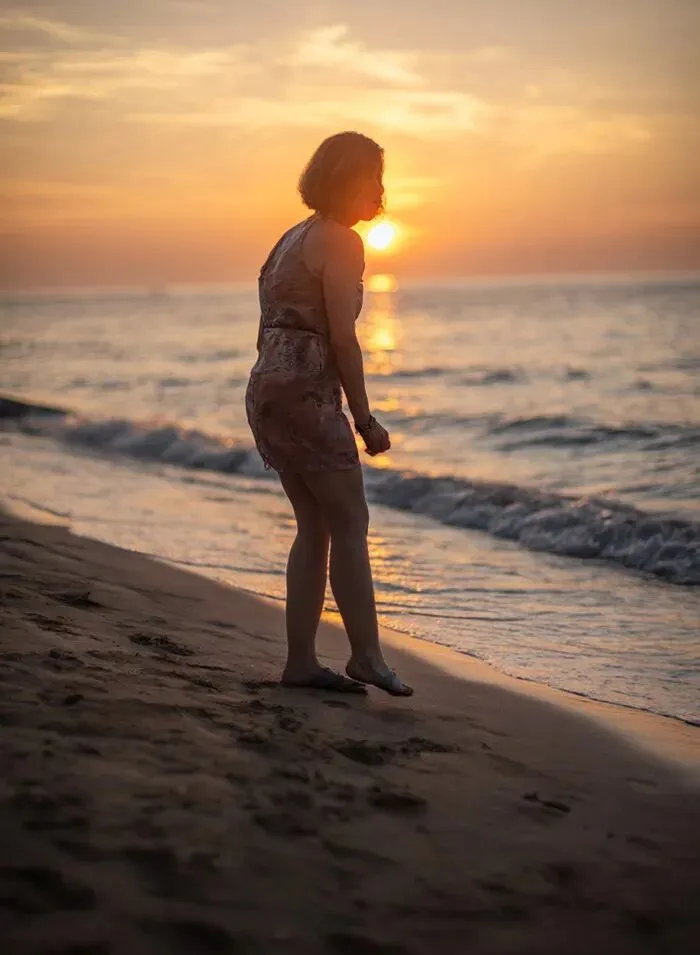
704×960 · 25 步 · 约 40 秒
再换个题材,看看它对细节和质感的把握:
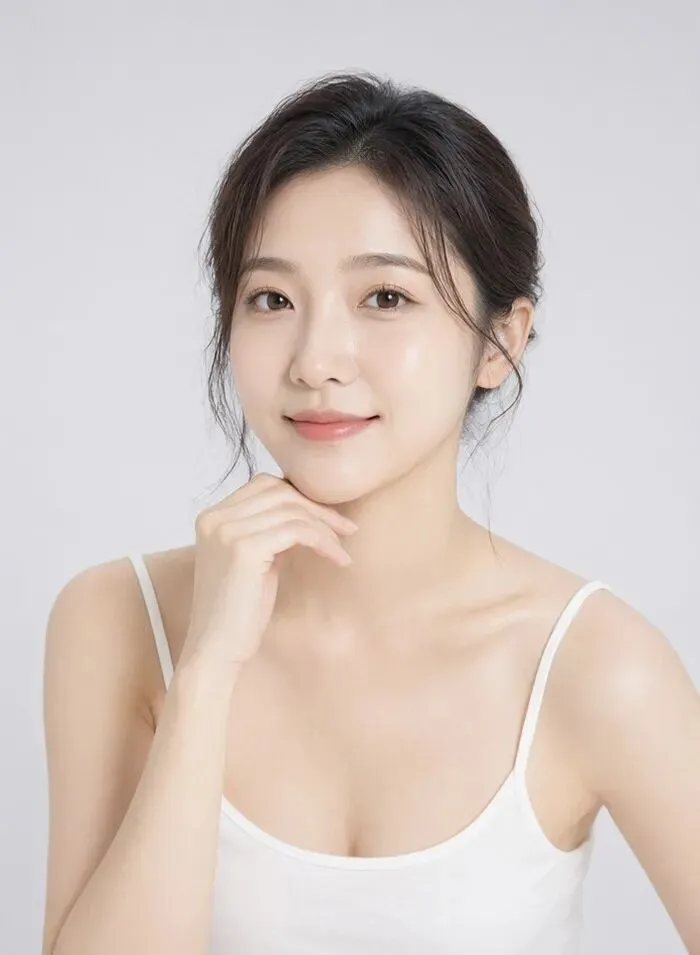
704×960 · 25 步 · 纯底模,没挂任何 LoRA
不过最能说明「原生中文」这四个字的,是下面这张。
提示词只有一句:
一家深夜营业的小面馆门口,木质招牌上写着「深夜食堂」四个中文字,暖黄色灯光,电影感
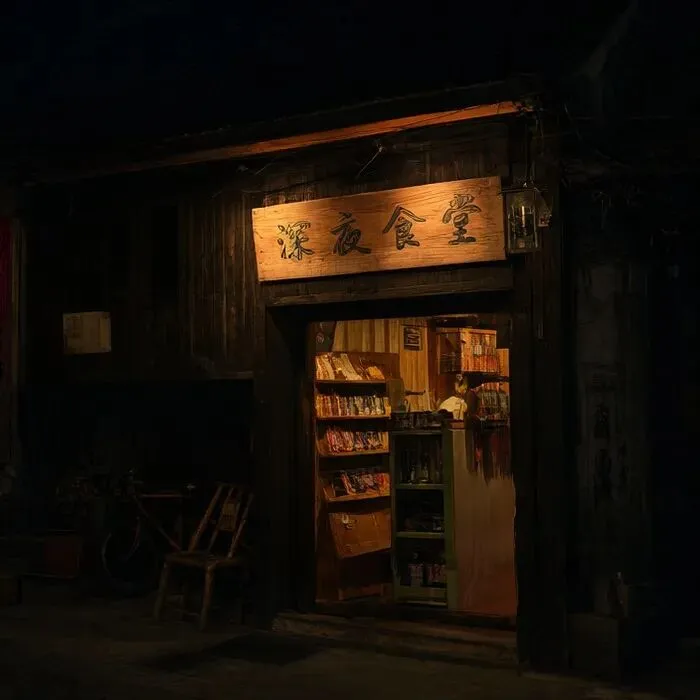
704×704 · 25 步 —— 招牌上的四个字,一笔不差
在图上画中文字,一直是扩散模型的老大难 —— 你让 SDXL 或者 FLUX 写四个中文,出来基本是鬼画符。Qwen-Image 这边是照着你的提示词把字写对。
做海报、封面、电商图的,应该知道这个差别有多大。
LoRA:最多挂 4 个,换一个不要一秒
这是很多人最关心的。最多同时挂 4 路 LoRA,每路一个强度。
LoRA 不合并进底模。底模是 GGUF 量化的,合并就得重新量化;而且换一个 LoRA 要重载 7GB 的权重。所以走的是旁路加算 —— 调强度、换 LoRA 都是瞬时生效,不会重新加载主干。
还有两个用起来顺手的地方:
· 新拷进来的 LoRA 不用重启程序。下拉框展开的瞬间会重新扫一遍 models\lora,刚拷进去的文件立刻能选,当前选中的那一路也不会丢 —— 队列正跑着的时候也能给下一条任务挂上新 LoRA。· 挂上去会告诉你命中多少层。日志里写「命中 224/224 层」这种。要是一层都对不上,它会直接跳过并告警 —— 那说明这不是 Qwen 的 LoRA。
另外还有「批量 LoRA」:勾上之后,models\lora 里每个模型都按当前设置完整跑一遍,出图文件名会自动带上 LoRA 名字,几十张混在一起也分得清。
队列:排好队,然后去干别的
调好一套参数,点「加入任务队列」——存的是快照,你可以接着改参数准备下一条,排队里的任务不会跟着变。
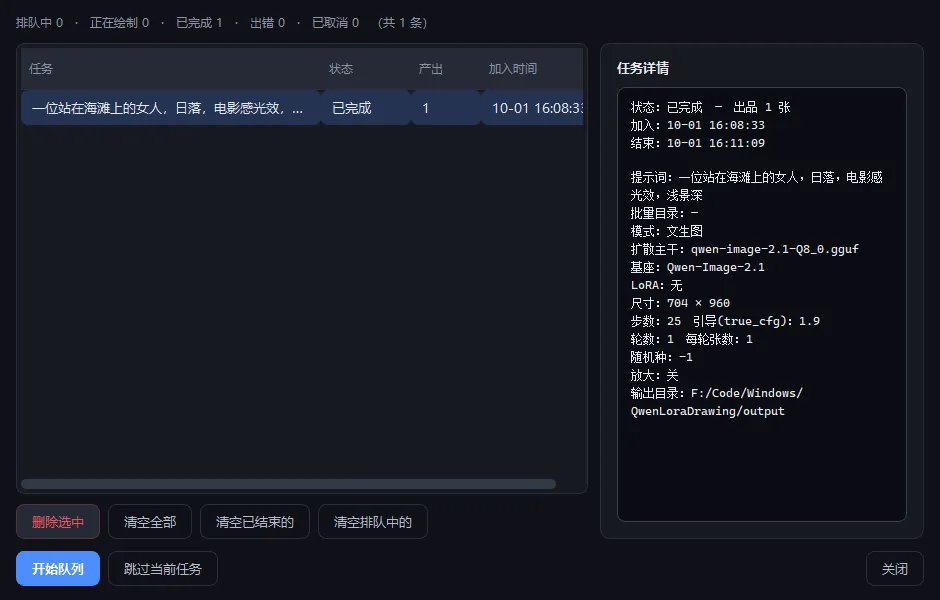
队列管理:每条任务的状态、产出、加入时间,右边是完整参数
队列跑起来之后你可以:· 删除某一条(正在画的那条要先「跳过当前任务」)· 清空全部 / 只清已结束的 / 只清排队中的· 停止队列(当前这张画完就收工)· 勾上「批量模式」,把一整个文件夹的 txt 当提示词一条条跑
有个设计要特意说一下:队列不跨程序运行保留。关掉程序就把任务全清掉,下次打开是空的。
为什么这么做?因为我自己被坑过:上一次排了一批带 LoRA 的任务,这次改成不带 LoRA 再提交,结果队列里上一批旧任务先跑,看到的图还是带 LoRA 的,白排查半天。队列本来就是「这次想画的东西」,跨会话留着只会让人拿到意料之外的结果。
顺带一提,每条任务开跑时日志里会明确写一行 本次使用 LoRA:xxx 或 本次不使用 LoRA —— 纯底模出图,随时能核对。
图生图:给一张图,改一个地方
前面说过 Qwen-Image 2.1 是同一个模型干两件事。切到「图生图 / 图片编辑」,拖几张参考图进去(最多 10 张),剩下的就是写你要改什么。
左边这张是原图,提示词只写了「把天空改成繁星点点的夜空,加一轮满月」:
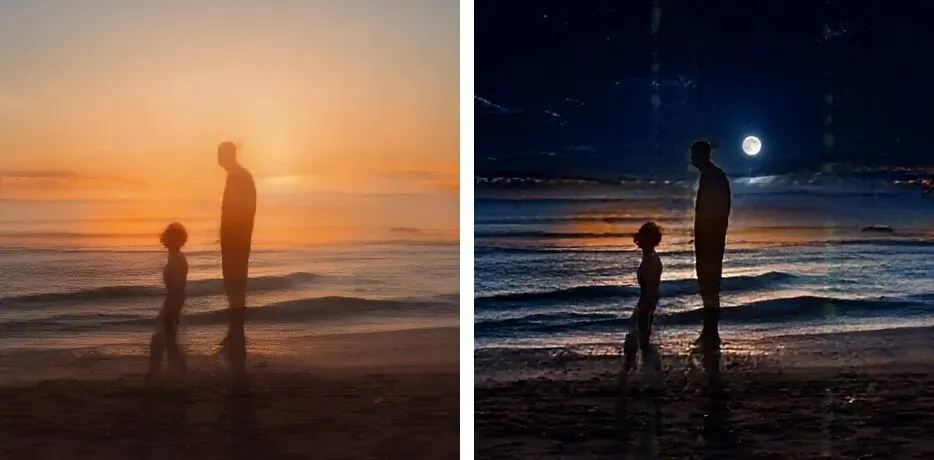
左:原图 右:改完之后 —— 人物和构图原样保留,只动了天空
这里有个参数叫「参考图精度」,512 / 768 / 1024 / 1536 四档。它决定参考图送进视觉编码器的分辨率 —— 而图生图的时间几乎全花在编码这些 token 上,调小一档,时间大致按面积缩小。想快就调到 512。
还有个「跟随参考图比例」,勾上之后按第一张参考图的宽高比算输出尺寸,不用自己算。
每张图旁边,都躺着一份 txt
这是我觉得最实用的一个功能,也是 ComfyUI 最不方便的地方 —— 出图当天记得参数,过一礼拜回头看一张满意的图,想复现,全靠回忆。
这里每张图旁边会生成一个同名的 .txt,把这张图是怎么来的全写下来:
提示词 实际用的那句(有负面提示词也会记)模型 扩散主干 GGUF、基座目录参考图 图生图用了哪几张、参考图精度多少LoRA 每一路的文件名和强度采样参数 分辨率、步数、引导、KV 缓存、随机种时间 任务加入、开始绘制、出图完成、本张耗时
末尾还有一行紧凑 JSON(键名是英文),方便你自己写脚本批量统计,以后也能做「从图片导入参数」。
采样分辨率和最终尺寸是分开记的。开了放大之后图片是 4 倍大,但采样是在小尺寸上做的。要复现得照着「采样分辨率」填,照着图片尺寸填就错了。
放大:内置,不用另开一个软件
生成完可以直接接放大,用 spandrel 加载 ESRGAN 那一系模型(4x-UltraSharp.pth 之类)。
放大一律分块处理:904×1600 放大 4 倍是 3616×6400,整张塞进显存不现实,所以按 512 的块带 32 重叠跑,边缘做羽化混合。
手机也能用:内置 Web 服务
菜单里点一下「启动 Web 服务」,浏览器打开就是一套完整的远程控制台 —— 改参数、传参考图、提交任务、看实时进度和预览、下载成品,全都能干。
菜单里就一个开关,没在跑的时候显示「启动 Web 服务」,跑起来就变成「停止 Web 服务」,不用自己去分辨当前是什么状态。
默认不需要登录 —— 只在自己机器上用(127.0.0.1)没必要多一道。要放局域网或者用 nginx 反代出去,就在设置里打开「打开网页需要登录」,口令自己改。改了开关不用重启服务,下一次请求就按新设置走。
硬件需求(敲黑板)
必须是 N 卡。跑的是 diffusers + CUDA,A 卡和核显就别看了。
显卡 NVIDIA,16GB 显存起步(我这台是 RTX 4070 Ti SUPER)内存32GB 建议,24GB 是底线 —— 这条比显存更要命,下面解释硬盘 装完程序 + 模型约 40GB(模型占 25GB)系统 Windows 10 / 11 64 位
为什么说内存比显存更要命?因为这个模型的文本编码器是 16.4GB 的 bf16 —— 比 16GB 的显卡还大,永远塞不进显存。
所以默认策略是:文本编码器常驻内存,只让 7GB 的扩散主干按需上卡。编码那一步在 CPU 上跑(本来也只是一次性 prefill,在内存里跑反而快),显存整个留给主干和 VAE。
别把文本编码器往显卡上搬。塞不下的时候 Windows 会把显存换页到内存,表现是 GPU 利用率显示 100%、功耗只有 70W(满载 285W),一次编码从约 10 秒拖成好几分钟。程序默认就避开了这个坑。
实测速度(RTX 4070 Ti SUPER 16GB + 32GB 内存):
首次加载模型 约 80 - 125 秒默认尺寸 704×960 / 25 步 约 40 秒1024×1024 / 40 步 约 60 秒图生图(参考图精度 512) 约 76 秒
采样时间不是「像素 × 步数」的简单正比 —— 第一步要额外花约 12 秒预热(把主干权重搬上显卡)。所以步数越少,那 12 秒摊到每一步就越明显。
装完第一件事:把 models 目录加进杀毒软件排除项。Windows Defender 会实时扫描每一个被读取的文件。它扫这 25GB 模型会让首次加载从一两分钟变成十几分钟,而且时间完全不可预测。
最后说点大实话
1. 只支持 Qwen-Image 2.1。不是通用绘图工具,别的模型塞不进去。2. 宽高必须是 32 的倍数。你填 720 会被改成 704,界面会直接显示改完的值。3. LoRA 只作用于扩散主干。这是 diffusers 的 Qwen 加载器本来就有的限制,而且 DiffSynth 训练器默认也只训 DiT,日常用不到文本编码器那一路。4. 队列不跨会话保留。关掉程序队列就清空了,见上面的解释。5. 中文提示词建议直接写中文。如果你习惯写英文也没问题,但别指望它比中文好多少 —— 这个模型的文本编码器本来就是中文母语的。
整个目录拷到别的电脑上(哪怕对方从没装过 Python),双击 exe 就能跑。模型单独拷进 models 就行。
有想试的、或者用着哪里别扭的,微信找我:
微信 704292306
链接:https://pan.quark.cn/s/9b51f5b9693e?pwd=h3YZ
提取码:h3YZ
百度网盘:
链接:https://pan.baidu.com/s/1wRulzMU3stsuR_STSzOjig?pwd=k6pb
提取码: k6pb