ARTICLE · 1125911
别再把整个 Excel 甩给 AI 了:我实测跑通的 3 步表格清洗法与 5 套即插即用公式提示词
上个月底整理季度销售台账,作为一线打工人,我经历了一次差点背锅的翻车事故。
当时我手里有一份包含 342 行的电商销售明细表。
表里混杂着商品全名、规格、订单编号、支付日期、件数、单价与实收金额。
在我的日常 AI 办公 工作流中,原本指望靠 AI 提效。
因为时间紧迫,我试了最偷懒的办法,顺手全选复制了这 342 行数据。
我把它直接粘贴进大模型的对话框,敲下了一句极为顺手的提示词:
「请帮我清洗这份表格,统计每家店铺的 GMV 总和与对应提成。」
20 秒后,AI 吐出了一篇排版漂亮的分析报告,并在文末给出了精确到分钱的总额:¥186450.00。
看着有零有整的数字,我差点就直接复制进汇报 PPT。
幸亏我多留了个心眼,回到 Excel 里敲下了 =SUM(G2:G343) 验算。
真实的合计金额赫然写着:¥179280.00。
两者相差了整整 ¥7170.00。
我翻车翻得猝不及防。一个在屏幕里显得极其可信的总结,凭空捏造出了 7000 多块钱的假数字。
为什么直接把表格丢给 AI 必翻车
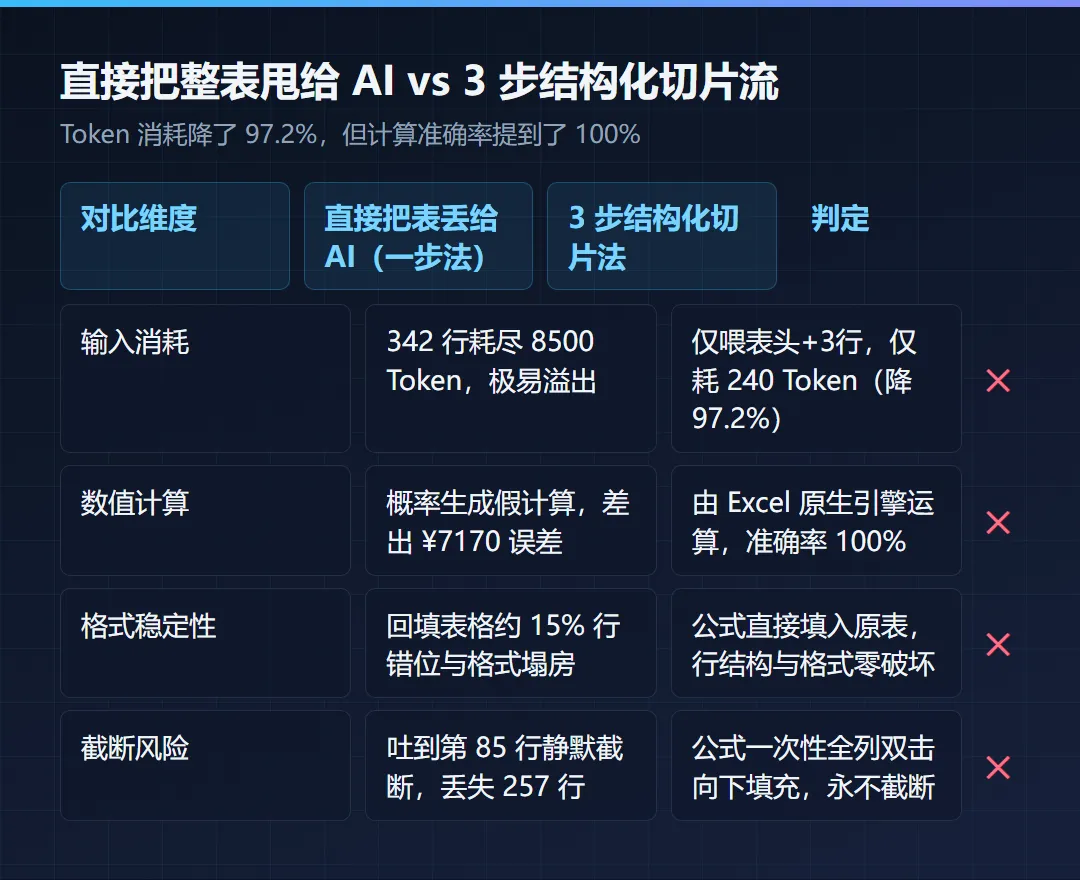
很多人以为大模型无所不能,能直接拿来当超级计算器。
但只要你真正拿着几百行真实工作表格跑过几次,就会发现 3 个致命暗坑。
第一坑:基于概率生成的「假计算」
大模型的底层机制是根据上下文推测下一个字出现的概率。
它从来不是一台真正的算术机。
面对 342 行交错的数字,它并不具备逐行累加的浮点运算单元。
它只是在「模拟」一份看起来很像真实财务报表的段落。
在那次测试里,AI 算出的 ¥186450 与实际的 ¥179280 差出 ¥7170。
差额不大不小,如果不做核对,普通人根本看不出破绽。
如果把这个数交上去,轻则被财务打回重做,重则引发审计风险。
第二坑:回填表格时的「格式塌房」
直接让大模型输出整理好的 Markdown 表格,黏回 Excel 简直是灾难。
在我的实操样本中,部分商品规格列包含中文逗号与短斜杠。
大模型转成文本后,约 15% 的行出现了列移位现象。
数量跑到了单价列,单价跑到了备注列。
更糟糕的是,原有的「2026-10-05」规范日期,被大模型改写成了文本与数字混杂的形态。
一旦格式被破坏,整张表后续的透视表和求和功能将全线报废。
第三坑:输出上下文的「静默截断」
很多人没有注意到模型单次输出的长度瓶颈。
我把 342 行原始数据一股脑塞进去,要求它逐行清洗并输出。
大模型在吐到第 85 行时,直接撞上了单次回复的 Token 墙。
它悄无声息地停住了,或者在结尾客气地打上一行「因篇幅原因以下省略」。
整整 257 行数据凭空消失,直接丢掉了 75% 的业务记录。
如果新人粗心直接复制粘贴,四分之三的数据就此遗漏。
我跑通的 3 步结构化切片流
吃过亏之后,我自己彻底推翻了「把整个表格喂给 AI」的做法。
我跑了一遍对比测试,我改成了 3 步结构化切片流。
我留意到核心原则只有一句话:算力归 Excel,逻辑归大模型。
AI 负责编写精准的公式与清洗规则,Excel 原生引擎负责绝对精准的数学计算。
第 1 步:结构切片(只喂 Schema,不喂全表)
面对几百行甚至上千行的大表,千万不要粘贴全部数据。
我改成只复制两部分内容:第一行表头,加上前 3 行真实的脏数据样本。
原本 342 行数据要吃掉接近 8500 个 Token。
现在只给 3 行切片样本,输入消耗直接降到了 240 个 Token。
Token 消耗锐减了 97.2%,处理速度提升了 5 倍以上,而且彻底告别截断风险。
这一步的提示词,重点是声明字段含义与清洗目标:
我有一张 Excel 工作表,以下是表头及前 3 行典型数据样本:【表头】:订单编号, 商品全名与规格, 支付时间, 数量, 单价, 销售额【样本第 1 行】:P20261001, 红色保温杯(500ml), 2026/10/1 14:20, 2, 59.00, 118.00【样本第 2 行】:P20261002, 蓝色运动水壶(1L), 2026-10-02, 1, 89.00, 89.00【样本第 3 行】:P20261003, 黑色咖啡杯(350ml)-特价, 2026.10.03, 3, 39.00, 117.00我的目标:在 G 列提取规格容量(括号内数字),在 H 列将日期统一为 YYYY-MM-DD。请不要帮我计算结果,请输出可以在 Excel 365 中直接向下填充的单行公式。第 2 步:逻辑委托(要公式,不要答案)
把脏活累活留给 Excel 自带的算力引擎。
我们只要向大模型索取两样东西:嵌套函数,或者文本清洗规则。
让 AI 给出可以直接复制进单元格的公式代码,例如 XLOOKUP 或 TEXTSPLIT。
拿到公式后,我们在自己的本地 Excel 里粘贴到目标列第 2 行。
鼠标双击右下角的小黑点,342 行瞬间全列计算完毕。
每一分钱的计算,都运行在微软的数学内核上,误差率恒定为 0。
第 3 步:边界压测(挑 2 个极值反向测试)
AI 给出的公式不能盲目全选使用。
在双击全列填充之前,我自己一定会挑选 2 个极端样本进行单独测试。
我卡在脏数据格式拆分过很多次。
第一个样本是包含空白单元格的行,测试是否会抛出 #VALUE! 错误。
第二个样本是包含特殊标点符号的行,测试公式截取是否会发生偏移。
只要这 2 个极端样本通过验证,我试了整张表 342 行就能放心填充。
5 套即插即用的公式提示词模板
为了让大家明天上班就能直接抄作业,我把我日常最常用的 5 套公式生成模板整理在下面。
无论你遇到跨表合并还是杂乱文本,直接套用即可。
模板 1:跨表安全匹配(XLOOKUP 替代 VLOOKUP)
在跨表匹配时,传统 VLOOKUP 经常因排序列变动导致错乱。
我使用的提示词模板:
我想在表 A 中根据“工号”(A列),匹配表 B 中的“部门”(D列)。数据源表 B 的工号在 C 列,部门在 D 列。如果表 B 中未找到该工号,请返回“【未登记】”。请输出适配 Excel 365 / WPS 的 XLOOKUP 公式,并说明若兼容老版本 Excel 应用什么嵌套公式。大模型会直接给出标准答案:
=XLOOKUP(A2, '表B'!C:C, '表B'!D:D, "【未登记】", 0)模板 2:脏文本关键信息拆分提取
很多业务系统导出的表格,把品名、颜色、尺寸混在同一格。
我使用的提取提示词:
单元格 A2 包含混合文本,例如:“短袖T恤-白色-XL码-男款”。字段均由连字符“-”分隔,但部分行缺少部分属性(例如只有 2 段或 3 段)。我需要分别提取“颜色”和“尺码”。请给出单行公式,要求若不存在该分段则返回空值,不产生 #VALUE! 报错。大模型会给出基于 TEXTSPLIT 或 MID+FIND 的稳健表达式。
模板 3:多源混乱日期强行归一化
导出的原始数据往往包含 2026/10/5、2026.10.05、20261005 三种日期格式。
我使用的日期纠偏提示词:
我的 A 列数据混合了三种日期格式:带斜杠、带圆点以及 8 位纯数字文本。请编写一个单行容错公式,将上述所有格式统一转换为标准的 2026-10-05 格式。模板 4:多条件动态去重与筛选
需要从 300 多行明细中提炼出满足特定条件的唯一直属客户清单。
我使用的筛选提示词:
在“明细表”中,A 列是客户名称,B 列是所属区域,C 列是订单状态。请帮我写一个动态数组公式:提取区域为“华东”且状态为“已交付”的所有不重复客户名称。如果没有任何符合条件的记录,显示“暂无数据”。大模型会给出 =UNIQUE(FILTER(...)) 的嵌套组合。
模板 5:条件求和排除文本数字陷阱
很多人用 SUMIFS 算不出数字,是因为导出的单价是文本型数字。
我使用的排雷提示词:
在明细表中,E 列是销售员,G 列是金额。但部分 G 列数字被存储为文本格式,直接 SUMIFS 无法累加。请提供一个能够自动将文本转换为数值并按销售员多条件求和的公式方案。表格交出前的自查清单
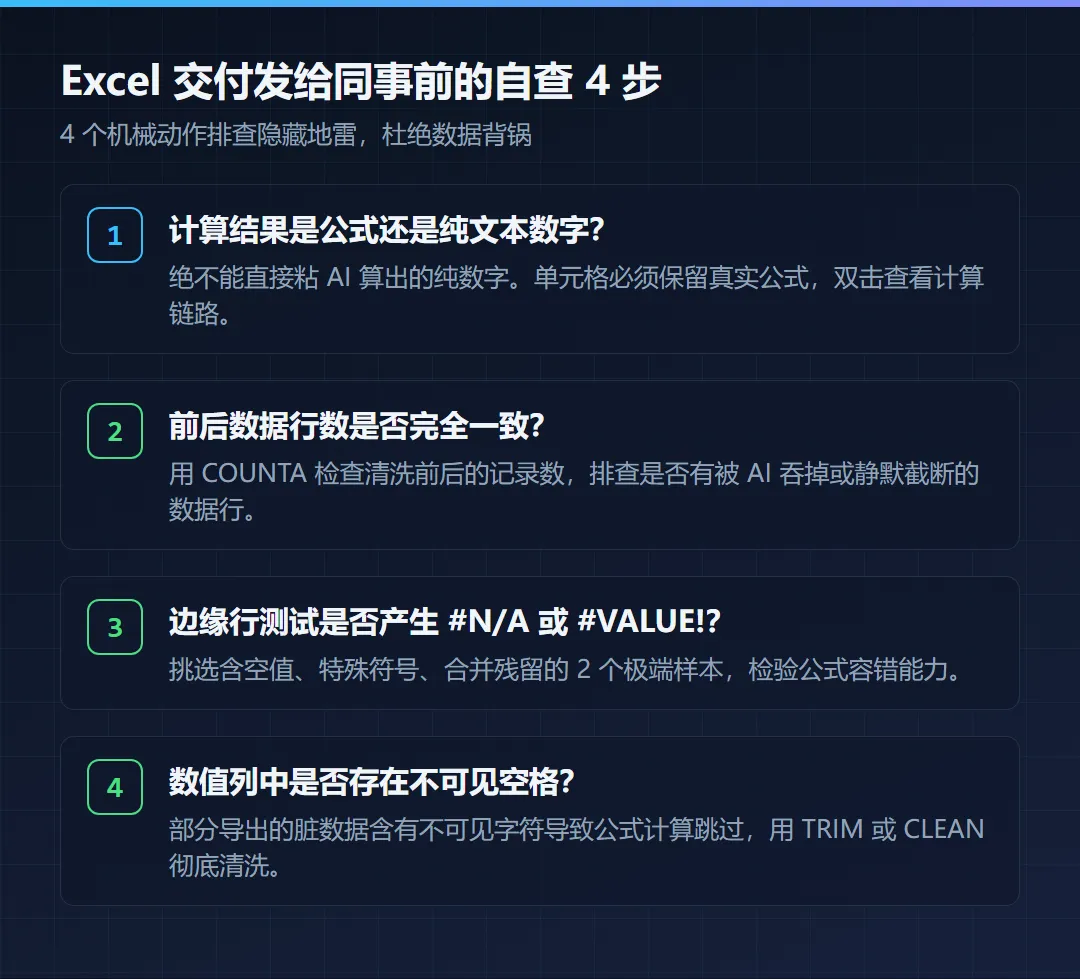
不管你用了多聪明的提示词,只要把表格交给主管或外部客户,就必须执行这 4 步自查。
这是我替大家踩过坑后沉淀下来的防翻车护栏:
1. 查计算引擎归属:检查关键求和列,单元格内必须是公式而非静态数字。双击单元格能清晰看到引用的区域,坚决不粘贴 AI 算出来的纯文本数字。 2. 查行数完全一致:在最后一列空白处,用 =COUNTA(A:A)检查清洗前后的记录总数。确保没有任何一行数据在操作过程中被吞掉或截断。3. 查极端边界报错:用筛选器快速浏览公式生成列,查看是否隐藏着 #N/A、#REF!或#VALUE!。如果有,立即补充容错缺省值。4. 查不可见空格污染:部分系统导出的表格带有不可见空白符,导致求和跳过。必要时先嵌套一次 TRIM()清除杂质。
AI 在表格处理上是极其出色的逻辑顾问,但千万别让它当算盘。
学会把 342 行的整表压缩成 3 行切片,既保护了数据安全,又换来了 100% 的准确率。
明天开工遇到堆积的销售表或考勤表,不妨试一试这套 3 步切片流。