ARTICLE · 1128424
AI落地基础课-03| 知识图谱最难的两件事:实体对齐与本体建模
《AI 落地基础课》第 3 篇(图谱收官)。前两篇讲了图谱是什么、怎么爬。这篇讲真正难的两关——它们都不在"写代码"上,而在"数据干不干净、图纸对不对"。一句话先摆这:图谱的质量上限,不由算法决定,由这两件事决定。
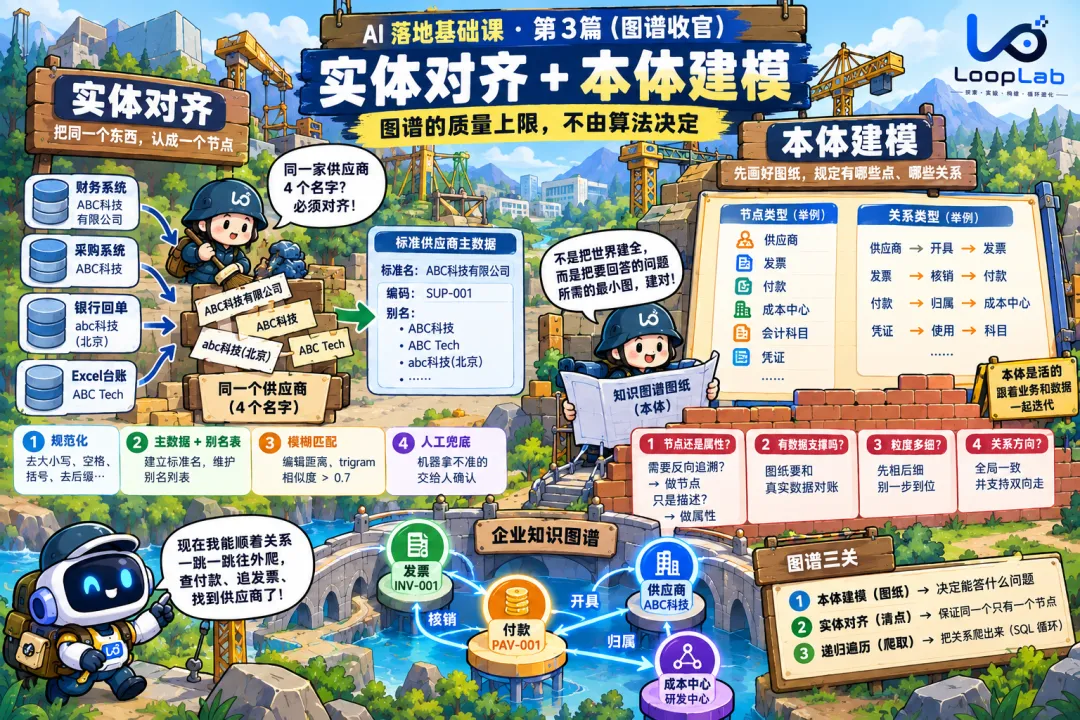
上半场:实体对齐——同一家供应商,4 个名字
一问题长什么样
同一家供应商,在你几个业务系统里可能是:
●●●CODE
财务系统: "ABC科技有限公司"采购系统: "ABC科技"银行回单: "abc科技(北京)"Excel台账: "ABC Tech"对人来说一眼是同一家。对机器,这是 4 个不同的字符串 = 4 个不同的节点。
后果很严重:你从"ABC科技"去追它开的发票,只追到 1/4 的票,金额算少一大截。
图谱当场碎成四片。AI 顺着碎图算出来的数,是错的——而且它一脸自信。
所以实体对齐要做的事,一句话:
把"其实是同一个东西"的多条记录,合并认定成同一个节点。
二怎么做(从易到难四招)
第 1 招:规范化——先把明显的噪音抹平
统一大小写、全半角、去空格括号、去掉"有限公司/(北京)"这类后缀:
●●●CODE
"abc科技(北京)" ┐"ABC科技有限公司" ├─ 规范化后都变成 → "abc科技""ABC Tech" ┘一规范,一大批"假不同"当场合并。这是性价比最高的一步。
第 2 招:主数据 + 别名表——建一个"官方档案"
给每个供应商建一条标准记录,外加一个别名列表:
●●●CODE
标准名:ABC科技有限公司编码: SUP-001别名: ["ABC科技", "ABC Tech", "abc科技(北京)"]以后任何系统进来一个名字,先来这张表匹配:命中标准名或任一别名 → 一律认定为 SUP-001。图里永远只有 SUP-001 这一个节点。
这是对齐的地基。(在我的项目里,这张表就是数据治理层的"供应商主数据"。)
第 3 招:模糊匹配——处理没见过的新写法
新数据来个"ABC 科技股份",别名表里没有,怎么办?算相似度:
- 编辑距离:改几个字能从 A 变成 B,改得越少越像。
- trigram(三字片段重叠率):数据库自带函数就能算。
设个阈值,比如相似度 > 0.7,就判"疑似同一个"。
第 4 招:人工兜底——机器拿不准的交给人
相似度卡在中间(0.5~0.8)的,别硬判,列一个"疑似重复"清单给运营点"是/不是",结果回写进别名表。下次机器就学会了。
三为什么它是最脏的活
●●●CODE
① 没标准答案:多像才算"同一个"?阈值高了漏合、低了错合,反复调② 是无底洞:新数据源不断进来,就不断有新写法要对齐,永远做不完③ 错一个代价大:把两家不同公司误合成一个,比不合更糟——两家的钱算一起了④ 跨部门:财务/采购/银行各叫各的,统一命名本质是"治理"问题,不纯是技术问题行业里那句老话,说的就是这个:
"垃圾进,垃圾出。" 图谱质量的上限,不由图算法决定,由实体对齐的质量决定。
01下半场:本体建模——一开始该建哪些节点和关系
四"本体"是什么
这词唬人,其实就一句话:
本体 = 知识图谱的"设计图纸"。它规定:允许出现哪些类型的节点、哪些类型的边。
盖房子前有张建筑图纸,规定"这是承重墙、那是门窗"。图纸不是房子,是房子的规则。
●●●CODE
本体(图纸/规则) 实例(真实数据)──────────────── ────────────────节点类型:供应商 具体:ABC科技、鼎盛物流关系类型:供应商-开具->发票 具体:ABC科技-开具->INV-001五为什么它比"对齐"还上游、还关键
因为它决定了AI 能不能回答某一类问题——从根上卡死。
老板问"这供应商这个月拿走多少钱",AI 要能答,图纸里就必须画了 供应商 → 发票 → 付款 这条链。
图纸里没画的关系,AI 永远追不出来——不是它笨,是这条路根本不存在。图纸多大,AI 的视野就多大。
建模错误是最贵的错误:它不是"某条数据错了",是"某一整类问题永远答不了"。
六怎么画图纸?反着来最靠谱
新手最容易犯的错:一上来就想"把公司所有东西都建成节点,越全越好"。错。 那样你会建出一张谁也用不动的巨网。
正确姿势是从问题倒推:
●●●CODE
第1步:先列出 AI 到底要回答哪些问题 (现金流为什么紧?这供应商花了多少?成本中心超预算没?) ↓第2步:每个问题涉及"哪些东西"→ 这些就是你要的【节点类型】 ↓第3步:这些东西要"怎么连"才能答出问题 → 这些就是你要的【关系类型】 ↓第4步:只建这些。其余一概先不建。建模不是"把世界建全",是"把要回答的问题所需的最小图,建对"。
七建模时真正纠结的四道判断题
判断 1:这东西该是"节点",还是"属性"?
拿"会计科目"(比如"管理费用")举例:
- 当属性:
凭证{科目:"管理费用"}→ 简单,但没法问"所有走管理费用的凭证有哪些" - 当节点:
(凭证)-使用->(科目:管理费用)→ 复杂点,但能反向穿透
判断标准:
如果你需要"从这个东西反向追它关联了谁",它就该是节点;只是用来描述、不需要被追溯,当属性就够。
(金额、日期永远是属性;供应商、成本中心该是节点。)
判断 2:这条关系,我有数据支撑吗?
理想图纸上画得出的边,真实数据里不一定连得起来。比如"付款→凭证"这条关系,如果表里压根没有关联字段,硬建就是在假设上盖楼,等真实数据进来多半推翻重来。
本体建模要和"你手里到底有什么数据"来回对账。理想图纸 ∩ 真实数据 = 你现在能建的图。
判断 3:粒度多细?(over-modeling 陷阱)
"付款"要不要拆成"单头+明细行"?新手总想拆得越细越专业。但每多一类节点,对齐成本、维护成本、查询复杂度都跟着涨。
当前的问题需要这个粒度吗?不需要就别拆。先粗后细,别一步到位。
判断 4:关系方向怎么定?
"付款核销发票"还是"发票被付款核销"?方向是人为约定,关键是全局一致 + 能双向走(还记得第 2 篇的"双向化"吗)。先定一个约定,别一会儿这样一会儿那样。
八本体是活的,不是刻在石头上的
最后一个关键心态:
本体不是一次画对、永远不变。它跟着业务和数据一起长。
●●●CODE
起步:先建最小可用图纸(够答核心问题的几类关系) ↓ 真实数据进来、新问题冒出来迭代:发现"付款→凭证"真需要了 → 补字段 → 图纸加一条边 ↓再迭代:要按科目穿透了 → 把科目从"属性"升级成"节点"一次性把所有关系都建了、还是为假数据建的,反而是负债。故意留白,等业务长到那儿再补,是成熟,不是偷懒。
02三关串起来,收个尾
●●●CODE
① 本体建模(图纸) ← 最上游,决定"能答哪类问题" ↓ 定义有哪些节点类型② 实体对齐(清点) ← 保证"同一个东西只有一个节点" ↓ 把点弄干净、唯一③ 递归遍历(爬取) ← 最下游、最好写,SQL 就搞定 ↓一张能被 AI 顺藤摸瓜的关系网倒过来说就是这个系列最想让你记住的一句:
图谱难,不难在"怎么爬"(技术活,第 2 篇就讲完了),难在"该建什么图、点干不干净"(业务活 + 治理活)。
而这也正是"AI 落地"最反直觉的地方——
决定 AI 上限的,从来不是模型多强,而是它脚下的数据地基铺得多实。
图谱三篇到此结束。这个系列后面还会继续讲 AI 落地里那些"看起来是模型问题、其实是数据/工程问题"的东西。
如果这篇文章对你有所启发,欢迎点赞、转发或留言交流。
我会持续分享:
- AI Agent
- MCP
- Dify
- 企业 AI
- Java 后端
- 企业数字化实践
希望和更多同行一起探索 AI 如何真正走进企业,而不仅仅停留在演示阶段