ARTICLE · 1130286
Agent 不需要记忆需要文档:Kevin Liao 破除向量抽奖,VeriHarness 证实分歧胜过共识
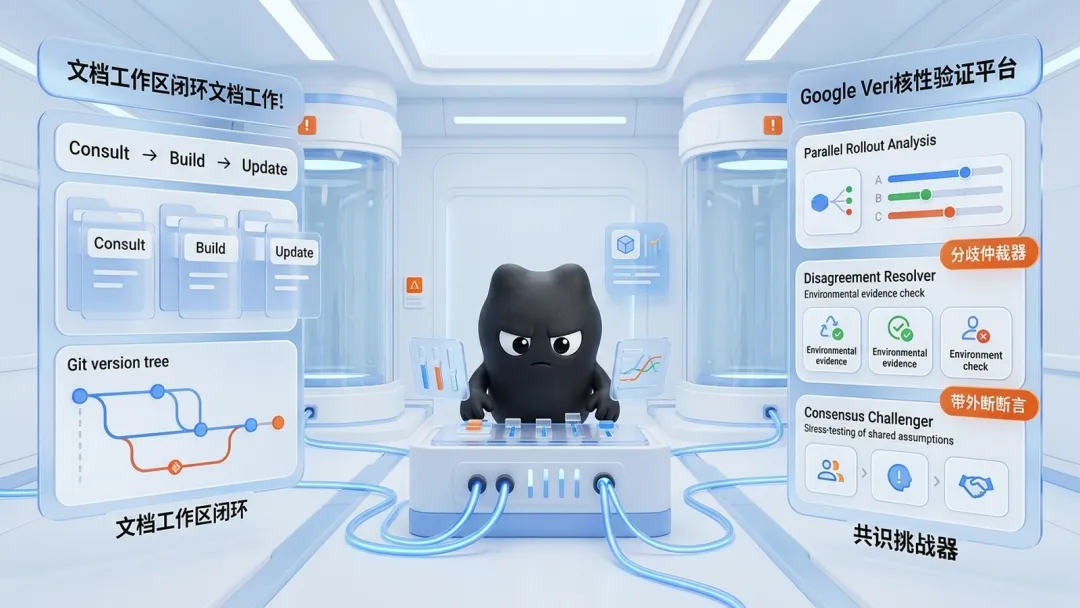
导读:当行业沉迷于给智能体塞进向量库抽奖、误以为投票共识就是真理时,今日工业突破敲响警钟:Kevin Liao 痛陈向量 RAG 缺陷,确立
Consult ➔ Build ➔ Update的 Markdown 文档工作区闭环;Google 开源 VeriHarness,实证“共识掩盖盲区,分歧曝出真理”,用带外环境仲裁器击碎集体幻觉;配合 The Extender 用 LSM 日志结构重构 Transformer 削减 104 倍 KV 显存,以及 SpaceXAI 工程师运维 200+ Agent 的物理证据链,智能体工程正全面迈入确定性系统秩序。
一、 向量记忆抽奖的破灭与文档工作区闭环
1.1 语义相似度不等于正确度:向量 RAG 记忆的五大致命缺陷
过去两年里,几乎所有的智能体记忆方案都在套用同一种工程模式:监听会话 ➔ 将历史文本切块存入向量数据库 ➔ 每次向大模型发送 Prompt 时检索 Top-5 语义相似片段盲目注入 ➔ 遇到上下文混乱就引入做梦者(Dreamer)或后台总结器。
Aerovato Research 创始人 Kevin Liao 在今日发表的长文中,用极其直白的工程常识击穿了这一模式的幻觉:市面上所有的智能体记忆插件,都在解一道根本不存在的错题。
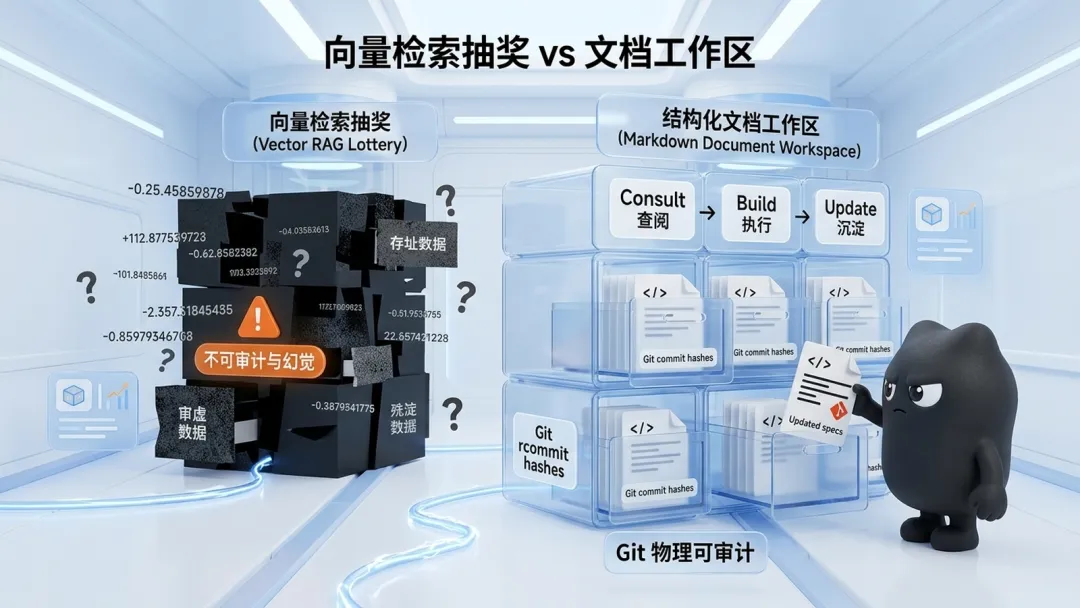
在真实工业级代码与业务场景中,向量记忆存在五项不可调和的底层内伤:
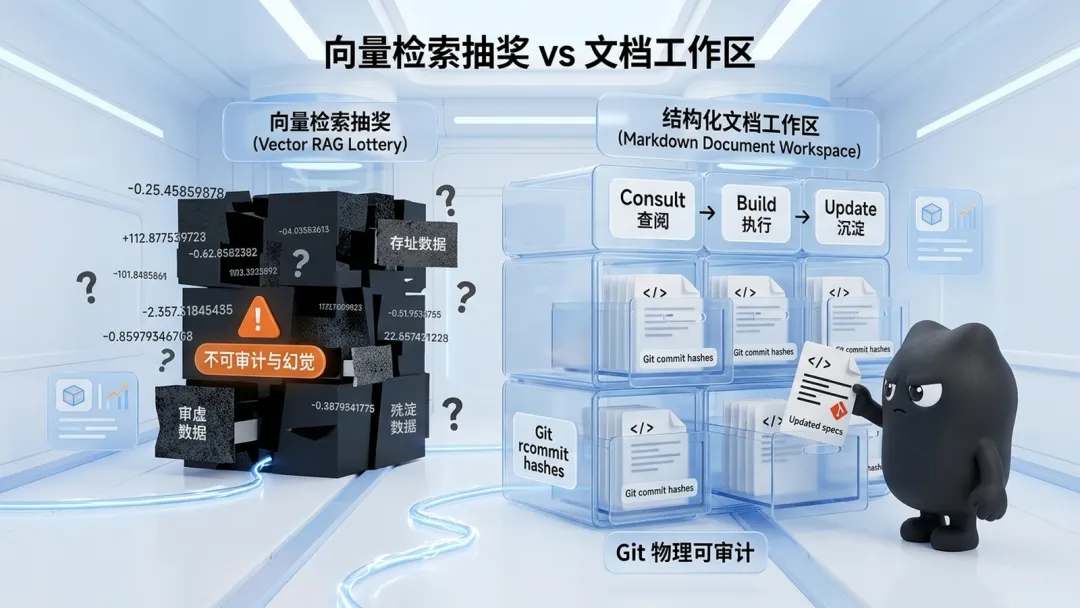
1. 距离近不代表事实对:向量空间里的余弦距离只能衡量词义或主题相近。一条两周前记录的“临时降级配置”可能与当前问题语义极高重合,但它是早已失效的陈旧毒药; 2. 语境与环境完全被剥离:切碎的文本块失去了当时的调用栈、系统状态与权限环境,模型在残缺前提下只能依靠自回归概率强行脑补幻觉; 3. 代码库天天在变,过去沉沦为虚假真相:软件系统是动态演进的实体。旧会话记录的接口入参早已过时,将历史当成“长久记忆”等同于向大脑持续灌注陈旧废气; 4. 智能体无法检索“它不知道自己不知道”的隐式约束; 5. 存储内堆积数万浮点嵌入黑箱:完全不可被人类工程师审计、无法在 CI/CD 中设置门禁断言,更无法像普通工程资产一样提交 Git 进行协同。
1.2 从失忆到文档工作区:Consult ➔ Build ➔ Update 四阶段工程重塑
真实世界中经验丰富的资深工程师,从来不会为了排查系统异常去重听三年前的会议录音。人类的协作秩序依托于活体文档系统——明确的规格说明书、接口契约与操作手册。
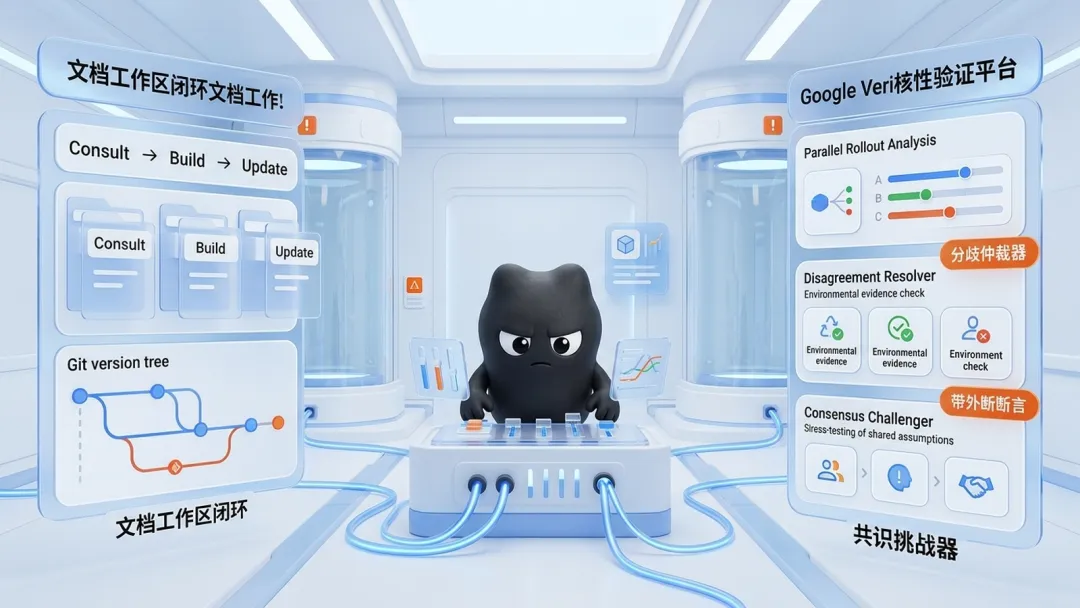
智能体需要的从来不是“拟人化的生物记忆”,而是一个透明、可审计的 Markdown 文档工作区(Markdown Document Workspace)。整个开发循环必须从脆弱的线性过程,重构为确定性的状态机闭环:
旧范式:Prompt ➔ Build ➔ Forget(盲目生成或抽奖式记忆)新范式:Prompt ➔ Consult(查阅规范)➔ Build(执行构建)➔ Update(回写沉淀)• Consult 阶段(前置查阅):在生成第一行代码之前,Agent 必须通过受控工具查阅对应目录下的 Markdown 规范(如 AGENTS.md、specs/);• Build 阶段(沙箱执行):在干净的执行环境中落实功能与测试; • Update 阶段(后置沉淀):在任务交付完毕、全盘业务上下文仍在记忆窗口内的黄金时刻,Agent 必须负责将最新配置、避坑教训与接口变更回写进 Markdown,并提交 Git。
这种架构无需维护任何后台守护向量库,零额外推理开销,每一次记忆演变都是一条清晰的 git commit,彻底将智能体拉回了经典现代软件工程的轨道。
二、 Google VeriHarness:分歧曝出真理,共识掩盖盲区
2.1 多数派投票的集体盲区陷阱
在长程、多步骤的自主任务中,当缺乏预先编写的标准答案或人工评分细则时,如何有效筛选智能体生成的多个候选方案(Rollouts)?长期以来,行业默认诉诸“共识投票(Consensus Voting)”——让模型生成 5 到 10 个候选,选择被最多候选所共同支持的结论。
Google Cloud AI 与剑桥大学联合发表的重磅预印本《VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks》(arXiv:2610.00972),用详实的工业实测打破了这一常识:
共识往往掩盖了共同盲区,而尖锐的分歧反而能曝光正确的备选路径。
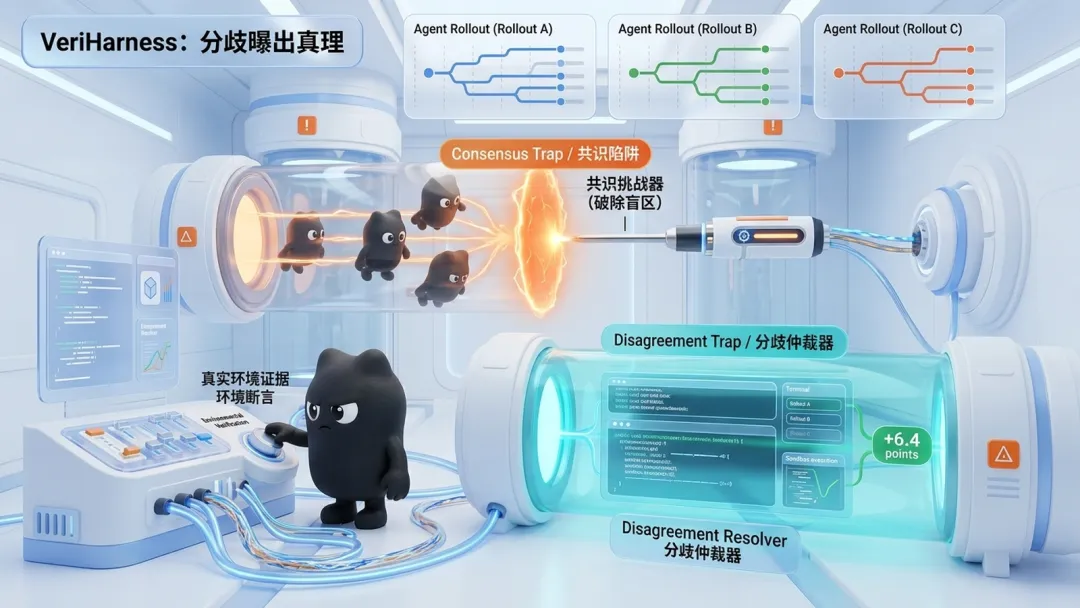
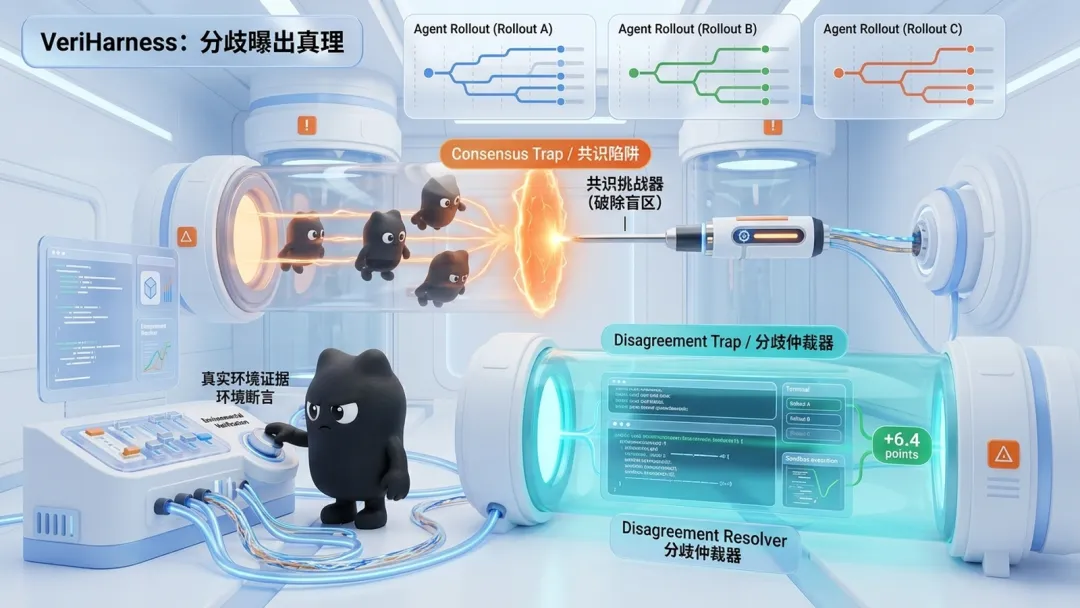
当底层模型在面对复杂长程任务时,同一个系统提示词和相似的上下文诱导,极容易让不同采样路径在同一个缺陷点上“异口同声”地犯错。如果盲目依据多数票筛选,系统实际上在用算力强化自身的集体幻觉;相反,当不同候选在某个关键步骤产生剧烈冲突时,往往意味着某个独立采样链触碰到了极其冷僻但正确的物理边界。
2.2 分歧仲裁器与共识挑战器的带外物理门禁
VeriHarness 彻底放弃了让模型自评自夸的软性评分,而是将基座大模型包装为一个拥有独立工作区、物理工具链与可演化技能的“代理验证器(Agentic Verifier)”,核心机制由两个对立统一的引擎构成:
1. Disagreement Resolver(分歧仲裁器):当不同候选之间出现互斥声明(例如“应采用方案 A”vs“应采用方案 B”),仲裁器不听信任何言语辩解,而是直接在带外沙箱中编写测试用例、拉起运行时进行环境断言(Environmental Evidence)。谁能在物理环境中真实通过,谁才被确认为有效声明; 2. Consensus Challenger(共识挑战器):专门负责充当“红方蓝军”,对所有候选达成一致的部分发起激进的压力测试。共识挑战器主动检索那些可能被全体候选遗漏的隐式边界、暗含并发竞态或隐藏业务死角。
在横跨 5 大长程工作区基准与前沿大模型(Gemini 3.5 Flash 与 Claude Opus 4.8)的评测中,VeriHarness 带来了高达 +6.2 至 +6.4 分 的纯净性能飞跃。这一突破证实:在智能体编排中,设计“故意挑刺与环境仲裁”的机制,远比追求表面上的合家欢共识更有工程价值。
三、 经典体系映射:CorpusMap 实体导航与 The Extender 日志 Transformer
3.1 微软 CorpusMap:倒排索引对决向量黑箱的胜利
当智能体需要在上千篇企业内部文档中检索证据时,传统做法是把全部文本切片灌入向量库,导致 Agent 频繁在相似文档之间做无头苍蝇式的重复检索。
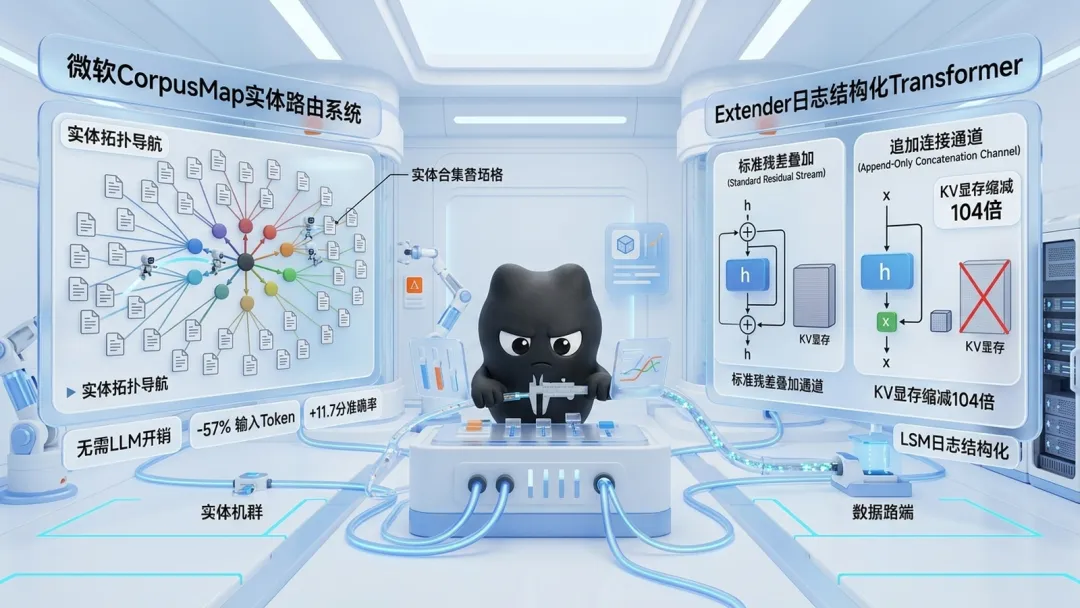
微软联合多所高校推出的 CorpusMap 架构,将经典数据库的倒排索引与实体拓扑图谱引入了智能体检索层。
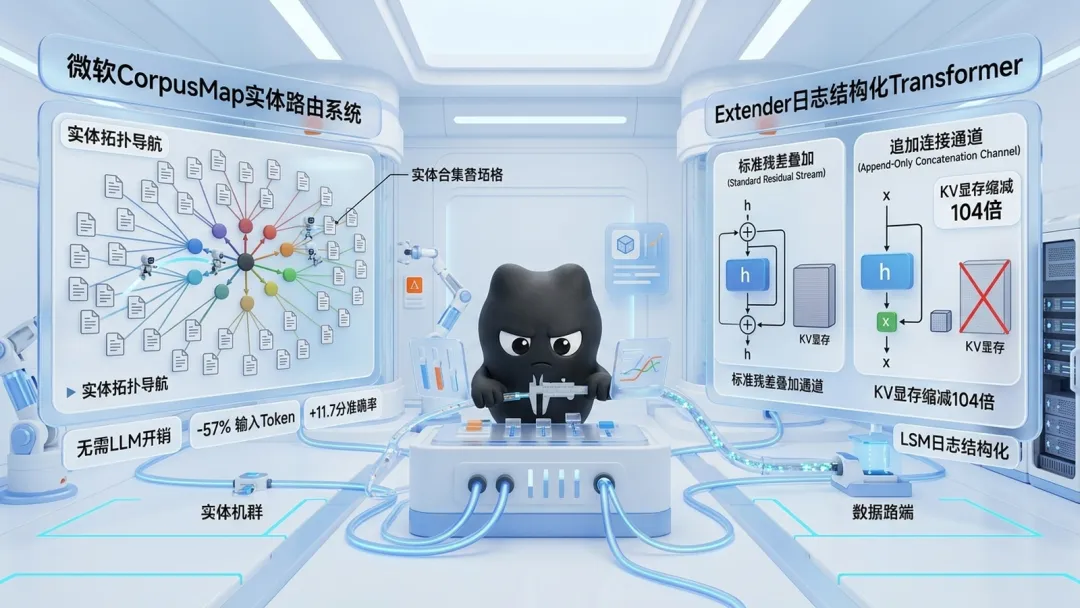
CorpusMap 在预处理阶段并不依赖昂贵的大模型推理,而是使用极速算法解析全量文档中的实体关系,为每个实体建立聚合索引页面,并建立与所有关联文档的双向链接。
智能体检索时,首先查阅实体拓扑,顺藤摸瓜直接定位所有支撑证据,彻底杜绝了同义词迷航与孤岛遗漏。实测表明,CorpusMap 跨 7 个主流模型将回答质量拉升 6.4 至 11.7 分,同时将输入 Token 消耗直接砍掉 34% 至 57%。
3.2 The Extender:用 LSM 日志结构重构 Transformer 显存
在模型底层架构层面,今日顶会论文《The Extender: A Log-Structured Transformer》(arXiv:2609.32759)做出了极其震撼的底层创新:将经典操作系统与存储系统中的 LSM 树(Log-Structured Merge-tree)与日志追加文件系统(LFS)映射至 Transformer。
在标准 Transformer 中,各层之间完全通过残差流 进行通信,信息在单一通道上发生重叠叠加。为了执行注意力计算,每一层都必须独立保存巨量的 KV 投影张量,导致长文本下的显存开销随深度 与维度 剧烈膨胀()。
The Extender 在残差流 之外,开辟了一条全新的只追加(Append-Only)拼接通道 :
• 每一层 既向残差流 提交更新 ,又将微小的扩展切片 追加到通道 ; • 前馈网络(FFN)与 Query 观察残差流 ,而 Attention 的 KV 投影仅以纯净的追加通道 作为输入; • 这一解耦使得所有层的 KV 投影输入被完全浓缩在 中,持久注意力显存占用从 骤降为 。
在 924M 参数模型实测中,The Extender 将持久注意力显存直接压缩了 104 倍!更关键的是,它在短文本基准上打平标准 Transformer,而在长文本(RULER 基准)上全面超越了传统注意力。这再次证明:计算机系统 40 年积累的存储分页与日志追加智慧,依然是解决前沿 AI 物理瓶颈的终极降维武器。
四、 算力经济学与 200+ 智能体编队的工程跟进环
4.1 SemiAnalysis 揭秘:同样 200 美元,Claude 换取的 Token 价值是 OpenAI 的 5 倍
当学术界还在讨论模型架构时,工业界战壕里的开发者正在面对算力账单的残酷冰山。
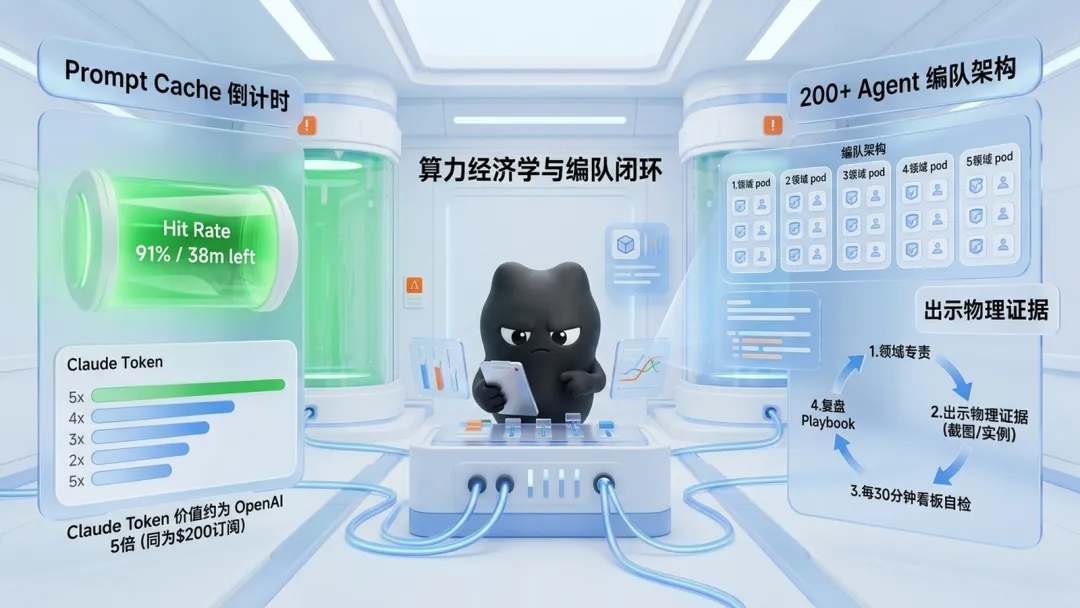
权威半导体与系统分析机构 SemiAnalysis 今日发布了对 9 家主流 AI 订阅的深度实测。数据披露了一个让行业震惊的事实:在每月 200 美元的同等高阶订阅下,Claude 换取的实际可用 Token 用量与 API 等价价值,整整是 OpenAI 的 5 倍之多。
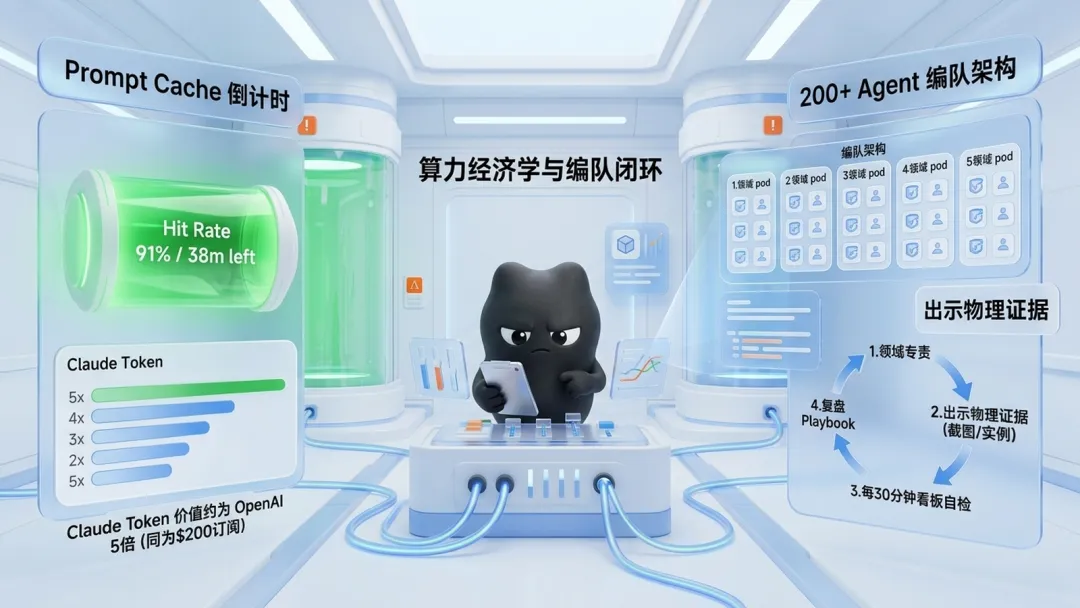
这一鸿沟主要体现在日常主力模型(Opus 5.5 vs GPT-6.1 Sol)的配额策略上。OpenAI 在 DevDay 之后将 200 美元 Pro 档位的可用额度直接腰斩,并推行高达 500 美元的 Ultrafast 档位,本质上标志着头部厂商对算力的大幅补贴正在全面退坡。
面对这一现实,高频开发者开始在工程控制面上建立严格的成本防线。今日走红的 Claude Code 状态栏 Prompt Cache 倒计时插件 即是战壕产物:
• 在终端状态栏实时监控上下文缓存的生存时间(TTL); • 暖缓存状态下显示绿色倒计时并提示命中率(如 91% hit,节省 90% 费用); • 剩余时间低于 20% 时亮黄灯预警,冷缓存状态下亮红灯提醒单次消息将引发数万 Token 重新编译。
4.2 SpaceXAI 工程师的 200+ 编码智能体编队跟进环
面对算力与规模的约束,单打独斗的对话框模式已经彻底过时。SpaceXAI 工程师 Lingxi Li 今日完整披露了其个人常态化运维 200+ 编码智能体编队 的私有治理架构:
整个代码库被严格划分为 5 大领域(移动端、桌面端、基础设施、Android 与 Harness 外骨骼),由 5 个独立的领域专员 Bot 分管,专员再向下派生具体的执行任务。这套系统之所以能够稳定运转,完全依赖于一套严密的四步跟进环(The Follow-up Loop):
1. 领域专责(Clear Ownership):绝不搞大一统全能 Agent,每个 Bot 上下文被严格限制在本域代码与最小地图内; 2. 物理断言证据链(Ask for Proof):严禁口头汇报“已完成”。Agent 必须出示真实的物理证据——修改前后的 UI 截图、终端可执行转录(Transcripts)与本地活体运行实例,由审查 Bot 进行自动校验; 3. 动态看板自检(Board Sync):系统每 30 分钟轮询一次 CI 状态、分支冲突与 Review 遗留,未通过验收的任务直接打回重跑; 4. 故障复盘归宿(Mistake Ownership):专属运维 Bot 对每次报错进行 Postmortem 根因分析,并即时将规约沉淀至团队共享的 Markdown Playbook 中。
五、 底层算法与通信:Dust 零阶预训练与 CacheBack 接收端条件协同
5.1 颠覆反向传播:首个零阶方法 Dust 预训练 Transformer 登场
在神经网络的底层优化器层面,数十年来反向传播算法(Backpropagation)一直被视为大型模型预训练不可动摇的黄金法则。然而,反向传播必须在正向与反向两次遍历中完整保存并回传激活值,这在极大规模计算中构成了沉重的内存墙与同步壁垒。
今日发布的 Dust 算法,成为了数十年来首个能够在 Transformer 架构上逼近并超越反向传播的零阶优化方法(Zeroth-Order Optimization)。
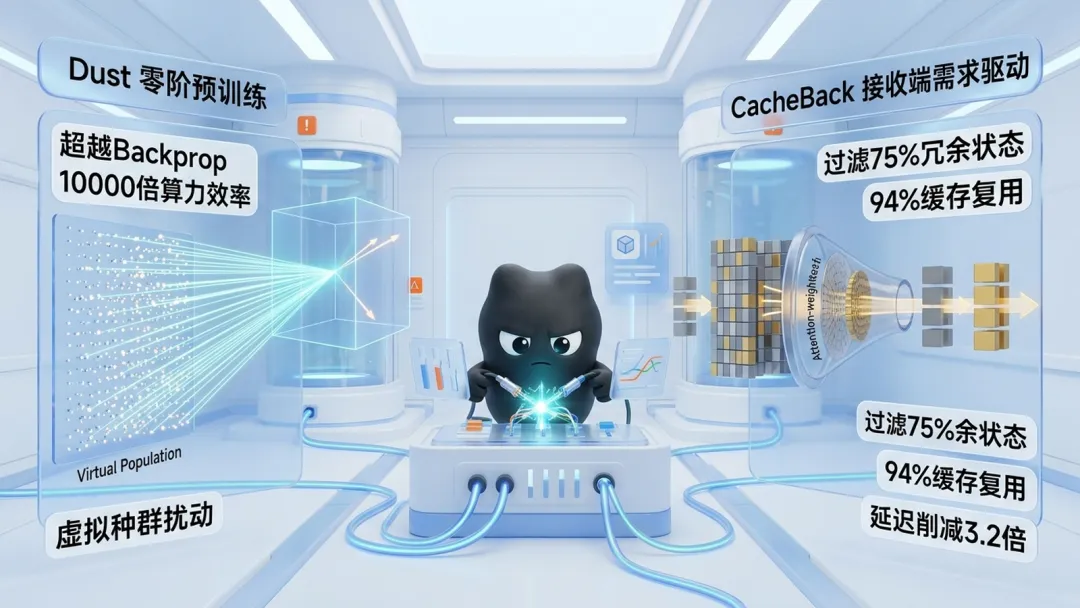
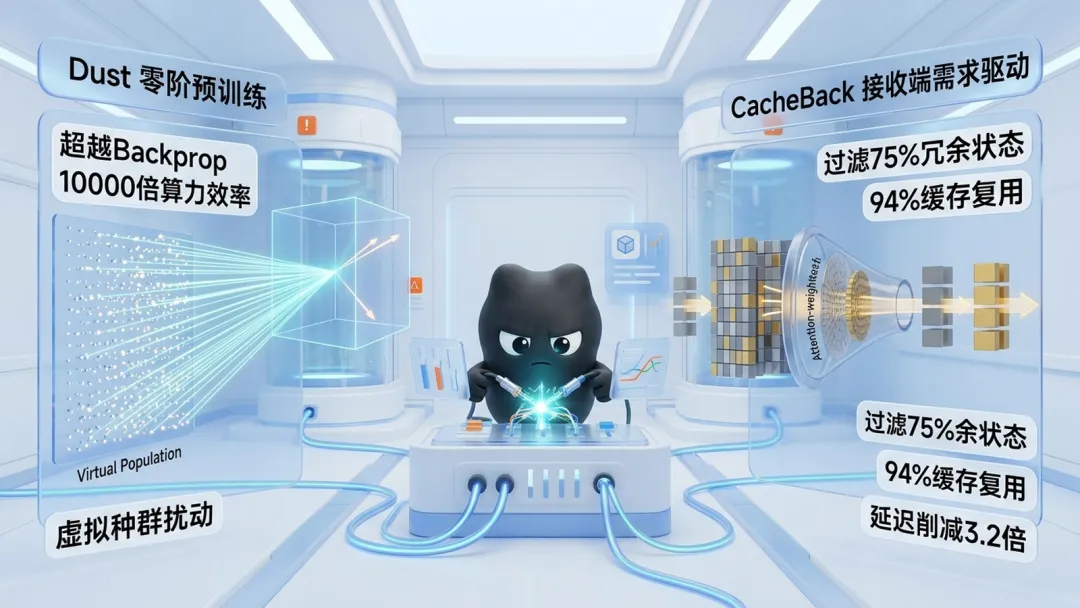
Dust 摒弃了复杂的梯度反向传播计算,其算力效率达到此前最优零阶方法 EGGROLL 的 1,000 至 10,000 倍。其微观机理在于利用虚拟种群(Virtual Population)并行扰动激活,在高维超参数化空间中自发涌现出等效于反向传播的参数更新向量,在 1B Token 预训练规模下表现出惊人的收敛稳定性。
5.2 哥伦比亚大学 CacheBack:接收端需求驱动的 94% 缓存复用
在多智能体协同系统中,传递自然语言文本虽然紧凑,但需要反复经历昂贵的生成解码,且常常丢失关键的执行细节;而如果直接在 Agent 之间传递底层 KV Cache,显存占用会随着参与协作的 Agent 数量和会话长度呈现灾难性的线性膨胀。
哥伦比亚大学团队在最新预印本《Receiver-Conditioned Latent Communication gives 94% CacheBack》(arXiv:2609.32046)中提出了突破性的 CacheBack 架构:
• 核心洞察:协作智能体之间根本不需要传递发送端的全量注意力状态,发送方只需要传递接收方在局部任务中真正关心的切片; • 机制流程:接收 Agent 仅需向发送端发送一个极简的需求描述,发送端基于注意力权重对自身庞大的 KV Cache 进行定向过滤与剪枝,仅推送经过压缩的下游必需状态; • 工业战果:在 FanOutQA 基准测试中,CacheBack 为 Qwen 3 裁剪掉了 75% 的冗余状态传输,跨 Agent 任务延迟大幅缩短 3.2 倍,任务准确率反而逆势拉升了 14.7 个百分点,实现了高达 94% 的缓存复用收益。
六、 搭建透明可审计与自愈 Agent 的四项工程重构
结合今日从记忆哲学、长程验证、系统显存到编队运维的多维突破,面向生产战壕的开发者应立即开展以下四项底层重构:
• 废黜向量黑箱,建立结构化 Markdown 文档工作区:在项目代码库中剔除繁复的第三方向量记忆插件,建立透明的 internal/specs/体系;在智能体外骨骼中强行固化Consult ➔ Build ➔ Update流程,强制 Agent 在动手前查阅规范、交工后更新文档并提交 Git 审计;• 在生成决策流中部署 VeriHarness 级分歧仲裁器:当多方案采样出现分歧时,坚决摒弃“多数派投票”的伪共识,设计专门的断言脚本(Disagreement Resolver)拉起带外沙箱,用真实的单元测试与运行退出码( exit_code == 0)进行物理裁决;• 实装上下文缓存倒计时监控(TTL 守护):在团队的终端或开发环境中引入类似 Cache Countdown 的状态条,可视化监控 Prompt Caching 的生存周期,避免高频多轮开发因为几秒钟的超时触发全量 Token 的昂贵重新计算; • 多 Agent 通信践行 CacheBack 范式做状态减负:在集群编排中,禁止无节制地向所有下游智能体广播全量上下文与全局会话历史,改为通过显式的“下游需求声明”进行注意力状态剪枝,将网络与显存负载锁定在最小必要集内。
终局点题:在算力潮水退去处重构确定性骨架
回顾半个世纪计算机体系的演进历史,每一次底层算力介质的爆炸,最初都会引发一阵对“算力万能论”的盲目狂热。四十年前微处理器刚刚普及之时,人们曾天真地以为只要主频足够高,就不再需要复杂的分页内存与特权级保护;二十年前分布式系统兴起之际,人们也曾妄想只要机器数量足够多,就能无视网络分区的物理法则。
然而,历史一次又一次用冷酷的系统崩溃给出了相同的教训:算力资源的暂时充沛,从来不会自动兑现出软件系统的稳定与秩序;越是高维、不可控的概率世界,越需要确定性外骨骼的严密咬合。
今天,大模型工程正在经历完全相同的历史交接。当向量 RAG 抽奖的狂热被可审计的 Markdown 工作区所终结,当多智能体表面共识的盲区被带外分歧仲裁器所击碎,当 104 倍的显存暴降重新回归经典的日志追加通道,我们清晰地看到:大模型正在卸下全知全能的虚妄光环,退回到它最该呆的生态位——作为一块极其强大但必须被外部操作系统严格约束的大宗算力芯片。
下一代真正具备工业交付能力的智能体,绝不会是一个内部堆满未剪枝向量碎片的黑箱玩具,而是一台状态落盘、依赖透明、分歧可裁决、每一步跃迁都有物理证据背书的认知微型操作系统。
当价格战的喧嚣与参数跑分的狂欢终将散去,唯有那些在工程战壕中千锤百炼的确定性骨架,才是重塑未来工业世界坚不可摧的永恒资产。
Agent 不需要记忆需要文档:Kevin Liao 破除向量抽奖,VeriHarness 证实分歧胜过共识
导读:当行业沉迷于给智能体塞进向量库抽奖、误以为投票共识就是真理时,今日工业突破敲响警钟:Kevin Liao 痛陈向量 RAG 缺陷,确立
Consult ➔ Build ➔ Update的 Markdown 文档工作区闭环;Google 开源 VeriHarness,实证“共识掩盖盲区,分歧曝出真理”,用带外环境仲裁器击碎集体幻觉;配合 The Extender 用 LSM 日志结构重构 Transformer 削减 104 倍 KV 显存,以及 SpaceXAI 工程师运维 200+ Agent 的物理证据链,智能体工程正全面迈入确定性系统秩序。
一、 向量记忆抽奖的破灭与文档工作区闭环
1.1 语义相似度不等于正确度:向量 RAG 记忆的五大致命缺陷
过去两年里,几乎所有的智能体记忆方案都在套用同一种工程模式:监听会话 ➔ 将历史文本切块存入向量数据库 ➔ 每次向大模型发送 Prompt 时检索 Top-5 语义相似片段盲目注入 ➔ 遇到上下文混乱就引入做梦者(Dreamer)或后台总结器。
Aerovato Research 创始人 Kevin Liao 在今日发表的长文中,用极其直白的工程常识击穿了这一模式的幻觉:市面上所有的智能体记忆插件,都在解一道根本不存在的错题。
在真实工业级代码与业务场景中,向量记忆存在五项不可调和的底层内伤:
1. 距离近不代表事实对:向量空间里的余弦距离只能衡量词义或主题相近。一条两周前记录的“临时降级配置”可能与当前问题语义极高重合,但它是早已失效的陈旧毒药; 2. 语境与环境完全被剥离:切碎的文本块失去了当时的调用栈、系统状态与权限环境,模型在残缺前提下只能依靠自回归概率强行脑补幻觉; 3. 代码库天天在变,过去沉沦为虚假真相:软件系统是动态演进的实体。旧会话记录的接口入参早已过时,将历史当成“长久记忆”等同于向大脑持续灌注陈旧废气; 4. 智能体无法检索“它不知道自己不知道”的隐式约束; 5. 存储内堆积数万浮点嵌入黑箱:完全不可被人类工程师审计、无法在 CI/CD 中设置门禁断言,更无法像普通工程资产一样提交 Git 进行协同。
1.2 从失忆到文档工作区:Consult ➔ Build ➔ Update 四阶段工程重塑
真实世界中经验丰富的资深工程师,从来不会为了排查系统异常去重听三年前的会议录音。人类的协作秩序依托于活体文档系统——明确的规格说明书、接口契约与操作手册。
智能体需要的从来不是“拟人化的生物记忆”,而是一个透明、可审计的 Markdown 文档工作区(Markdown Document Workspace)。整个开发循环必须从脆弱的线性过程,重构为确定性的状态机闭环:
旧范式:Prompt ➔ Build ➔ Forget(盲目生成或抽奖式记忆)新范式:Prompt ➔ Consult(查阅规范)➔ Build(执行构建)➔ Update(回写沉淀)• Consult 阶段(前置查阅):在生成第一行代码之前,Agent 必须通过受控工具查阅对应目录下的 Markdown 规范(如 AGENTS.md、specs/);• Build 阶段(沙箱执行):在干净的执行环境中落实功能与测试; • Update 阶段(后置沉淀):在任务交付完毕、全盘业务上下文仍在记忆窗口内的黄金时刻,Agent 必须负责将最新配置、避坑教训与接口变更回写进 Markdown,并提交 Git。
这种架构无需维护任何后台守护向量库,零额外推理开销,每一次记忆演变都是一条清晰的 git commit,彻底将智能体拉回了经典现代软件工程的轨道。
二、 Google VeriHarness:分歧曝出真理,共识掩盖盲区
2.1 多数派投票的集体盲区陷阱
在长程、多步骤的自主任务中,当缺乏预先编写的标准答案或人工评分细则时,如何有效筛选智能体生成的多个候选方案(Rollouts)?长期以来,行业默认诉诸“共识投票(Consensus Voting)”——让模型生成 5 到 10 个候选,选择被最多候选所共同支持的结论。
Google Cloud AI 与剑桥大学联合发表的重磅预印本《VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks》(arXiv:2610.00972),用详实的工业实测打破了这一常识:
共识往往掩盖了共同盲区,而尖锐的分歧反而能曝光正确的备选路径。
当底层模型在面对复杂长程任务时,同一个系统提示词和相似的上下文诱导,极容易让不同采样路径在同一个缺陷点上“异口同声”地犯错。如果盲目依据多数票筛选,系统实际上在用算力强化自身的集体幻觉;相反,当不同候选在某个关键步骤产生剧烈冲突时,往往意味着某个独立采样链触碰到了极其冷僻但正确的物理边界。
2.2 分歧仲裁器与共识挑战器的带外物理门禁
VeriHarness 彻底放弃了让模型自评自夸的软性评分,而是将基座大模型包装为一个拥有独立工作区、物理工具链与可演化技能的“代理验证器(Agentic Verifier)”,核心机制由两个对立统一的引擎构成:
1. Disagreement Resolver(分歧仲裁器):当不同候选之间出现互斥声明(例如“应采用方案 A”vs“应采用方案 B”),仲裁器不听信任何言语辩解,而是直接在带外沙箱中编写测试用例、拉起运行时进行环境断言(Environmental Evidence)。谁能在物理环境中真实通过,谁才被确认为有效声明; 2. Consensus Challenger(共识挑战器):专门负责充当“红方蓝军”,对所有候选达成一致的部分发起激进的压力测试。共识挑战器主动检索那些可能被全体候选遗漏的隐式边界、暗含并发竞态或隐藏业务死角。
在横跨 5 大长程工作区基准与前沿大模型(Gemini 3.5 Flash 与 Claude Opus 4.8)的评测中,VeriHarness 带来了高达 +6.2 至 +6.4 分 的纯净性能飞跃。这一突破证实:在智能体编排中,设计“故意挑刺与环境仲裁”的机制,远比追求表面上的合家欢共识更有工程价值。
三、 经典体系映射:CorpusMap 实体导航与 The Extender 日志 Transformer
3.1 微软 CorpusMap:倒排索引对决向量黑箱的胜利
当智能体需要在上千篇企业内部文档中检索证据时,传统做法是把全部文本切片灌入向量库,导致 Agent 频繁在相似文档之间做无头苍蝇式的重复检索。
微软联合多所高校推出的 CorpusMap 架构,将经典数据库的倒排索引与实体拓扑图谱引入了智能体检索层。
CorpusMap 在预处理阶段并不依赖昂贵的大模型推理,而是使用极速算法解析全量文档中的实体关系,为每个实体建立聚合索引页面,并建立与所有关联文档的双向链接。
智能体检索时,首先查阅实体拓扑,顺藤摸瓜直接定位所有支撑证据,彻底杜绝了同义词迷航与孤岛遗漏。实测表明,CorpusMap 跨 7 个主流模型将回答质量拉升 6.4 至 11.7 分,同时将输入 Token 消耗直接砍掉 34% 至 57%。
3.2 The Extender:用 LSM 日志结构重构 Transformer 显存
在模型底层架构层面,今日顶会论文《The Extender: A Log-Structured Transformer》(arXiv:2609.32759)做出了极其震撼的底层创新:将经典操作系统与存储系统中的 LSM 树(Log-Structured Merge-tree)与日志追加文件系统(LFS)映射至 Transformer。
在标准 Transformer 中,各层之间完全通过残差流 进行通信,信息在单一通道上发生重叠叠加。为了执行注意力计算,每一层都必须独立保存巨量的 KV 投影张量,导致长文本下的显存开销随深度 与维度 剧烈膨胀()。
The Extender 在残差流 之外,开辟了一条全新的只追加(Append-Only)拼接通道 :
• 每一层 既向残差流 提交更新 ,又将微小的扩展切片 追加到通道 ; • 前馈网络(FFN)与 Query 观察残差流 ,而 Attention 的 KV 投影仅以纯净的追加通道 作为输入; • 这一解耦使得所有层的 KV 投影输入被完全浓缩在 中,持久注意力显存占用从 骤降为 。
在 924M 参数模型实测中,The Extender 将持久注意力显存直接压缩了 104 倍!更关键的是,它在短文本基准上打平标准 Transformer,而在长文本(RULER 基准)上全面超越了传统注意力。这再次证明:计算机系统 40 年积累的存储分页与日志追加智慧,依然是解决前沿 AI 物理瓶颈的终极降维武器。
四、 算力经济学与 200+ 智能体编队的工程跟进环
4.1 SemiAnalysis 揭秘:同样 200 美元,Claude 换取的 Token 价值是 OpenAI 的 5 倍
当学术界还在讨论模型架构时,工业界战壕里的开发者正在面对算力账单的残酷冰山。
权威半导体与系统分析机构 SemiAnalysis 今日发布了对 9 家主流 AI 订阅的深度实测。数据披露了一个让行业震惊的事实:在每月 200 美元的同等高阶订阅下,Claude 换取的实际可用 Token 用量与 API 等价价值,整整是 OpenAI 的 5 倍之多。
这一鸿沟主要体现在日常主力模型(Opus 5.5 vs GPT-6.1 Sol)的配额策略上。OpenAI 在 DevDay 之后将 200 美元 Pro 档位的可用额度直接腰斩,并推行高达 500 美元的 Ultrafast 档位,本质上标志着头部厂商对算力的大幅补贴正在全面退坡。
面对这一现实,高频开发者开始在工程控制面上建立严格的成本防线。今日走红的 Claude Code 状态栏 Prompt Cache 倒计时插件 即是战壕产物:
• 在终端状态栏实时监控上下文缓存的生存时间(TTL); • 暖缓存状态下显示绿色倒计时并提示命中率(如 91% hit,节省 90% 费用); • 剩余时间低于 20% 时亮黄灯预警,冷缓存状态下亮红灯提醒单次消息将引发数万 Token 重新编译。
4.2 SpaceXAI 工程师的 200+ 编码智能体编队跟进环
面对算力与规模的约束,单打独斗的对话框模式已经彻底过时。SpaceXAI 工程师 Lingxi Li 今日完整披露了其个人常态化运维 200+ 编码智能体编队 的私有治理架构:
整个代码库被严格划分为 5 大领域(移动端、桌面端、基础设施、Android 与 Harness 外骨骼),由 5 个独立的领域专员 Bot 分管,专员再向下派生具体的执行任务。这套系统之所以能够稳定运转,完全依赖于一套严密的四步跟进环(The Follow-up Loop):
1. 领域专责(Clear Ownership):绝不搞大一统全能 Agent,每个 Bot 上下文被严格限制在本域代码与最小地图内; 2. 物理断言证据链(Ask for Proof):严禁口头汇报“已完成”。Agent 必须出示真实的物理证据——修改前后的 UI 截图、终端可执行转录(Transcripts)与本地活体运行实例,由审查 Bot 进行自动校验; 3. 动态看板自检(Board Sync):系统每 30 分钟轮询一次 CI 状态、分支冲突与 Review 遗留,未通过验收的任务直接打回重跑; 4. 故障复盘归宿(Mistake Ownership):专属运维 Bot 对每次报错进行 Postmortem 根因分析,并即时将规约沉淀至团队共享的 Markdown Playbook 中。
五、 底层算法与通信:Dust 零阶预训练与 CacheBack 接收端条件协同
5.1 颠覆反向传播:首个零阶方法 Dust 预训练 Transformer 登场
在神经网络的底层优化器层面,数十年来反向传播算法(Backpropagation)一直被视为大型模型预训练不可动摇的黄金法则。然而,反向传播必须在正向与反向两次遍历中完整保存并回传激活值,这在极大规模计算中构成了沉重的内存墙与同步壁垒。
今日发布的 Dust 算法,成为了数十年来首个能够在 Transformer 架构上逼近并超越反向传播的零阶优化方法(Zeroth-Order Optimization)。
Dust 摒弃了复杂的梯度反向传播计算,其算力效率达到此前最优零阶方法 EGGROLL 的 1,000 至 10,000 倍。其微观机理在于利用虚拟种群(Virtual Population)并行扰动激活,在高维超参数化空间中自发涌现出等效于反向传播的参数更新向量,在 1B Token 预训练规模下表现出惊人的收敛稳定性。
5.2 哥伦比亚大学 CacheBack:接收端需求驱动的 94% 缓存复用
在多智能体协同系统中,传递自然语言文本虽然紧凑,但需要反复经历昂贵的生成解码,且常常丢失关键的执行细节;而如果直接在 Agent 之间传递底层 KV Cache,显存占用会随着参与协作的 Agent 数量和会话长度呈现灾难性的线性膨胀。
哥伦比亚大学团队在最新预印本《Receiver-Conditioned Latent Communication gives 94% CacheBack》(arXiv:2609.32046)中提出了突破性的 CacheBack 架构:
• 核心洞察:协作智能体之间根本不需要传递发送端的全量注意力状态,发送方只需要传递接收方在局部任务中真正关心的切片; • 机制流程:接收 Agent 仅需向发送端发送一个极简的需求描述,发送端基于注意力权重对自身庞大的 KV Cache 进行定向过滤与剪枝,仅推送经过压缩的下游必需状态; • 工业战果:在 FanOutQA 基准测试中,CacheBack 为 Qwen 3 裁剪掉了 75% 的冗余状态传输,跨 Agent 任务延迟大幅缩短 3.2 倍,任务准确率反而逆势拉升了 14.7 个百分点,实现了高达 94% 的缓存复用收益。
六、 搭建透明可审计与自愈 Agent 的四项工程重构
结合今日从记忆哲学、长程验证、系统显存到编队运维的多维突破,面向生产战壕的开发者应立即开展以下四项底层重构:
• 废黜向量黑箱,建立结构化 Markdown 文档工作区:在项目代码库中剔除繁复的第三方向量记忆插件,建立透明的 internal/specs/体系;在智能体外骨骼中强行固化Consult ➔ Build ➔ Update流程,强制 Agent 在动手前查阅规范、交工后更新文档并提交 Git 审计;• 在生成决策流中部署 VeriHarness 级分歧仲裁器:当多方案采样出现分歧时,坚决摒弃“多数派投票”的伪共识,设计专门的断言脚本(Disagreement Resolver)拉起带外沙箱,用真实的单元测试与运行退出码( exit_code == 0)进行物理裁决;• 实装上下文缓存倒计时监控(TTL 守护):在团队的终端或开发环境中引入类似 Cache Countdown 的状态条,可视化监控 Prompt Caching 的生存周期,避免高频多轮开发因为几秒钟的超时触发全量 Token 的昂贵重新计算; • 多 Agent 通信践行 CacheBack 范式做状态减负:在集群编排中,禁止无节制地向所有下游智能体广播全量上下文与全局会话历史,改为通过显式的“下游需求声明”进行注意力状态剪枝,将网络与显存负载锁定在最小必要集内。
终局点题:在算力潮水退去处重构确定性骨架
回顾半个世纪计算机体系的演进历史,每一次底层算力介质的爆炸,最初都会引发一阵对“算力万能论”的盲目狂热。四十年前微处理器刚刚普及之时,人们曾天真地以为只要主频足够高,就不再需要复杂的分页内存与特权级保护;二十年前分布式系统兴起之际,人们也曾妄想只要机器数量足够多,就能无视网络分区的物理法则。
然而,历史一次又一次用冷酷的系统崩溃给出了相同的教训:算力资源的暂时充沛,从来不会自动兑现出软件系统的稳定与秩序;越是高维、不可控的概率世界,越需要确定性外骨骼的严密咬合。
今天,大模型工程正在经历完全相同的历史交接。当向量 RAG 抽奖的狂热被可审计的 Markdown 工作区所终结,当多智能体表面共识的盲区被带外分歧仲裁器所击碎,当 104 倍的显存暴降重新回归经典的日志追加通道,我们清晰地看到:大模型正在卸下全知全能的虚妄光环,退回到它最该呆的生态位——作为一块极其强大但必须被外部操作系统严格约束的大宗算力芯片。
下一代真正具备工业交付能力的智能体,绝不会是一个内部堆满未剪枝向量碎片的黑箱玩具,而是一台状态落盘、依赖透明、分歧可裁决、每一步跃迁都有物理证据背书的认知微型操作系统。
当价格战的喧嚣与参数跑分的狂欢终将散去,唯有那些在工程战壕中千锤百炼的确定性骨架,才是重塑未来工业世界坚不可摧的永恒资产。