ARTICLE · 1134405
AI 模型到底在算什么——本质、分类、主流对比
AI 模型到底在算什么——本质、分类、主流对比
AI 模型到底在算什么?
——算的是"下一个字"。
就这么简单。
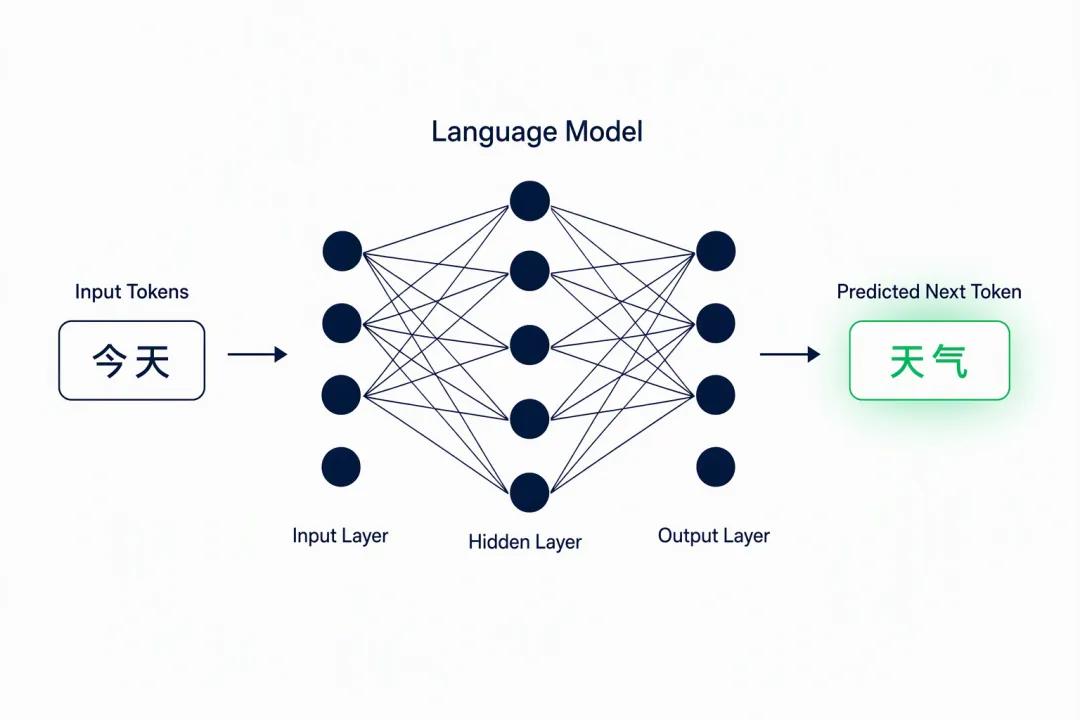
你跟豆包说"今天天气怎么样",它回"今天"——后面紧跟着"天气"两个字,是模型算出来的。它在所有可能的下一个字里,挑概率最高的那一个。
这个简单的"猜下一个字"的游戏,模型玩了上万亿次之后,突然学会了写代码、写诗、做数学题、聊人生。
听起来反常识——但这就是 AI 大语言模型(LLM)的本质:一个在海量文本上学到的、从"前文"到"下一个 token"的概率分布。
参数是它的"记忆",数据是它的"老师"。上万亿个参数,记下了人类写过的几乎所有公开文本的语言规律。
但参数不是越多越好。
模型规模在 2024 年就过剩了——现在大家拼的是"同样的参数规模,谁训得更好"。本质上:参数是基础设施,数据和训练方法才是真正的差异化。
一、模型的本质:函数逼近器
AI 大语言模型本质是一个函数逼近器。
它的工作流程是这样:你给它一段文字(prompt),它输出下一段文字(response)。这个过程不是"思考",是"预测"——基于前文,预测最可能的后续。
但为什么这个简单的预测能产生复杂的行为?
因为训练数据里有几乎所有的人类知识——新闻、论文、代码、对话、小说。模型把这些数据"压缩"进了上万亿个参数里。当你问它问题时,它不是从数据库里"查"答案,是从参数里"算"出最可能的回答。
这个"算"的过程是黑盒——我们能看到输入和输出,但看不到中间发生了什么。这也是为什么 AI 模型有时候会"一本正经地说错话"——它生成的字都来自统计概率,看着像思考,其实只是最像正确答案的拼接。
模型有三层关键能力,层层递进:
第一层:语言能力。模型能写出通顺、得体的文字。这是基础——大部分模型在 2024 年之前就达到了。
第二层:知识能力。模型能调用训练数据里的事实。这是 GPT-3 之后的能力——模型成了"知识的容器"。
第三层:推理能力。模型能多步思考、把复杂问题拆解。这是 2024 年之后的能力——以 OpenAI o1、DeepSeek-R1 为代表,开启了"推理模型"时代。
这三层能力层层递进——更高的能力叠加在低层之上,不是取代。
二、模型怎么分类:5 个维度
市面上模型多得让人眼花——豆包、DeepSeek、通义千问、Kimi、智谱、文心、混元……每个都说自己最强。
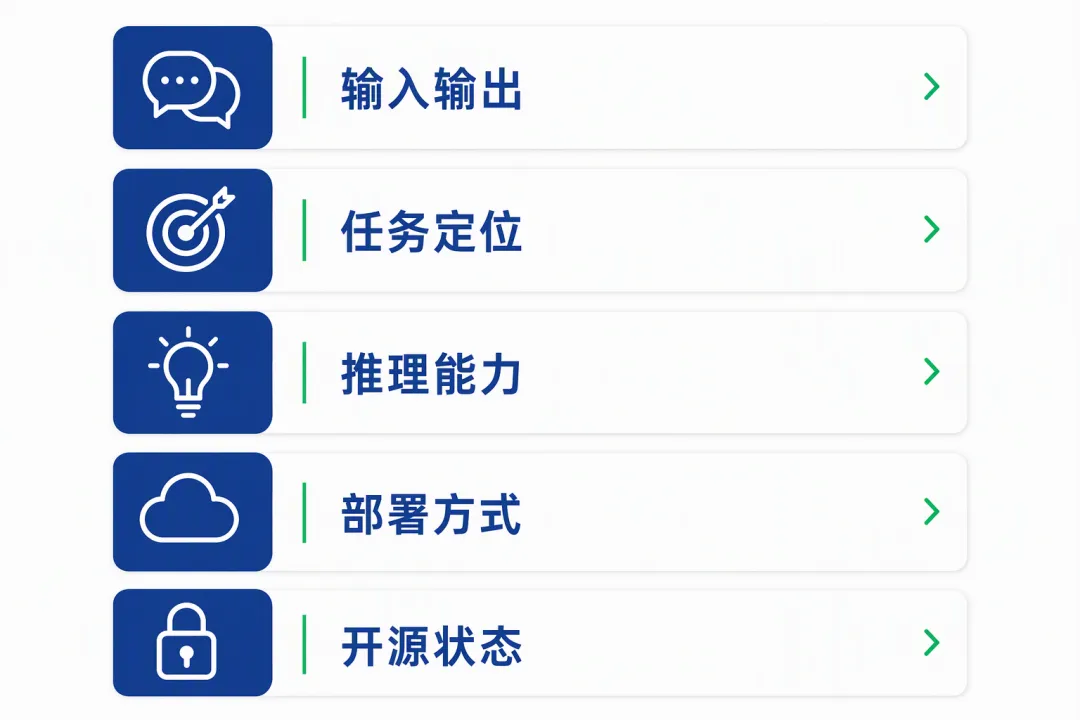
但其实模型的分类只有 5 个维度。任何一个模型,都可以在这个框架里找到位置。
维度 1:按输入输出分
纯文本模型:只能处理文字。早期 GPT-3、Llama 都是。 多模态模型:能同时处理文字、图片、音频、视频。GPT-4V、豆包视觉、通义千问 VL 都是。
多模态有实实在在的价值——它让模型能"看图说话"、"听音识曲",应用场景比纯文本宽得多。
维度 2:按任务定位分
通用模型:什么都能干,但什么都不一定专精。豆包、DeepSeek、通义千问都是。 垂直模型:专门针对某个领域训练。医疗模型、法律模型、金融模型都是。
老板选模型,大部分情况选通用模型就够了。垂直模型只有在你有明确专业需求时才考虑——比如做医疗 AI 客服,确实需要专门的医学知识库做底座。
维度 3:按推理能力分
基础模型:直接输出答案。速度快、成本低。 推理模型:先在内部"想"几步,再输出答案。质量高,但慢且贵。OpenAI o1、DeepSeek-R1、阿里 QwQ 是代表。
推理模型虽强,但成本也高——除非任务真的需要多步思考(比如复杂决策、代码生成、数学证明),否则没必要为它多付钱。
维度 4:按部署方式分
云端 API:模型跑在厂商服务器上,你按调用付费。最省事。 本地私有化:模型跑在你自己的服务器上。需要硬件投入,但数据安全。
数据敏感的场景(金融、医疗、政府),本地私有化是首选。其他情况用云端 API 就够。
维度 5:按开源状态分
闭源模型:只提供 API,不开放权重。OpenAI GPT、Anthropic Claude、字节豆包(部分)是代表。 开源权重模型:权重开放,可以下载部署。DeepSeek、Qwen、Llama 是代表。
开源当然也有成本——硬件、运维、技术能力都是开销。但开源最值的地方在哪?在你有"换"的能力。今天用这家,明天换那家,你不会被任何一家绑架。
三、主流模型对比:一张表看懂
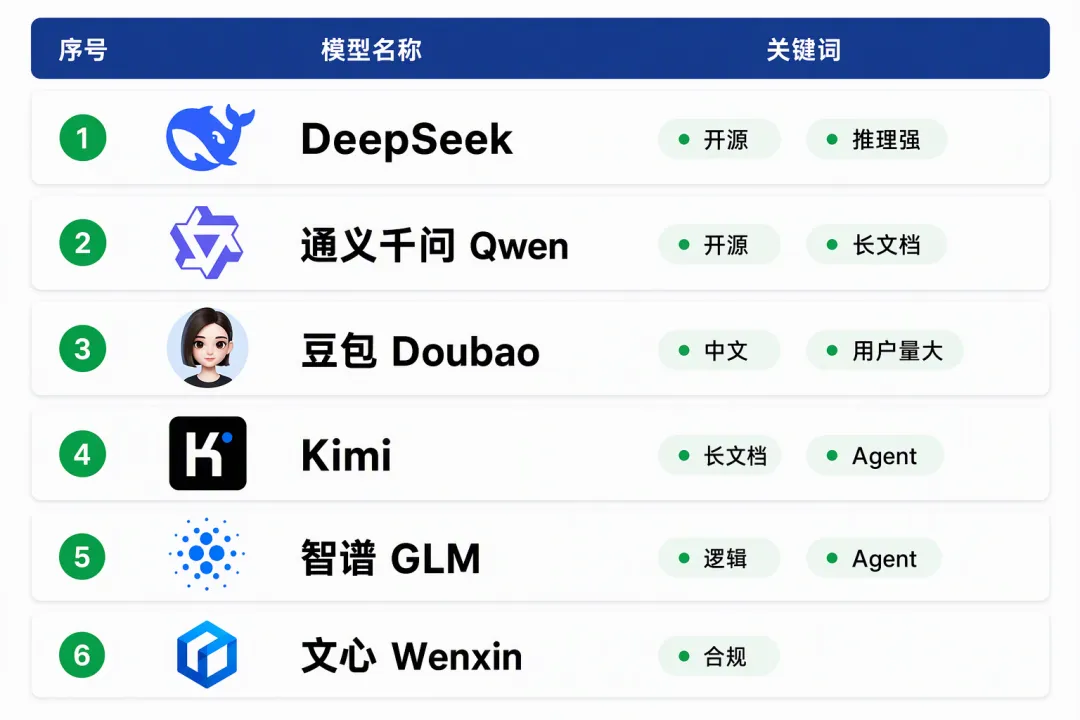
国产主流模型——DeepSeek、通义千问、豆包、Kimi、智谱、文心——综合榜分数都差不多,70 分上下,前三名只差 0.5 分。
0.5 分什么概念?
按"100 个用例、70% 成功率"的评估标准,模型的波动幅度就有 ±9 个百分点。换句话说,新模型 73% 对旧模型 70%,这 3 分的差距完全在噪声里——你不知道它是真进步了,还是你刚好抽到了好运。
所以综合榜看个大概就行。前三名任何一个,闭眼选都不会差到哪去。但你非要花一倍钱去切那个"榜一",对不起,冤枉钱。
真正的差异在哪里?先看一张速览图:
详细数据看这张表:
(数据以各厂商官网为准)
价格差异看起来不大——但按企业级调用量算账(月调用几千万 token 那种),一年能差出几十万。
综合榜前三差 0.5 分,基本可以忽略。但任务级指标(比如 AgentCLUE-Task)就不一样了——它测的是真本事。2026 年 7 月那一期,Kimi-K3 以 49.5 分拿第一,单题成本约 1.37 元。
这个差距有意义——因为它测的是"能不能正确调工具"。
老板选模型的终极标准其实就一句:测的是不是你关心的那件事。
看综合榜那个分数没意义,看参数规模那个数字也没意义,要看你具体的任务。
四、模型也会犯错
讲了这么多模型的好处,但有一件事老板必须知道——模型也会犯错,而且经常一本正经地犯。
我陪跑过程里见过几个典型的"翻车现场":
幻觉。模型会编造不存在的事实。比如问"某公司去年营收多少",模型可能给你一个看起来很具体的数字,但完全是编的。看起来像答案,其实是猜测。
推理错误。复杂数学题、多步逻辑推理,模型经常会算错。让它算"3 个人轮流值班,每个人值班 2 天,5 天内有多少种排班方式"——它经常答错。
长上下文遗忘。聊到第 20 轮,它可能忘了第 1 轮你说过的话。上下文窗口号称 100 万 token,实际有用的可能只有前面几万。
时效性差。模型的训练数据有截止日期。让它说"昨天发生了什么新闻",它只能瞎猜。
价值观偏差。不同模型对同一问题的回答有差异——有的保守,有的激进。老板要的是稳定可控的回答,不是随机的多样性。
模型会犯错,是因为它的本质是"统计概率生成"——它在"算最像答案的字",而不是"判断事实的真伪"。
老板怎么应对?
关键决策别让 AI 单独做——AI 出方案,人来决策 事实性内容必须人工核实——尤其涉及数字、日期、人名 让 AI 知道自己会犯错——prompt 里加一句"如果不确定,请说不知道" 多次跑取一致——同一个问题跑 3-5 次,看答案是否稳定
五、老板怎么用这张表?
看完上面的对比,老板可能会问:那我怎么选?
看 3 件事。
你的任务是什么? 模型是工具,不是聊天对象——你让它回答"今天天气怎么样"和让它"分析销售数据写周报"是两回事。前者随便哪个模型都能做,后者要看模型在你的真实任务上表现得怎么样。任务清楚,模型才好选——写文案的看中文能力,做客服的看响应速度,做代码的看推理能力。
你的预算是多少? 很多老板算账只算订阅费。订阅费只是开始——后面还有集成时间、出错成本、错选的机会成本。一个月费 50 块、配置要 40 小时、每月维护 5 小时的工具,一年不是 600 块,是 600 块 + 100 小时的人工费。算总账,别看月费。
你的容错边界在哪? 写个内部周报,错了也就错了,改改就行——闭眼选便宜的。给客户发的合同条款,错了要赔钱——必须选贵的。涉及合规、医疗、金融的场景,预算不要省,省了就是埋雷。
3 件事清楚,模型才好选。
六、最后的判断
模型市场 6 个月就变一次。今天的"榜一",6 个月后可能就掉到第三。
选什么没那么重要,能不能换才重要。
把架构搭成"模型无关"的——你今天用豆包,明天能换成 DeepSeek,后天能换成千问。这样你不会被任何一家厂商绑架,也不会因为某家厂商降价了你就得跟着降。
老板真正要做的,不是选最强的那个模型,是把模型接进自己的活场景——让它干上活。
工具的价值不在于它本身有多强,在于它有没有被用上、用对地方。
送一份 WorkBuddy 入门学习资料
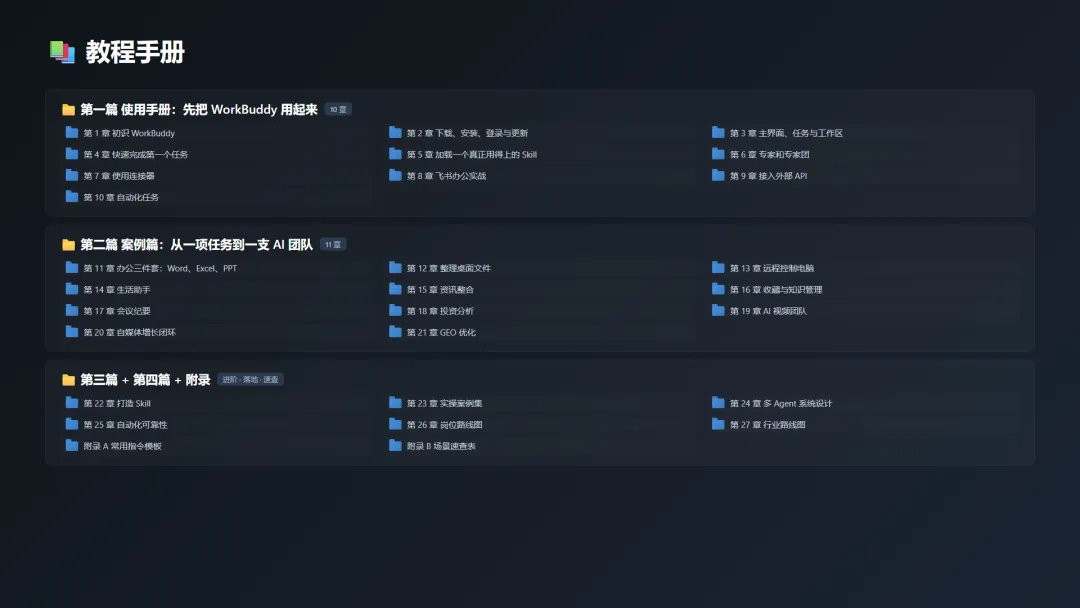
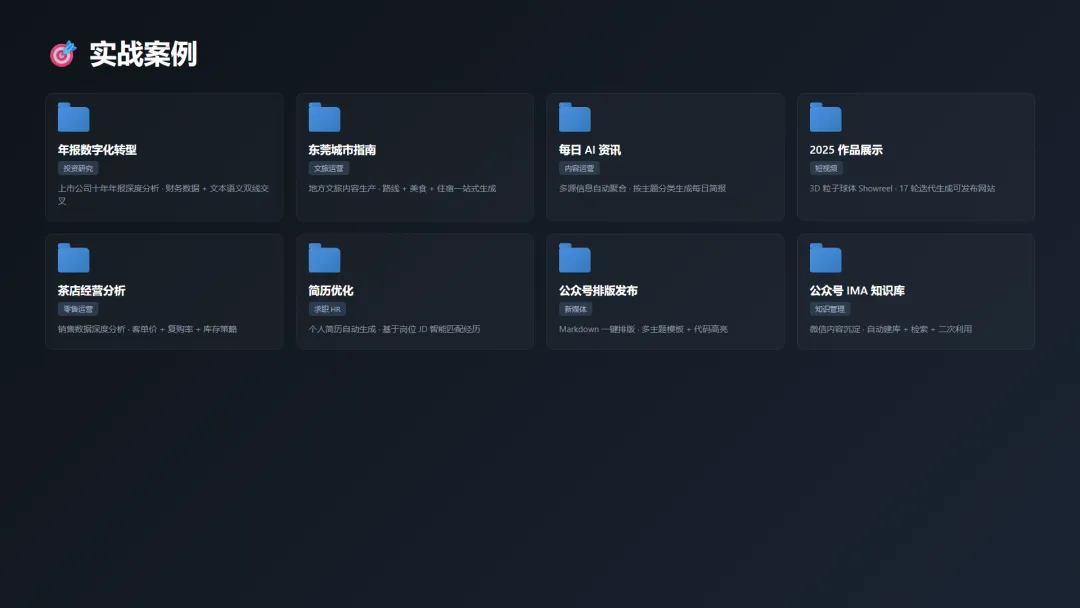
我整理了一份 WorkBuddy 入门学习资料,分两部分——基础入门手册 + 实战案例。
第一部分:基础入门手册(4 篇 / 27 章)
使用手册(10 章):WorkBuddy 用起来 案例篇(11 章):从任务到 AI 团队 进阶篇(4 章):进阶玩法 · 速速 岗位与行业落地(2 章)
第二部分:实战案例(8 个真实场景,每个案例都附详细提示词)
年报数字化转型(投研研究) 东莞城市指南(文旅) 每日 AI 资讯(内容运营) 2025 作品展示(短视频) 茶店经营分析(零售) 简历优化(求职) 公众号排版发布(新媒体系) 公众号 IMA 知识库(知识管理)
如果想免费领取这份资料,关注我就能拿到。