ARTICLE · 1137211
我照着B站教程,用AI手搓了个书单视频skill
先给你看一段话。
「明明累得不想说话,还答应替同事做事。拒绝的话打了几遍,最后发出去的还是没问题。等忙到深夜,心里又有些委屈,自己的疲惫就往后放。」
这段话不是我抄的,是我前天晚上用 AI 生成的一条书单视频的旁白。
从建项目到导出成片,我花了三个多小时,没写过一行代码,也没学过剪辑。
晚上十点,我在卧室书桌前开始照着教程做
我为什么会去做这个东西
我一直想做点内容,但卡在最前面那一关:我不会剪视频。
打开剪映,光是轨道我就看了十分钟,然后关掉了。
前两天我刷到一条B站教程,说的是零基础手搓一个书单讲解视频的 skill,做完一天能批量出很多条。
标题我不太信。但开头那段旁白的演示片段,我听完就停住了。
不是因为它多高级,是因为它写得太准。
所以我决定自己走一遍。
开篇那三句话,看懂了就不慌
博主一上来没讲工具,先讲了个挺重要的道理。
他说,任何一条视频,根上就三个东西。
第一是画面素材,图片、原片、字幕、特效,都算。
第二是音频素材,台词、背景音乐、甚至一个齿轮音效,都算。
第三是时间轴。
第三个最容易被忽略。它不显眼,但决定前两样东西什么时候出现。
我们要做的就是让 AI 生出画面和音频,自己排好时间轴,最后拼起来。
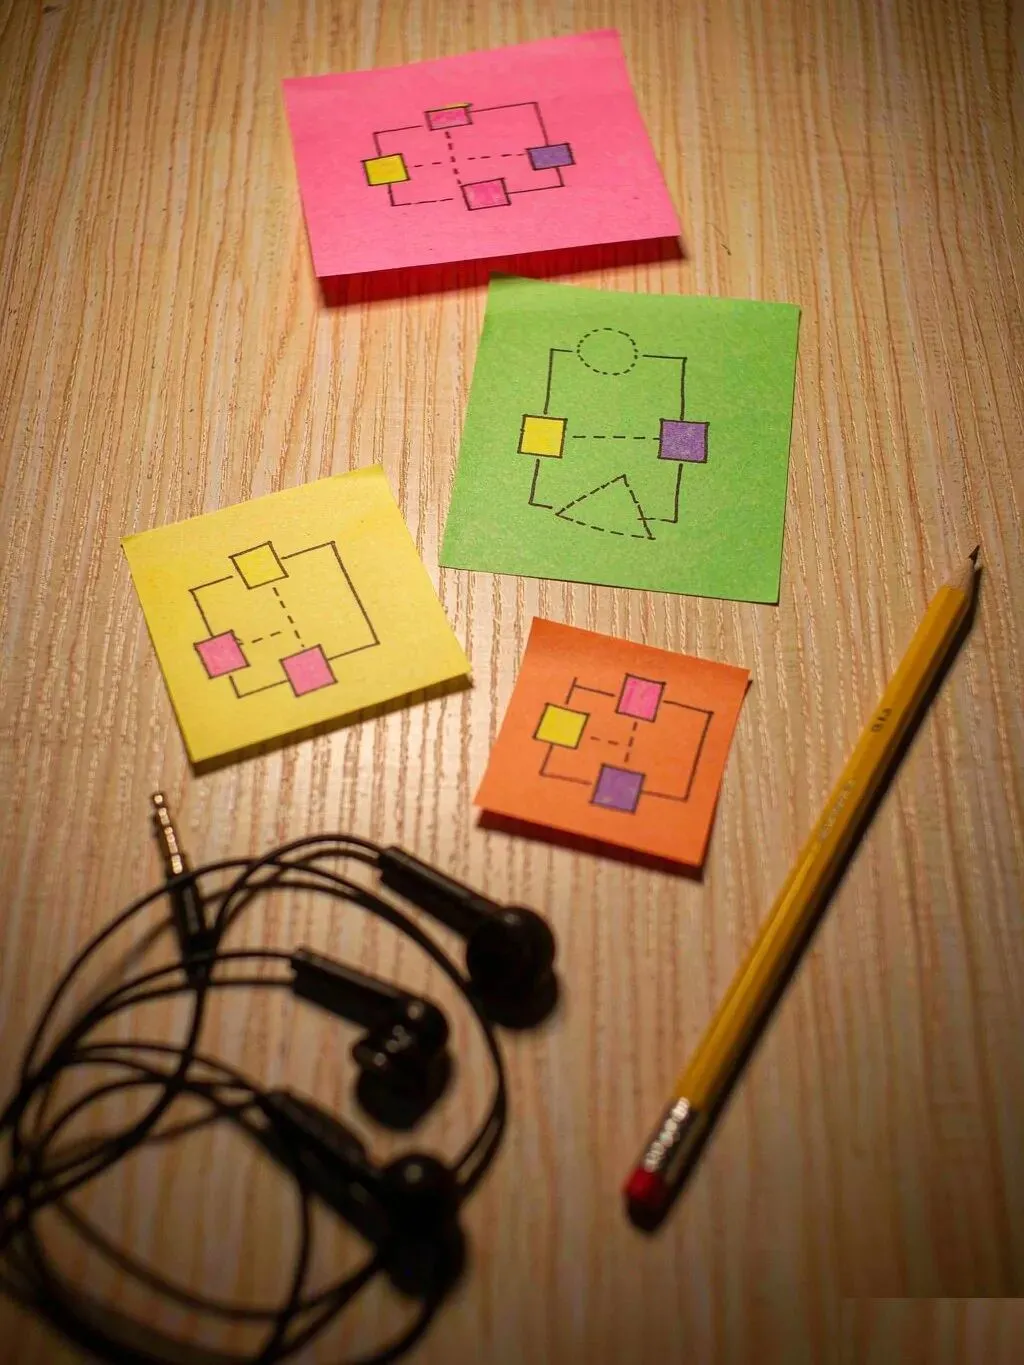
做视频这件事,拆开就三块
第一步:让 AI 把一本书拆开
我选的书是《被讨厌的勇气》,没什么特别理由,就是这两年一直有人说,我也没读完。
博主给了个我很喜欢的思路:你没时间读,但有人读过。
微信读书里,大量读者已经把笔记、划线、最打动人的段落标出来了。这些可以做成 Skill,让 AI 去读、去汇总。
我照着要了一份清单,一共九项。
准确的书名、作者、出版信息;这本书主要解决什么问题;目标受众是谁;观众最容易共鸣的处境是什么。
还有:最适合做成视频的那一条观点;可以引用的观点和案例;不能夸大表述的内容;适合画面的视觉方向。
返回结果里,「最适合讲的那一条观点」是课题分离——你负责把话说清楚,对方怎么回应,不由你决定。
那一刻我有点意外。
我以为拆书是提炼知识点。真正提取出来的,是网友反复提到的那种处境。
这才是能打动人的东西。
第二步:写一段愿意听完的文案
接下来是写旁白的文案,提示词里带了五条要求。
第一,第一句直接制造共鸣。第二,用短句和具体的生活场景。第三,中间自然带出书名和作者。
第四,结尾留余味。第五,不要写成书评或者剧情梗概。
还有一条硬规矩,我一开始觉得挺苛刻:正文最多 21 行,大约 220 个汉字,推荐 18 到 20 行,每一行是一个完整的朗读单元。
另一个细节也很有意思——不许用「不是……而是……」这种排比。
这种句式读出来太像 AI 写的,听两句就想划走。
生成出来是 18 行。它不是读完让人兴奋的文案,是读完让人安静一会儿的那种。
第三步:四张图决定好不好看
书单视频的核心素材就是图片,我让它一次性生成四张。
第一张是片头图,后面三张分别对应正文的前段、中段、后段。
统一要求一共六条,我原封不动抄下来了。
3:4 竖版、电影感纪实摄影、以情绪和氛围为主。
顶部和底部留出书名和字幕的空间、画面里不要出现任何文字、不要有书封、不要有卡片界面、不要有水印。
四张图的色调、人物和摄影风格必须统一。
最后一条最考验人:四张图色调对不上,整条视频就废了。
生成完我干了一件事:把它们分别命名为「片头」「前段」「中段」「后段」。
博主特意强调,后面所有提示词都按这个命名去写,改了名字就找不到图。
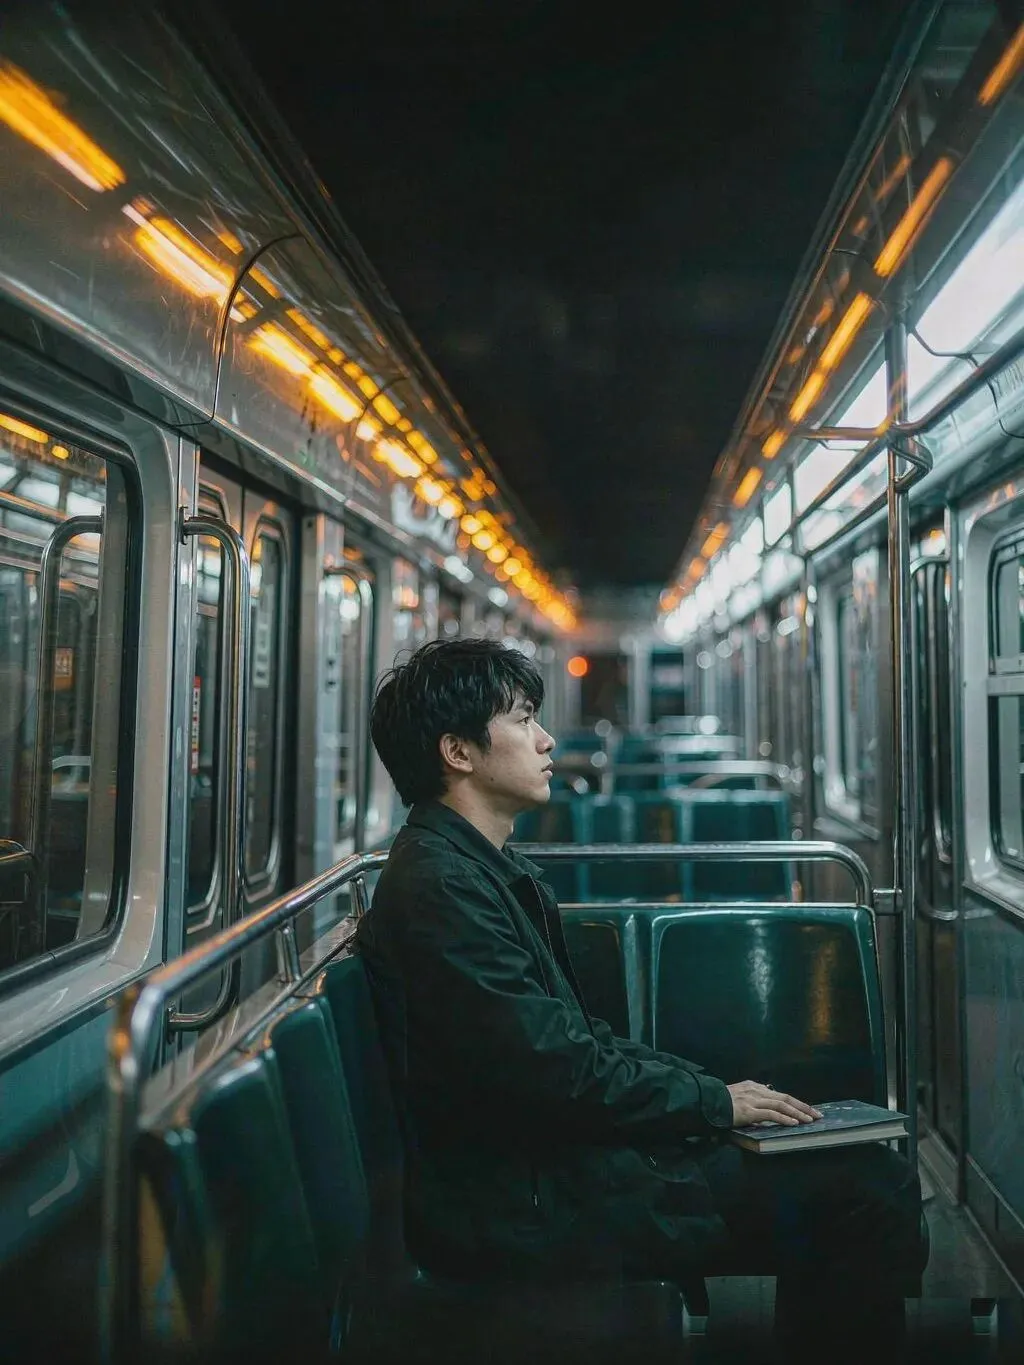
教程演示里生成的正文图,就是这种感觉
第四步:配音和字幕,最笨的办法
配音有两种做法,我选了最笨的那种。
打开剪映,新建一个文本,把文案整段粘进去,然后在「朗读」里挑了个港风男声。
这个声音有种被生活磨过的感觉,配我那段文案刚好。
导出时只勾音频,别勾视频。
另外单独做了一句:「今天要分享的是」,留作片头用。
第二种方式是用火山引擎的语音合成,音色选磁性解说男声,可以直接无水印下载。两条路都通。
字幕这一环我觉得是整个流程里最聪明的设计。
用两个工具配合:一个负责测出旁白里每一句的真实停顿,另一个只用来核对音频念的是什么,不能拿识别出来的文字当字幕。
还有一条规矩我记了很久:书名只用在片头口播,不生成底部字幕。
因为书名一旦做成字幕,画面上部的排版就全乱了。
第五步:素材怎么拼成一条视频
到这一步,我手里是:一份文案、一条正片配音、一条片头音频、四张图、还有每句台词的时间戳。
拼成片子用的是 HyperFrames。博主说它相当于你 agent 里的剪映。
我第一反应是「完了,我不会用」。
他接着说了句让我放松的话:你不用会用它,只要把这段指令复制过去就行。
画幅我设的是 720×960,也就是 3:4。
动画顺序也定死了:先片头,然后淡入前段,再切中段,最后是后段。书名作者放在固定位置,字幕在下方。
片头要提前准备七张素材:六张图片,一张背景音乐,一个齿轮音效,再加一张碎片图。
六张图对应六本书的书名和作者,轮换切换,这就是很多书单视频开头的滚动效果。
博主说了句我立刻记住的话:片头做一次就够了,以后每次直接调用。
我做到这里卡了两次。一次是背景音乐没被找到,重新拖了一次才认;一次是图的名字和提示词对不上,AI 找不到素材。
这两个坑都不难,但没人提前说,你会怀疑是自己哪步做错了。
做完那一刻,我把手机扣在桌上
最后一步,才是那个「焚诀」
到这里,一条片子已经能播了。
但真正让我坐直的是最后一句话。
博主说,你现在跟 AI 说一句:把我们刚才生成视频的整个过程做成 skill。
以后你只需要输入书名,打开窗口输进去,剩下的它自己跑。
他还补了一句:有了这个 skill,你可以同时开多个窗口,无限地生成视频。
我一开始以为这一步有多神。真做完才明白,它能成立,是因为前面每件小事都做得足够具体。
「片头、前段、中段、后段」这个命名具体到不会歧义。「书名不做底部字幕」这种细节具体到不会出错。
AI 不是靠一句「帮我做视频」学会的。它是靠你把流程切得足够细,才能学会。
所以博主最后那句话我觉得最值钱:
整个过程学的不是一条书单视频,而是学会用 AI 做视频的生产逻辑——先生产内容,再生产素材,最后根据时间轴去组装。
学会这个逻辑,换任何一个赛道都能用。
卡住的时候别急着放弃,天亮之前总能做完
说三句实话。
第一句:这件事我做了三个多小时,中间卡了两次。第一次做不可能十分钟搞定。
第二句:它不是「点一下就有钱」的东西。它只是把做视频这件事,从「我不会」变成了「我照着走能走完」。
第三句:价值不在视频本身,在于你走完一遍之后,手里多了一个可以复用的流程。
我把这次从建项目到导出成片的完整流程,每一步该复制哪句话、卡住怎么办,整理成了一份能直接照着走的文档。
想要的在评论区留 「书单」 两个字我看到就发给你。