ARTICLE · 1137847
【统计分析软件SPSS】189、时间序列分析——使用专家建模器构建模型(结果解读)
本系列文章(基于SPSS 31版本)配套数据可通过百度网盘获取:
链接:https://pan.baidu.com/s/1AGizNngKrzAVapWtNcc-VA?pwd=mnsj提取码:mnsj
https://www.mizhushare.com/docs/
在前一篇文章中,我们已经完成了使用「专家建模器」构建模型的菜单操作。
【统计分析软件SPSS】188、时间序列分析——使用专家建模器构建模型(操作步骤)
本文将在前一篇文章的基础上逐表拆解使用「专家建模器」构建模型的输出图表。
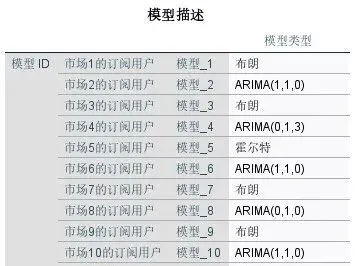
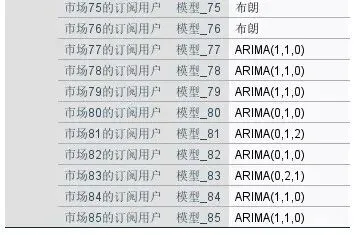
输出结果一:模型描述
该表格展示了使用专家建模器为每一条序列构建的时间序列模型的详细信息。本次共包含以下三种模型类型:
ARIMA模型 | 自回归积分移动平均模型,是最灵活的时间序列模型。参数含义如下:
|
布朗模型 | 一种指数平滑法,它通过给近期的观测值赋予更高的权重来预测未来值,其核心思想是“最近的数据更重要”。适用于具有线性趋势但没有明显季节性的数据。 |
霍尔特模型 | 也是一种指数平滑法,但它比布布朗模型更复杂,因为它同时考虑了水平(level)和趋势(trend)两个分量。霍尔特模型可以捕捉到随时间变化的线性趋势,并且能够适应趋势的变化。 |
在本次示例中,模型描述结果表明:
不同市场对应的最优预测模型存在明显差异,说明各市场订阅用户序列具有不同的时间序列特征。
ARIMA(0,1,0) 模型出现频率较高,表明多数市场序列在一阶差分后呈现近似随机游走特征,即当前期数值主要由前一期数值及随机扰动决定。
霍尔特指数平滑模型出现次数较少,说明仅有少数市场的订阅用户数量呈现较为明显且稳定的线性趋势结构。
部分市场采用了高阶 ARIMA 模型(如 ARIMA(0,1,5)),表明这些序列内部存在较为复杂的相关结构,需要通过高阶移动平均项来刻画其动态变化特征。
输出结果二:平均绝对误差百分比 直方图
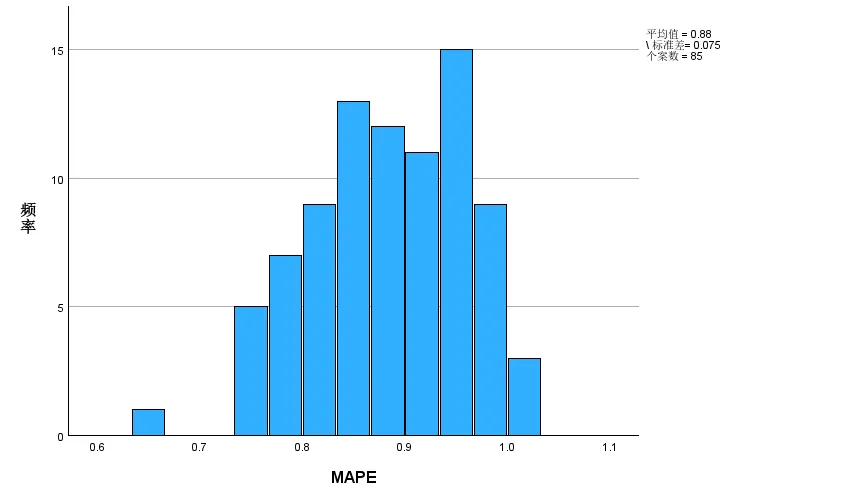
该直方图显示了所有模型的平均绝对误差百分比 (MAPE),直观地展示了所有模型在拟合历史数据时预测精度的分布情况。其中,横轴 (X轴)表示 MAPE 的取值范围;纵轴 (Y轴):表示频率,即在该 MAPE 区间内的模型数量。
MAPE表示预测值与真实值之间的平均偏差占真实值的百分比。数值越小,说明模型的预测精度越高。其计算公式为:
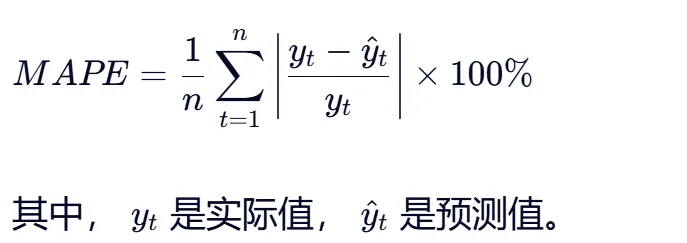
在本次示例中,平均绝对误差百分比(MAPE)直方图显示:
整体预测精度高:所有市场的平均预测误差(MAPE)为0.88%,表明专家建模器构建的模型能够非常精确地捕捉到历史数据的模式。
模型性能高度一致:标准差较小(0.075),说明不同市场的模型质量差异不大,不存在某些市场模型严重失准的情况,体现了模型选择过程的稳健性。
输出结果三:最大绝对误差百分比 直方图
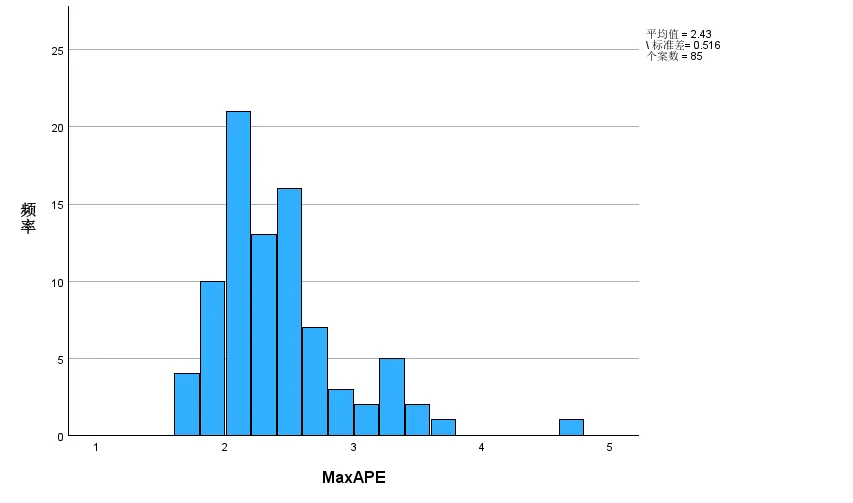
该直方图显示了所有模型的最大绝对百分比误差 (MaxAPE),这对于设想预测的最坏情况非常有用。其中,横轴 (X轴)表示 MaxAPE 的取值范围;纵轴 (Y轴)表示频率,即在该 MaxAPE 区间内的模型数量。
MaxAPE表示在所有历史预测点中,预测值与真实值之间的最大绝对百分比误差,是衡量单次预测最坏情况误差的指标,揭示了模型在某一个特定时间点上可能出现的最严重预测失误,反映了预测结果的稳健性和风险上限。其计算公式为:
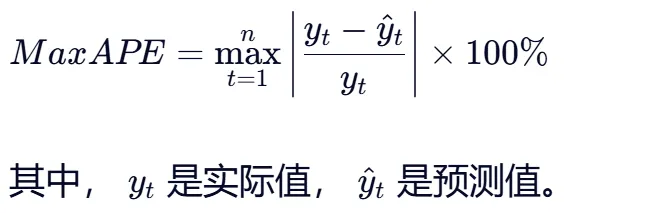
在本次示例中,最大绝对误差百分比(MaxAPE)直方图显示:
各市场模型的最大百分比误差主要分布在 1%~5% 的范围内,说明在最差预测情形下,模型误差总体处于有限区间内。
需要注意的是,误差是否属于可接受范围,取决于具体应用目的和业务需求。由于不同业务问题对预测误差的容忍程度不同,因此需要结合实际决策背景,运用商业判断来确定模型结果是否满足使用要求。
输出结果四:模型拟合度
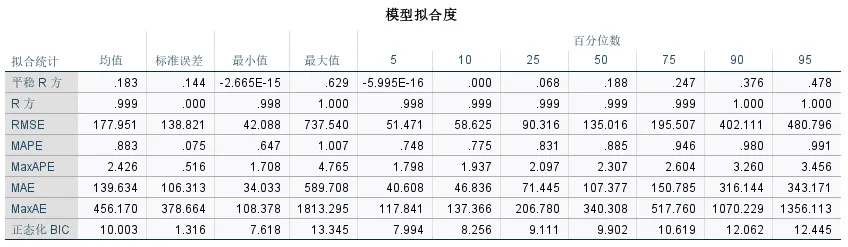
该表是专家建模器输出中的「模型拟合度」汇总表,它不是针对某一个序列,而是对全部序列(本次为85个市场)模型的拟合效果进行总体统计。
在本次示例中:
平稳R方:平均值较低(0.183),说明差分后的序列中,模型能解释约18.3%的变异。这属于正常现象,因为平稳R方通常不高,尤其是在序列接近随机游走时。
R方:拟合极好,说明模型几乎完全捕捉了历史数据的变动趋势。但需注意过拟合风险。
RMSE(均方根误差):平均误差约178个用户,但不同市场规模差异大(最小值42,最大值738)。
MAPE(平均绝对百分比误差):预测精度较高,平均误差不到1%,说明绝大多数模型的平均预测误差非常小,且性能高度一致。
MaxAPE(最大绝对百分比误差):均值为2.426%,95%分位数为3.456%。这意味着即使在最坏的情况下,约95%的模型其最大预测误差也不会超过3.456%
MAE(平均绝对误差):与RMSE类似,但受极端值影响小。平均误差约140个用户。
MaxAE(最大绝对误差)::某些市场在某个时点预测偏差较大(最大达1813用户),但结合MAPE看,这可能是由于该市场规模较大。
正态化BIC(贝叶斯信息准则):BIC值相对集中,说明专家建模器在选择模型时,有效地平衡了模型的拟合优度和复杂度,避免了过度拟合。
虽然模型拟合度表格报告了多种统计量,但一般重点关注MAPE(平均绝对百分比误差)和MaxAPE(最大绝对百分比误差)两项。绝对百分比误差用于衡量因变量序列与其模型预测水平的偏离程度,反映了预测中的不确定性。
输出结果五:模型统计
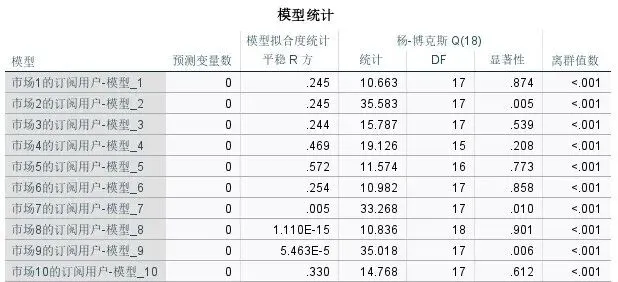
该表展示了每个序列模型的拟合质量与残差检验结果。
模型 | 模型的完整名称,包含因变量(如“市场1的订阅用户”)和模型ID(如“模型_1”)。 |
预测变量数 | 模型中包含的自变量数量。在本例中,所有值均为 0,表明这些模型都是纯时间序列模型,仅使用历史的因变量自身来预测未来值,没有引入外部协变量。 |
模型拟合度统计 平稳 R 方 | 如前所述,衡量模型对差分后时间序列的解释能力。由于大多数模型都进行了差分(d=1),这个指标反映了模型对去趋势后的波动部分的拟合优度。数值越高越好,但通常不高。 |
杨-博克斯 Q(18) 统计 | Ljung-Box Q检验统计量,用于检验时间序列残差中是否存在显著的自相关性。其原假设(Null Hypothesis)是:残差序列不存在自相关性,即残差是白噪声。 |
DF | 自由度,通常等于模型的滞后阶数加上差分阶数。 |
显著性 | Ljung-Box Q检验的p值。这是判断检验结果是否显著的关键。
|
离群值数 | 模型在估计过程中检测到的离群值(Outliers)的数量。 |
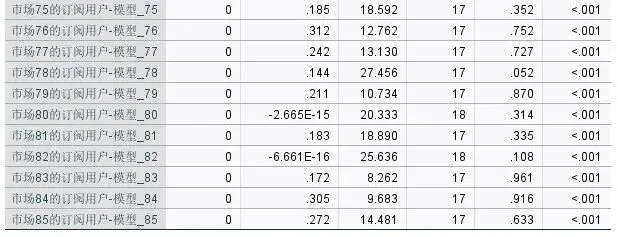
在本次示例中,模型统计揭示了以下信息:
模型普遍有效:绝大多数模型的 Ljung-Box Q检验p值大于0.05,表明它们的残差是随机的,模型成功地提取了数据中的可预测信息,符合良好的时间序列建模标准。
存在个别问题模型:少数模型的p值小于0.05,提示这些模型可能存在不足。后续可以进一步检查这些市场的数据,查看是否有特殊的事件、数据录入错误或需要更复杂模型的情况。
输出结果六:预测表
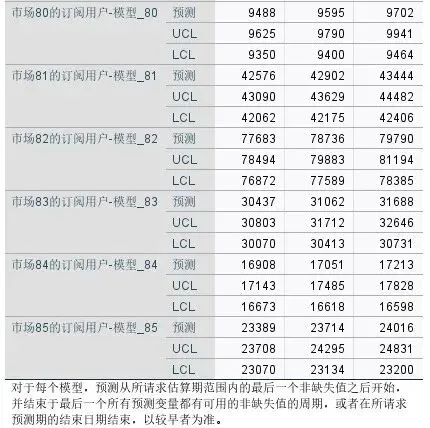
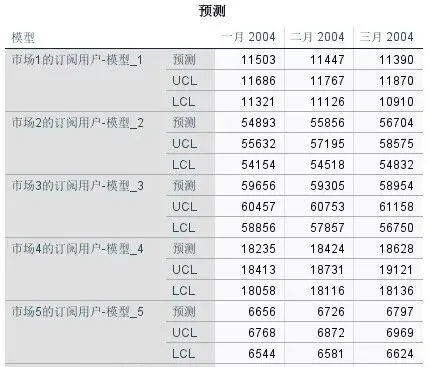
该表格仅包含预测期(本例中为2004年1月至3月)的预测值,其核心价值在于提供结构化、按模型组织的未来预测信息。与保存在数据编辑器中的新变量(如,预测_Market_1_模型)不同,此表格不包含估计期(即历史拟合期),仅聚焦于未来时段的预测。
结果按模型组织,并通过模型名称进行标识,模型名称由关联的因变量名称(或标签)及模型标识符组成(与包含模型预测值的新变量名称结构一致)。该表格还同步给出了95%置信水平(默认)下的上置信限(UCL),从而量化了预测的不确定性。例如,市场1在2004年3月的预测值为11390,但真实值有95%的概率落在[10910, 11870]区间内。
至此,我们已掌握获取预测结果的两种互补方式:
将预测值作为新变量保存在活动数据集中——便于后续在SPSS内部进行数据操作、图表绘制或与其他变量联动分析; 生成独立的预测表格——便于快速查阅、报告展示或直接导出。
............