WorkBuddy这类办公AI能读材料、拆任务、交成果。企业需要自建AI助手时,问题就变了:工具怎么接,流程怎样暂停,文档放在哪里,谁来确认结果?
LangChain、LangGraph、Deep Agents提供的是不同层的开发能力。这篇用同一份虚构资料,分别跑通工具问答、人工确认和文件交付,帮你看清该从哪层开始。
适合已会基础Python、想从使用办公智能体走向开发Agent的读者。资料、产品设定和工作区数量均为教学虚构,不对应实际企业项目。下面提供完整代码和运行预期。
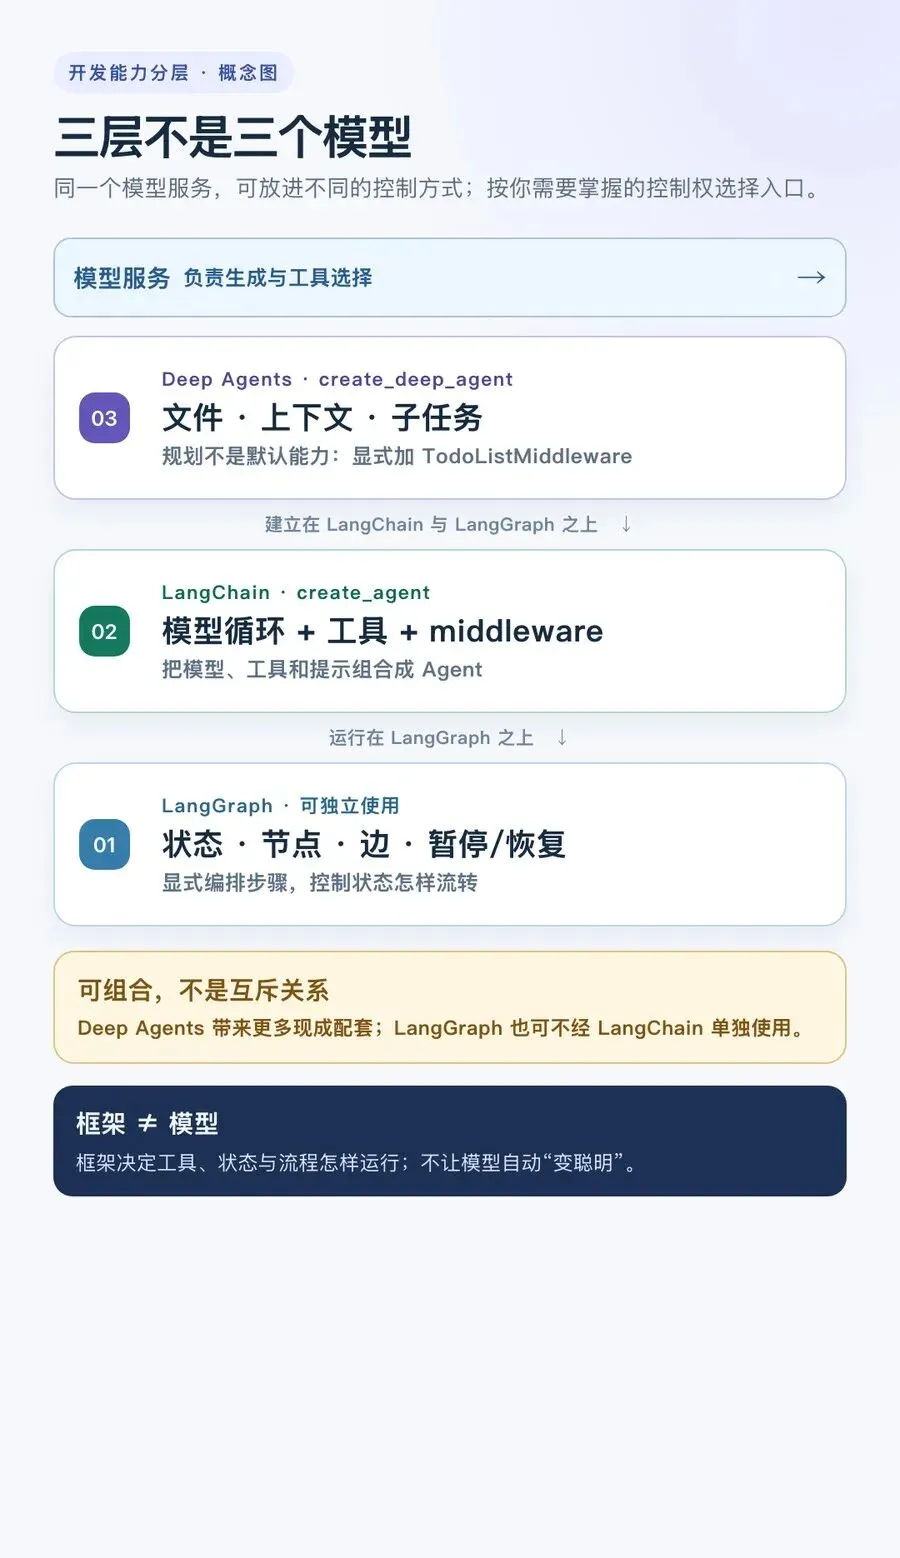
三层可组合,WorkBuddy是产品切入,不是其底层架构揭秘
一、先把三层关系放对位置
WorkBuddy是面向用户的成品工作台。腾讯官方说明它能围绕自然语言任务规划步骤、调用工具并交付成果。本文借这种使用体验提出开发问题,没有证据表明它的底层采用下面这三套框架,也不做其SDK接入教程。
三个名字之间的关系,可以从底层往上看。
LangGraph:运行时与编排。你定义状态、节点和边,决定工作经过哪些步骤;它负责执行这些步骤,也提供暂停、恢复和流式输出等机制。
LangChain:可组合的Agent。 create_agent把模型、工具、提示和middleware组合成一个模型循环,底层运行在LangGraph上。middleware是围绕循环插入行为的组件,例如人审或额外检查。
Deep Agents:带更多现成能力的harness。 harness可以理解为模型外面的执行配套。它在LangChain和LangGraph之上,组合文件工具、上下文管理和子任务等能力。
这不是三个互斥模型,也不是“换成Deep Agents,模型就更聪明了”。同一个模型可以放进不同的执行方式;LangGraph也可以独立使用,不必先创建LangChain Agent。
后面三个实现,变化的是控制权与交付方式,材料保持一致。
二、准备环境与同一份虚构材料
案例是一个虚构笔记工具。我们要根据两份自行编写的演示说明,回答支持哪些导出格式、团队能建多少工作区,再写一份上手指南。
材料很小,也不联网搜索。这样可以先确认代码、工具和状态有没有接对,避免把检索问题和框架问题混在一起。
本文实际安装并验证的环境为Python 3.12,依赖固定如下。新建一个独立目录lc-stack-demo,把这一段保存为requirements.txt:
langchain==1.4.3langgraph==1.2.14deepagents==0.7.23langchain-anthropic==1.7.5使用uv的读者可以这样安装:
mkdir lc-stack-democd lc-stack-demouv venv --python 3.12source .venv/bin/activateuv pip install -r requirements.txt先建目录并保存依赖文件,再执行安装。下面四个Python文件都放在这个目录,文件名不要改。
两种运行方式先说明
所有示例都有 --offline模式。它使用脚本化模型替身,交回预设的工具调用和文本,让真实框架执行工具、保存状态或触发中断。
我实际跑的是这个模式。因此,下文能确认依赖和执行路径跑通,但不能据此宣称真实模型理解正确、能自动完成任意任务,或者具有某个准确率。
接真实模型时,不加 --offline;代码读取DEMO_MODEL,并通过init_chat_model初始化服务商适配器。本文安装了对应的模型适配包,其他服务商需要换装其适配包。
例如选择你有权限使用的模型,并在本机受控环境中设置密钥。bash或zsh可用下面的静默输入方式,输入结束后按回车;不要把密钥写进代码或截图:
export DEMO_MODEL=\"anthropic:claude-haiku-5-5"read -r -s ANTHROPIC_API_KEYexport ANTHROPIC_API_KEYAPI用量费用另行计算。模型需要支持工具调用;服务商权限、兼容性、实际效果仍要用自己的账号验证。
公共材料与模型入口
把下面完整保存为common.py。get_doc通过封闭的资料ID读取虚构原文;它不是靠关键词猜用户意图的路由器。模型决定要用什么工具,代码核验工具参数。
"""Shared offline fixtures for the three LangChain stack demos."""import osfrom typing import Any, Literalfrom langchain.chat_models import ( init_chat_model,)from langchain_core.language_models import ( BaseChatModel,)from langchain_core.messages import ( AIMessage, BaseMessage,)from langchain_core.outputs import ( ChatGeneration, ChatResult,)from langchain_core.tools import toolNOTES = { "overview": ( "示例笔记工具支持Markdown和PDF导出;" "团队方案最多 " "20个工作区;同步不等于备份。" ), "export": ( "PDF导出:选笔记→导出→PDF;" "共享默认受邀可见;" "没说明离线同步。" ),}READS: list[str] = []@tooldef get_doc( doc_id: Literal["overview", "export"],) -> str: """Read one approved fictional note by its closed document ID.""" READS.append(doc_id) return NOTES[doc_id]def live_model() -> BaseChatModel: """Build the provider-neutral model named by DEMO_MODEL.""" model_name = os.environ["DEMO_MODEL"] return init_chat_model(model_name)class ScriptedModel(BaseChatModel): """Deterministic double: validates flow, not intelligence.""" replies: list[AIMessage] index: int = 0 bound_tools: list[Any] = [] prompts: list[str] = [] tool_results: list[str] = [] @property def _llm_type(self) -> str: return "scripted-demo" def bind_tools( self, tools: Any, **_: Any ) -> "ScriptedModel": self.bound_tools = list(tools) return self def _generate( self, messages: list[BaseMessage], stop: list[str] | None = None, run_manager: Any = None, **_: Any, ) -> ChatResult: if self.index >= len( self.replies ): raise RuntimeError( "ScriptedModel replies are exhausted" ) tool_name = getattr( messages[-1], "name", None ) if tool_name: self.tool_results.append( tool_name ) last_content = str( messages[-1].content ) self.prompts.append(last_content) reply = self.replies[self.index] self.index += 1 generation = ChatGeneration( message=reply ) return ChatResult( generations=[generation] )def offline_chain_model() -> ( ScriptedModel): """Ask for overview once, then produce a deterministic answer.""" return ScriptedModel( replies=[ AIMessage( content="", tool_calls=[ { "name": "get_doc", "args": { "doc_id": "overview" }, "id": "note-1", } ], ), AIMessage( content=( "工具支持Markdown/PDF导出;" "团队方案最多20个工作区;" "同步不等于备份。" ) ), ] )def offline_draft_model() -> ( ScriptedModel): """Return a text draft for the graph-only offline path.""" return ScriptedModel( replies=[ AIMessage( content=( "草稿:Markdown/PDF导出," "20个工作区;同步不等于备份。" ) ), AIMessage( content=( "草稿:Markdown/PDF导出," "20个工作区;同步不等于备份。" ) ), ] )ScriptedModel只用于本教程的离线结构测试。真实请求走live_model,不会因为用户写了某个词就套用这些预设回答。
三、LangChain:先让模型自己选择工具
第一种需求很简单:用户问一个问题,模型判断需要哪份说明,调用工具后根据原文回答。
你不必亲自安排“先读overview,再写答案”每一步。create_agent管理模型与工具之间的循环;你提供工具、提示和模型。
把下面保存为demo_chain.py:
"""LangChain agent: the model chooses one read-only tool call."""import argparsefrom langchain.agents import create_agentfrom langchain_core.messages import ( HumanMessage,)from common import ( READS, get_doc, live_model, offline_chain_model,)def build(model=None): """Create an agent; the model, not keywords, selects tools.""" return create_agent( model or live_model(), tools=[get_doc], system_prompt=( "Read approved notes only. Never export or write." ), )def run(offline=False): """Print a trace and the final agent message.""" READS.clear() model = ( offline_chain_model() if offline else None ) agent = build(model) prompt = "Prepare a guide from the approved overview." message = HumanMessage(content=prompt) state = agent.invoke( {"messages": [message]} ) trace = [ getattr( m, "name", type(m).__name__ ) for m in state["messages"] ] print("TRACE", trace, "read=", READS) final = state["messages"][-1].content print("RESULT", final)if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument( "--offline", action="store_true" ) run(parser.parse_args().offline)然后运行:
python demo_chain.py --offline怎样看出它真的经过工具
不能只看最后一句话。输出的TRACE应显示get_doc被调用,资料ID为overview;结果应该引用该资料里的信息,而不是把没有的功能编出来。
离线脚本会按预设轨迹走。切换到真实模型后,工具顺序和答案措辞可能变化,应检查消息中的tool_calls和对应工具结果。
这个实现适合可用工具少、边界清楚、最终回答能回读材料核验的助手。随着需求增加,可以加入更多工具或middleware;但工具列表变长,不自动意味着任务完成率更高。
如果业务要求“未经人确认,后续步骤绝不能执行”,仅在提示里写一句“记得问人”,还不足以构成一个执行门禁。下一层要把这个约束放进流程。
四、LangGraph:把确认点写成会停住的节点
第二种需求仍是写上手指南,但流程必须明确:读取材料、生成草稿、暂停给人看,批准后保留;拒绝就结束,不把草稿当成已接受成果。
这里我们亲自定义图。
State是贯穿流程的数据。Node是一个步骤。Edge连接步骤。模型负责写草稿,是否批准则由明确的外部决定控制,不让模型替人决定。
保存为demo_graph.py:
"""LangGraph: read, draft, pause for approval, then keep or reject."""import argparsefrom typing import TypedDictfrom langchain_core.messages import ( HumanMessage,)from langgraph.checkpoint.memory import ( InMemorySaver,)from langgraph.graph import ( END, START, StateGraph,)from langgraph.types import ( Command, interrupt,)from common import ( get_doc, live_model, offline_draft_model,)class GuideState(TypedDict, total=False): query: str note: str draft: str result: strdef build(model=None): """Build a graph; side effects belong after approval.""" model = model or live_model() def read(state): note = get_doc.invoke( {"doc_id": "overview"} ) return {"note": note} def draft(state): reply = model.invoke( [ HumanMessage( content=( f"Question: {state['query']}\n" f"Approved note: {state['note']}" ) ) ] ) return {"draft": reply.content} def approve(state): payload = { "draft": state["draft"] } answer = interrupt(payload) if not isinstance(answer, dict): raise ValueError( "Approval must be a dict with approve: bool" ) if set(answer) != {"approve"}: raise ValueError( "Approval only accepts the approve field" ) if ( type(answer["approve"]) is not bool ): raise ValueError( "Approval approve must be a bool" ) result = ( state["draft"] if answer["approve"] else "" ) return {"result": result} graph = StateGraph(GuideState) graph.add_node("read", read) graph.add_node("draft", draft) graph.add_node("approval", approve) graph.add_edge(START, "read") graph.add_edge("read", "draft") graph.add_edge("draft", "approval") graph.add_edge("approval", END) saver = InMemorySaver() return graph.compile( checkpointer=saver )def run(offline=False, approve=None): """Show the interrupt, then resume the same in-process thread.""" model = ( offline_draft_model() if offline else None ) app = build(model) thread = {"thread_id": "cli-guide"} config = {"configurable": thread} initial = {"query": "make a guide"} first = app.invoke(initial, config) paused = app.get_state(config).values[ "draft" ] print( "TRACE paused=", bool(first.get("__interrupt__")), paused, ) if approve is None: print( "RESULT paused: use " "--approve or --reject to resume" ) return first if type(approve) is not bool: raise ValueError( "approve must be bool or None" ) resume = Command( resume={"approve": approve} ) final = app.invoke(resume, config) print( "RESULT", final.get("result", "<rejected>"), ) return finalif __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument( "--offline", action="store_true" ) choice = parser.add_mutually_exclusive_group() choice.add_argument( "--approve", action="store_true" ) choice.add_argument( "--reject", action="store_true" ) args = parser.parse_args() approve = ( True if args.approve else False if args.reject else None ) run(args.offline, approve=approve)先只观察暂停:
python demo_graph.py --offline这轮应出现interrupt,显示待确认草稿,并停在确认点。没有明确批准时,不应直接输出已接受的result。
为了在同一个进程内演示恢复,可以显式传入决定:
python demo_graph.py --offline --approvepython demo_graph.py --offline --reject这两个命令分别从头创建一次演示。每次内部先中断,再用同一thread_id和Command(resume=...) 恢复;它们不是跨进程找回上一次的状态。
两个决定恢复是否可靠的细节
第一,thread_id是这轮状态的定位依据。恢复必须对应原线程,不能随便换一个编号,再期待读到旧草稿。
第二,interrupt所在节点恢复时会从头再执行。发消息、扣款或写业务记录等副作用,如果无条件放在interrupt前面,就可能重复发生。生产工具还需要自己的幂等和权限约束。
这个例子把生成草稿与确认节点分开,所以恢复确认不会重新让模型生成一份不同的草稿。测试也检查了这一点。
另外,InMemorySaver只是进程内的检查点。进程退出,它不负责保存到硬盘。若要跨重启恢复,应换成适合环境的持久化checkpointer,并验证存储、身份和恢复流程。
LangGraph的价值就在这里:把“应该先确认”变成可观察、可验证的执行状态。代价是你要自己设计状态、节点、异常路径,以及数据结构与流转规则。
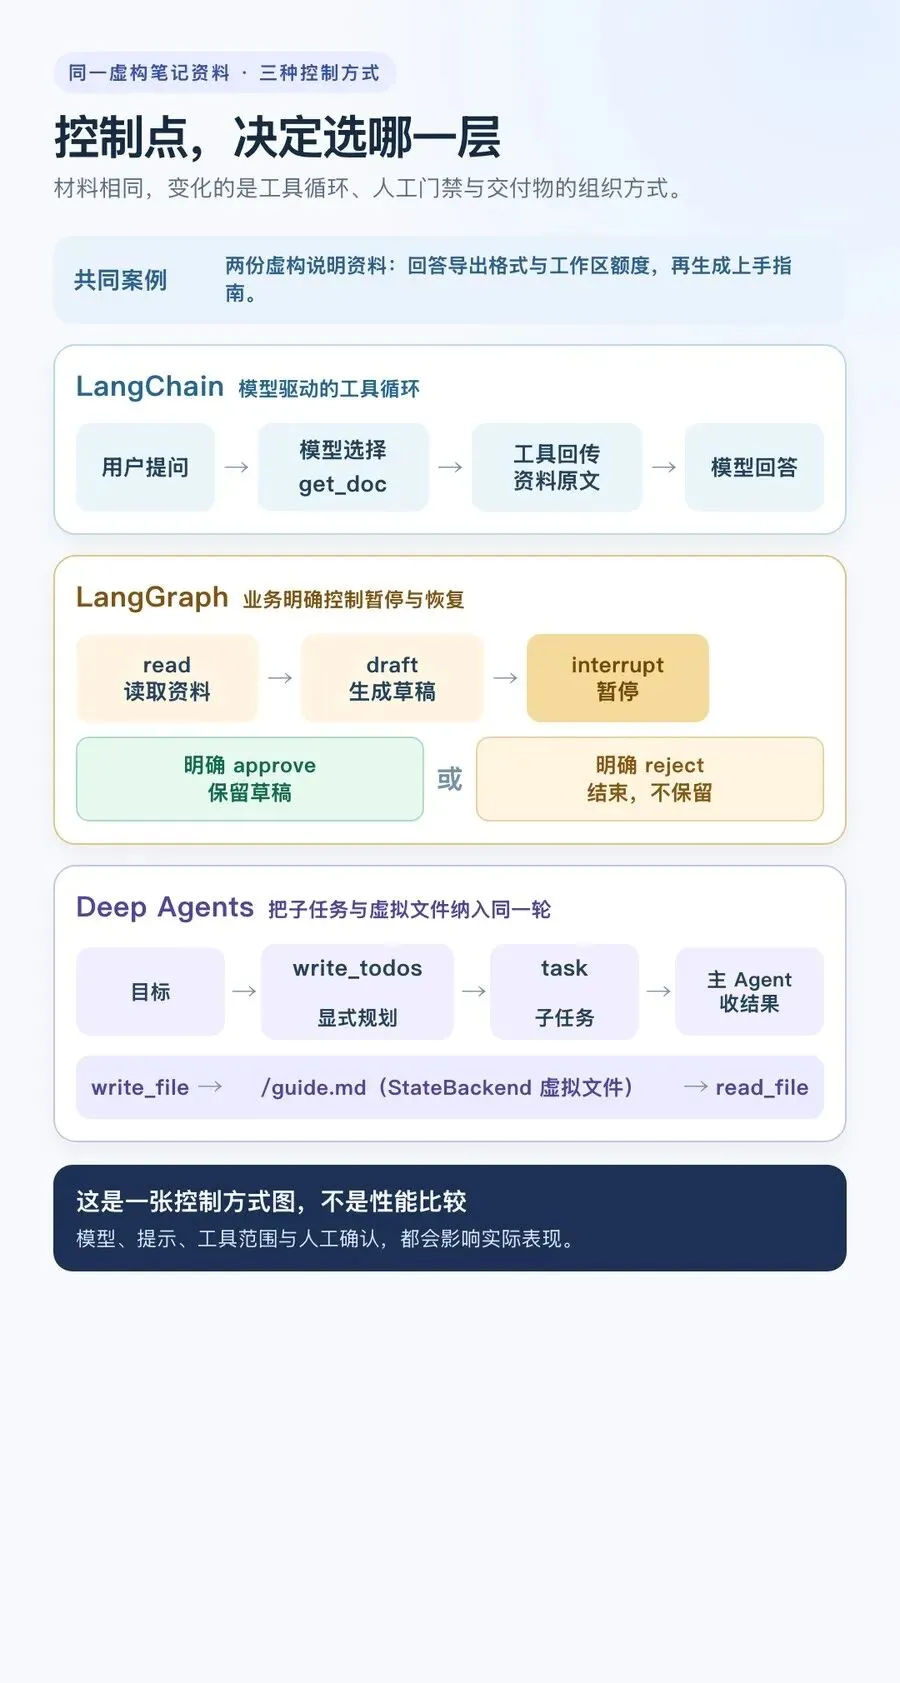
同一份虚构资料,比较工具循环、确认节点与文件交付
五、Deep Agents:让子任务和文件进入同一轮工作
第三种需求是,给出“写一份上手指南”的目标,让主Agent组织子任务,再把成果写成一份可读取的文件。
Deep Agents提供更多现成的执行配套。你可以给子Agent独立提示和工具,让它处理一段明确的工作,再把结果交回主Agent。主Agent不必把每个细节都挤在自己的对话里。
不过,这一节有两个版本细节必须说清。
规划不是本版本的默认能力。 Deep Agents 0.7起,任务规划改为可选。本例显式加入TodoListMiddleware,才让模型能调用write_todos。
默认文件不是你电脑上的文件。本例使用StateBackend:guide.md在这轮Agent的状态里。它便于存放中间材料,但不意味着真实磁盘上已经出现同名文档,也不自动等于跨进程长期记忆。
保存为demo_deep.py:
"""DeepAgents: plan, delegate, write state file, then read it."""import argparsefrom deepagents import create_deep_agentfrom deepagents.backends import ( StateBackend,)from langchain.agents.middleware import ( TodoListMiddleware,)from langchain_core.messages import ( AIMessage, HumanMessage,)from langgraph.checkpoint.memory import ( InMemorySaver,)from common import ( READS, ScriptedModel, get_doc, live_model,)def _call(name, args, call_id): return AIMessage( content="", tool_calls=[ { "name": name, "args": args, "id": call_id, } ], )def offline_models(): """Main delegates; the writer owns its scripted model.""" writer = ScriptedModel( replies=[ _call( "get_doc", {"doc_id": "overview"}, "note-1", ), _call( "write_file", { "file_path": "/guide.md", "content": ( "# Fictional guide\n\nMarkdown/PDF export; " "20 workspaces; sync is not backup." ), }, "write-1", ), AIMessage( content="guide.md is ready." ), ] ) main = ScriptedModel( replies=[ _call( "write_todos", { "todos": [ { "content": "write guide", "status": "in_progress", } ] }, "todo-1", ), _call( "task", { "subagent_type": "writer", "description": "Write the fictional guide to /guide.md.", }, "task-1", ), _call( "read_file", { "file_path": "/guide.md" }, "read-1", ), AIMessage( content="Guide was written and read from state." ), ] ) return main, writerdef build(model=None, writer_model=None): """Use ephemeral graph state, not the local filesystem.""" model = model or live_model() writer_model = writer_model or model return create_deep_agent( model=model, tools=[get_doc], backend=StateBackend(), checkpointer=InMemorySaver(), middleware=[TodoListMiddleware()], subagents=[ { "name": "writer", "description": ( "Reads notes and writes the fictional guide." ), "model": writer_model, "tools": [get_doc], "system_prompt": ( "Call get_doc for source facts, " "then write /guide.md. " "Do not invent product facts." ), } ], )def run(offline=False): """Run offline; live mode needs DEMO_MODEL credentials.""" main, writer = ( offline_models() if offline else (None, None) ) app = build(main, writer) READS.clear() prompt = "Plan, delegate, write, and read a fictional guide." config = { "configurable": { "thread_id": "cli-deep" } } state = app.invoke( { "messages": [ HumanMessage( content=prompt ) ] }, config, ) tools = [ m.name for m in state["messages"] if getattr(m, "name", None) ] content = state["files"]["/guide.md"][ "content" ] writer_results = ( writer.tool_results if writer else [] ) print( "TRACE", tools, "writer_read=", READS, ) print( "TRACE writer_results=", writer_results, ) print("RESULT", content)if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument( "--offline", action="store_true" ) run(parser.parse_args().offline)运行:
python demo_deep.py --offline这次验收看一份文件,而不只看一句完成了
TRACE应显示规划、task子任务和文件读取等操作。子任务中的write_file应把 /guide.md写回StateBackend;主流程再用read_file读回,输出完整内容。
如果只有聊天回复说“文档已保存”,但result中没有文件,就不能算文件交付成功。实际文件名与路径以代码为准,不把回复里的一句话当存储回执。
本例没有默认开放宿主机shell,也没有把你整个电脑目录交给Agent。要输出真实文件,可以由应用在确认结果后导出,或者配置适合场景的文件后端;后者是另一项权限与存储设计。
子Agent的上下文隔离,也不等于完整的安全沙箱。它是否能访问某个文件或外部工具,仍由你配置的工具、后端和权限决定。
六、企业要选哪层,看自己必须掌握什么
看完三个例子,可以按控制需求选择入口。
需要“模型自主选择几项工具并回答”,先用LangChain create_agent。需要“步骤明确、状态可查、在哪暂停由业务决定”,使用LangGraph。需要围绕目标组织文件、子任务和较长上下文,则可以从Deep Agents的现成配套开始。
Deep Agents不是必须从LangGraph开始学到最后才能用的“毕业版”。你可以直接使用,再逐步理解底层;也可以只用LangGraph,保持流程简单。
放进企业场景后,三个例子外还要补四件事。
身份与数据范围。当前人员或租户的身份由应用确认,再按该身份提供有权限的材料。不能让模型根据用户一句“我是管理员”就获得权限。
动作与审批。模型可以建议发送或更新,工具需要核验这次动作的授权和范围;审批决定还要绑定对应任务和成果,不能拿上一轮的批准覆盖新内容。
持久化与隔离。检查点、文件和跨会话记忆用途不同。线程ID也不是租户隔离方案,必须结合应用的认证、存储命名空间和访问控制。
结果与成本。记录输入、工具执行、确认、失败与最终产物。没有执行证据时,漂亮答案只能当草稿;调用费也要连同重试和人工复核一起看。
本文提供的是这些机制的开发起点。企业产品还需要服务部署、权限系统、持久存储和真实模型评估,不会因为三个脚本跑通就自动具备它们。
七、用一张检查单判断自己跟完了没有
这篇实际完成了依赖安装与无密钥的框架结构验证;真实模型的API调用、理解质量、延迟和费用没有在本次验证中覆盖。
你可以先按这组结果对照:
• LangChain:工具调用确实执行,非法资料ID被参数校验拒绝。
• LangGraph:先暂停;无批准不直接接受;明确批准与拒绝走不同结果;不同线程不串状态。
• Deep Agents:规划工具被显式加入,task子任务真实执行,虚拟文件写回并可读回。
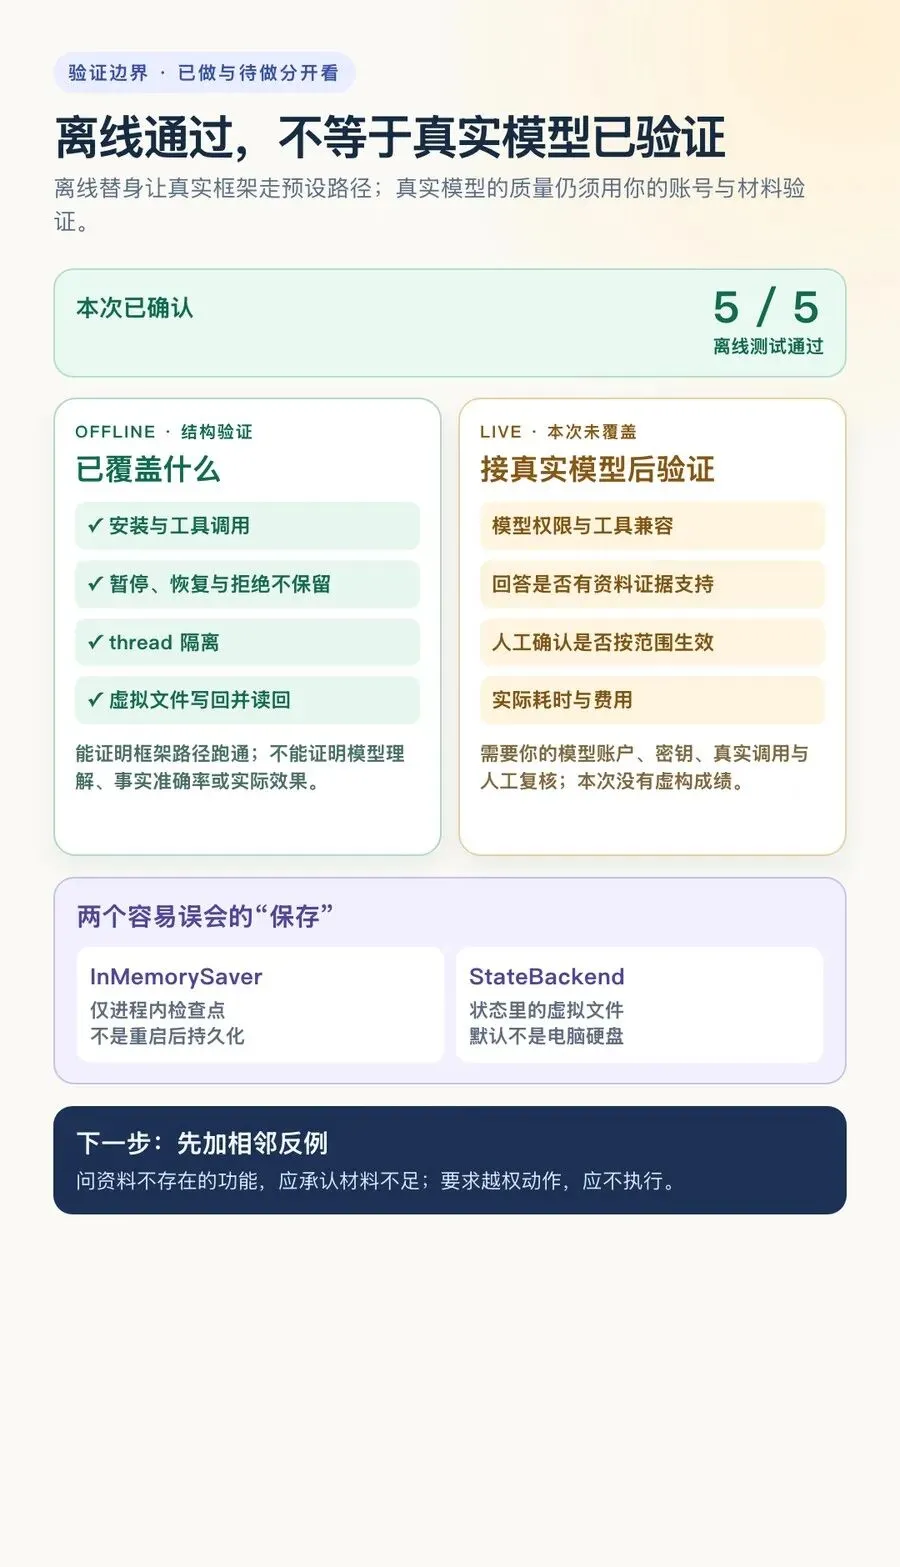
离线验证结构,真实模型仍需验证质量、权限与成本
再接真实模型,至少加两个相邻输入。一个问资料里不存在的功能,例如“是否支持离线同步”;另一个要求删除或发送等超出本例权限的动作。
前者应承认材料不足,后者应不执行。不能把所有失败都归因于框架,也不能把所有成功都归功于“多Agent”。回读模型输入、工具参数、实际结果和最后回答,才知道问题在哪。
遇到“导入报错”,先核对Python、依赖版本和工作目录。遇到“图没有暂停”,核对checkpointer、thread_id与interrupt。遇到“文件不在硬盘”,先看你是不是用了StateBackend。遇到“write_todos不存在”,看是否显式加了规划middleware。
第一次可以只完成LangChain那个例子。等你能看懂一次真实工具循环,再加确认点或文件交付。每次多学一层,是因为任务需要更多控制,而不是为了把所有技术名都放进架构图。
关注「AI落地手记」
真实工作流 · 工具拆解 · 可复用方法
如果这份三层技术教程对你有用,可以点一下「喜欢作者」,或者转发给正在搭AI工作流的朋友。