ARTICLE · 1155787
一个轻量级文档解析神器,CPU上也能飞速跑
RapidDoc 是一个轻量级开源文档解析框架,支持 OCR、版面分析、公式识别、表格识别,能把复杂 PDF 转成 Markdown、JSON、Word、HTML,CPU 上也能跑得飞快。
项目亮点
😺 RapidDoc 是一个轻量级、专注于文档解析的开源框架,能帮你把复杂的 PDF 文档转换成 Markdown、JSON、Word、HTML 格式。它基于 MinerU 二次开发,把 VLM 模块移除,专注在 Pipeline 产线下的高效文档解析。
✨ 核心能力一览:
🔍 OCR 识别 — 使用 RapidOCR 支持多种推理引擎,CPU 下默认用 OpenVINO,GPU 下默认用 torch
📐 版面识别 — 基于 PP-DocLayout 系列 ONNX 模型,支持 PP-DocLayoutV3(自带阅读顺序、支持异形框)、V2、plus-L、L、S 多个版本可选
🧮 公式识别 — 使用 PP-FormulaNet_plus 系列模型(L/M/S),支持配置只识别行间公式
📊 表格识别 — 多模型串联方案,先做表格分类(区分有线/无线表格),再进行针对性识别
📄 原生 Office 解析 — 支持 docx/doc、pptx/ppt、xlsx/xls 的原生解析,不依赖模型
解决什么痛点?
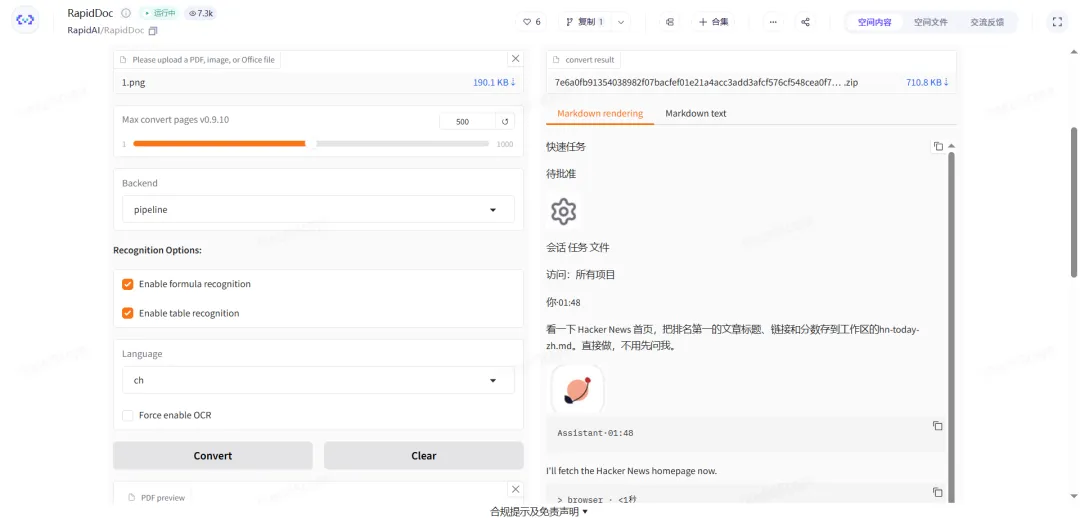
你有没有遇到过这样的情况:手头有一堆 PDF 论文、合同、报告,想要提取里面的文字、公式和表格,复制粘贴出来全是乱码,公式变成了一堆看不懂的符号,表格更是惨不忍睹……
😫 传统 OCR 工具要么只认文字不认版面,要么公式识别一塌糊涂,要么表格直接给你整成一坨。更别提那些扫描件里带旋转的页面了,识别出来全是歪的。
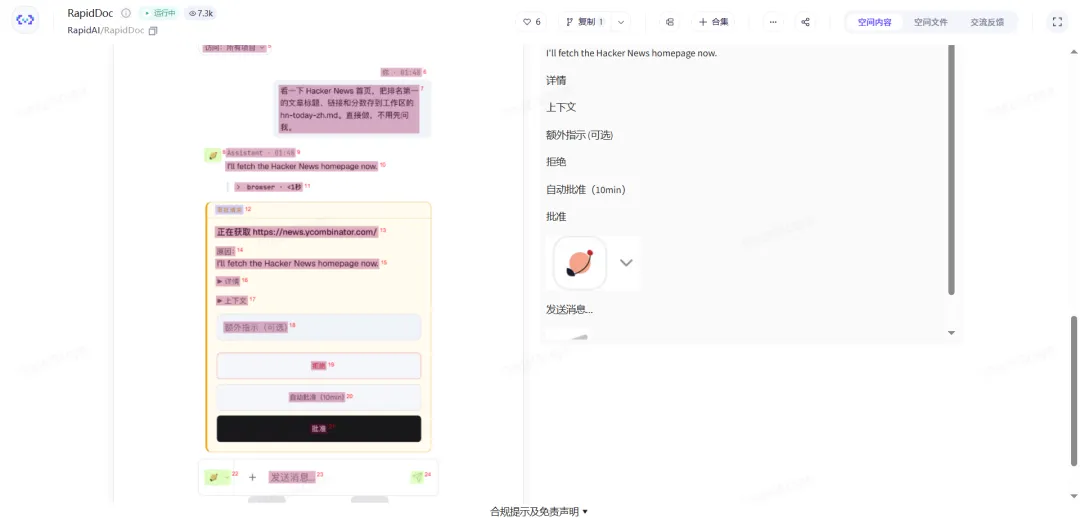
💡 RapidDoc 就是来解决这些问题的。它把 OCR、版面分析、公式识别、表格识别、阅读顺序恢复这些能力打包在一起,你只需要几行代码,就能把一份复杂的 PDF 变成结构清晰的 Markdown。而且它特别轻量,在 CPU 上也能保持不错的解析速度,不像某些方案非得配个大显卡才能跑。
更贴心的是,它还支持原生解析 Word、PPT、Excel 文件,不需要调用任何模型,直接提取内容。这意味着你处理日常办公文档时,速度会快得多。
手把手教程
安装
CPU 版本直接一行命令搞定:
pip install rapid-doc[cpu]如果你有 GPU,可以装 GPU 版本:
pip install rapid-doc[gpu]想从源码安装也简单:
git clone https://github.com/RapidAI/RapidDoc.gitcd RapidDocpip install -e .[cpu]快速上手
安装完之后,用起来非常简单:
importosfrompathlibimportPathfromrapid_docimportRapidDocroot=Path(__file__).resolve().parentoutput_dir=root/"output"doc_path_list= [root/"demo/pdfs/示例1-论文模板.pdf",root/"demo/docx/test.docx",]engine=RapidDoc()outputs=engine(doc_path_list, output_dir=output_dir)foroutputinoutputs:print(output.markdown)就这么几行,PDF 和 Word 文档就都被解析成 Markdown 了。输出的 RapidDocOutput 对象里包含 markdown、images、middle_json、content_list_json 等内容,你可以按需取用。
GPU 加速
如果你想用 GPU 跑,在导入 rapid_doc 之前设置一下环境变量就行:
import osos.environ["MINERU_DEVICE_MODE"] = "cuda" # 默认 cuda:0# os.environ["MINERU_DEVICE_MODE"] = "cuda:1" # 指定第二块 GPUGPU 包会自动安装 onnxruntime-gpu,记得确保你的 CUDA/cuDNN 环境跟 ONNXRuntime 的 CUDA execution provider 要求匹配。
自定义模型配置
RapidDoc 支持灵活配置各类模型。比如你想换一个版面识别模型,或者调整 OCR 引擎:
layout_config = {#"model_type": LayoutModelType.PP_DOCLAYOUTV3,#"engine_cfg": {'use_cuda': True, "cuda_ep_cfg.device_id": 0},}ocr_config = {#"engine_type": OCREngineType.OPENVINO,}formula_config = {#"model_type": FormulaModelType.PP_FORMULANET_PLUS_M,#"engine_type": FormulaEngineType.TORCH,#"engine_cfg": {'use_cuda': True, "gpu_id": 0},}它还支持自定义 OCR、公式、表格模型,只需要实现 CustomBaseModel 的 batch_predict 方法即可。目前已经内置了 PaddleOCR-VL 系列模型的集成。
Docker 部署
如果你不想折腾环境,RapidDoc 提供了 Docker 部署方案。镜像已经推送到 Docker Hub 了。
CPU 模式启动:
docker-compose -f docker-compose.yml up -dGPU 模式启动:
docker-compose -f docker-compose-gpu.yml up -d服务默认跑在 8888 端口。启动后可以先做个健康检查:
curl http://localhost:8888/health然后就能调用解析接口了:
curl-X POST "http://localhost:8888/parse"-F"file=@document.pdf"-F"mode=pipeline"Web API 服务
RapidDoc 还提供了一个基于 FastAPI 的 Web API 服务,完全兼容官方接口规范。你可以用 pip 装依赖后直接启动:
pip install rapid-doc fastapi uvicorn python-multipartpython app.py服务会在 http://localhost:8888 启动,API 文档在 http://localhost:8888/docs 可以访问。
调用 /file_parse 接口解析文件:
curl-X POST "http://localhost:8888/file_parse"-F"files=@document.pdf"-F"return_md=true"这个接口支持批量上传多个文件,还能选择返回 Markdown、中间 JSON、模型输出、内容列表、图片等多种格式。如果你的文档不是 PDF 而是其他格式(比如 Word、PPT、图片等),可以配合 Gotenberg 服务做转换:
docker run -d -p 3000:3000 gotenberg/gotenberg:8然后设置环境变量 GOTENBERG_URL 指向这个服务就行。
文本分块与定位
RapidDoc 还提供了文档分块和定位工具,可以在 Chunk 中添加坐标与所属页面信息。匹配时采用 RapidFuzz 找出最相似的 block。
安装分块和定位的依赖:
pip install tiktoken markdown rapidfuzz -i https://mirrors.aliyun.com/pypi/simple/使用示例可以参考项目里的 example_chunk.py、text_splitters.py 和 get_bbox_page_fast.py。
同类项目对比
RapidDoc 基于 MinerU 二次开发,移除了 VLM 模块,专注在 Pipeline 产线下的高效文档解析。默认模型主要来源于 PaddleOCR 的 PP-StructureV3 系列,并全部转换为 ONNX 格式,支持在 CPU/GPU 上高效推理。
如果你需要一个轻量、快速、开箱即用的文档解析方案,RapidDoc 值得一试。
🔗 项目地址:
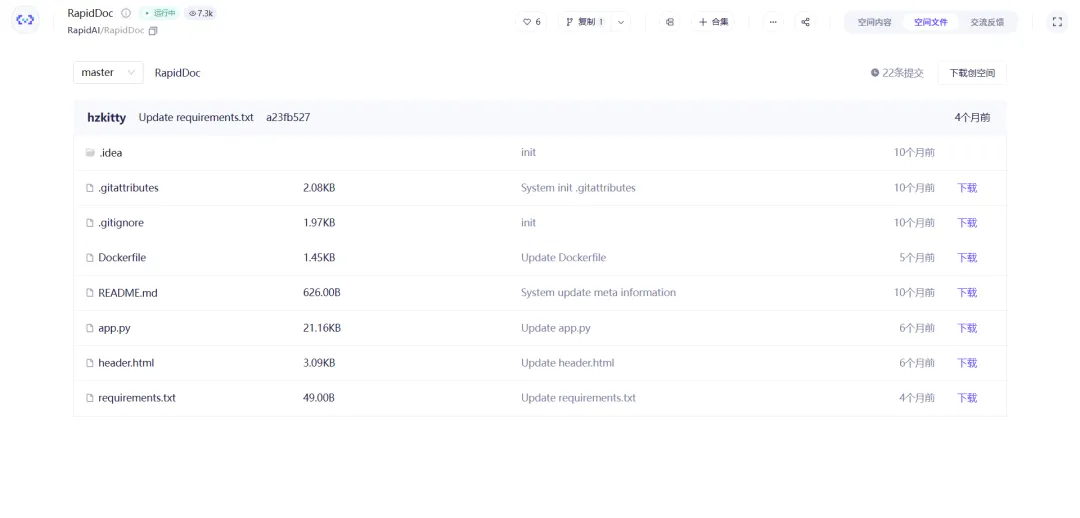
GitHub项目地址: https://github.com/RapidAI/RapidDoc
Gitee: https://gitee.com/hzkitty/KittyDoc
Docker Hub: https://hub.docker.com/r/hzkitty/rapid-doc
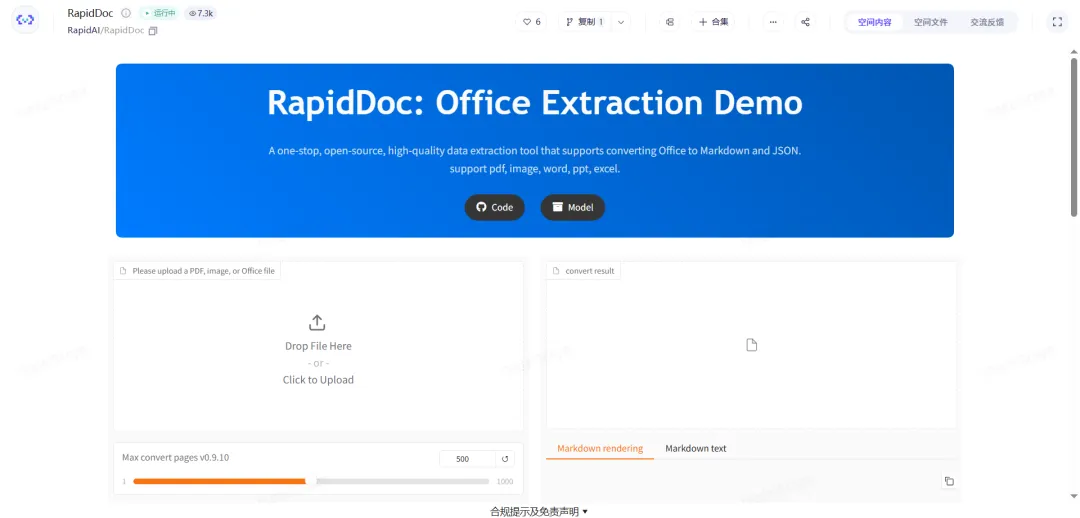
在线体验: https://www.modelscope.cn/studios/RapidAI/RapidDoc