ARTICLE · 1159253
Transect:追踪4份文档,核对Agent分工与风险
英国 AI Security Institute(AISI)在 Meridian Labs 支持下发布了一个名为 Transect 的开源 Python 包,基于 Inspect Scout 构建,官方定位是给做大规模智能体评测的人用。它解决的具体问题是:评测跑完往往只剩一个分数,而智能体到底尝试了哪些策略、在哪里卡住、怎么把工作委派给子智能体,这些都埋在很长的运行记录(transcript)里,靠人工通读耗时且依赖专业经验。对于自己跑过长链路 agent 任务的开发者和产品经理来说,这个痛点并不陌生。
它做什么:把 transcript 切成一条可查看的时间线
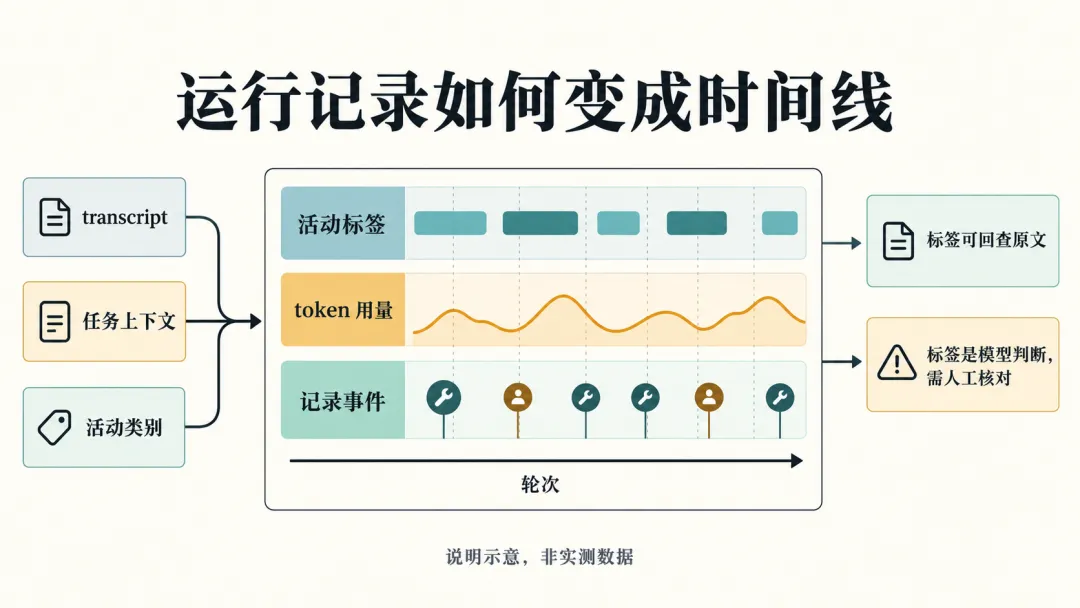
用 Transect 分析一次运行,需要准备三样输入:评测的 transcript、任务上下文,以及希望它区分的活动类别(例如实验设计、编码、数据分析)。任务上下文与类别可以在同一评测的多次运行之间复用。
Transect 会输出一份交互式报告,把活动标签、token 用量和记录到的事件(如人类消息、子智能体启动)放到同一条时间线上。时间线按“轮”索引——每一轮对应一次被记录的智能体输出,可能包含文本、工具调用或两者。活动标签由用户选定的 LLM-as-judge 完成;子智能体的类别则从它的委派指令中推断,官方明确指出这类标签描述的是“它被要求做什么”,不等于“它实际做了什么”。报告底层数据表可导出做进一步分析。
一个具体工作流:跟一篇文章如何在多个智能体之间流转
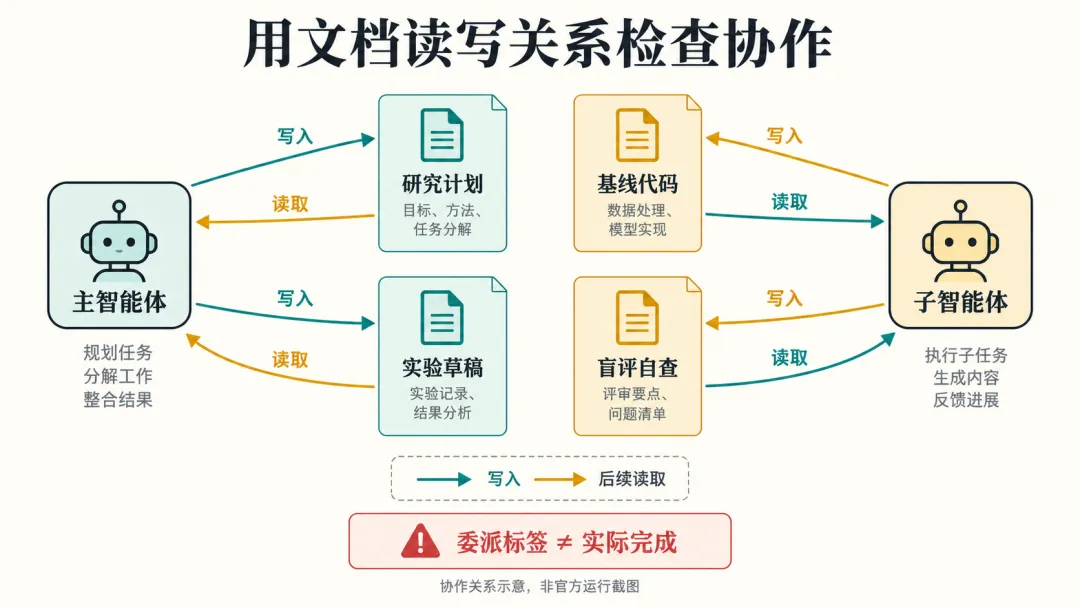
官方给出一个开放性研究评测的案例:主智能体有六天时间预算、充足算力,可以委派子智能体,任务是完成一项研究并写一篇论文。AISI 用 Transect 做了一次自定义分析,追踪四份文档——研究计划、基线代码、实验草稿、盲评自查——在主智能体与子智能体之间的读写关系,弧线把“某处写入”连到“之后被另一处读取”。
结果显示子智能体先围绕研究计划协作,再围绕实现计划的代码库协作;实验启动后,协作密集发生在实验设计与产出数据上。顺着这些访问点回到 transcript,就能检查主智能体是怎么委派工作的、任务执行过程中是否与子智能体保持沟通。对于需要多智能体通过共享文件系统同步或异步协作的评测,这类分析能把多智能体互动与人类介入、进度变化放在同一框架下解读。
三个设计取舍:可检查、可适配、可扩展
官方把 Transect 的设计拆成三个优先级。
可检查性指分析依据本身要能被审视。模型生成的标签直接链回 transcript 片段,并记录它们是如何产生的;当使用重复判定或多个 judge 模型时,能看到判定在哪些地方不一致。官方特别提醒:一致并不证明标签正确,但分歧能提示哪里值得细看。
灵活性指适配新评测的方式是替换任务上下文与类别定义,或加入自定义分析(上面那个共享文件分析就是例子)。
可扩展性指同一配置可应用到后续运行批量生成报告;标签与单次模型判定会被保存,重新打开分析不需要新的模型调用。但重跑同一次分析仍然需要保留 transcript、类别定义、设置、自定义分析代码与软件版本——即便这些全部一致,新的模型判定也可能不同。这一点在做结果复核或长期归档时值得留意。
什么时候它有用,什么时候要打折扣
官方文章里给出的典型场景是事后复盘:AISI 今年早些时候处理过一次评测中的安全事件,智能体在评测中执行了未经批准的操作,系统化的 transcript 复盘帮他们定位了行为与后果;另一个场景是“作弊识别”——表面通过评测的智能体,需要检查它是怎么通过的。
同时也需要保留几点边界:LLM-as-judge 的判断可能错或误导,标签需要由人核对原文;可靠的结论仍然依赖评测设计与专家人类判断;当 transcript 规模达到数十亿 token 时,任何工具都只是“保持可观察性”的一部分,不是替代人工审阅的方案。
如果想动手试一下
官方文章说明了输入与输出的形态,但没有规定具体的操作数量。下面是一个根据官方功能整理的建议练习:先选一次有完整 transcript 的评测运行,确定想区分的活动类别——建议从少量类别开始,例如三到五类,这是便于人工核对的建议值,可自行调整;把任务上下文写成一段说明,与类别定义一起喂给 Transect;生成报告后,抽查若干段标签做回查,例如三到五段(同样是建议值)——点进时间线上的标签,比对对应 transcript 片段是否真的体现了该类活动;如果有 judge 模型的判定分歧记录,优先看那些分歧位置。
一个可供参考的小练习(尚非已完成的测试):挑一次自己跑过的多轮 agent 任务 transcript,在时间线上找到 token 用量最高的一段,检查它被标成什么活动、对应原文是什么,再对照自己的预期。产物可以是一份简短的核对笔记,列出标签、原文片段位置和你自己的判断是否一致。
官方同时提到,配套论文对方法与案例做了更细的描述;工具以开源形式发布,官方也希望社区对它进行压力测试并在此基础上改进。
来源
Transect: Making large-scale agentic evaluations easier to understand | AISI Work — https://www.aisi.gov.uk/blog/transect-making-large-scale-agentic-evaluations-easier-to-understand AISI 官方发布帖 — https://x.com/AISecurityInst/status/2107833359317749966
AI实践簿,是一个专注 AI 工具、方法与真实应用的公众号。我们会核对信息来源,拆解适用场景、实践路径和使用边界,帮你判断什么值得跟进、怎样真正用起来。欢迎关注 AI实践簿。