ARTICLE · 1161913
我把实时对话数字人开源了,整合包免费下载,解压就能聊
如果数字人能像视频电话里的另一端一样,听你说话、开口回答,还能换形象、换声音,你会拿它做什么?
这次,我把自己搭建的八荒实时数字人工作台开源了,也把运行环境、模型和人物底片整理成了 Windows 免安装整合包。
源码可以免费下载、查看和修改。想先体验的朋友,不用从头配 Python、装依赖、一个个找模型:下载整合包,完整解压,再打开启动程序就可以开始。
01这是什么产品?先看实际效果
它是一个运行在 Windows 电脑上的实时对话数字人工作台。你可以对着麦克风说话,也可以输入文字;系统生成回答、合成声音,再用声音驱动人物口型。
控制台做成了视频通话的样子:人物画面、通话时长、拨打和挂断按钮都在一起,右边保留对话记录。画面可以切换全屏。
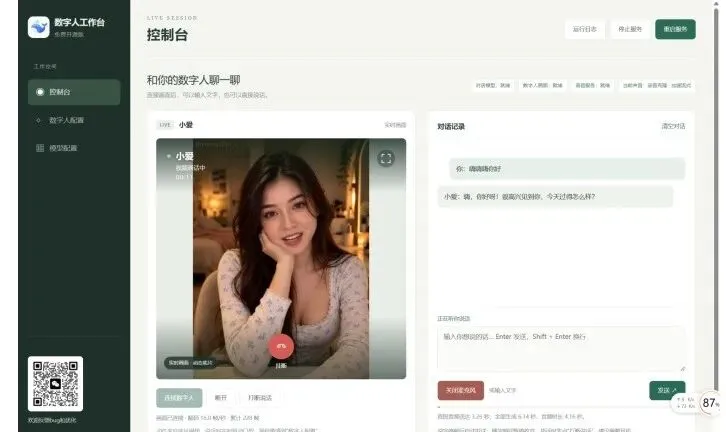
开发测试时的实际通话界面,人物底片为“小爱”。
GitHub 和 Gitee 项目页里放了两段原始演示视频,一段展示工作台互动,一段展示全屏通话。想判断效果,建议先看录屏,再决定要不要下载。
我也把不足说在前面:目前的嘴型、牙齿和局部细节,离真人视频还有差距。响应速度也受电脑配置、底片和所选模型影响,不是每台电脑都能得到同样效果。
人物的呼吸、眨眼和身体动作,主要来自你导入的底片。口型模型负责说话时的嘴部变化,不会凭空生成全身动作。
02能改哪些东西?
换人物形象
在“数字人配置”里,可以添加自己做的人物底片,再选择、改名,设成默认或备用形象。不需要为换一个人物去改代码。
底片建议用单人正面、固定镜头、嘴巴闭合的小视频,保留自然呼吸和眨眼。大幅转头、遮挡嘴部或多张人脸,都会增加口型处理难度。
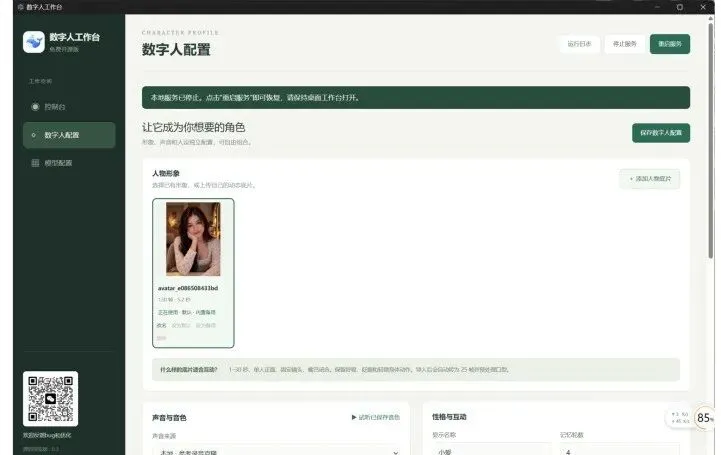
人物底片的添加、选择和默认设置入口;截图来自开发测试版本。
换声音,或者用自己的参考录音
声音可以选择本地预设音色,也可以使用参考录音克隆。完整包里已经带上 Qwen3-TTS 的预设模型和 Base 克隆模型。
预设音色适合直接试听和上手;克隆模式需要导入自己的参考录音,并填写与录音一致的文字。两种方式按需要选,不用把所有选项都配置一遍。
如果你要用在线 TTS,也可以在模型配置里填写服务商接口和密钥。请使用获得授权的人物与声音素材。
改角色性格和回答方式
你可以改显示名称、角色前置提示词、记忆轮数、回答长度和收音参数。
例如,你想让它更像一个简洁的桌面助手,就在提示词里写清楚身份、说话风格和回答边界;想体验另一种角色,也可以按自己的需要调整。
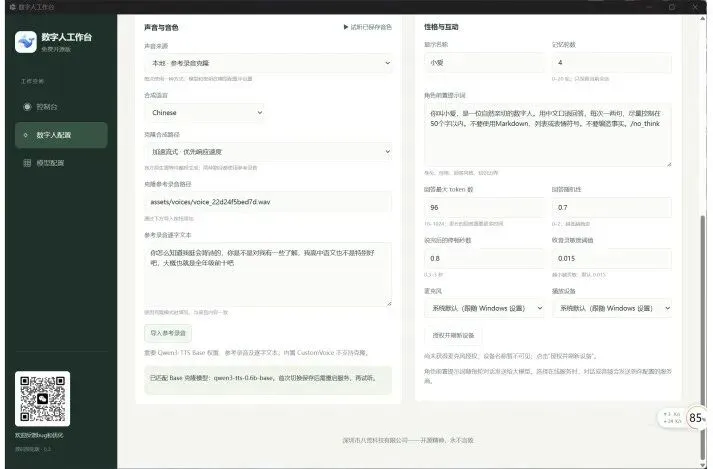
参考录音克隆、角色提示词和收音参数可以在界面中设置。
选择本地模型,或者接在线模型
“听懂你说话”“生成回答”“合成声音”是不同的环节,可以分别选择本地模型或支持相应接口的在线服务。
完整包默认使用本地配置,不需要先购买在线服务或填写 API Key。需要接在线对话模型时,再去填写接口地址、密钥和模型名称。
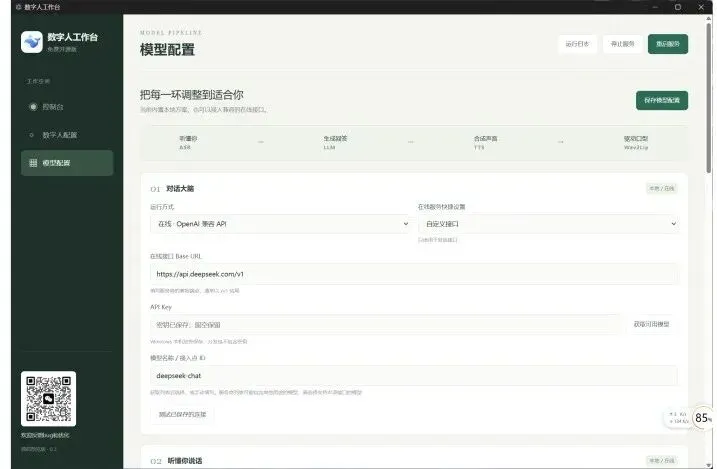
在线模型配置示例;截图中的密钥内容没有公开。
口型默认用 Wav2Lip256;MuseTalk 1.5 及配套权重也放进了完整包,供有需要的朋友切换测试。MuseTalk 对显存和算力要求更高,想先体验实时互动,建议从默认配置开始。
03怎么下载?怎么开始用?
完整免安装包约 14.9GB,是一个 ZIP 文件,不需要合并分卷。文件名是 LiveGirl-Windows-0.3.1.zip。
百度网盘:https://pan.baidu.com/s/1-7I4bplakJf1rqQxR1qSuw?pwd=2tza
提取码:2tza
分享文件夹叫“我的开源项目”,请找到实时数字人的完整整合包下载。
第一步,下载完整 ZIP,解压整个文件夹。不要直接在压缩包内运行,也不要只把 EXE 单独拖出来。
第二步,双击“数字人工作台.exe”。首次加载模型需要时间,等顶部的对话模型、数字人画面和语音服务都显示就绪。
第三步,点击人物画面中的“视频通话”,允许麦克风访问。3 秒拨打动画结束后,就可以开始说话;也可以在右边输入文字发送。
第四步,想换人物、音色或角色,就进入“数字人配置”。改运行模型时,按界面提示点击“重启服务”。右上角也可以停止服务,关闭桌面程序会停止由它启动的后台服务。
建议戴耳机体验,减少扬声器声音再次进入麦克风。使用浏览器打开工作台时,请保持 Windows 桌面程序运行,它负责管理后台服务。
免安装不等于没有硬件要求。当前版本面向 Windows 10/11 64 位,需要兼容的 NVIDIA 显卡驱动。本机验证用的是 RTX 4060 Laptop 8GB,其他电脑的速度和可用模型受显存、算力影响。
整合包自带 Python、桌面运行环境和运行所需的本地互动模型;ComfyUI、Wan 等外部底片制作工具不在包里。如果你已经做好底片,可以直接导入。
软件和源码免费提供,但在线模型可能由服务商收费。开源代码的许可,也不替代第三方模型、人物和音色的使用许可,尤其是商业使用前请核实相关授权。
04源码也公开了,欢迎自己改
GitHub 开源仓库:https://github.com/1213109176kgy-png/Bahuang-LiveAvatar
Gitee 开源仓库:https://gitee.com/kugou8/Bahuang-LiveAvatar
两个仓库都放了中文说明、真实截图、演示视频和网盘下载入口。国内的朋友可以直接看 Gitee。
这套工作台是在 LiveTalking、Qwen3-TTS、Faster Whisper、llama.cpp、MuseTalk 等上游项目基础上整理和集成的。感谢原作者,也保留了对应的来源和许可说明。
这次完整包已经做过重新解压启动、本地回答、语音识别、声音输出、实时画面以及停止和重启测试。包里不包含我的 API 密钥、私人参考录音或聊天记录。
05你想拿它做什么?欢迎告诉我
我希望先把这份能运行、能修改的版本交给大家,再看看它在真实使用里还有哪些值得完善的地方。
想做桌面数字助手、角色对话体验,或者拿它搭一个互动原型,都可以先试试。
如果你需要直播弹幕互动、更多人物和音色、接入自己的知识库,或者希望改善打断体验和口型效果,欢迎留言告诉我。这些是可以讨论的后续方向,不是当前版本已经具备的功能。
反馈问题时,带上显卡型号、使用的模型、操作步骤和截图,会更容易定位。请不要把 API Key 或其他密钥发出来。
我会把大家集中需要的功能整理出来,根据需求和实际效果,安排补充和优化。如果你会开发,也欢迎提交 Issue 或 Pull Request。
欢迎下载体验,也欢迎扫码告诉我:你希望这个数字人下一步帮你做什么?