ARTICLE · 1185118
推理引擎是怎么运转的:从源码看 vLLM、SGLang、TensorRT-LLM
2026-09-30
从启动到输出最后一个 token,沿着请求的执行路径,看看推理引擎每一步做了什么。本文以三个开源引擎固定提交版本的源码为依据,讲到 GPU kernel 的调用边界。
LLM 推理服务系列之一。
版本说明。本文固定阅读的源码版本为 vLLM v0.29.0、SGLang v0.5.19 和 TensorRT-LLM v1.2.1。英文发布版补充了两次复核记录:10 月 8 日对照 vLLM v0.31.0 和 SGLang v0.5.21,原审计涉及的默认状态没有变化;10 月 9 日继续检查本篇新增涉及的默认值时,发现一项变化:SGLang 无法读取 GPU 显存大小时使用的回退比例,在 v0.5.21 中由 0.88 改为 0.95。下文的实现描述与算例仍以原先固定的版本为准。
1. 推理引擎的一次迭代做了什么
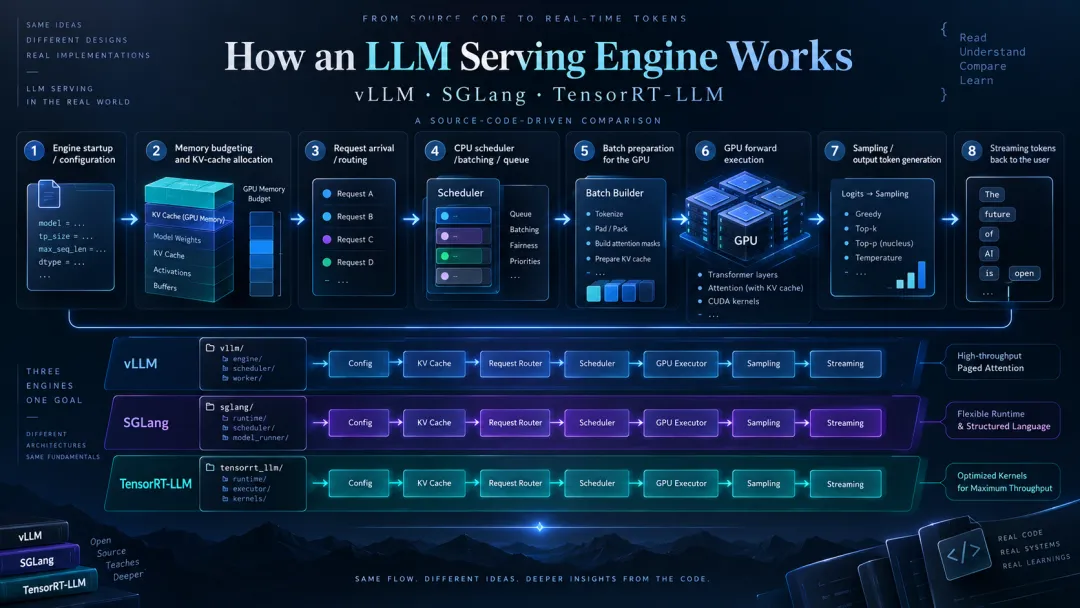
LLM 推理引擎通过不断迭代处理请求:CPU 安排本轮计算并分配 KV 空间,GPU 执行计算,随后更新请求状态。普通 decode 每轮会为参与计算的请求产生一个输出 token;尚未完成的 prefill 分块则不会。如果 prefill 不分块,也不使用推测解码或重计算,生成一段 200 token 的回答,需要一次 prefill,再接着执行 199 次 decode。
本文沿着这个循环,分别阅读 vLLM、SGLang 和 TensorRT-LLM 的源码,从启动一直追到文本输出。每个引擎都固定在一个提交版本上,每节先解释机制,再比较三个引擎的实现。具体到引擎的结论,均附有编号,指向文末的源码位置。
讨论止于引擎与 GPU kernel 的调用边界:引擎构造哪些张量、传入哪些参数,kernel 从哪里读取数据。kernel 内部如何实现,不在本文范围内。
先回顾几个基本概念。本文从普通自回归 Transformer 的执行路径讲起。预填充(prefill)处理提示词并建立 KV 缓存,可以一次完成,也可以拆到多轮迭代中;完成 prefill 后,才能得到第一个输出 token。随后,解码(decode)将刚生成的 token 作为新输入,扩展缓存状态,继续生成下一个 token。基础流程以 KV 保存在 GPU 显存中为例;前缀复用和卸载会改变这份状态的保留与迁移方式。
后面会反复用到四种机制:连续批处理,每步重新决定批次成员(Yu 等,2022);分页 KV,按固定大小的块分配 KV 显存(Kwon 等,2023);分块预填充,将长提示词分段处理,避免 decode 长时间得不到执行(Agrawal 等,2024);前缀缓存,复用共同前缀已经计算好的 KV(Zheng 等,2024)。
后文会在各自对应的执行环节展开这些机制。论文列在参考文献中;入门篇则通过算例解释了它们的基本原理。没有读过入门篇,也不影响阅读本文。
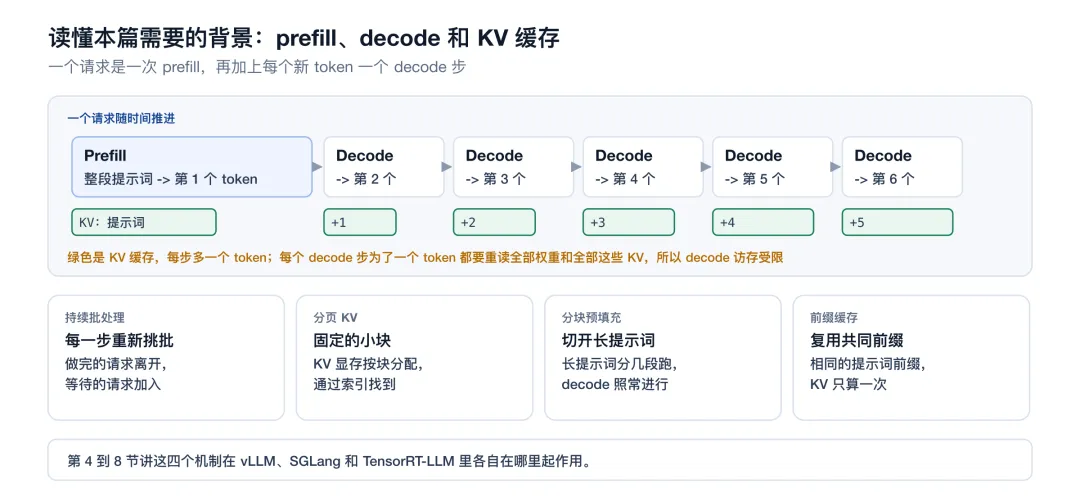
图 1|prefill、decode 与 KV 缓存。图示采用未分块、不含推测解码或重计算的基本流程。
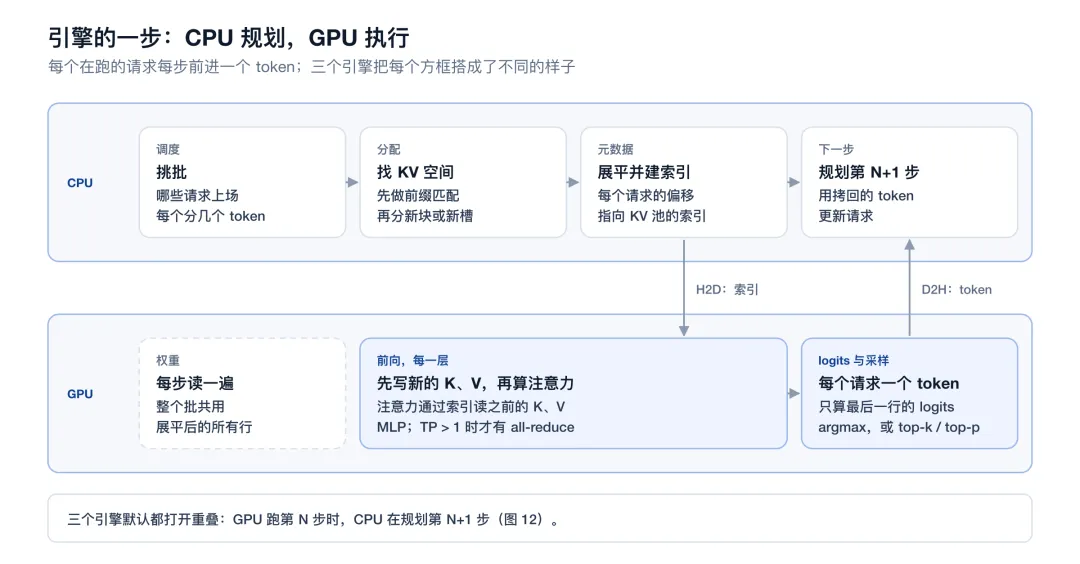
图 2|一次迭代中的 CPU 与 GPU 工作。未完成的 prefill 分块不产生有效输出 token。
阅读路线。图 2 也是全文的提纲。后面的章节沿着请求的执行路径依次展开:
- 第 2 节:启动。
确定执行路径与 KV 缓存的显存预算。 - 第 3 节:请求进入。
文本转换为 token ID,再传给负责调度和驱动 GPU 的进程。 - 第 4 节:CPU 调度。
组织批次,为新 token 分配 KV 空间。 - 第 5 节:准备 GPU 输入。
将批次展平为张量,构造索引,让 kernel 能够找到各个请求的 KV。 - 第 6 节:前向计算。
逐层查看执行过程。 - 第 7 节:CUDA graph。
通过一次调用提交整步的 GPU 工作。 - 第 8 节:生成输出。
计算 logits、采样,并将新 token 复制回 CPU。 - 第 9 节:返回文本。
将 token ID 还原为文本,完成这一轮处理。 - 第 10 节:扩展功能。
介绍比较引擎时常见的功能,以及它们分别改变了循环中的哪个环节。 - 第 11、12 节:对照与边界。
分析默认配置与引擎结构的关系,并说明本文没有覆盖的内容。
每节的组织方式相同:先说明问题和共同机制,再分别介绍三个引擎,最后归纳要点。各引擎段落末尾的“源码入口”列出相关函数、配置项和类名,方便继续查代码;理解正文不需要记住这些名称。术语说明见附录 E。
三个引擎运行的是同一类循环,实现方式却不相同。快照篇检查了 20 项机制的默认状态;本文进一步解释机制如何运行,并在第 11 节回到这些默认值,分析哪些差异与引擎结构有关。本文不进行性能测试。
三个引擎的来历与对外接口
vLLM 和 SGLang 都起源于研究论文,论文中的核心设计也延续到了后来的实现中。TensorRT-LLM 则是 NVIDIA 官方提供的推理库,针对自家 GPU 硬件进行优化。
- vLLM
源自 PagedAttention(Kwon 等,2023)。它针对推理服务中 KV 显存浪费的问题,借鉴操作系统的分页机制,按固定大小的块分配缓存。第 4 节介绍的块池就沿用了这一思路。客户端通过 OpenAI 兼容服务调用,接口包括 /v1/chat/completions1。 - SGLang
源自同名论文(Zheng 等,2024),研究的是如何高效执行多次调用模型、且调用之间共享提示词前缀的程序。缓存方面的方案是 RadixAttention,也就是第 4 节介绍的基数树机制。它的 HTTP 服务同样提供 OpenAI 兼容接口2。论文还提出了一套前端语言,包含 gen、select、fork等操作3。这部分作为服务客户端运行,本文不展开。 - TensorRT-LLM
是 NVIDIA 提供的推理库,采用 Apache-2.0 许可4。仓库包含多条执行路径:一条将模型编译为 TensorRT 引擎,另一条使用 PyTorch。本文固定的版本默认采用 PyTorch 路径,第 2 节会详细说明。它的 OpenAI 兼容服务器也提供上述接口5。
2. 启动时:确定执行路径与 KV 显存预算
第一个请求到来之前,引擎需要先确定两件事。
第一件是执行路径,也就是实际驱动模型前向计算的那套后端代码。它可能直接使用 PyTorch 实现,也可能运行针对硬件编译好的模型。先确认走哪条路径,才能判断后面的显存预算、组批规则等行为属于哪个执行器。本文涉及多条执行路径选择的是 TensorRT-LLM,下面单独介绍。
第二件是 KV 缓存可以使用多少显存。各引擎在启动时确定容量,预先分配整个 KV 池。此后,请求只需从池中取得空闲块或槽:一个块容纳固定数量的 token,一个槽对应一个 token,不必在某一步执行到一半时,再向 GPU 申请 KV 显存。池的容量决定了可以同时处理多少 token,也限制了批次大小。
先确认实际执行的是哪条路径
需要先确认执行路径的是 TensorRT-LLM。v1.2.1 对外提供的 Python 类基于 PyTorch 实现6;不指定后端时,选择的也是 PyTorch7。trtllm-serve 同样默认使用 PyTorch 后端8。这两个入口最终都进入 PyTorch 路径,调用用 Python 编写的执行器9。
较早的 TensorRT 路径仍然保留:它会把模型编译为 TensorRT 所称的“引擎”,也就是编译后的模型,可以通过名称显式选择10。第三个后端 AutoDeploy 也需要显式指定11。
因此,阅读 TensorRT-LLM 的默认配置之前,先确认采用哪条执行路径。后面的默认值都属于相应路径。本文关于 TensorRT-LLM 的论述均指 PyTorch 路径。
源码入口:class LLM(_TorchLLM)、trtllm-serve --backend、create_py_executor、_autodeploy。
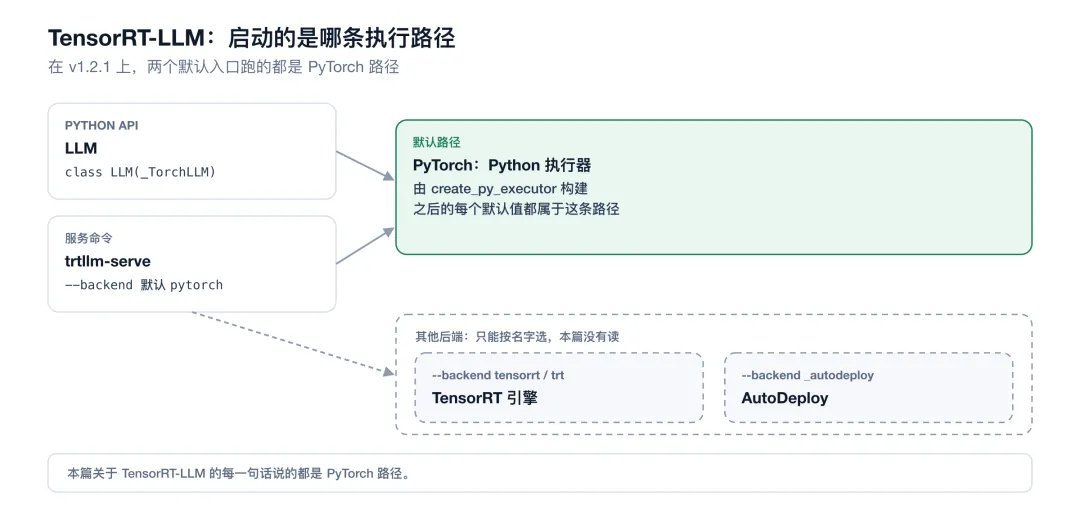
图 3|TensorRT-LLM 的两个默认入口都进入 PyTorch 执行器。
确定 KV 缓存的容量
模型权重只占显存预算的一部分。激活值、运行时缓冲区和 CUDA graph 也需要空间。分配 KV 池之前,引擎要先计入这些开销,但三个引擎的估算方法并不相同:
- 估算非 KV 开销:
通过试运行测量,或根据配置预留空间。 - 计算 KV 预算:
应用对应引擎的预算规则,计入配置比例及额外预留空间。 - 分配缓存池:
将 KV 预算换算为可用块数或 token 槽数,再分配内存。
下文讨论的路径中,vLLM 和 TensorRT-LLM 通过试运行测量,SGLang 默认采用预留量估算。这几个配置项的差别,不只在数值,也在预算覆盖哪些开销、KV 可用空间怎样计算:
vLLM
配置项:gpu_memory_utilization
默认值:0.92
预算含义:GPU 的总显存
SGLang
配置项:mem_fraction_static
默认值:未设置时计算
预算含义:以 GPU 显存总容量为分母,为模型权重与 KV 池划定静态预算
TensorRT-LLM
配置项:free_gpu_memory_fraction
默认值:0.9
预算含义:测得峰值后剩余的空闲显存
这里的 static 指预算覆盖的内容——模型权重与 KV 池——而不是分母。mem_fraction_static 的分母仍是 GPU 显存总容量。
vLLM 通过测量确定预算。启动时,它用模拟输入执行一次前向计算,记录显存占用12。显存比例默认为 0.9213,以 GPU 的总显存为基数14。
KV 缓存预算先扣除测得的全部非 KV 内存,再扣除 CUDA graph 的预计占用15。CUDA graph 记录了一步 GPU 工作,第 7 节会详细介绍。在 CUDA 平台上启用图时,默认会扣除这笔估算值16;也可以通过环境开关取消这项扣除17。最后,用剩余字节数除以每块的字节数,得到池中的块数18。
源码入口:
gpu_memory_utilization、VLLM_MEMORY_PROFILER_ESTIMATE_CUDAGRAPHS。SGLang 默认不进行这一步测量。它也支持捕获 CUDA graph 后再确定容量,但该选项默认关闭19。默认做法是先计算一笔预留空间20,从 KV 池的可用空间中扣出,留给激活值工作内存、并行执行和 CUDA graph。对于显存超过 60 GB 的 GPU,这笔预留至少为 10 GB。
显存比例由预留空间反推:(GPU 显存 − 预留空间)÷ GPU 显存。例如,80 GB 显存预留 10 GB,对应的比例就是 70 ÷ 80 = 0.875。只有无法读取 GPU 显存大小时,才使用 0.88 作为回退值21。
权重加载后,KV 预算按以下公式计算:当前空闲显存 −(1 − 比例)× 加载前的空闲显存22。仍以 0.875 为例,0.125 × 80 GB = 10 GB,正好对应预留空间,而且只扣除一次。再用这一预算除以每个 token 的字节数,得到池可容纳的 token 数23。
这个比例覆盖静态部分,也就是模型权重与 KV 池;预留空间则留给这两项之外的开销,不应再从静态预算中重复扣除。
TensorRT-LLM 使用模拟请求进行一次试运行,估计显存需求24。峰值由 PyTorch 记录的峰值与 PyTorch 之外的内存占用相加得到25。它的显存比例默认为 0.926,作用于测得峰值之后仍然空闲的显存27。
缓存布局兼容的层会被归入同一个主池。本文算例各层采用相同的注意力配置,因此每张 GPU 上的一个池可以覆盖全部模型层;如果模型包含不同的缓存分组,就可能需要多个池。池中的数据按块和层组织,键、值区域分开,默认每块容纳 32 个 token。
将这份预算除以每个 token 的缓存字节数,得到缓存容量28。主池位于 GPU 显存中,再用 token 容量除以块大小,得到块数29。位于主机内存中的次级池,则由第 10 节介绍的 KV 卸载功能提供。源码入口:
free_gpu_memory_fraction。
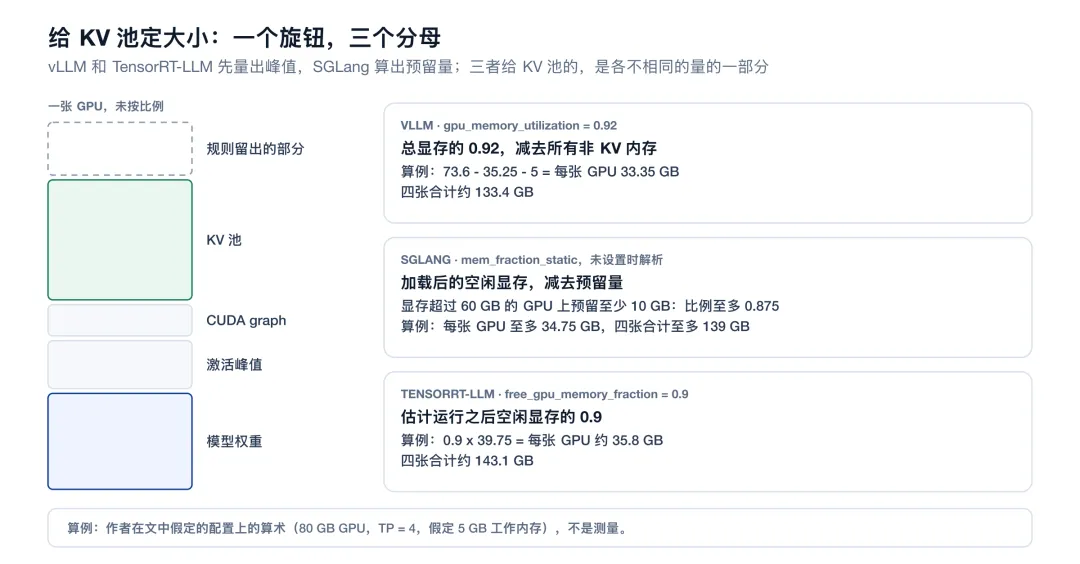
图 4|启动时的 GPU 显存分配,以及三个引擎计算 KV 池容量的规则。
CUDA graph 本身也占显存。引擎会在启动时,为准备回放的批次形状捕获 CUDA graph,详见第 7 节。vLLM 从预算中扣除图的预计占用30;SGLang 则在预留空间中为图留出位置31。
每个 token 占多少空间,KV 又如何排布
在每个注意力层中,一个 token 的每个 KV 头都对应一对键向量和值向量。分组查询注意力(Ainslie 等,2023)允许多个查询头共享一个 KV 头,因此存储量应按 KV 头数计算。三个引擎在这一点上相同,主要区别在张量布局。
- vLLM
为每层分配独立的张量,维度依次按块、KV 头、块内 token 排列,最后是该头在该 token 上的一格数据32。这一格同时存放键和值33。FlashAttention(Dao 等,2022)路径在写入前,会将其拆为键视图和值视图34。未另外配置时,每块容纳 16 个 token35。 - SGLang
为每层分配两个缓冲区,分别存放键和值36。默认布局将 token 槽放在最前面37:每个槽占一行,行内再按 KV 头和头维度排列38。CUDA 平台上,未另外配置时每页容纳一个 token39,因此一个槽就对应一个 token。源码入口: k_buffer、v_buffer;以头为首个维度的布局称为 HND。 - TensorRT-LLM
按缓存分组建立主池。对于本文各层注意力配置相同的算例,每张 GPU 上的一个主池覆盖全部层,依次按块、层、键或值、块内 token 排布40,默认每块容纳 32 个 token41。这里说的“跨层”是指同一池内的各层;不同缓存分组可能对应不同的池。相比之下,另外两个引擎在本文所示路径中按层分别保存张量或缓冲区。
用一组数字计算 KV 容量
下面采用同一套配置:70B 级稠密模型,使用 BF16,每个值占 2 字节;模型有 80 层、64 个查询头、8 个 KV 头,头维度为 128。模型运行在四张 80 GB GPU 上,张量并行度为 4,即每一层分布到四张 GPU。
权重共占 141 GB,约为 70.5 B 个参数、每个参数 2 字节,每张 GPU 分担约 35.25 GB。为了简化预算计算,假设每张 GPU 的非权重、非 KV 开销合计为 5 GB,其中包含激活值工作内存、运行时缓冲区及额外的 CUDA graph 预留。不再额外留余量时,手算得到每张 GPU 的 KV 池为 80 − 35.25 − 5 = 39.75 GB,四张合计 159 GB。
张量并行将 8 个 KV 头分到四张 GPU,每张分到 2 个。因此,一个 token 在每张 GPU 上的 KV 开销是:80 层 × 2(键和值)× 2 个头 × 128 × 2 字节,即 80 KiB;四张合计 320 KiB。
在 vLLM 的布局中,一格对应一个 KV 头、一个 token 在一层中的键和值,其大小为 (128 + 128) × 2,即 512 字节42。
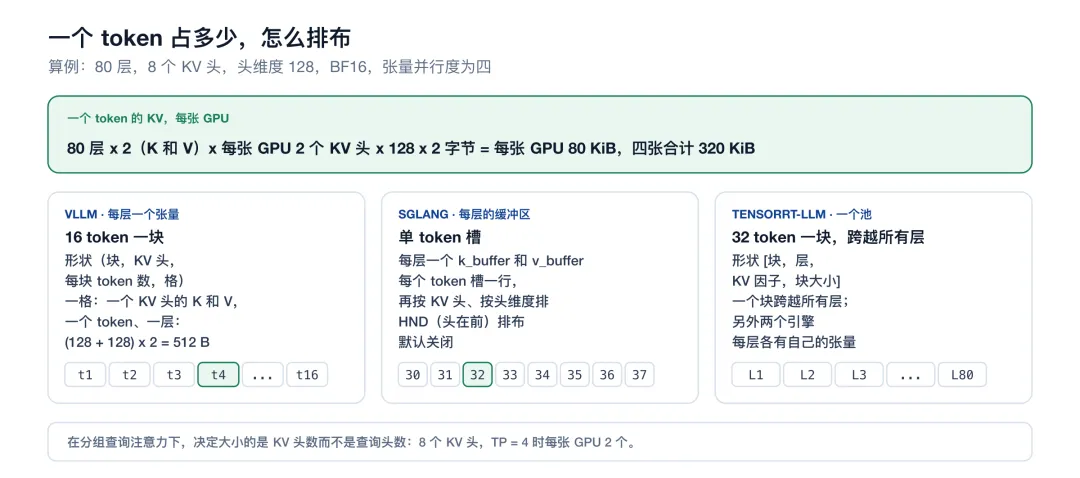
图 5|统一注意力算例中的每 token KV 存储量与布局。TensorRT-LLM 的单池仅表示本算例。
下面的计算只用于说明预算规则,不是对真实引擎分配结果的预测。5 GB 是统一假设的合计开销,既不是实测的激活峰值,也不是另加的一笔图显存估算。vLLM 和 TensorRT-LLM 的算例都把它作为非权重、非 KV 的合计开销;SGLang 则使用自己的预留规则,因此不再扣一次 5 GB。
- vLLM43
:显存利用率预算为 0.92 × 80 GB = 73.6 GB。扣除 35.25 GB 权重和假设的 5 GB 非权重、非 KV 合计开销后,每张 GPU 留给 KV 的空间为 33.35 GB,四张合计 133.4 GB。 - SGLang44
:80 GB 显存超过 60 GB 的阈值,因此至少预留 10 GB,对应比例至多为 0.875。加载权重后还剩 44.75 GB,再扣除预留空间,每张 GPU 的 KV 预算至多为 34.75 GB,四张合计至多 139 GB。这里的预留空间已经代替了工作内存预算,不再重复扣除 5 GB。 - TensorRT-LLM45
:采用同样的开销假设,应用 KV 比例之前还剩 80 − 35.25 − 5 = 39.75 GB。取其中的 90%,得到每张 GPU 35.775 GB,四张合计 143.1 GB。
不额外预留空间的手算
每张 GPU 的 KV 池:39.75 GB
四张合计:159 GB
vLLM
每张 GPU 的 KV 池:33.35 GB
四张合计:约 133.4 GB
SGLang
每张 GPU 的 KV 池:至多 34.75 GB
四张合计:至多 139 GB
TensorRT-LLM
每张 GPU 的 KV 池:约 35.8 GB
四张合计:约 143.1 GB
三个结果都小于手算的 159 GB,因为各自的规则都额外保留了一部分空间:vLLM 留出 GPU 总显存的约 8%46,SGLang 扣除预留空间47,TensorRT-LLM 则保留空闲显存的约 10%48。
这组算例中,池容量的差别只有几个百分点,但计算规则并不相同。理解“显存比例”,既要看预算覆盖什么,也要看扣除了哪些开销、还留了多少余量。不能只复制一个比例值,就认为换到另一个引擎后,KV 预算仍然相同。
小结。开始服务前,本文讨论的路径会先确定执行方式和 KV 池预算。比较时要看完整的显存预算规则,而不是只看比例:相同的配置数值,并不表示三个引擎会为 KV 留出相同空间。
3. 请求进入:分词与进程间通信
请求首先以文本形式通过 HTTP 进入服务。HTTP 便于客户端接入:不同语言、不同机器上的程序,都可以向 OpenAI 兼容接口发送 JSON 并接收 JSON。需要边生成边接收结果时,客户端会启用流式返回,通过 server-sent events(服务器推送事件)接收数据。vLLM 对应的响应类型是 text/event-stream49。
HTTP 只用于最外层入口。引擎内部的进程通过消息通信,下面分别来看。
三个引擎也都支持绕过 HTTP,直接从 Python 调用:vLLM 提供相应的类50;SGLang 也有直接调用入口,此时调度器和 detokenizer 仍然作为子进程运行51;TensorRT-LLM 则复用服务器使用的同一个类52。本文按 HTTP 路径展开。
源码入口:vLLM 的 LLM、SGLang 的 Engine、TensorRT-LLM 的 LLM。服务器入口分别是 vllm serve、SGLang 的 HTTP 服务器和 trtllm-serve。
调度之前,文本需要先转换成 token ID。三个引擎都把分词放在调度进程之外的另一个进程中。分词在 CPU 上执行,将它与调度分开,就不会占用驱动 GPU 的那条循环。
同一台机器上的进程通过消息交换数据,称为进程间通信(IPC)。下文会涉及两种工具:ZMQ 是消息通信库;MPI 则是多 GPU 作业中常用的消息传递方式。
vLLM。单卡默认启动两个进程。API 服务器运行在启动进程中53,引擎核心在后台进程中运行54。API 在请求处理循环之外执行分词55,避免长提示词阻塞其他请求,再通过 ZMQ 将请求交给引擎核心56。
此时 world size 为 1,驱动 GPU 的 worker 直接运行在引擎核心进程中,不另起进程57。world size 表示一份模型使用的 GPU 数量,等于张量并行度 × 流水线并行度58。多卡默认采用多进程方式,每张 GPU 对应一个 worker59。在 placement group 中启动时属于例外:placement group 是通过 Ray 集群作业框架提前预留的一组 GPU60。
SGLang。HTTP 服务和分词运行在主进程,调度器和 detokenizer 分别运行在子进程61。主进程完成分词62后,通过 ZMQ 将请求送给调度器63。这里使用本机套接字文件,而不是网络连接64。源码入口:分词由 TokenizerManager 负责。
TensorRT-LLM。服务器进程中的 LLM 将提示词转换成 token ID65,然后交给执行器66。即使在单卡上,执行器也分成两部分67:代理(proxy)留在服务器进程,通过 MPI 启动 GPU worker68,再通过 IPC 队列转交请求69。源码入口:分词发生在 generate_async 中。
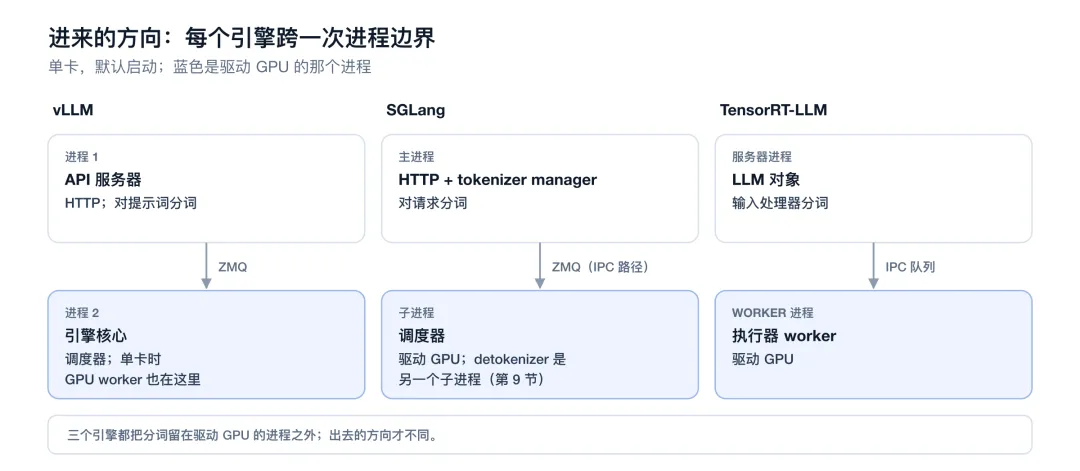
图 6|单卡默认配置下的请求输入路径:三个引擎都跨越一次进程边界。
小结。在单卡默认配置下,三个引擎都会先在 GPU 进程之外完成分词,再跨越一次进程边界传入请求。它们在输出方向上的差别,将在第 9 节介绍。
4. CPU 上的工作:调度与 KV 分配
每一步中,CPU 先选择参与本轮计算的请求,决定每个请求处理多少 token,再为新 token 分配 KV 位置。连续批处理、分页 KV、分块预填充和前缀缓存,都在这里对应到具体的程序调用。
组织批次。首先要回答:同一步中的 prefill 和 decode,能否放进同一个批次?三个调度器的做法不同。
- vLLM
的调度器不将请求分成 prefill 和 decode 两类,而是记录每个请求已经计算了多少 token,以及总共有多少 token。每一步按两者的差额分配 token 预算,不区分当前阶段70。decode 请求只差一个 token,prefill 请求则可能还差很多;两者使用同一份 token 预算。正在运行的请求优先获得预算71,默认策略是先来先服务72。 - SGLang
先尝试组织 prefill 批次,有可执行的 prefill 就优先处理,只有没有新的 prefill 时才运行 decode73。要在同一步中混合两者,需要打开一个默认关闭的开关74。因此,默认情况下,SGLang 的一步要么处理 prefill,要么处理 decode,不会同时处理两者。它的默认策略同样是先来先服务75。源码入口: enable_mixed_chunk。 - TensorRT-LLM
每次迭代依次运行两个调度器。容量调度器先选出 KV 显存能够容纳的请求;微批调度器再从中选出符合本轮批次大小和 token 上限的请求。prefill 请求在这里称为 context 请求,decode 请求称为 generation 请求,两类请求分别放在两个列表中返回76,随后在同一次迭代中执行。容量策略默认不驱逐正在运行的请求77。源码入口: GUARANTEED_NO_EVICT。
分块预填充如何实现。长提示词可以拆成多段,避免单个请求占满一步的 token 预算。
- vLLM
开启分块后,会将等待中请求的本轮计算量截到剩余预算以内,而不是一直等到预算足以容纳整段提示词78。分块是否默认开启,取决于模型的支持情况79。 - SGLang
会把超过剩余分块预算的请求截到预算长度,并将它作为“分块请求”带入下一步80。默认分块大小根据 GPU 显存确定81。 - TensorRT-LLM
的公开 API 默认关闭分块预填充82。
分配 KV 空间。请求开始执行前,每个新 token 都需要先在 KV 缓存中取得存储位置。
vLLM 维护一组固定大小的 GPU 块。空闲块与保存了可复用前缀 KV、但需要时可以回收的块,位于同一个队列中83。对于等待中的请求,调度器先检查开头哪些块已经计算过,也就是查找前缀缓存84;命中的块直接复用,其余部分分配新块85。运行中的请求在后续 token 需要更多空间时,继续申请新块86。
没有空闲块时,调度器会抢占一个正在运行的请求87:暂停它的执行,回收它占用的块,等到再次调度时重新计算其 KV。源码入口:
allocate_slots。SGLang 先在基数树中查找请求的 token 序列。从根节点出发的一条路径,对应一段已经缓存的 token 序列88。对未命中的 token,引擎分配 KV 槽,并在请求到 token 的映射表中,为该请求分配一行,详见第 5 节89。页大小为一个 token 时,每个新 token 恰好占一个槽90;这些槽号写入映射表中该请求对应的行91。
源码入口:
RadixKey、alloc_for_extend、out_cache_loc、req_to_token。- TensorRT-LLM
在前向计算开始前,为已调度的批次准备资源92。prefill 请求处理第一个分块时,按完整提示词长度向 KV 缓存管理器登记93;decode 请求则在每一步增加一个 token 的空间94。
前缀缓存如何判断匹配。两个请求要共享一段 KV,这一段之前的历史也必须完全一致。因此,三个引擎在标识缓存块时,都会考虑完整的前缀历史,而不只是当前块里的 token。
- vLLM
将每个满块的内容、父块哈希,以及 LoRA 适配器名称等额外键一起计算哈希,LoRA 见第 10 节95。之后在哈希到块的映射表中查找96。因此,复用以包含 16 个 token 的整块为单位。源码入口: BlockHashToBlockMap。 - SGLang
沿基数树查找 token ID 序列中最长的已缓存前缀97。页大小为一个 token 时,不需要再按块边界向下取整。 - TensorRT-LLM
维护一棵块树,每个节点通过键找到对应的子块98;计算键的哈希时,使用父键的哈希作为种子99。源码入口: BlockKey。
调度和分配完成后,CPU 已经确定每个请求在本步处理哪些 token,以及它们要读写哪些物理 KV 位置。接下来,需要把这些信息交给 GPU。
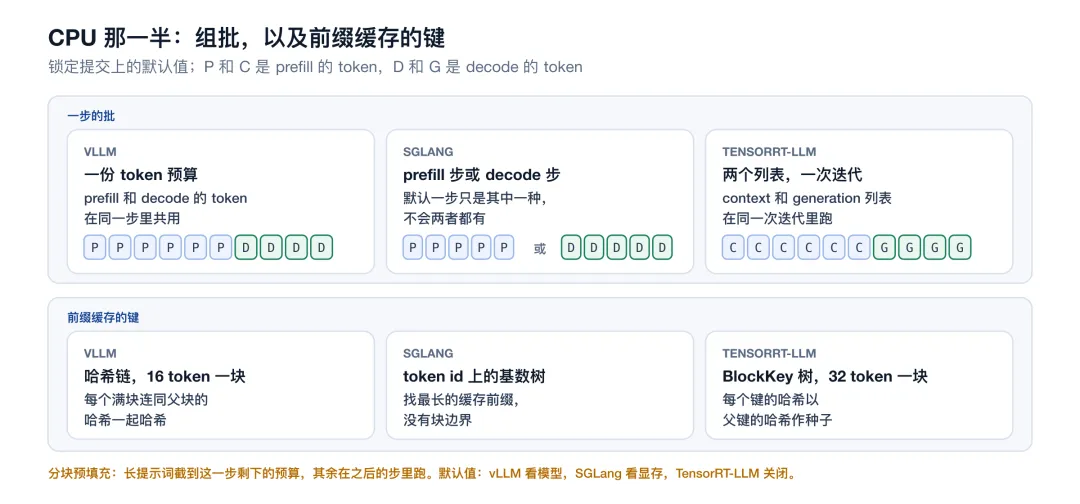
图 7|三个引擎如何组织批次,以及前缀缓存如何匹配。
小结。CPU 决定本轮处理哪些请求,以及 KV 存放在哪里。主要差别是 prefill 与 decode 能否混合执行,以及 KV 按多个 token 一块、还是按单 token 槽分配。
5. 准备 GPU 输入:展平批次与构造索引
GPU kernel 接收的是张量,而不是请求列表。因此,批次需要先展平:将本轮各个请求的新 token 首尾相接,每个 token 占一行,再用偏移数组记录各个请求从哪一行开始。不论是包含几千个 token 的 prefill 分块,还是只有一个 token 的 decode,展平后都表示为连续的若干行。
批处理让多个 token 行共用同一组权重矩阵,比逐个处理请求更容易复用权重。展平后,这些共享计算就可以交给矩阵乘法 kernel 执行。这并不保证每个权重只从 HBM 读取一次。实际访存量还取决于 kernel 的分块方式、缓存命中和批次形状。
KV 缓存并不按请求连续存放,token 会分布在分配时空闲的块或槽中。引擎因此还要向 kernel 提供索引,列出每个请求历史 token 的物理位置。分页 KV 通过索引读取缓存,注意力不依赖某个请求的 KV 连续存放。前缀命中时,两个请求的索引可以指向相同的物理块,kernel 直接读取,不需要另行复制。
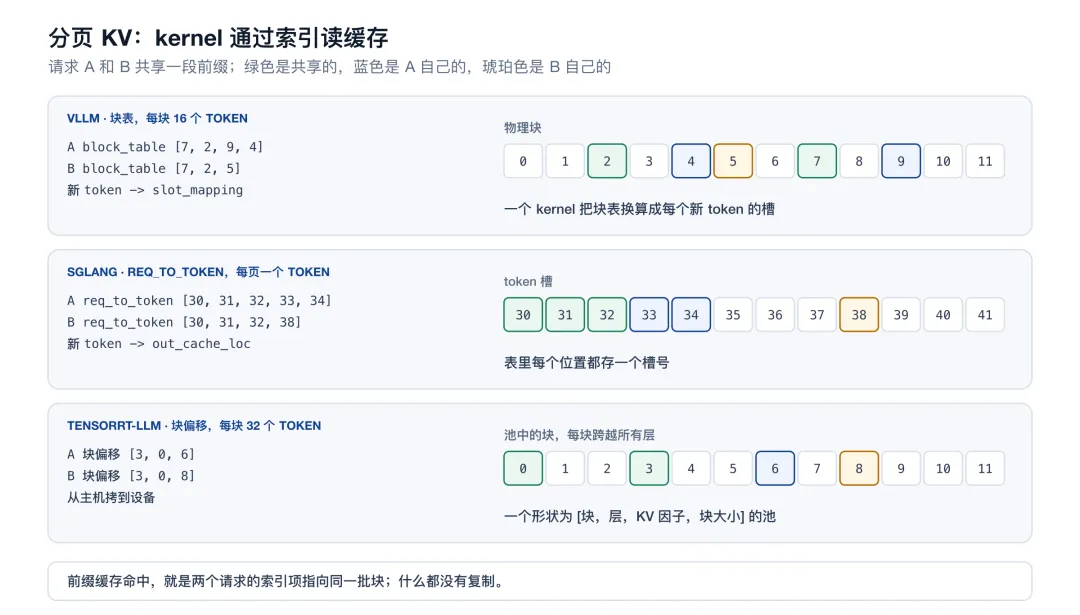
图 8|三个引擎如何通过索引读取 KV。TensorRT-LLM 图示表示一个缓存分组。
vLLM。负责构造 GPU 输入的模型运行器,要准备四类信息:每个请求的块表、起始行、当前序列长度,以及每个新 token 的写入槽。
块表为每个请求保存一行块 ID,并优先复制到 GPU,让这次复制与后续 CPU 工作重叠100。随后,将已调度的 token 展平,标明它们分别属于哪个请求,并累计每个请求的 token 数101。根据累计结果得到各请求的起始行,再复制到 GPU102。当前序列长度,则等于已计算的 token 数加上本步调度的 token 数103。
新 token 的写入槽由起始行、token 在请求中的位置和块表共同确定104,这项计算由 GPU 上的一个小 kernel 完成105。最后,将四类信息封装在同一个对象中,传给注意力代码106。
源码入口:起始行是 query_start_loc,序列长度是 seq_lens,写入槽是 slot_mapping,封装对象是 CommonAttentionMetadata。
SGLang。每个批次都标明属于 prefill、decode 还是混合模式107。索引采用一张映射表:每个请求占一行,序列中的每个位置占一列,表中保存 token 槽号108。
传给 kernel 的具体数据形式,取决于注意力后端,也就是引擎中负责调用注意力 kernel 的代码。基于 FlashAttention 3(Shah 等,2024)的 FA3 后端,直接取出本批请求在表中对应的几行,传给 kernel109。基于 FlashInfer 内核库(Ye 等,2025)的后端,则先调用一个 GPU kernel,将这些行压成一份扁平列表110。
源码入口:批次模式为 ForwardMode,取值为 EXTEND、DECODE 或 MIXED;映射表是 req_to_token。FA3 接收的参数名为 page_table;FlashInfer 使用的列表名为 kv_indices,由 Triton kernel 构造。
TensorRT-LLM。批次中先排列 prefill 请求,再排列 decode 请求,并为各请求标记类型;prefill 请求数量给出两者的分界111。KV 索引采用块偏移表,以非阻塞方式从主机复制到设备112。
源码入口:两类请求的类型值分别为 0 和 1,prefill 请求数量是 num_contexts,索引表是 kv_cache_block_offsets。
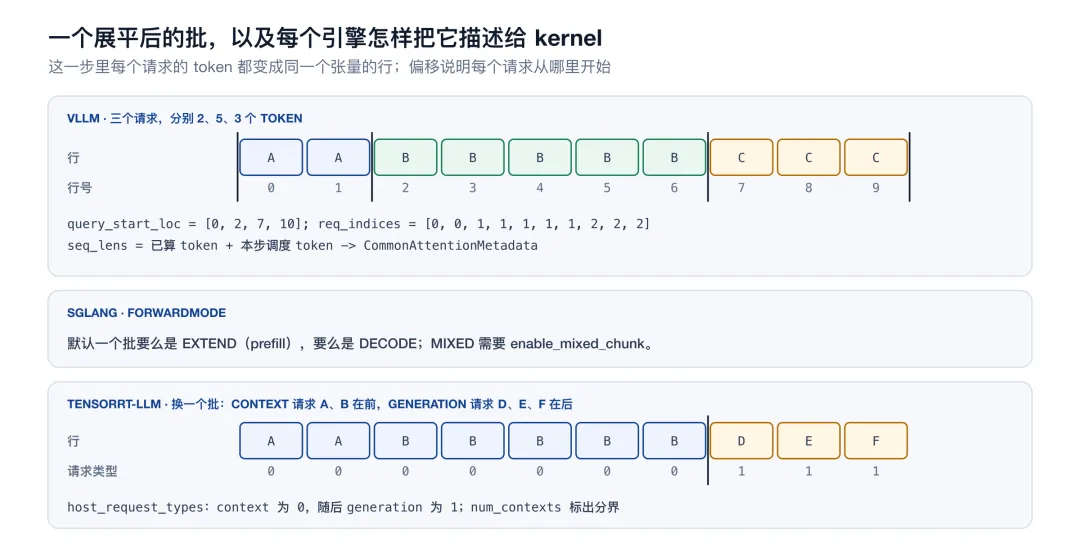
图 9|批次展平之后,三个引擎分别向 kernel 提供哪些信息。
三种索引的粒度不同。vLLM 与 TensorRT-LLM 分别指向包含 16、32 个 token 的块113;vLLM 写入新 KV 时,还会把块表转换为逐 token 的槽位映射114。SGLang 则直接指向单 token 槽115。无论采用哪种形式,kernel 都要通过索引找到每个请求的历史 token。
小结。kernel 接收展平后的新 token 张量、各请求的起始行,以及各自的 KV 索引。索引既允许 KV 分散存储,也让不同请求能够直接共享前缀,而不必复制缓存。
6. 前向计算:逐层查看执行过程
前向计算按顺序经过模型的各层。在每一层中,先将展平后的 token 投影为 Q、K、V;新的 K、V 按第 5 节确定的位置写入缓存;注意力再通过索引读取各请求的历史 K、V,与本步的 Q 一起计算;随后执行 MLP。只有注意力需要区分请求边界,投影和 MLP 都将展平张量视为连续的数据行。
在 decode 中,读取 KV 是两项主要访存开销之一,另一项是读取权重,见第 1 节。每个请求只产生一行 Q,kernel 却需要按索引,从相应的块中读取该请求此前所有的 K、V。与权重不同,这部分读取量会随着上下文变长而增加。
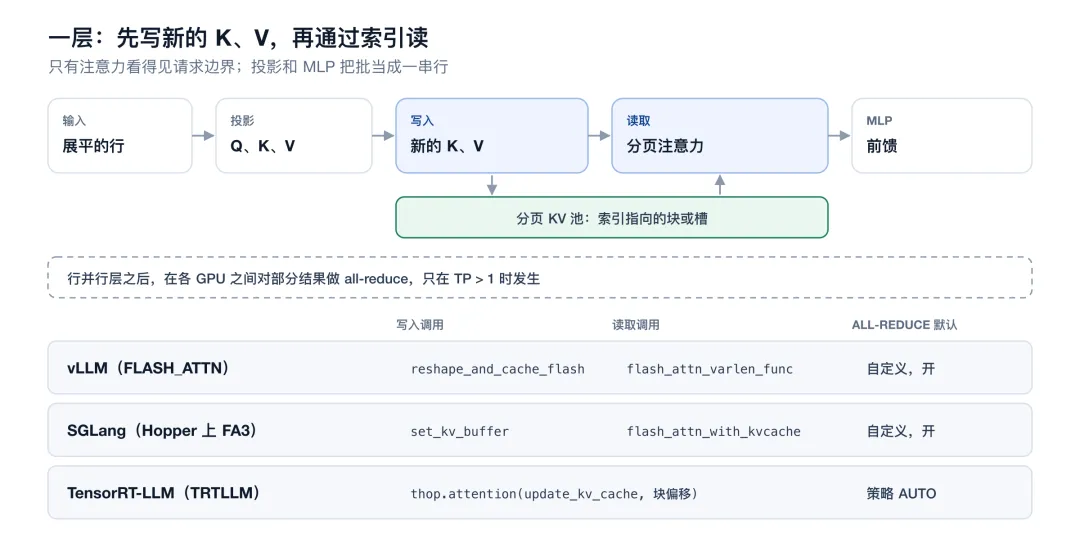
图 10|一层中的 KV 访问:先写入新状态,再通过索引读取历史。
vLLM。注意力后端从一份按优先级排列的列表中选择。对大多数模型和 GPU,首选 FlashAttention 后端;SM100,也就是 NVIDIA Blackwell 数据中心这一代 GPU,以及采用多头潜在注意力(MLA,一种压缩 KV 的设计)的模型,则从列表中的其他选项开始选择116。
FlashAttention 路径分为两次调用:先把新键和值写入指定槽位117,再对展平后的查询执行注意力计算。第二次调用会传入每个请求的起始位置,并用块表提供 KV 索引118。
源码入口:后端名为 FLASH_ATTN;reshape_and_cache_flash 将 KV 写入 slot_mapping 指定的位置;flash_attn_varlen_func 读取缓存,接收 cu_seqlens_q 和 block_table。
SGLang。对于标准多头注意力模型,在安装较新 CUDA 的 Hopper GPU,也就是 H100 这一代硬件上,默认注意力后端是 FA3。其他 GPU,包括 SM100,使用其他分支119。
FA3 同样分两次调用:先将新键和值写入批次指定的缓存位置120,再把各层缓冲区组织为分页视图121,带上第 5 节介绍的映射表行,执行注意力计算122。
源码入口:set_kv_buffer、flash_attn_with_kvcache、page_table。
TensorRT-LLM。默认使用自身提供的注意力后端123。前向计算通过一个算子完成,接收块偏移、缓存池地址,以及是否更新缓存的标志124。vLLM 和 SGLang 将写入与读取分成两次调用,TensorRT-LLM 则交给同一个算子处理。
源码入口:attn_backend 为 TRTLLM,算子是 thop.attention,更新标志是 update_kv_cache。
三个引擎也会共享 kernel。不能仅凭仓库名称判断底层计算来自哪里。FlashInfer 中包含以 TensorRT-LLM 命名的注意力 kernel,另外两个引擎也会使用:vLLM 选中 FlashInfer 后端时,会从中导入批量 decode 和 prefill kernel125;SGLang 的一个后端也在文档中明确说明,调用的是 FlashInfer 中的同名注意力 kernel126。
源码入口:SGLang 的这个后端名为 trtllm_mha。
跨 GPU 通信:all-reduce。张量并行(Shoeybi 等,2019)将每层计算分到多张 GPU。对于行并行线性层,每张 GPU 只计算一部分结果,随后通过 all-reduce 在各 GPU 间求和,使每张卡都得到完整向量,继续后续计算。本文的四卡算例在每步的每一层都会执行这一操作;单卡则不需要。
- vLLM
仅在张量并行度大于一时,对行并行层的输出执行 all-reduce127。它使用针对这一场景编写的自定义 all-reduce kernel,而非 NVIDIA 通信库中的通用实现。禁用这一 kernel 的开关默认关闭128,因此 worker 会在启动时将其准备好129。源码入口: disable_custom_all_reduce,默认值为 false。 - SGLang
在行并行层中使用相同的判断条件130;除非显式禁用,否则同样采用自定义 all-reduce kernel131。源码入口: disable_custom_all_reduce,默认值为 false。 - TensorRT-LLM
为每个需要跨 GPU 汇总输出的线性层配置 all-reduce132,在矩阵乘法后立即调用133。默认由系统自动选择 all-reduce 算法134。源码入口: allreduce_strategy为 AUTO。
小结。每层计算中,注意力需要通过索引区分各请求,其余计算按展平后的数据行执行。三个引擎向注意力提供的信息相同:请求从哪里开始、历史 KV 存在哪里、新 KV 写到哪里;主要差别在于写入与读取分成两次调用,还是由一次调用完成。
7. CUDA graph:捕获与回放
每个 GPU kernel 都需要 CPU 发起一次启动调用。一个包含 80 层的前向过程,因此会产生大量 launch。decode 中,单个 kernel 的计算量较小,启动开销就更明显。CUDA graph 在形状和内存地址固定的条件下,记录一串 kernel 启动操作,之后通过一次调用回放。
难点在于形状必须匹配。为 8 个请求捕获的图,只能用于形状与之匹配的批次。因此,引擎在启动时会为一组大小分别捕获图;运行时,要么将批次填充(pad)到已捕获的大小,要么不用图。
prefill 的形状随提示词长度变化,处理起来更复杂。另一种做法是分段捕获:固定部分放进图,变化的操作留在段与段之间。三个引擎的差别,就在于哪些步骤能够回放。
vLLM 在默认优化级别下135,批次条件允许时使用完整图,否则使用分段图136。它以一步中的 token 数确定图大小,并将批次填充到下一个已捕获的大小137。
对于每个请求处理相同 decode token 数的批次,可以使用完整图;推测解码时,各请求的 token 数可能不同,见第 10 节。其他批次,包括包含 prefill 的批次,都视为非均匀批次138,存在匹配的分段图时就使用它139。超出最大捕获大小的批次不使用图140。回放通过一次调用完成141。
源码入口:优化级别为 O2,图模式为
FULL_AND_PIECEWISE。- SGLang
默认对 decode 使用完整图,对 prefill 分段捕获142。在 CUDA 平台上,这种 prefill 模式称为“breakable”,含义与分段图相同143。decode 批次只要不超过已捕获的最大大小,就可以回放144;运行器会调用对应大小的已捕获图145。 - TensorRT-LLM
默认启用 CUDA graph146,但只有不含 prefill 请求的批次才能使用147。填充默认关闭148,最大值未设置时取 128149。捕获的大小包括 1 到 31,以及 32、64、128150。不在这些大小中的批次不使用图151;匹配的批次则回放相应的图152。
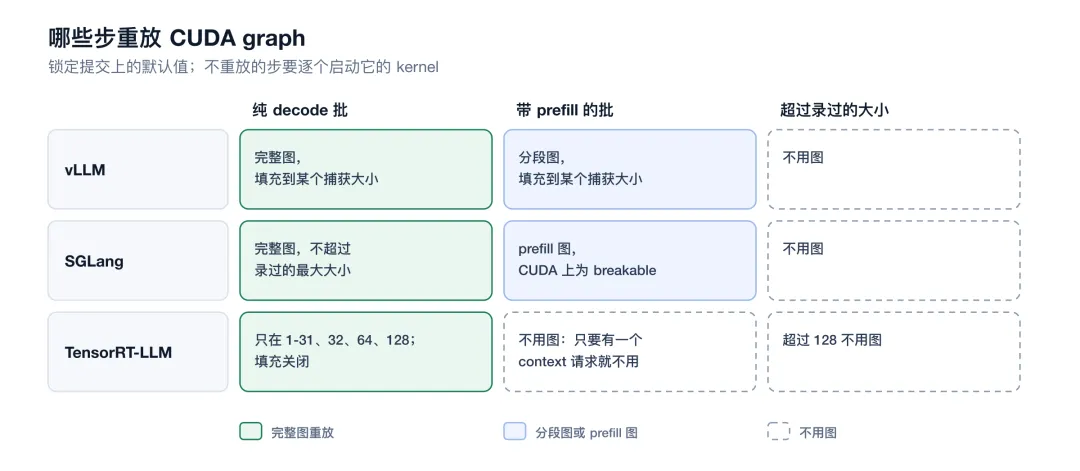
图 11|三个引擎分别在什么情况下回放 CUDA graph。
结合第 4 节,可以看到调度与 CUDA graph 之间的关系。TensorRT-LLM 的迭代只要包含 prefill,就不使用图153;填充关闭时,包含 40 个请求的 decode 批次也可能无法使用图154。SGLang 默认不在同一步中混合 prefill 和 decode155,因此 decode 步的形状稳定,只要批次不超过捕获上限就能回放。vLLM 的混合步骤则采用分段图156。
这些差异不足以判断哪个引擎在某种负载下更快,却能提供排查方向:CPU launch 开销意外升高时,先确认本轮计算是否能够回放 CUDA graph。
小结。CUDA graph 通过一次调用回放整步计算,但只能使用启动时捕获过的形状。是否能够使用图,与调度器如何组织批次直接相关,包含 prefill 的步骤尤其需要注意。
8. 计算 logits、采样并返回结果
最后一层结束后,展平批次中的各行都有隐藏状态。生成路径只对选定的行计算 logits,也就是词表中各个候选 token 的分数,不会处理所有行。这一步需要与词表大小有关的矩阵乘法。沿用第 1 节的范围:普通 decode 可以产生下一个输出 token;如果 prefill 仍未完成,本轮就还没有可返回的有效输出。
选择用于采样的行。在 vLLM 中,未使用推测解码时,取每个请求的最后一个位置,也就是下一个请求起始行的前一行157。logits 只根据这些行的隐藏状态计算158。源码入口:query_start_loc[1:] - 1。
选出用于计算 logits 的行,与请求是否已经能够返回一个有效输出 token,是两件事。未完成 prefill 的请求仍需继续处理输入。
采样。贪心采样直接对 logits 取 argmax。vLLM159 和 SGLang 的全贪心路径160都采用这种方式。随机采样则按概率选择下一个 token,通常先缩小候选范围:top-k 只保留概率最高的 k 个候选;top-p 保留累计概率达到 p 的最小候选集合。三个引擎都可以使用第 5 节介绍的 FlashInfer 采样 kernel,但启用条件不同。源码入口:vLLM 的 greedy_sample。
条件允许时,三个引擎都会使用 FlashInfer 执行 top-k 和 top-p。区别在于默认选择、何时回退到 PyTorch,以及哪些请求或环境条件会使 FlashInfer 路径失效。
- vLLM161
默认由采样器处理 top-k 和 top-p。在 CUDA 平台上,默认使用 FlashInfer kernel162。两种情况会绕过该路径:请求要求在 top-k/top-p 之后计算对数概率,或者当前 GPU/环境不支持 FlashInfer。前者由请求决定,后者涉及默认开启的环境开关163及 GPU 代际164。源码入口: flashinfer_sampler_supported()、VLLM_USE_FLASHINFER_SAMPLER。 - SGLang165
在 FlashInfer 可用时使用它,否则回退到 PyTorch。采用 FlashInfer 路径时,top-k 和 top-p 也由对应 kernel 执行166。源码入口: sampling_backend、top_k_top_p_sampling_from_probs。 - TensorRT-LLM167
的 sampler_type默认为 auto,非束搜索场景会选择 PyTorch 采样器168。只要能够导入 flashinfer,这个采样器就默认调用 FlashInfer 采样 kernel169。相应的禁用开关默认关闭170,top-k 和 top-p 也由 FlashInfer 执行171。源码入口:sampler_type为 auto,采样器是TorchSampler,开关是disable_flashinfer_sampling。
结果如何复制回 CPU。采样得到的 token ID 位于 GPU,CPU 需要根据它们安排下一步。同步复制会让 CPU 等待 GPU,因此三个引擎都使用非阻塞复制:把复制任务提交到一条流中,CPU 随后继续其他工作。流是一条按顺序执行的 GPU 工作队列;复制后记录一个事件,通过查询或等待这个事件,便能确认数据何时复制完成。
- vLLM
使用单独的流,以非阻塞方式将采样得到的 token ID 复制到 CPU172。提交复制任务后记录事件173,等到需要读取输出时,才等待这个事件完成174。 - SGLang
将结果异步复制到锁页主机内存,也就是允许 GPU 直接写入的主机内存175,其中包含下一个 token 的 ID176。CUDA 平台使用独立的复制流,使数据传输与下一次前向计算重叠177。复制后记录事件178,处理结果时先等待事件完成,再使用这些 token179。源码入口:事件名为 copy_done。 - TensorRT-LLM
以非阻塞方式将结果复制到主机180,同时在设备和主机上保留新 token,并附上已经记录的事件181。
通过这种方式,调度与执行可以重叠:GPU 仍在执行第 N 步时,CPU 已经开始安排第 N+1 步。三个引擎默认都会重叠执行调度与 GPU 计算。
- vLLM
默认开启重叠,除非配置了与之冲突的选项182。开启后,可以同时有两个批次处于处理过程中183。源码入口: async_scheduling。 - SGLang
默认开启重叠,因为对应的禁用开关默认关闭184。它的循环先提交当前批次,再处理上一批次的结果185。源码入口: disable_overlap_schedule。 - TensorRT-LLM
同样默认开启重叠186。循环先对新调度的批次执行前向计算,再用上一批次的结果更新请求187。源码入口: disable_overlap_scheduler。
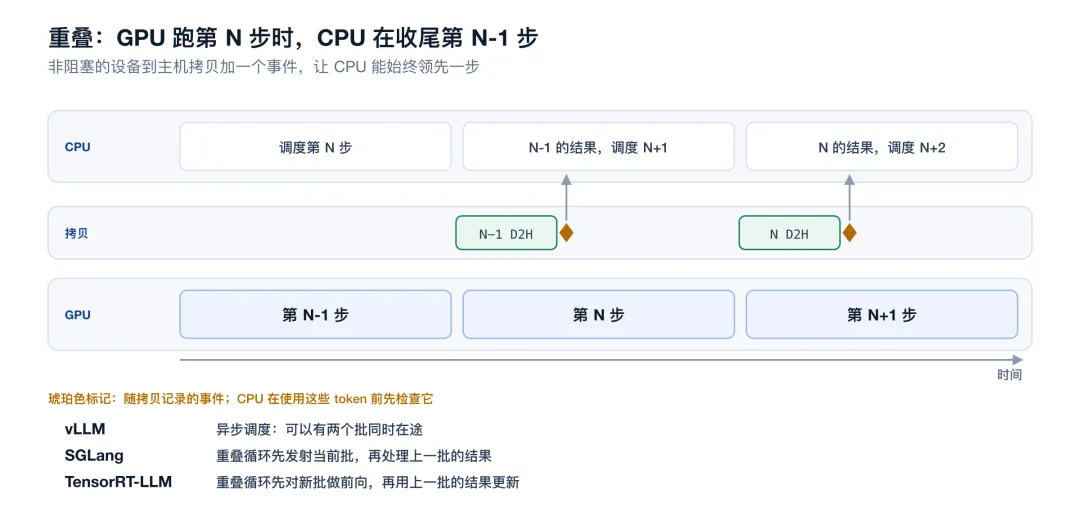
图 12|重叠执行:GPU 计算第 N 步时,CPU 处理第 N-1 步的结果。
调度、分配和构造元数据等 CPU 工作,被安排到 GPU 执行上一步期间。连续批处理要求每步重新组织批次,重叠执行则让这部分工作不再占用 GPU 的关键路径。
小结。生成路径从选定的隐藏状态行计算 logits、采样,再将结果返回 CPU;请求是否已有有效输出,仍取决于本轮是否完成 prefill 或普通 decode。非阻塞复制配合相应的结果处理路径,让 CPU 与 GPU 的部分工作能够重叠。
9. 还原文本并返回客户端
将 token ID 还原成文本,是第 3 节分词过程的逆向操作。三个引擎的区别在于:这一步反分词由哪个进程完成。
vLLM。引擎核心通过 ZMQ 将输出送回 API 服务器进程188。后台输出处理器取出结果189,增量 detokenizer 将其转换为下一段文本190。
SGLang。调度器将 token ID 流式发送给 detokenizer 进程191。该进程按批次执行反分词192,再将文本送回主进程193。
TensorRT-LLM。结果通过第二个 IPC 队列,返回服务器进程中的代理194。它支持设置独立的后处理进程来执行反分词,但默认未启用195,因此反分词由服务器进程中的结果对象完成196。
单卡默认配置下,输出路径在 vLLM 和 TensorRT-LLM 中各跨越一次进程边界;SGLang 因为单独设置了反分词进程,需要跨越两次197。请求尚未结束时,它会继续作为运行中的请求,参加下一步调度。
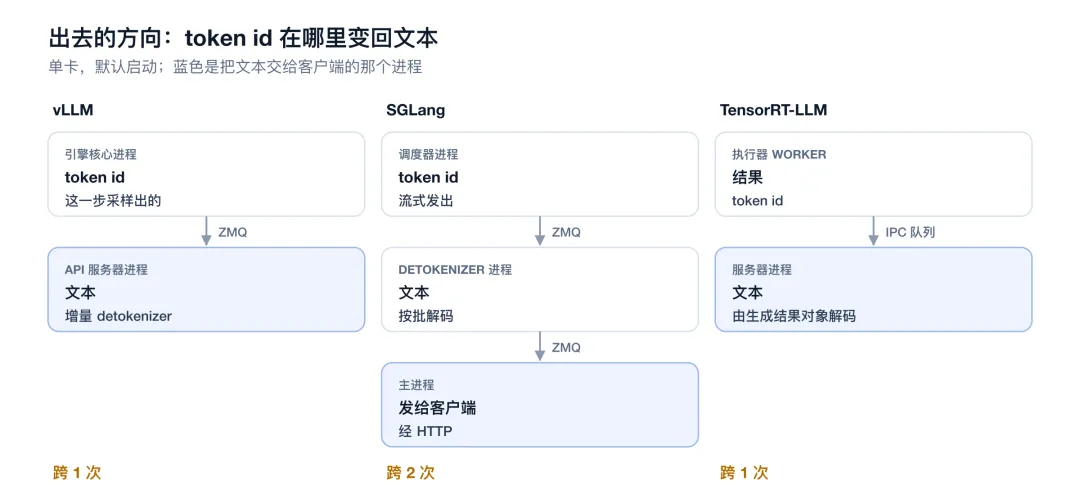
图 13|单卡默认配置下的输出路径:token ID 在哪个进程中还原为文本。
小结。SGLang 使用独立进程完成反分词;vLLM 和 TensorRT-LLM 则在 API 服务器或服务器进程中完成。输出返回后,未结束的请求继续下一轮处理。
10. 扩展功能改变了哪些执行环节
前面介绍的是最基本的执行循环。比较引擎时,通常还会关注推测解码、结构化输出、LoRA 适配器、量化、多 GPU 并行、prefill/decode 分离和 KV 卸载。这些能力没有另起一套循环,而是改变其中的一两个环节。
本节先说明每项功能影响哪个阶段,再列出三个引擎的配置项与默认状态。多数功能需要显式开启,例外会单独说明。
推测解码。草稿器可以是低成本模型,也可以通过查找已有文本,为请求提出几个候选 token。目标模型随后在一次前向计算中验证这些候选,保留它认可的最长前缀(Leviathan 等,2023;Chen 等,2023)。
这会改变两个阶段:第 4 节的调度器在一步中为同一个请求安排多个 token;第 8 节的采样器需要读取多行 logits,而不使用推测解码时只读取最后一行。
- vLLM
支持 n-gram、Medusa(Cai 等,2024)、草稿模型、suffix 和 EAGLE 系列(Li 等,2024)等方法;MTP,即多 token 预测(Gloeckle 等,2024;DeepSeek-AI,2024),也归在这一系列中198。三个引擎中,只有它的默认状态不是简单的“关闭”:模型检查点中的 speculators 配置可能启用这一功能,部分检查点自带草稿模型199。 - SGLang
通过 speculative_algorithm指定草稿器,内置选项包括 EAGLE 系列、MTP(在 SGLang 中称为 NEXTN)、独立草稿模型和 n-gram 等,默认值为空200。 - TensorRT-LLM
为不同草稿器提供相应的推测解码配置,包括 EAGLE、MTP、n-gram 和草稿模型等201,默认未设置202。
结构化输出。请求可以要求结果符合 JSON schema、正则表达式或语法约束。这会改变第 8 节的采样过程:在采样前屏蔽当前语法不允许的 token 的 logits,采样器只能从允许的候选中选择。
- vLLM
的结构化输出后端默认为 auto,支持 xgrammar(Dong 等,2025)、guidance、outlines 和 lm-format-enforcer203。语法位掩码在采样前作用于 logits204。 - SGLang
的 grammar_backend默认未设置205,随后解析为 xgrammar206。构造好的词表掩码会作用于 logits207。 - TensorRT-LLM
的 guided_decoding_backend可设为 xgrammar 或 llguidance,默认值为空208。未设置时,不会构建引导解码配置209,因此结构化输出处于关闭状态。设置后端后,引导解码器会直接屏蔽 logits 中不允许的 token210。
LoRA 适配器。LoRA(Hu 等,2022)为部分权重矩阵增加小规模的低秩更新,使多个微调变体能够共享基础权重(Sheng 等,2024;Chen 等,2024)。
它影响两个阶段:第 6 节的前向计算,需要为使用适配器的请求加入对应的更新;第 4 节的前缀缓存,需要区分采用不同适配器的请求,因为相同 token 在不同适配器下会得到不同的键和值。
- vLLM
的 enable_lora默认为 false211。 - SGLang
的 enable_lora默认未设置,提供适配器路径时启用212。 - TensorRT-LLM
的 enable_lora默认为 false213。
在前缀缓存中,vLLM 将 LoRA 请求的适配器名称加入块哈希214;TensorRT-LLM 则将 LoRA 任务 ID 纳入 BlockKey 比较215。本文没有追查 SGLang 如何在基数树中区分不同适配器。
量化。降低权重的存储位数,可以为第 2 节的 KV 池释放更多显存,也会改变第 6 节调用的矩阵乘法 kernel。降低 KV 缓存的存储位数,则直接改变第 2 节计算的每 token 字节数。三个引擎都不是默认一律关闭量化,而是在未另外指定时,从模型检查点读取格式。
- vLLM
未指定量化方法时,从模型配置中读取216。 cache_dtype默认为auto,即使用模型的数据类型217。 - SGLang
的 quantization默认未设置218,由模型检查点的配置解析得到219。kv_cache_dtype为auto时,使用模型的数据类型220。 - TensorRT-LLM
根据已量化的模型检查点更新量化配置221。KV 缓存数据类型为 auto时,沿用检查点中的 KV 量化配置222。
多 GPU 并行。模型分布到多张 GPU 后,第 3 节的进程组织会随之改变,每张 GPU 对应自己的 worker 进程;第 6 节的前向计算也会加入张量并行所需的 all-reduce。三个引擎默认都使用一张 GPU。
- vLLM
的 tensor_parallel_size和pipeline_parallel_size默认为 1223,enable_expert_parallel默认为 false224。 - SGLang
的 tp_size225、pp_size226 和ep_size227 默认都是 1。 - TensorRT-LLM
的 tensor_parallel_size228 和pipeline_parallel_size229 均默认为 1。多 GPU 运行时,每个 rank 启动一个 MPI worker230。
prefill/decode 分离。两个阶段可以由不同引擎实例执行:一个实例处理提示词,另一个生成 token。prefill 计算好的 KV 会传给 decode 实例(Zhong 等,2024;Patel 等,2024;Qin 等,2024)。第 4 节的组批由此分到两个实例中,两者之间增加一次 KV 传输。三个引擎都已实现这一功能,但默认关闭。
- vLLM
通过 kv_transfer_config启用该功能,配置 KV 连接器及本实例的角色231。连接器负责实际传输,已注册的实现包括对接 LMCache(KV 缓存层)和 NIXL(NVIDIA 传输库)的连接器232。 - SGLang
的 disaggregation_mode默认为 null233,传输后端默认使用 Mooncake 的实现(Qin 等,2024)234。 - TensorRT-LLM
提供独立的 disaggregatedserve 命令235。缓存收发器负责在实例间传输 KV,可选择 UCX、NIXL、Mooncake 或 MPI,默认均未设置236。
KV 卸载。第 4 节的 KV 池可以扩展到主机内存或存储中。被移出显存的块可以重新加载,而不必重算。三个引擎都实现了这项功能,默认关闭。
- vLLM
的 kv_offloading_size默认为空237。 - SGLang
的 enable_hierarchical_cache默认为 false238。 - TensorRT-LLM
的 host_cache_size默认为空239。
下表汇总各项功能影响的环节及对应配置项:
推测解码
改动的阶段:第 4、8 节
vLLM:speculative_config,或由 checkpoint 决定
SGLang:speculative_algorithm
TensorRT-LLM:speculative_config
结构化输出
改动的阶段:第 8 节
vLLM:由请求提出,后端 auto
SGLang:由请求提出,后端 xgrammar
TensorRT-LLM:guided_decoding_backend
LoRA
改动的阶段:第 4、6 节
vLLM:enable_lora
SGLang:enable_lora,或适配器路径
TensorRT-LLM:enable_lora
量化
改动的阶段:第 2、6 节
vLLM:来自 checkpoint
SGLang:来自 checkpoint
TensorRT-LLM:来自 checkpoint
并行
改动的阶段:第 3、6 节
vLLM:tensor_parallel_size、pipeline_parallel_size
SGLang:tp_size、pp_size、ep_size
TensorRT-LLM:tensor_parallel_size、pipeline_parallel_size
分离
改动的阶段:第 4 节
vLLM:kv_transfer_config
SGLang:disaggregation_mode
TensorRT-LLM:disaggregated 命令
KV 卸载
改动的阶段:第 4 节
vLLM:kv_offloading_size
SGLang:enable_hierarchical_cache
TensorRT-LLM:host_cache_size
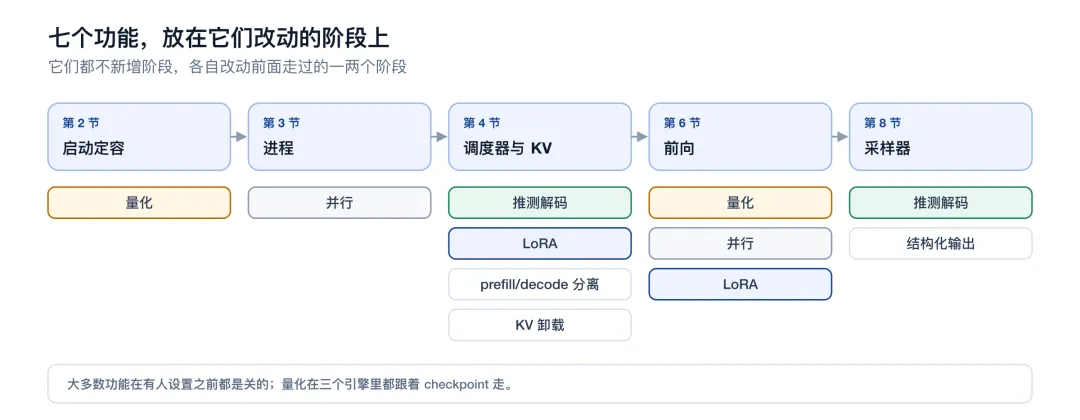
图 14:七个功能,放在它们改动的循环阶段上。
小结。这些功能作用于前面介绍的调度器、KV 池、前向计算或采样器,并不增加新的阶段,多数需要显式开启。三个引擎都根据模型检查点处理量化;vLLM 的检查点还可能启用推测解码。vLLM 与 SGLang 则支持按请求启用结构化输出,而不必另设服务端开关。
11. 默认值为什么不同,又该怎样理解
将三个引擎放在一起看
下表汇总前面各环节的实现。所有内容均对应固定提交版本的默认配置;TensorRT-LLM 的每一行都指默认 PyTorch 路径。
KV 显存比例(第 2 节)
vLLM:总显存的 0.92
SGLang:显存减去预留量,再除以显存
TensorRT-LLM:峰值之后空闲显存的 0.9
单卡时的进程(第 3 节)
vLLM:API 服务器;带 GPU worker 的引擎核心
SGLang:主进程;调度器;反分词进程
TensorRT-LLM:服务器进程;执行器 worker
组批(第 4 节)
vLLM:prefill 和 decode 共用一份 token 预算
SGLang:要么 prefill 步,要么 decode 步
TensorRT-LLM:context 与 generation 分为两个列表,在同一次迭代中执行
KV 粒度(第 4、5 节)
vLLM:16 token 一块,每层一个张量
SGLang:单 token 槽,每层各自的缓冲区
TensorRT-LLM:每块 32 个 token,覆盖同一缓存池中的各层;本算例为单池
注意力调用(第 6 节)
vLLM:先写后读:两次调用
SGLang:先写后读:两次调用
TensorRT-LLM:由同一个算子完成写入和读取
CUDA graph(第 7 节)
vLLM:均匀 decode 用完整图,其余用分段图
SGLang:decode 用完整图;prefill 用 breakable 图
TensorRT-LLM:不含 context 请求,且大小匹配已捕获配置的批次
结果复制与重叠执行(第 8 节)
vLLM:非阻塞加事件;默认重叠
SGLang:非阻塞加事件;默认重叠
TensorRT-LLM:非阻塞加事件;默认重叠
反分词(第 9 节)
vLLM:API 服务器进程
SGLang:单独的进程
TensorRT-LLM:服务器进程
20 项机制的默认状态
快照篇对同样的三个引擎,检查了另一组问题:20 项机制分别处于什么默认状态?这些机制包括连续批处理、分页式/块式 KV 内存、前缀/基数树缓存、分块预填充、权重量化、KV 缓存量化、推测解码、主机或磁盘 KV 卸载、KV 淘汰、混合专家模型的专家并行与放置、LoRA 多路复用、张量并行、流水线并行、prefill/decode 分离、数据并行注意力、缓存感知路由、负载均衡、准入控制、优先级调度与请求抢占,以及引擎挂起看门狗。
矩阵中的每个单元格记录以下四种状态之一:
default_on:不额外指定参数启动引擎时,该机制就会运行。 conditional_default:只有满足特定条件时才默认运行,例如模型或 GPU 支持该机制。 implemented_off:已有实现,但默认关闭,需要显式开启。 unresolved:已阅读的源码不足以确定状态。
其中,16 项机制在三个引擎中的状态相同,4 项不同。对每项差异,再区分三种原因:来自引擎结构的差异,归为架构;无需改变结构、只需调整某层默认值即可改变的,归为配置;现有源码证据无法确定的,记为原因未明。
只有源码证据能够确定三个引擎的对应状态时,才归入架构或配置。具体规则见附录 C。
分块预填充
vLLM:conditional_default
SGLang:conditional_default
TensorRT-LLM:implemented_off
类别:配置选择
推测解码
vLLM:conditional_default
SGLang:implemented_off
TensorRT-LLM:implemented_off
类别:配置选择
数据并行注意力
vLLM:unresolved
SGLang:implemented_off
TensorRT-LLM:implemented_off
类别:原因未明
引擎挂起看门狗
vLLM:unresolved
SGLang:default_on
TensorRT-LLM:default_on
类别:原因未明
四项差异中,两项被归为配置选择,两项仍然原因未明。本次审计没有确认哪一项由架构造成,但原因未明的两项也不能据此排除架构因素。
配置选择。三个调度器都实现了分块预填充,见第 4 节。vLLM 根据模型确定其默认值240,SGLang 根据 GPU 显存确定241,TensorRT-LLM 的 API 则将默认值设为 false242。
vLLM 的推测解码条件默认值,来自模型检查点中的 speculators 配置243,在参数层解析244;另外两个引擎的推测配置默认未设置245。因此,这里的决定来自读取检查点配置,而不是引擎结构。
原因未明。vLLM 的数据并行注意力状态尚未确定,本次阅读也没有补足证据。挂起看门狗方面,SGLang 和 TensorRT-LLM 都将其内置在引擎中246;已读到的 vLLM 源码,只显示启动器在引擎出错后才介入检查247,不足以判断引擎本身是否带有看门狗,因此仍不能解释这一差异。
架构原因:这四项中尚未确认。两项能够解释的差异,都追到了配置选择;另外两项仍然没有足够证据说明原因。另一方面,前面的源码阅读还展示了状态矩阵没有覆盖的实现差异,包括组批方式、KV 显存预算和 CUDA graph 的覆盖范围。它们中的一些可以通过配置改变,因此不能把实现不同直接当成架构上的限制。
相同标签,也可能由不同配置路径决定。前缀缓存没有参与差异归类,因为三个引擎都被记为 conditional_default。但继续查代码,就能看到相同状态背后的不同过程。
vLLM 的参数最初未设置,由函数根据模型支持情况补全248,对不含注意力的模型关闭249。SGLang 使用禁用标志,基数树缓存默认开启,除非某个条件将它关闭250;如果模型无法安全复用前向结果,模型钩子就会关闭缓存251。TensorRT-LLM 则默认开启块复用252,当注意力后端是某个 FlashInfer 变体时,由执行器将其关闭253。
最终都是一个“有条件默认启用”的状态,却由三个不同层面的代码决定。
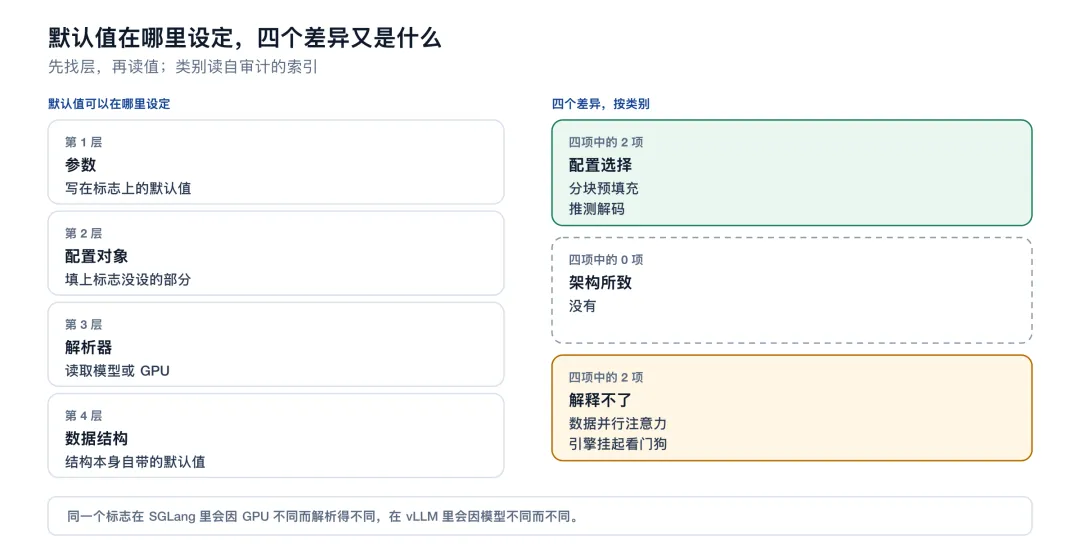
图 15|默认值的解析位置与四项差异的归类。未确认架构原因,不等于排除架构因素。
阅读引擎默认值时,可以按下面的顺序检查。这些步骤帮助定位实现,不用于给引擎排名。
- 先确认执行路径。
对 TensorRT-LLM,先判断采用哪个后端,见第 2 节,再检查该路径下的默认值。 - 先找解析位置,再读最终取值。
默认值可能定义在参数、配置对象、读取模型或 GPU 信息的解析器中,也可能由数据结构决定。一个配置项在 SGLang 中可能随硬件变化,在 vLLM 中则随模型变化;同样叫显存比例,也可能对应第 2 节介绍的三种计算方式。 - 区分“支持”和“默认运行”。
功能矩阵说明代码中存在某项机制。没有额外参数时它是否真的运行,还要看默认值在哪一层确定,以及那一层读取了什么条件。 - 写清实际生效的配置。
使用各引擎自身的默认设置进行比较,实际上是在比较不同配置:组批方式、分块策略、注意力后端和 CUDA graph 覆盖范围可能都不相同。这种比较仍有价值,但需要明确说明比较的是什么。
12. 本文的范围与限制
本文不做性能实测,也不对引擎排名。第 2 节的数字是明示假设下的手算,不是运行结果。本文不使用其他研究的测量结果或评分,也不代表任何雇主的立场。
关于引擎的结论只对应以下固定版本:vLLM v0.29.0(98dff2a8)、SGLang v0.5.19(0bcd8223)、TensorRT-LLM v1.2.1(376f7e1b)。涉及 kernel 时,只追踪到调用边界:引擎传给 flash_attn_varlen_func、flash_attn_with_kvcache 或 thop.attention 哪些参数,不深入 kernel 内部。
同一仓库中的外部路由组件,例如 SGLang 的 model gateway 和 TensorRT-LLM 的 serve router,不属于引擎内部,因此未纳入本文。SGLang 前端语言也不在范围内,它作为服务器的客户端运行,见第 1 节。
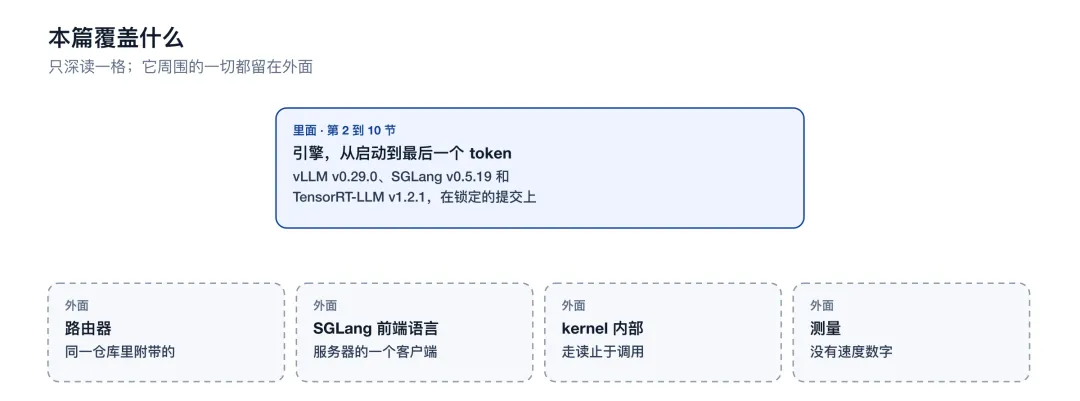
图 16|本文覆盖的执行范围,以及未纳入讨论的部分。
与本文最接近的是 Park 等(2026)的推理引擎综述,覆盖 25 个引擎,并提供矩阵与实验。那篇研究着重比较覆盖面,本文则选择三个引擎,沿执行路径深入查看。
该研究的矩阵没有标出每个单元格对应的引擎版本,将 TensorRT-LLM 的前缀缓存记为不支持;本文固定版本中的块复用却默认开启。两者考察的版本不同,并不是要据此判断谁对谁错。本文不使用该研究的评分或实测数据。
下面列出的论文供读者查阅机制的原始思想。具体到引擎实现的结论,以源码注为依据,而不以论文代替实现证据。
参考文献
以下论文介绍了本文涉及的机制,可作为进一步阅读的材料。正文在介绍相关思想时,以作者和年份标出对应文献。
Agrawal, A. et al. (2024). Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve. OSDI 2024. arXiv:2403.02310 Ainslie, J. et al. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP 2023. arXiv:2305.13245 Cai, T. et al. (2024). Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads. ICML 2024. arXiv:2401.10774 Chen, C. et al. (2023). Accelerating Large Language Model Decoding with Speculative Sampling. arXiv:2302.01318 Chen, L. et al. (2024). Punica: Multi-Tenant LoRA Serving. MLSys 2024. arXiv:2310.18547 Dao, T. et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv:2205.14135 DeepSeek-AI (2024). DeepSeek-V3 Technical Report. arXiv:2412.19437 Dong, Y. et al. (2025). XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models. MLSys 2025.arXiv:2411.15100 Gloeckle, F. et al. (2024). Better & Faster Large Language Models via Multi-token Prediction. ICML 2024. arXiv:2404.19737 Hu, E. J. et al. (2022). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022. arXiv:2106.09685 Kwon, W. et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023. arXiv:2309.06180 Leviathan, Y. et al. (2023). Fast Inference from Transformers via Speculative Decoding. ICML 2023. arXiv:2211.17192 Li, Y. et al. (2024). EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty. ICML 2024. arXiv:2401.15077 Park, S. et al. (2026). A Survey on Inference Engines for Large Language Models: Perspectives on Optimization and Efficiency. ACM TIST. arXiv:2505.01658,DOI 10.1145/3803798 Patel, P. et al. (2024). Splitwise: Efficient generative LLM inference using phase splitting. ISCA 2024. arXiv:2311.18677 Qin, R. et al. (2024). Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving. arXiv:2407.00079 Shah, J. et al. (2024). FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision. NeurIPS 2024. arXiv:2407.08608 Sheng, Y. et al. (2024). S-LoRA: Serving Thousands of Concurrent LoRA Adapters. MLSys 2024. arXiv:2311.03285 Shoeybi, M. et al. (2019). Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism. arXiv:1909.08053 Ye, Z. et al. (2025). FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving. MLSys 2025. arXiv:2501.01005 Yu, G.-I. et al. (2022). Orca: A Distributed Serving System for Transformer-Based Generative Models. OSDI 2022. Zheng, L. et al. (2024). SGLang: Efficient Execution of Structured Language Model Programs. NeurIPS 2024. arXiv:2312.07104 Zhong, Y. et al. (2024). DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving. OSDI 2024. arXiv:2401.09670
附录
A. 源码记录如何归档
正文关于引擎的每项结论,都需要对应固定提交上的源码记录,包括引擎名称、文件、行号范围、提交版本和摘录。引擎自带文档只用作背景材料。
记录沿用审计初稿的七个维度归档。正文虽然改为按执行阶段叙述,证据仍按以下维度组织:
- 进程拓扑:
默认启动哪些进程,各自负责什么,如何通信。 - 调度循环:
一次迭代如何执行,包括 CUDA graph 回放、采样和结果复制。 - KV 内存管理:
容量计算、布局、分配,以及用于前缀复用的数据结构。 - 批处理与分块预填充:
prefill 和 decode 如何共享批次,以及批次如何展平。 - 注意力与 kernel 后端:
可用后端及其选择方式,传给 kernel 的元数据与调用过程。 - 并行与分布式运行时:
并行执行如何启动和协调,包括 all-reduce。 - 配置与默认值:
每个默认值在哪里定义、在哪一层解析。
B. 源码索引
本文的每处引用,都对应 data/engines-2026/architecture-index.json 中的一条记录。索引共 468 条:179 条由两个模型提取,125 条从快照篇的证据迁入,另有 164 条来自作者阅读,用于支撑 GPU 执行路径及相关功能的介绍。
作者阅读的记录依据审计范围文件的 A3 至 A7 修订加入。每条记录都归入已有维度,不计入模型一致率,也不用于支持任何归类。模型提取的 179 条记录中,有 99 条与另一个模型的源码定位重叠。所有摘录都已与固定版本源码逐字核对。
C. 差异如何归类
两个模型系列 gpt-5.6-sol-medium 与 cursor-grok-4.6-low,按照事先固定的提要,独立提取各引擎在七个维度上的实现信息。两者看不到对方输出,也看不到本文和快照篇的数据。12 个问题的实质判断全部一致。
其中一个模型对 vLLM 的四项判断,源码位置偏移了一到两行,按提要规则丢弃。这四项事实各自仍有另一条通过检查的记录支持。
随后,两个模型分别对当时存在差异的五项机制归类。A8 修订后,差异项减为四项,见下文。最初三项类别一致,推测解码和挂起看门狗两项存在分歧。
两处分歧均对照源码裁决:推测解码归为配置,因为 vLLM 的默认值来自模型检查点配置;挂起看门狗仍记为原因未明,因为已阅读的 vLLM 源码不足以确定引擎是否内置看门狗。
原先类别一致的三项中,缓存感知路由被两个模型都归为原因未明。但快照篇 A8 修订后,这一项不再有引擎间差异,因此不参与最终归类,原始判断仍保留在日志中。裁决日志为 data/engines-2026/adjudication.json。
D. 快照篇的修订
撰写本文期间,快照篇中 TensorRT-LLM 的三个单元格作了修正,汇总计数不变。重新阅读默认 PyTorch 路径后,优先级调度改为 implemented_off,挂起看门狗改为 default_on;缓存感知路由改为 unresolved,因为唯一的证据来自引擎外部路由器。对应快照篇的 A6、A7、A8 修订,理由记录在快照篇的预注册文件中。
E. 术语表
- 激活值:
前向计算产生的中间张量。需要为其预留工作内存,峰值随批次大小变化。 - all-reduce:
在各 GPU 之间对张量求和,使每张 GPU 都得到完整的和。张量并行在每层中都需要执行一次。 - 块、页与槽:
KV 显存的分配单位。一个槽对应一个 token 的 KV;块或页对应固定数量 token 的 KV。默认情况下,vLLM 每块容纳 16 个 token,TensorRT-LLM 为 32 个,CUDA 平台上的 SGLang 为一个。 - BF16
:一种 16 位浮点格式,每个值 2 字节。 - 计算能力:
NVIDIA 为 GPU 硬件代际定义的版本号,kernel 库据此判断哪些 kernel 可以运行。 - CUDA graph:
捕获的一系列 GPU kernel 启动操作,在形状和内存地址固定时,可以通过一次调用回放。完整图覆盖整步计算;分段图,也称 breakable 图,将形状会变化的部分留在图外。 - 数据并行注意力:
将模型的注意力部分复制成多个数据并行副本,分别处理不同请求,其余层仍然分布在多张 GPU 上。 - prefill/decode 分离:
由不同引擎实例分别执行两个阶段,将 prefill 算好的 KV 传给 decode 实例。 - 执行路径:
实际运行模型的那套代码。TensorRT-LLM 提供多条路径,默认使用 PyTorch。 - 专家并行:
将混合专家模型中的不同专家放在不同 GPU 上。SGLang 对应配置为 ep_size。 - FA3、FlashAttention 与 FlashInfer:
注意力内核库,包括 FlashAttention(Dao 等,2022)、FlashAttention 3,即 FA3(Shah 等,2024),以及 FlashInfer(Ye 等,2025)。FlashInfer 还提供采样 kernel。 - 展平批次:
将各请求的新 token 首尾相接,每个 token 占一行,再用偏移记录各请求的起点。 - 分组查询注意力:
多个查询头共享一个 KV 头,因此缓存容量按 KV 头数计算(Ainslie 等,2023)。 - 头维度:
一个注意力头中键、值或查询向量的长度,本文算例为 128。 - HND 与 NHD:
KV 缓冲区的两种维度顺序,分别以头或 token 槽作为首个维度。 - HTTP、JSON 与 server-sent events:
客户端通过 HTTP 发送 JSON 请求;流式结果以 server-sent events(服务器推送事件)返回,每段文本对应一条消息。 - Hopper 与 SM100:
NVIDIA 的 GPU 代际标识。Hopper 对应 H100 这一代,SM100 对应 Blackwell 数据中心这一代。 - 索引:
记录各请求历史 token 所在的物理 KV 位置。vLLM 使用块表,SGLang 使用请求到 token 的映射表,TensorRT-LLM 使用块偏移。 - IPC、ZMQ 与 MPI:
进程间通信涉及的机制与工具。IPC 指同机进程间通信,ZMQ 是消息通信库,MPI 是多 GPU 作业中常用的消息传递系统。 - kernel:
运行在 GPU 上的函数,由 CPU 发起启动调用。 - logits:
词表中每个词对应的分数,用于选择下一个 token。 - LoRA:
为部分权重矩阵加入低秩适配器,使多个微调变体共享基础权重。 - 非阻塞复制、流与事件:
流是顺序执行 GPU 工作的队列。提交非阻塞复制后,CPU 可以继续其他工作;事件用于标记进度,CPU 查询或等待事件,即可确认复制是否完成。 - 流水线并行:
将模型层分成连续的几组,放到不同 GPU 上。配置项包括 pipeline_parallel_size和pp_size。 - 锁页内存:
固定在物理内存中的主机内存,GPU 可以直接向其中复制数据。 - 抢占:
暂停正在运行的请求,回收它的 KV 块;恢复运行时,重新计算其 KV。 - 量化:
用更少的位存储权重或 KV,格式通常从模型检查点读取。 - 基数树:
从根出发的路径表示 token 序列,沿路径查找,可以找到新请求最长的已缓存前缀。 - 行并行层:
分布在多张 GPU 上的线性层。每张卡计算部分结果,再通过 all-reduce 求和。 - 推测解码:
草稿器通过小模型或查找已有文本,先提出若干 token,再由目标模型在一次前向计算中验证,保留认可的最长前缀。涉及的执行阶段见第 10 节。 - 结构化输出:
采样前屏蔽语法不允许的 token 的 logits,使结果符合 schema、正则表达式或语法约束。TensorRT-LLM 称之为引导解码(guided decoding)。 - 张量并行:
将每层计算分到多张 GPU,每张持有其中一部分。配置项包括 tensor_parallel_size和tp_size。 - top-k 与 top-p:
两种限制随机采样候选范围的方法,分别保留概率最高的 k 个 token,或累计概率达到 p 的最小 token 集合。 - Triton:
一种使用 Python 编写 GPU kernel 的语言。 - world size:
一份模型使用的 GPU 数量。vLLM 将其定义为张量并行度 × 流水线并行度;单卡默认配置下为一。
源码索引
每个编号都指向固定提交中的源码位置,可在附录 B 所述索引中找到对应记录。
vllm/entrypoints/openai/chat_completion/api_router.py:41-42↩︎python/sglang/srt/entrypoints/http_server.py:1734-1735↩︎python/sglang/lang/api.py:75,python/sglang/lang/api.py:236,python/sglang/lang/interpreter.py:370↩︎tensorrt_llm/__init__.py:1-2↩︎tensorrt_llm/serve/openai_server.py:270-272↩︎tensorrt_llm/llmapi/llm.py:1188↩︎tensorrt_llm/llmapi/llm.py:1082-1083↩︎tensorrt_llm/commands/serve.py:295-302↩︎tensorrt_llm/executor/base_worker.py:197-203↩︎tensorrt_llm/commands/serve.py:295-302↩︎tensorrt_llm/commands/serve.py:202-207↩︎vllm/v1/worker/gpu_worker.py:551-557↩︎vllm/config/cache.py:111-114↩︎vllm/v1/worker/utils.py:516-523↩︎vllm/v1/worker/gpu_worker.py:606-610↩︎vllm/v1/worker/gpu_worker.py:565-577↩︎vllm/envs.py:2105-2107↩︎vllm/v1/core/kv_cache_utils.py:1437-1441↩︎python/sglang/srt/environ.py:554,python/sglang/srt/arg_groups/overrides.py:1750-1757↩︎python/sglang/srt/arg_groups/memory_hook.py:231-237↩︎python/sglang/srt/arg_groups/memory_hook.py:249-267↩︎python/sglang/srt/mem_cache/kv_cache_configurator.py:2007-2021↩︎python/sglang/srt/model_executor/pool_configurator.py:427-436↩︎tensorrt_llm/_torch/pyexecutor/_util.py:353-358↩︎tensorrt_llm/_torch/pyexecutor/_util.py:382-385↩︎tensorrt_llm/llmapi/llm_args.py:1650-1651↩︎tensorrt_llm/_torch/pyexecutor/_util.py:125-126↩︎tensorrt_llm/_torch/pyexecutor/resource_manager.py:808-817↩︎tensorrt_llm/_torch/pyexecutor/resource_manager.py:840-848↩︎vllm/v1/worker/gpu_worker.py:606-610↩︎python/sglang/srt/arg_groups/memory_hook.py:249-267↩︎vllm/v1/kv_cache_interface.py:253-269↩︎vllm/v1/kv_cache_interface.py:401-412↩︎vllm/v1/attention/backends/flash_attn.py:1232-1235↩︎vllm/config/cache.py:79-81,vllm/config/cache.py:309-318↩︎python/sglang/srt/mem_cache/memory_pool.py:2153-2162↩︎python/sglang/srt/environ.py:546↩︎python/sglang/srt/mem_cache/memory_pool.py:2098-2109↩︎python/sglang/srt/arg_groups/overrides.py:1389-1399↩︎cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp:937-938↩︎tensorrt_llm/llmapi/llm_args.py:1711-1712↩︎vllm/v1/kv_cache_interface.py:401-412↩︎vllm/config/cache.py:111-114,vllm/v1/worker/gpu_worker.py:606-610↩︎python/sglang/srt/arg_groups/memory_hook.py:249-267,python/sglang/srt/mem_cache/kv_cache_configurator.py:2007-2021↩︎tensorrt_llm/_torch/pyexecutor/_util.py:125-126↩︎vllm/v1/worker/utils.py:516-523↩︎python/sglang/srt/arg_groups/memory_hook.py:249-267↩︎tensorrt_llm/_torch/pyexecutor/_util.py:125-126↩︎vllm/entrypoints/openai/chat_completion/api_router.py:69-80↩︎vllm/entrypoints/llm.py:67-74↩︎python/sglang/srt/entrypoints/engine.py:219-231↩︎tensorrt_llm/llmapi/llm.py:1188↩︎vllm/entrypoints/cli/serve.py:150-153↩︎vllm/v1/engine/async_llm.py:155-163↩︎vllm/v1/engine/async_llm.py:440-442↩︎vllm/v1/engine/core_client.py:503-511↩︎vllm/config/parallel.py:987-988,vllm/v1/executor/uniproc_executor.py:50-69↩︎vllm/config/parallel.py:334-335↩︎vllm/v1/executor/multiproc_executor.py:189-200↩︎vllm/config/parallel.py:943-949↩︎python/sglang/srt/entrypoints/http_server.py:2800-2810↩︎python/sglang/srt/managers/tokenizer_manager.py:961-966↩︎python/sglang/srt/managers/tokenizer_manager.py:1571↩︎python/sglang/srt/managers/tokenizer_manager.py:553-562↩︎tensorrt_llm/llmapi/llm.py:498-500↩︎tensorrt_llm/llmapi/llm.py:546-547↩︎tensorrt_llm/executor/executor.py:532-543↩︎tensorrt_llm/executor/proxy.py:64-74↩︎tensorrt_llm/executor/proxy.py:125-132↩︎vllm/v1/core/sched/scheduler.py:501-512↩︎vllm/v1/core/sched/scheduler.py:550-553↩︎vllm/config/scheduler.py:130-136↩︎python/sglang/srt/managers/scheduler.py:3445-3455↩︎python/sglang/srt/server_args.py:903-907↩︎python/sglang/srt/server_args.py:756-760↩︎tensorrt_llm/_torch/pyexecutor/scheduler.py:273-282↩︎tensorrt_llm/_torch/pyexecutor/scheduler.py:140-148↩︎vllm/v1/core/sched/scheduler.py:984-999↩︎vllm/engine/arg_utils.py:2762-2774↩︎python/sglang/srt/managers/schedule_policy.py:1160-1171↩︎python/sglang/srt/arg_groups/memory_hook.py:61-149↩︎tensorrt_llm/llmapi/llm_args.py:2003-2007↩︎vllm/v1/core/block_pool.py:170-184↩︎vllm/v1/core/sched/scheduler.py:475-477↩︎vllm/v1/core/sched/scheduler.py:1077-1080↩︎vllm/v1/core/sched/scheduler.py:655-662↩︎vllm/v1/core/sched/scheduler.py:668-678↩︎python/sglang/srt/managers/schedule_batch.py:1451-1454↩︎python/sglang/srt/managers/schedule_batch.py:2548-2551↩︎python/sglang/srt/mem_cache/allocation.py:333-334↩︎python/sglang/srt/mem_cache/allocation.py:353-366↩︎tensorrt_llm/_torch/pyexecutor/py_executor.py:1661↩︎tensorrt_llm/_torch/pyexecutor/resource_manager.py:489-492↩︎tensorrt_llm/_torch/pyexecutor/resource_manager.py:516↩︎vllm/v1/core/kv_cache_utils.py:642-648↩︎vllm/v1/core/block_pool.py:33-59↩︎python/sglang/srt/mem_cache/radix_cache.py:377-388↩︎cpp/include/tensorrt_llm/batch_manager/kvCacheManager.h:200-211↩︎cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp:204-209↩︎vllm/v1/worker/gpu_model_runner.py:1993-1995↩︎vllm/v1/worker/gpu_model_runner.py:1997-2005↩︎vllm/v1/worker/gpu_model_runner.py:2088-2095↩︎vllm/v1/worker/gpu_model_runner.py:2208-2210↩︎vllm/v1/worker/gpu_model_runner.py:2213-2217↩︎vllm/v1/worker/block_table.py:214-223↩︎vllm/v1/worker/gpu_model_runner.py:2464-2477↩︎python/sglang/srt/model_executor/forward_batch_info.py:104-111↩︎python/sglang/srt/mem_cache/memory_pool.py:272-281↩︎python/sglang/srt/layers/attention/flashattention_backend.py:1026-1028↩︎python/sglang/srt/layers/attention/flashinfer_backend.py:1748-1757↩︎tensorrt_llm/_torch/attention_backend/trtllm.py:979-980↩︎tensorrt_llm/_torch/attention_backend/trtllm.py:998-1001↩︎vllm/config/cache.py:79-81,tensorrt_llm/llmapi/llm_args.py:1711-1712↩︎vllm/v1/worker/block_table.py:214-223↩︎python/sglang/srt/arg_groups/overrides.py:1389-1399↩︎vllm/platforms/cuda.py:156-163↩︎vllm/v1/attention/backends/flash_attn.py:1244-1253↩︎vllm/v1/attention/backends/flash_attn.py:1162-1176↩︎python/sglang/srt/arg_groups/model_override_base.py:298-309↩︎python/sglang/srt/layers/attention/flashattention_backend.py:1330-1337↩︎python/sglang/srt/layers/attention/flashattention_backend.py:1199-1212↩︎python/sglang/srt/layers/attention/flashattention_backend.py:1565-1573↩︎tensorrt_llm/llmapi/llm_args.py:2805-2809↩︎tensorrt_llm/_torch/attention_backend/trtllm.py:500-528↩︎vllm/v1/attention/backends/flashinfer.py:19-20↩︎python/sglang/srt/layers/attention/trtllm_mha_backend.py:4↩︎vllm/model_executor/layers/linear.py:1766-1769↩︎vllm/config/parallel.py:212-213↩︎vllm/v1/worker/gpu_worker.py:1484↩︎python/sglang/srt/layers/linear.py:1673-1692↩︎python/sglang/srt/server_args.py:1990-1997↩︎tensorrt_llm/_torch/modules/linear.py:2152-2154↩︎tensorrt_llm/_torch/modules/linear.py:2325-2328↩︎tensorrt_llm/llmapi/llm_args.py:2905-2908↩︎vllm/config/vllm.py:419↩︎vllm/config/vllm.py:285-301↩︎vllm/v1/cudagraph_dispatcher.py:82-91↩︎vllm/v1/cudagraph_dispatcher.py:141-148↩︎vllm/v1/cudagraph_dispatcher.py:307-318↩︎vllm/v1/cudagraph_dispatcher.py:274-281↩︎vllm/compilation/cuda_graph.py:360-361↩︎python/sglang/srt/model_executor/cuda_graph_config.py:143-152↩︎python/sglang/srt/model_executor/cuda_graph_config.py:112-121↩︎python/sglang/srt/model_executor/runner/decode_cuda_graph_runner.py:713-717↩︎python/sglang/srt/model_executor/runner/decode_cuda_graph_runner.py:1479↩︎tensorrt_llm/llmapi/llm_args.py:2777-2778↩︎tensorrt_llm/_torch/pyexecutor/scheduler.py:33-35↩︎tensorrt_llm/llmapi/llm_args.py:119-120↩︎tensorrt_llm/llmapi/llm_args.py:3160-3164↩︎tensorrt_llm/llmapi/llm_args.py:146-149↩︎tensorrt_llm/_torch/pyexecutor/cuda_graph_runner.py:261-271↩︎tensorrt_llm/_torch/pyexecutor/cuda_graph_runner.py:397↩︎tensorrt_llm/_torch/pyexecutor/scheduler.py:33-35↩︎tensorrt_llm/_torch/pyexecutor/cuda_graph_runner.py:261-271↩︎python/sglang/srt/managers/scheduler.py:3445-3455↩︎vllm/v1/cudagraph_dispatcher.py:307-318↩︎vllm/v1/worker/gpu_model_runner.py:2272↩︎vllm/v1/worker/gpu_model_runner.py:4559-4560↩︎vllm/v1/sample/sampler.py:241-242↩︎python/sglang/srt/layers/sampler.py:153-161↩︎vllm/v1/sample/sampler.py:286-292↩︎vllm/v1/sample/ops/topk_topp_sampler.py:93-102↩︎vllm/envs.py:856-860↩︎vllm/v1/sample/ops/topk_topp_sampler.py:53-63↩︎python/sglang/srt/arg_groups/overrides.py:1019-1026↩︎python/sglang/srt/layers/sampler.py:299-316↩︎tensorrt_llm/llmapi/llm_args.py:2810-2811↩︎tensorrt_llm/_torch/pyexecutor/_util.py:964-982↩︎tensorrt_llm/_torch/pyexecutor/sampler.py:951-956,tensorrt_llm/_torch/flashinfer_utils.py:19-22↩︎tensorrt_llm/llmapi/llm_args.py:2974-2975↩︎tensorrt_llm/_torch/pyexecutor/sampling_utils_flashinfer.py:159-173↩︎vllm/v1/worker/gpu_model_runner.py:322-328↩︎vllm/v1/worker/gpu_model_runner.py:347↩︎vllm/v1/worker/gpu_model_runner.py:355↩︎python/sglang/srt/managers/utils.py:31-41↩︎python/sglang/srt/managers/utils.py:154↩︎python/sglang/srt/managers/scheduler.py:4121-4129↩︎python/sglang/srt/managers/utils.py:178↩︎python/sglang/srt/managers/scheduler_components/batch_result_processor.py:249-250↩︎tensorrt_llm/_torch/pyexecutor/sampler.py:813-815↩︎tensorrt_llm/_torch/pyexecutor/sampler.py:1904-1909↩︎vllm/config/scheduler.py:179-182,vllm/config/vllm.py:1262-1311↩︎vllm/config/vllm.py:559-568↩︎python/sglang/srt/server_args.py:885-892↩︎python/sglang/srt/managers/scheduler.py:1889-1900↩︎tensorrt_llm/llmapi/llm_args.py:2791-2795↩︎tensorrt_llm/_torch/pyexecutor/py_executor.py:1712-1720↩︎vllm/v1/engine/core_client.py:503-511↩︎vllm/v1/engine/async_llm.py:761-765↩︎vllm/v1/engine/output_processor.py:406-407↩︎python/sglang/srt/managers/scheduler_components/output_streamer.py:118-124↩︎python/sglang/srt/managers/detokenizer_manager.py:273-276↩︎python/sglang/srt/managers/detokenizer_manager.py:177-184↩︎tensorrt_llm/executor/proxy.py:133-144↩︎tensorrt_llm/llmapi/llm_args.py:2077-2080↩︎tensorrt_llm/executor/result.py:653-654↩︎python/sglang/srt/entrypoints/engine.py:970-980↩︎vllm/config/speculative.py:68-81↩︎vllm/transformers_utils/config.py:661-672↩︎python/sglang/srt/server_args.py:2070-2075↩︎tensorrt_llm/llmapi/llm_args.py:1608-1618↩︎tensorrt_llm/llmapi/llm_args.py:2051-2053↩︎vllm/config/structured_outputs.py:12-21↩︎vllm/v1/worker/gpu_model_runner.py:4657-4664↩︎python/sglang/srt/server_args.py:1698-1705↩︎python/sglang/srt/arg_groups/serving_hook.py:217-222↩︎python/sglang/srt/constrained/base_grammar_backend.py:158-159↩︎tensorrt_llm/llmapi/llm_args.py:2009-2010↩︎tensorrt_llm/_torch/pyexecutor/py_executor_creator.py:199-215↩︎tensorrt_llm/_torch/pyexecutor/guided_decoder.py:300-307↩︎vllm/engine/arg_utils.py:655-657↩︎python/sglang/srt/server_args.py:2954-2998↩︎tensorrt_llm/llmapi/llm_args.py:1996-2000↩︎vllm/v1/core/kv_cache_utils.py:542-554↩︎cpp/tensorrt_llm/batch_manager/kvCacheManager.cpp:198-202↩︎vllm/config/model.py:1314-1318↩︎vllm/config/cache.py:119-120↩︎python/sglang/srt/server_args.py:570-578↩︎python/sglang/srt/configs/model_config.py:1558-1611↩︎python/sglang/srt/server_args.py:592-618↩︎tensorrt_llm/llmapi/llm_utils.py:319-347↩︎tensorrt_llm/llmapi/llm_args.py:1699-1701,tensorrt_llm/_torch/pyexecutor/model_loader.py:57-63↩︎vllm/config/parallel.py:122-125↩︎vllm/config/parallel.py:163-185↩︎python/sglang/srt/server_args.py:937-944↩︎python/sglang/srt/server_args.py:953-960↩︎python/sglang/srt/server_args.py:2357-2365↩︎tensorrt_llm/llmapi/llm_args.py:1923-1927↩︎tensorrt_llm/llmapi/llm_args.py:1938-1943↩︎tensorrt_llm/llmapi/llm.py:207-218↩︎vllm/engine/arg_utils.py:738-741,vllm/config/kv_transfer.py:102-110↩︎vllm/distributed/kv_transfer/kv_connector/factory.py:164-180↩︎python/sglang/srt/server_args.py:3178-3181↩︎python/sglang/srt/server_args.py:3183-3190↩︎tensorrt_llm/commands/serve.py:646-687↩︎tensorrt_llm/llmapi/llm_args.py:1807-1815↩︎vllm/config/cache.py:241-250↩︎python/sglang/srt/server_args.py:2717-2739↩︎tensorrt_llm/llmapi/llm_args.py:1655-1660↩︎vllm/engine/arg_utils.py:2762-2774↩︎python/sglang/srt/arg_groups/memory_hook.py:61-149↩︎tensorrt_llm/llmapi/llm_args.py:2003-2007↩︎vllm/transformers_utils/config.py:661-672↩︎vllm/engine/arg_utils.py:1936-1952↩︎python/sglang/srt/server_args.py:2070-2075,tensorrt_llm/llmapi/llm_args.py:2051-2053↩︎python/sglang/srt/server_args.py:1192-1201,tensorrt_llm/_torch/pyexecutor/py_executor.py:294-302↩︎vllm/entrypoints/launchers/launcher.py:180-189↩︎vllm/engine/arg_utils.py:2762-2769↩︎vllm/config/model.py:2128-2142↩︎python/sglang/srt/server_args.py:854-861↩︎python/sglang/srt/arg_groups/model_hook.py:593-617↩︎tensorrt_llm/llmapi/llm_args.py:1628-1635↩︎tensorrt_llm/_torch/pyexecutor/py_executor_creator.py:260-265↩︎