ARTICLE · 1185240
AI SSD :1000 万 IOPS 还是 245TB?
一、KV Cache 成了独立的存储类别,理想的介质却已经死了
大模型推理跟训练最大的区别是:推理每一分每一秒都在发生,而且它有一块只会变大、不会变小的状态——KV Cache。
KV Cache 存的是注意力计算产生的中间结果,随上下文长度增加而急剧增长,不随参数量增长。一个跑了五十轮对话的智能体,脑子里那几百万 token 的中间状态省不掉,只能存着备用。亚马逊云科技 8 月 12 日的工程博客实测,2,048 个 token 的 KV 是 109MB。
HBM 就那么多。微软 10 月 12 日公布的 Maia 300,8 颗 HBM4 一共 288GB,已经是量产芯片里的顶级配置,权重还要先占掉一大块。
KV Cache 因此被挤出了 GPU,变成一个独立的存储类别。铠侠在 GTC 2026 上说得很直接:智能体和子智能体可能在几分钟内创建、消费 KV Cache、然后销毁,这个读写模式跟过去任何企业级负载都对不上。
这里有个常被跳过的前提。理论上最适合干这活的不是 NAND,是存储级内存(SCM)——时延接近 DRAM,寿命和容量又比 DRAM 好。英特尔 Optane 本来是那个角色。The Register 今年 7 月 28 日那篇的标题就是《Optane 的安魂曲:英特尔本可以缓解内存涨价的 KV Cache 杀手》。产品线没了,行业只能拿 NAND 硬凑。
而 NAND 内部随即裂成了两档。这是理解 AI SSD 的关键。
信源:
AWS Machine Learning Blog https://aws.amazon.com/blogs/machine-learning/tiered-kv-cache-for-large-llms-on-amazon-sagemaker-hyperpod-with-curvine/
ServeTheHome(铠侠 GP Series 与 CM9)https://www.servethehome.com/kioxia-gp-series-and-cm9-launched-for-the-era-of-agentic-ai-storage/
The Register 2026-07-28《A requiem for Optane, Intel's KV cache killer that could have eased the RAM price crunch》
二、需求分两档:延迟层和容量层
延迟层——当 HBM 的延伸
介质用 XL-FLASH 这类低时延闪存,SLC 起步,拿密度换时延和 IOPS。访问粒度细到 512 字节,传统 NVMe 最小是 4K——细四倍是为了在喂注意力头激活和 KV Cache 查询时把 PCIe 总线喂满。寿命按几十 DWPD 设计。容量小,不追求大。代表是铠侠 GP1。
容量层——当 KV Cache 的仓库
介质用 QLC、TLC,追求单盘容量和每瓦 TB 数。访问粒度回到 4K。寿命 0.6 到 3 DWPD。容量往百 TB 级走。代表是美光 6600 ION、铠侠 CM10 和 CM9、Solidigm D5-P5336、三星 BM1773。
两档的指标差着一个量级。铠侠 GP1 今年 8 月 3 日公布,随机读最高 1000 万 IOPS(512 字节块)、寿命最高 50 DWPD;同门的 CM10 是 332 层 TLC、容量到 61.44TB、读密集 1 DWPD。美光 6600 ION 更极端:245.76TB,4K 随机写只有 0.075 DWPD。
拿容量层的寿命指标去要求延迟层,或者拿延迟层的 IOPS 去要求容量层,都会得出错误结论。这两档服务的是同一个问题的两个半边:延迟层管"读得快",容量层管"存得下"。
信源:
StorageReview(铠侠 GP1)https://www.storagereview.com/news/kioxia-gp1-series-hits-10-million-random-read-iops-on-xl-flash-gen-2
StorageReview(铠侠 CM10)https://www.storagereview.com/news/kioxia-cm10-is-its-first-pcie-6-0-enterprise-ssd-aimed-at-nvidia-cmx-kv-cache
StorageReview(美光 6600 ION 245TB 评测)https://www.storagereview.com/review/micron-6600-ion-245tb-ssd-review-a-quarter-petabyte-per-drive-bay
ServeTheHome(铠侠 GP Series 与 CM9)https://www.servethehome.com/kioxia-gp-series-and-cm9-launched-for-the-era-of-agentic-ai-storage/
三、产品谱系
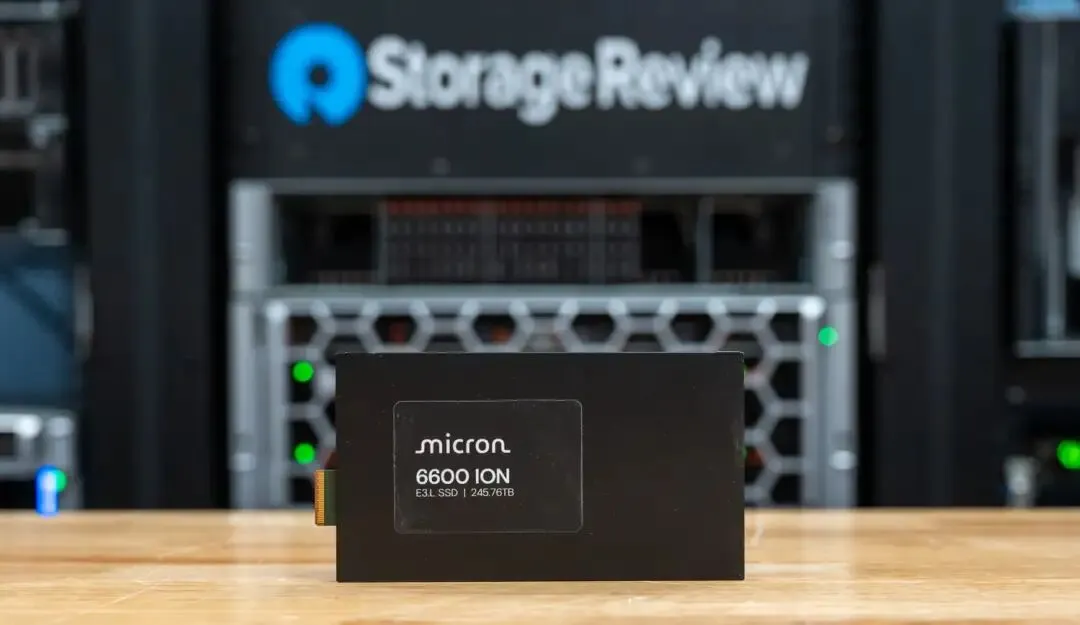
美光 6600 ION 245.76TB,容量层代表,图源美光
延迟层,海外目前基本是铠侠一家。GP1 是 PCIe 6.0、NVMe 2.2,用第二代 XL-FLASH,形态有 E3.S、E1.S 9.5mm 和 15mm,E3.S 和 E1.S 9.5mm 上冷板液冷,但也都能跑普通风冷服务器。铠侠存储部门 SVP Neville Ichhaporia 把这叫"AI 内存墙",他的算法是:每 GB 成本比扩节点内的 HBM 或 DRAM 显著低。GP1 走 GPU 直连,不经过主机 CPU 转发。
这条路是英伟达在推。GTC 2026 上英伟达的 Storage-Next 架构要求 IOPS"提升一个数量级——1 亿",并且要能处理小块传输。Tech Times 5 月 19 日的报道说, Vera Rubin 会让 GPU 直接指挥存储,打开 16 倍 AI 内存容量的路径。
容量层就热闹了。美光 6600 ION 的 245.76TB 今年 5 月 5 日出货,G9 QLC,PCIe Gen5 x4,峰值功耗不超过 30 瓦。Solidigm 的 D5-P5336 是 122.88TB、192 层 QLC,7GB/s 顺序读、90 万 4K 随机读 IOPS、24 瓦、0.6 DWPD,一台戴尔 R7725xd 能塞进接近 3PB。铠侠 CM9 是 25.6TB、3 DWPD,ServeTheHome 折算下来相当于每天 76.8TB 写入。三星 9 月 16 日发布 BM1773,定位写的是"AI 数据中心超高密度存储"。
国内这边,延迟层还没有跟 GP1 同档的公开产品。容量层和主控侧动作不少:长江存储的 PE511 12.8TB 和 PE522 15.36TB,4K 随机读写都在 300 万 IOPS 以上;紫光闪芯 9 月 3 日发 E5300 企业级 PCIe 5.0 盘,顺序带宽最高 14GB/s;8 月 7 日国内首颗 CXL 3.1 主控和 PCIe 6.0 SSD 主控同步面世。主控上,ScaleFlux 的 FC6116 做到顺序读 28GB/s、700 万 4K 随机读 IOPS。
软件侧,华为 9 月 17 日在全联接大会发布 OceanStor M900,单集群 64PB KV Cache 容量、40TB/s 聚合带宽,官方称访问时延从毫秒级降到 60 微秒、支持每天 24 次写入、SSD 寿命延长 16 倍——这些数字全是华为自称,没有第三方复核。Lightbits 的 Inferra 走纯软件路线,官方口径是并发会话数提高 16 倍、上下文窗口开到 1000 万 token,还在客户 beta。阿里云的 KVCacheStore 配新一代 CPFS,官方数字是百 TB/s 级吞吐、亿级 IOPS、模型启动时间降 50%、AI 存储成本降 69%。
信源:
StorageReview(铠侠 GP1)https://www.storagereview.com/news/kioxia-gp1-series-hits-10-million-random-read-iops-on-xl-flash-gen-2
StorageReview(美光 6600 ION 245TB 评测)https://www.storagereview.com/review/micron-6600-ion-245tb-ssd-review-a-quarter-petabyte-per-drive-bay
StorageReview(CoreWeave 锁 Solidigm 供货)https://www.storagereview.com/news/coreweave-locks-in-solidigm-ssd-supply-as-flash-allocation-becomes-an-ai-cloud-problem
ServeTheHome(铠侠 GP Series 与 CM9)https://www.servethehome.com/kioxia-gp-series-and-cm9-launched-for-the-era-of-agentic-ai-storage/
Unite.AI(华为 OceanStor M900)https://www.unite.ai/oceanstor-m900-brings-pb-scale-context-memory-to-huawei-superpods/
StorageReview(Lightbits Inferra)https://www.storagereview.com/news/lightbits-inferra-kv-cache-engine-claims-16x-session-density-and-10m-token-contexts
存储在线(阿里云 KVCacheStore 与 CPFS)https://www.dostor.com/p/101198.html
三星 2026-09-16 发布 BM1773,定位"AI 数据中心超高密度存储"(samsung.com)
Tech Times 2026-05-19《Nvidia's Vera Rubin Will Let GPUs Command Storage Directly》
驱动之家 2026-08-10《4K随机读写3300K IOPS、双重加密!长江存储PE511 12.8TB企业级SSD图赏》
四、现在到哪一步了
两档的成熟度差得很远。
延迟层还在样品阶段。铠侠 GP1 今年年底才向选定客户送评测样品,官方自己标注了"仅功能验证,量产规格可能变化"。它也没有公布具体时延数字,StorageReview 明确写了这篇文章里查不到读写时延,只有"更低时延"和 512B 更细粒度这类定性说法。1 亿 IOPS 那一代,铠侠已经推到 2028 年,PCIe 7.0 生态同步定在 2028。
容量层已经量产,而且有生产级实测。AWS 那套三级 KV Cache,跨 Pod 命中率 100%,1,925 个 token 一个不落;跨节点读约 56 毫秒;单请求加速比从 1,000 token 时的 1.7 倍涨到 2,500 token 时的 2.7 倍。它也说清了边界:共享前缀不到 40% 不划算,1,000 token 以下跑一趟 SSD 跟重算差不多。
StorageReview 在戴尔 XE7740 上加四张 RTX PRO 6000 Blackwell 和八块 Solidigm D7-PS1030 做了实测:恢复会话的首 token 时延从 13.9 秒压到 3.2 秒,持续吞吐约 3 万 token/s,是纯显存配置的 2.2 倍。
市场的反应比技术快。TrendForce 的数据,2026 年第一季度全球企业级 SSD 收入 184.6 亿美元,创历史纪录,环比增长 86%。第三季度 NAND 合约价预计还要涨 10% 到 15%。CoreWeave 8 月 5 日跟 Solidigm 签了多年协议抢优先供货,容量、年限、金额一个都没公布——这种签法通常说明瓶颈在分配不在价格。
信源:
StorageReview(铠侠 GP1)https://www.storagereview.com/news/kioxia-gp1-series-hits-10-million-random-read-iops-on-xl-flash-gen-2
Tech Times 2026-09-08《Kioxia Slips 100M IOPS Flash Drive to 2028; PCIe 7.0 Ecosystem Sets 2028 Clock》
AWS Machine Learning Blog https://aws.amazon.com/blogs/machine-learning/tiered-kv-cache-for-large-llms-on-amazon-sagemaker-hyperpod-with-curvine/
StorageReview(CoreWeave 锁 Solidigm 供货)https://www.storagereview.com/news/coreweave-locks-in-solidigm-ssd-supply-as-flash-allocation-becomes-an-ai-cloud-problem
TrendForce 2026-06-11《Enterprise SSD Revenue Hits Record $18.46 bn in Q1 2026 as AI Agent Boom Drives 86% Growth》(InfotechLead 转引)
五、未来怎么发展
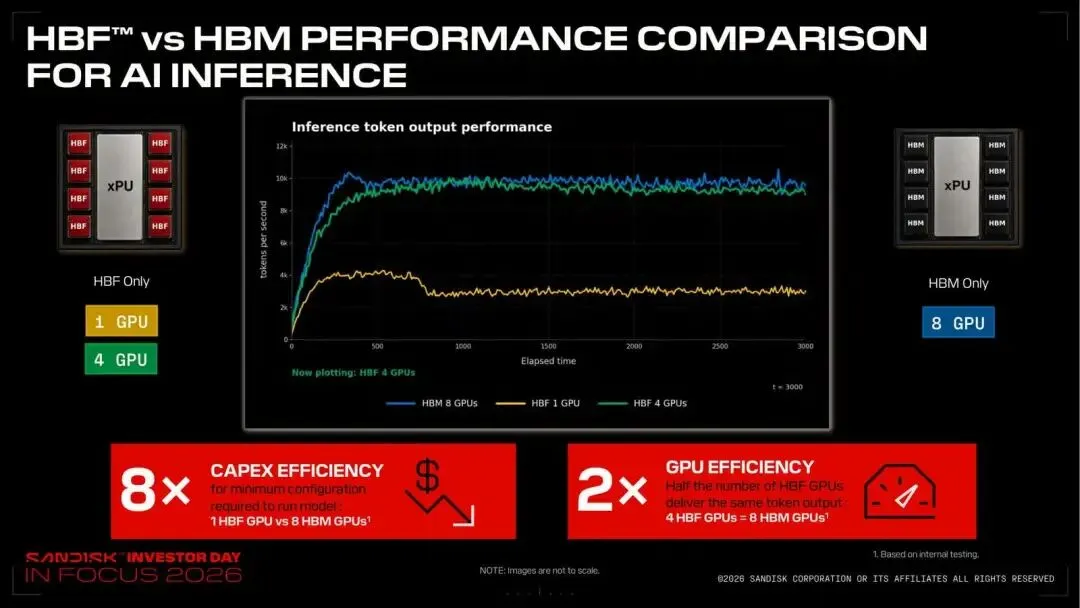
闪迪给出的 HBF 与 HBM 推理性能对比,图源闪迪,经 StorageReview 转引
延迟层的路标最清楚:1000 万 IOPS 往上走到 1 亿,接口从 PCIe 6.0 到 7.0,时间点都压在 2028。中间还有一道坎是 GPU 直连的生态——英伟达 Vera Rubin、Storage-Next、SCADA 把存储控制权挪到 GPU 上,这些都得跟上。
容量层继续往上翻。245TB 之后是 500TB 级,PLC NAND 会在这一轮真正上场。铠侠 CM10 的 E3.S 版本已经上冷板液冷,Solidigm 也把液冷列成释放高端存储性能的必备条件——盘快了以后散热先到顶。
形态上最大的变量是 HBF。闪迪 8 月 13 日流出第一颗 HBF 存储裸片的流片照片,每叠 512GB、读带宽 1.6TB/s,官方宣称容量是 HBM 的 8 到 16 倍而成本相近。它和 SK 海力士 8 月 3 日通过 OCP 发布了第一份 HBF 技术规范,三星注册了 zHBF 商标。样品时间定在 2027 年,比 2025 年 8 月说的 2026 年下半年晚了一年。Tom's Hardware 在 Hot Chips 2026 上的判断是带宽和容量都很大,但"可用性极其有限"。
还有一道一直没迈过去的坎。Optane 那条路断了之后,延迟层只能拿 SLC 类的 XL-Flash 顶,时延和寿命都跟真正的 SCM 差着一截。哪天 PCM、ReRAM 这类介质真能在成本和产能上过关,这一档才算是补上了。
信源:
StorageReview(铠侠 GP1)https://www.storagereview.com/news/kioxia-gp1-series-hits-10-million-random-read-iops-on-xl-flash-gen-2
StorageReview(闪迪 HBF 流片)https://www.storagereview.com/news/sandisk-tapes-out-its-first-hbf-memory-die-targets-2027-for-inference-product-samples
Tech Times 2026-09-08《Kioxia Slips 100M IOPS Flash Drive to 2028; PCIe 7.0 Ecosystem Sets 2028 Clock》
Tom's Hardware《Hot Chips 2026: High Bandwidth Flash promises massive bandwidth and capacity, but its usability is extremely limited》,2026-08-26
The Register 2026-07-28《A requiem for Optane, Intel's KV cache killer that could have eased the RAM price crunch》
总结清单。
1. AI SSD 分两档,指标差一个量级。延迟层用 XL-FLASH 类低时延介质、512B 粒度;容量层用 QLC、4K 粒度。拿一档的指标要求另一档会得出错误结论。
2. 延迟层的标杆是铠侠 GP1。PCIe 6.0、1000 万随机读 IOPS(512B 块)、最高 50 DWPD,走 GPU 直连。今年年底才送评测样品。
3. 容量层已经量产。美光 6600 ION 245.76TB,每瓦 8.2TB;Solidigm D5-P5336 122.88TB、0.6 DWPD;铠侠 CM9 25.6TB、3 DWPD 折合每天 76.8TB 写入。
4. 已有生产级实测,但只在容量层。AWS 跨 Pod 命中率 100%,1,000 到 2,500 token 是甜区;StorageReview 测出首 token 时延 13.9 秒降到 3.2 秒。
5. 1 亿 IOPS 和 500TB 都排在 2028 年。铠侠把 1 亿 IOPS 的盘推到 2028,PCIe 7.0 生态同步。Optane 之死后,延迟层只能拿 SLC 类介质顶。
AI SSD 不是一种盘,是两种完全不同的东西共用一个名字。一档替 HBM 打工,比的是 IOPS、时延、DWPD;一档替内存当仓库,比的是每美元多少 GB、每瓦多少 TB。
电不值钱的那天,赚钱的是电器厂。放在存储上要改一改:算力不值钱的那天,赚钱的是那个能把状态留住的人——而"留住"这件事,现在得靠两档完全不同的硬件接力。
一个真问题:如果延迟层和容量层的技术路线继续分叉,你觉得最后是英伟达用 CMX 和 Storage-Next 把两档都收进自己的生态,还是存储厂商各自守住一档?评论区聊。