ARTICLE · 1190922
190k Star:微软官方神器,PDF/Word/PPT/图片/音频一键转 Markdown——MarkItDown 完整教程
🔄
PDF、Word、PPT,一个命令全转成 Markdown
MarkItDown:微软官方开源 Python 工具,把各种文件一键转成干净 Markdown,专为 LLM 与文本分析设计
190k StarMIT 协议微软官方
📖 它是什么
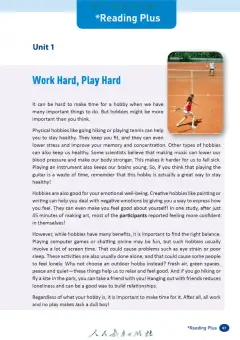
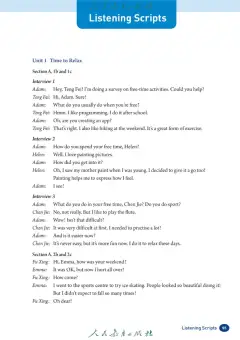
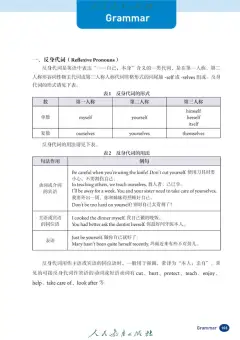
MarkItDown 是微软 AutoGen 团队开源的轻量级 Python 工具,作用很纯粹:把各种文件转成 Markdown。它比常见的 textract 更强的地方,是尽量保留文档的关键结构——标题、列表、表格、链接等都会转成对应 Markdown 语法,输出干净、token 高效,正好是主流大模型(如 GPT-4o)"最懂"的文本格式,非常适合 LLM、RAG、知识库和文本分析流程当预处理步骤。
目前支持 PDF、PowerPoint、Word、Excel、图片(EXIF + OCR)、音频(EXIF + 语音转录)、HTML、CSV/JSON/XML、ZIP、YouTube 网址、EPub 等十多种格式。命令行、Python API、Docker 都能跑。项目于 2024 年 11 月中旬发布,到 2026-10-15 GitHub 已达 190.3k Star、14.1k Fork。
官方使用 MIT 许可证,可自由使用与商用。注意它主要面向机器消费的文本分析,不追求给人类阅读的高保真排版;需要极高保真可搭配 Azure 云端能力或 OCR 插件。
✨ 核心亮点
🧩
支持十多种格式
PDF/Word/PPT/Excel/图片/音频/HTML/ZIP/EPub
🔤
输出干净 Markdown
保留标题、列表、表格、链接结构
🐍
一行安装
pip install 'markitdown[all]' 即装即用
🤖
LLM 友好
token 高效,适配 LLM/RAG/知识库预处理
🖥️ 环境要求
🚀 上手步骤
① 准备 Python 环境
需要 Python 3.10–3.14,建议建虚拟环境:
python -m venv .venv Windows: .venv\Scripts\activate macOS/Linux: source .venv/bin/activate② 安装 MarkItDown
pip install 'markitdown[all]'想省依赖可只装部分,如 pip install 'markitdown[pdf, docx, pptx]'。
③ 命令行:一行转 Markdown
# 转成文件 markitdown path-to-file.pdf -o document.md # 或直接重定向输出 markitdown path-to-file.pdf > document.md # 也可以管道输入 cat path-to-file.pdf | markitdown④ Python API:嵌入自己的流程
from markitdown import MarkItDown md = MarkItDown() result = md.convert("test.xlsx") print(result.markdown)图片想要 AI 描述时,传入 llm_client 和 llm_model(如 OpenAI 客户端 + gpt-4o)。
⑤ 进阶:Docker、OCR 插件与 Azure 云端
# Docker docker build -t markitdown:latest . docker run --rm -i markitdown:latest < ~/your-file.pdf > output.md # OCR 插件 pip install markitdown-ocr pip install openai🎯 典型玩法
🤖 喂给大模型:PDF/Word 转 Markdown 再丢给 LLM,答案更准
🗂️ RAG 知识库:统一转 Markdown 后入库做向量检索,召回更稳
🔎 文本索引:批量把办公文档归一化,供全文检索与分析
🖼️ 图片/音频转写:图片 OCR、音频转文字,便于进一步处理
⚙️ 批量自动化:Python API 嵌入脚本,批量转换整套文档
📊 和同类做法比
原理一句话:把各类文件解析成带结构的纯文本——Markdown 极接近纯文本、标记极简,又能表达标题/列表/表格结构,主流大模型被大量 Markdown 训练过,天然"听得懂"。
❓ 常见问题
Q:免费吗?可以商用吗?
完全免费,官方采用 MIT 许可证,可自由使用与商用(注意微软商标使用需遵循其品牌指南)。
Q:支持哪些格式?
PDF、Word(.docx)、PowerPoint(.pptx)、Excel(.xlsx/.xls)、图片(EXIF+OCR)、音频(EXIF+转录)、HTML、CSV、JSON、XML、ZIP、YouTube 网址、EPub 等。
Q:怎么安装?
pip install 'markitdown[all]' 装全量;也可按需装 markitdown[pdf, docx, pptx]。需要 Python 3.10–3.14。
Q:怎么转换一个文件?
命令行 markitdown 文件.pdf -o 输出.md;或用 Python md = MarkItDown(); print(md.convert("文件.xlsx").markdown)。
Q:扫描版 PDF 转不出来字怎么办?
扫描件是图片,内置 PDF 转换拿不到文字。装 OCR 插件 pip install markitdown-ocr(需 LLM Vision,如 OpenAI + gpt-4o)即可提取图片里的文字。
Q:输出不像原文档那么好看?
MarkItDown 面向机器消费,重结构、不追求高保真排版。要高保真可接 Azure Document Intelligence / Content Understanding 云端转换。
Q:音频和视频支持吗?
内置支持音频转录(装 [audio-transcription]);视频本身不支持,可用 Azure Content Understanding(云端)处理视频。
Q:装依赖报冲突怎么办?
建议用独立虚拟环境(venv / uv / conda)避免和系统包冲突;uv 环境记得用 uv pip install。
Q:安全上要注意什么?
MarkItDown 会以当前进程权限读写资源,不要把不可信输入直接喂给它(尤其服务端场景),尽量用最窄的接口如 convert_local() / convert_stream()。
📎 GitHub 搜索 microsoft/markitdown
关注「AI工具匠」,获取更多 AI 工具实操教程