ARTICLE · 1193033
定时AI助手怎么做:让Agent每天自己把活干完
过去一年,几乎所有做 Agent 的团队都撞上过同一堵墙。
Demo 阶段一切顺利——你打开界面、粘贴需求、等待结果、复制输出。但只要你想让它"自己"跑起来,就会立刻遇到两个问题:
第一,谁叫醒它? 没有人在场的时候,那个 Agent 不会自己开始工作。
第二,它怎么登录? 要干活的 Agent 得访问你的系统,那 API key 放在哪?
大多数"自主 Agent"的试点,就死在这两个问题上——不是模型不行,是没人给它安排上班时间和门禁卡。
今年 6 月 9 日,Anthropic 在 Claude 平台上把这两个能力一起推进了公开测试版。它们分别对应上面那两个问题,而且名字很直白:scheduled deployments(定时部署)和 vaults(保险库)。
先说定时。
以前,一个 Claude Managed Agent 只在被触发时才跑——通常是你自己的应用去调一次 API。如果你想让它每天早上 7 点总结一下夜间告警,你得自己搭一个调度器、自己托管、自己监控。
现在不需要了。你可以直接在控制台或 API 上,给一个 Agent 部署挂上一条标准的 cron 表达式。每次时钟到点,平台就启动一个全新的 Agent 会话,把任务从头执行到尾。
没有调度器要你建,没有 cron 守护进程要你养,没有额外基础设施要你盯。
几个必须知道的细节:
| cron 语法 | |
| 时区 | |
| 抖动(jitter) | |
| 数量上限 | |
| 运行状态 | |
| 每次预算 |
最后一条最值得注意。 官方文档举的例子是:一个设置了 `2000` 上限的部署,每一次运行最多可以花掉大约 20 美元。
为什么"每次上限"比"总额上限"重要? 因为定时任务的风险模式不是"总量失控",而是"某一次因为数据异常跑飞了"。按次设闸,才真的拦得住。
(技术细节来源:Claude Platform 官方文档《Scheduled deployments》,2026 年;解读见《Claude Managed Agents Just Got Cron Scheduling and Vault Credentials》,AI for Anything,2026 年)
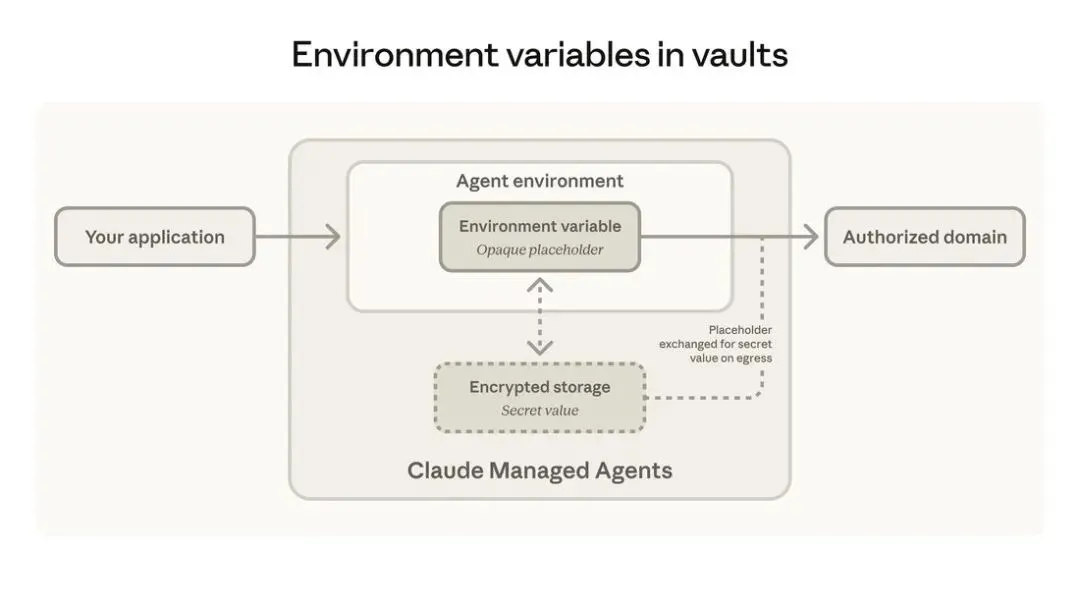
第二个问题是认证。这个设计我认为是这次更新里最值得所有 Agent 平台抄的一条。
做法是:把凭据放进 vault(保险库),在运行时以环境变量的形式提供给 Agent。
听起来平平无奇?关键在后面这几句:
• 你在 vault 里注册一个 API key,给它一个环境变量名(比如 `SENTRY_API_TOKEN`),同时指定这个 key 允许访问哪些域名;
• Agent 沙盒里的 CLI 可以读到这个环境变量,正常发起认证请求;
•但 Agent 从头到尾看不到真钥匙。 沙盒里只有一个占位符。
•真正的凭据在网络边界注入,而且只在你白名单里的域名上生效。
也就是说:即使有人通过工具返回的内容注入了恶意指令、试图把"钥匙"带出去,它拿到的也只是个占位符。
而换钥匙呢?在 vault 里更新,正在运行的会话下一次调用就会用上新值。
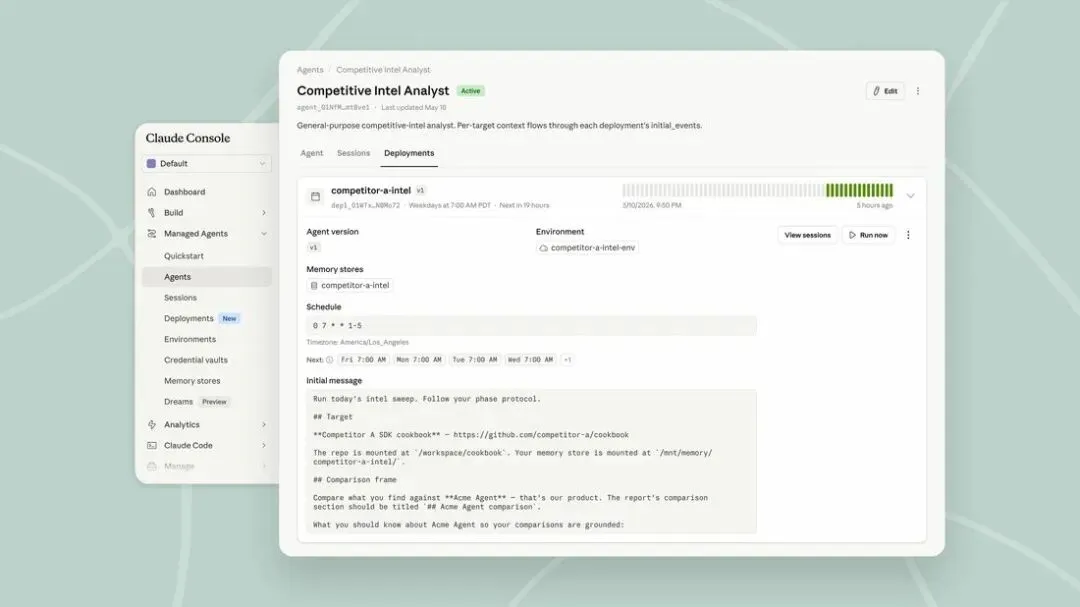
官方博客列了一批已经在用这两个能力的团队。我把它们按"你能抄哪一类"重新整理:
| 周/月数据分析 + 报告 | ||
| 替换自建调度 | ||
| 盯进度、催下一步 | ||
| CLI 与 MCP 并存 | ||
| 定期校验自己的目录 | ||
| 数据异常即时告警 |
注意其中两条的"元"性质: Browserbase 是用定时 Agent 校验自己产出的目录;Active AI 是用平台能力替掉了自己搭的调度系统。
这已经不是"加一个功能",而是在替换基础设施。
那到底哪些活该交给定时 Agent?原文里有一句判断准则,我认为比任何清单都好用:
(来源:《Claude Managed Agents 解析:让 AI 自动排程执行任务》,2026 年 6 月)
反过来说,不适合的也很明确:每次都需要新鲜人类判断的工作——策略决策、敏感的客户邮件、招聘短名单。这些工作之所以需要人,正是因为输入会以你无法预期的方式变化。
三个最典型的"适合":
•夜间数据同步:把昨天的记录从 CRM 拉出来,写成规范版本送进数据仓库;
•每周合规扫描:检查生产主机上有没有已知 CVE 的软件包,把摘要邮件发出去;
•每日摘要:把新增的支持工单、GitHub issue、Slack 讨论汇总成一份晨报。
官方给的示例就是第三种的一个变体:一个每周一 07:00 触发的安全 Agent,扫描生产主机、和上周结果做差分、把新发现邮件给安全团队——全程没有人类按开始键。
如果你准备动手,这三个坑值得先看。
第一个坑:把长流程塞进一次运行。
每次调度触发都会启动一个全新的会话,默认不继承上一轮的状态。所以如果你写的是"第一步拉数据、第二步做分析、第三步发报告"这种长链路,得先想清楚中间状态存在哪里——是临时文件,还是外部存储。
默认假设"它记得上次做到哪了",是这项能力最容易被误用的地方。
第二个坑:忽略抖动。
平台会给实际执行时间加上最多 15% 间隔的抖动(最少 5 秒、最多 9 分钟),目的是分散负载。这意味着"每天 7:00 整"实际可能落在 7:00 到 7:09 之间的某一刻。
如果下游任务对时刻有硬依赖,这一点必须先确认。
第三个坑:忘了按次设预算。
前面说过,部署上的 `budget` 是每次运行的上限,不是总额。如果你只在心里估了个"每月大概花多少",那就等于没设闸。
真正的风险场景不是慢慢超支,是某一次因为输入数据异常直接跑飞。
第一,先找一件"输入固定、逻辑固定、输出固定"的活。 从三个经典场景里挑一个:夜间同步、周期扫描、固定摘要。
第二,把它写成编号步骤清单,然后用"资浅同事能不能照做"自检。 过不了这一关的,先别交给 Agent。
第三,第一件事只给最小权限的钥匙。 用 vault 的思路——给它能力,不给你家的钥匙。