ARTICLE · 1210696
CUDA 兼容到底兼容什么:从源码、PTX 到目标 GPU 的执行链路
一份 .cu 源码、一份编好的 CUDA 可执行文件、一个带自定义 CUDA 算子的模型项目,迁移到 AMD GPU 时,遇到的是三个不同的问题。
源码可以改写,也可以交给另一套编译器重新编译;已有二进制没有这些自由,必须有人承接它调用的接口,并处理其中的设备代码;模型项目即使主体已经支持 ROCm,也可能被一个只发布 NVIDIA 二进制的扩展卡住。
所以,“兼容 CUDA”首先要补全两个条件:接收什么输入,在软件栈的哪一层替换实现。 AMD 的 ROCm/HIP、摩尔线程的 MUSA、海光的 DTK,以及第三方 SCALE、ZLUDA,不能只用“要不要改源码”分成两类。
一份 CUDA 程序,其实包含两条执行路径
用向量运算作教学示例:CPU 分配显存、复制数据,启动 GPU 内核计算 y[i] = a * x[i] + y[i],再取回结果。这里有两个不同对象:
• 主机代码:在 CPU 上运行,调用内存分配、复制、流、事件和内核启动接口。
• 设备代码:由 GPU 线程执行的函数,包含索引、访存、计算和同步。
CUDA C++ 把两者放进同一个工程,甚至同一个 .cu 文件。nvcc 是协调这两条编译路径的编译驱动,不是把整个文件变成一段 GPU 指令。主机部分最终由主机编译器处理;设备部分则需要生成 GPU 可执行的代码,并与主机侧启动逻辑关联起来。
设备侧有三个容易混淆的对象。
PTX 是 NVIDIA 定义的虚拟指令集。 它已经是低层程序,表达线程索引、寄存器运算、访存、同步等操作,但不是某一代 NVIDIA GPU 直接执行的机器码。编译器可以先面向 compute_* 虚拟架构生成 PTX,再面向 sm_* 真实架构生成设备二进制。
cubin 是设备编译映像,其中包含特定 NVIDIA 架构的机器码,通常称为 SASS。 cubin 不是 PTX 的另一个文件名,也不能因为同样叫 GPU 就交给 AMD 执行。
fatbin 是容器。 一个容器可以装多份面向不同架构的 cubin,也可以装 PTX。它嵌入可执行文件或共享库后,NVIDIA 运行时与驱动选择可用映像:能使用已有 cubin 时加载它,需要且存在合适 PTX 时,再做即时编译,即 JIT。
是否保留 PTX 由构建参数决定,不能只看文件后缀。例如下面是编译配置示意,未实际执行:
nvcc app.cu -gencode arch=compute_86,code='[sm_86,compute_86]' -o app
这里同时要求保存 sm_86 的 cubin 和 compute_86 的 PTX。若 code 只保留 sm_86,这条配置便不再提供 PTX 回退。对于依赖 PTX 的第三方翻译器,两种产物的可用性完全不同。
主机侧还有两组接口。Runtime API,如 cudaMalloc、cudaMemcpy,替程序处理较多初始化与模块管理;Driver API,如 cuModuleLoadDataEx、cuLaunchKernel,允许更直接地管理设备代码模块与启动过程。它们最终都必须落到目标平台的内存管理、命令提交、驱动和硬件上。
此外,调用 cublasGemmEx 的程序通常没有自己实现矩阵乘内核。它依赖的是 cuBLAS 的接口、数值规则、算法选择和内部优化代码。兼容这个调用,通常意味着换一个库实现矩阵乘,而不是逐条翻译 cuBLAS 里面的 NVIDIA 机器码。
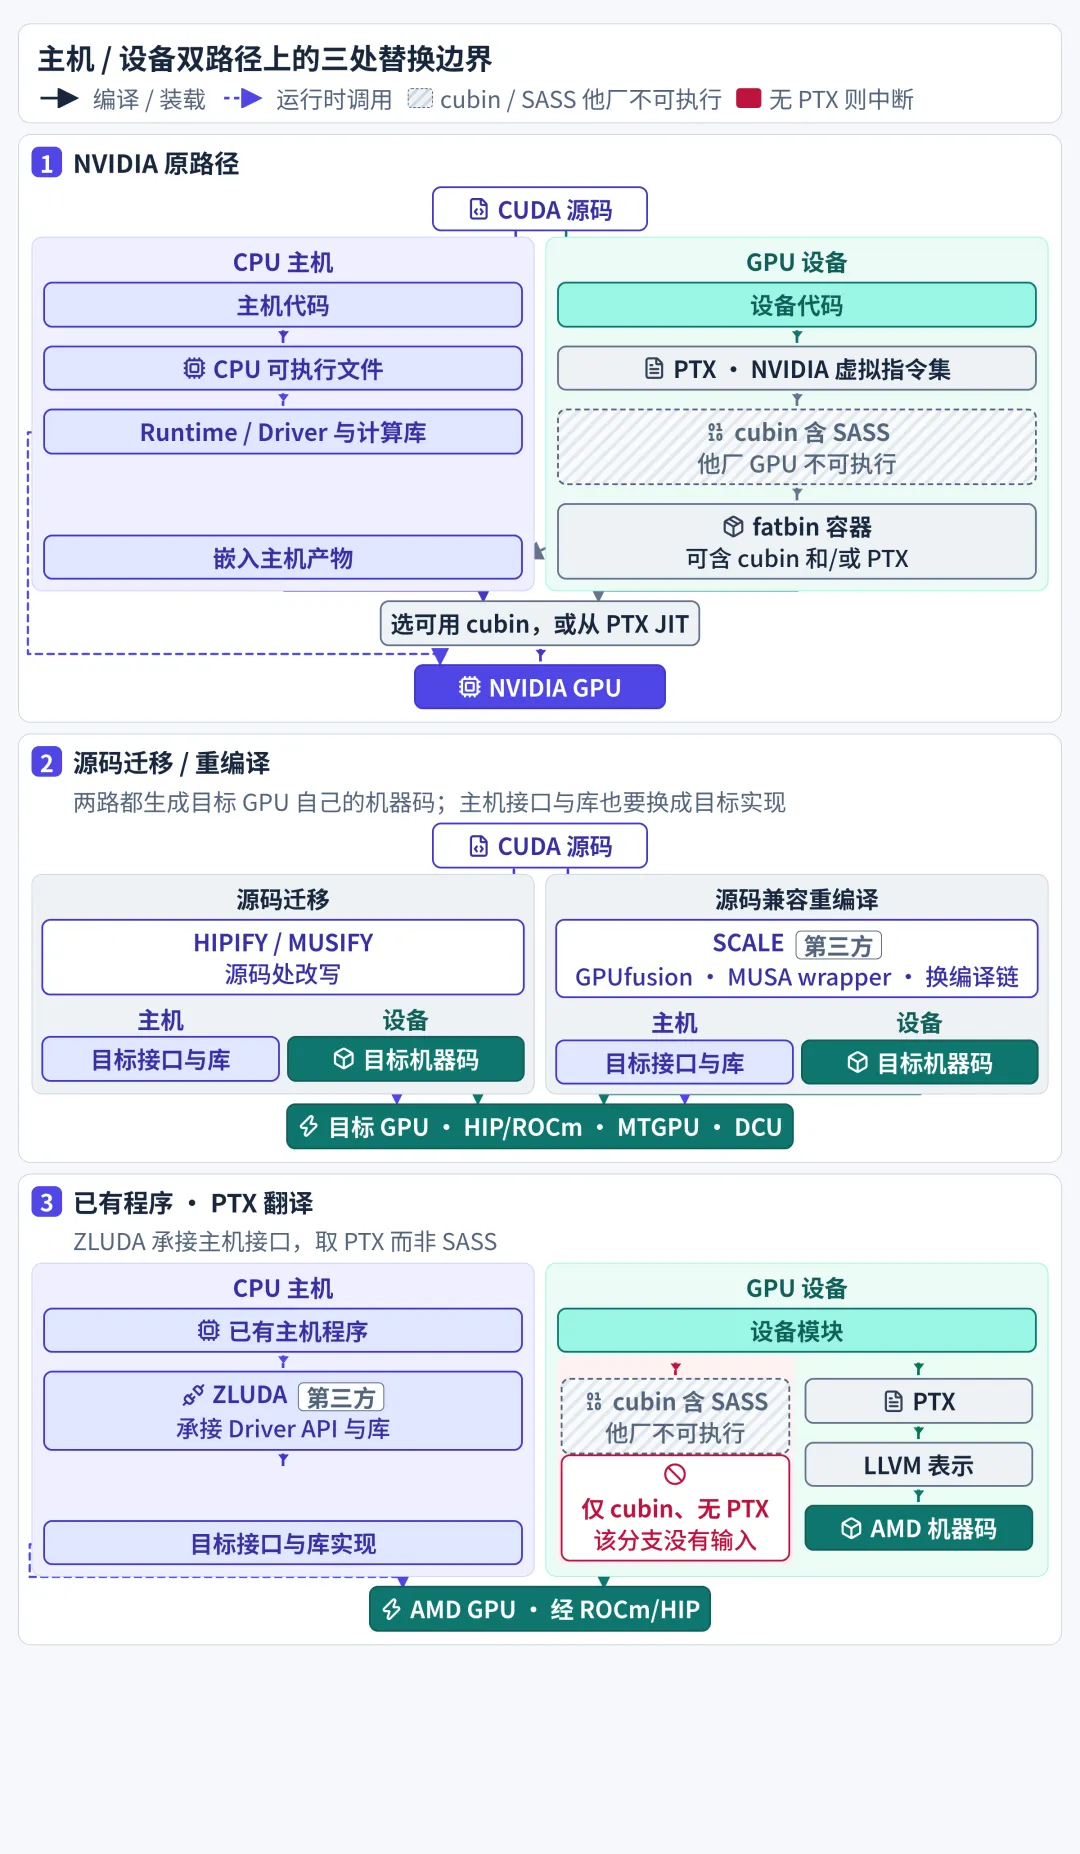
把图中的主机接口和设备代码两支分开看:只替换 API,不能让错误架构的设备代码可执行;只编出目标机器码,也不能补齐程序依赖的库和运行时语义。
AMD 的主要路径:把 CUDA 工程迁成 HIP,再生成 AMD 代码
ROCm 是 AMD 的计算软件栈;HIP 是其中承接 GPU C++ 程序的语言与运行时接口。AMD 的这条主要迁移路线,输入是源码,不是现成的 NVIDIA 可执行文件:
CUDA 源码 → HIPIFY 改写 → HIP 源码与目标库 → HIP-Clang 编译 → AMD 设备代码 → HIP/ROCm 运行时 → AMD GPU
HIPIFY 改了什么,没有改什么
HIPIFY 会把大量 CUDA 接口、类型、头文件和库调用转换为对应的 HIP 表达。例如,cudaMalloc 转为 hipMalloc;一些功能相近的 Runtime、Driver 接口在 HIP 中合并到同一套命名下。
其中,hipify-clang 先解析源码,建立抽象语法树——也就是识别“这是函数调用、那个是类型声明”的结构——再转换;它需要代码能被正确解析,并有必要的 CUDA 头文件。hipify-perl 主要做模式匹配,不要求完整 CUDA 编译环境,但识别复杂代码结构的能力更有限。
两者都不是“理解算法后为 AMD 重写算法”的工具。假如源码包含一段 NVIDIA 专用内嵌 PTX,或者根据 __CUDA_ARCH__ 选择特定 Tensor Core 内核,改完函数名以后,原来的硬件假设依然存在。没有对应实现的库功能,也不会因符号换名自动出现。
因此,自动转换统计反映的是可处理的源码引用,不是程序功能覆盖率,更不是数值正确率。
HIP 编译产物不是 NVIDIA cubin
在 AMD 路径上,hipcc 是调用 HIP-Clang 等工具的编译驱动。设备代码按目标 AMD 架构生成 code object,即可装载的设备代码对象,HIP 模块接口使用的格式包括 .hsaco;多目标代码可以打包进 .hip_fatbin 并嵌入主机程序。
主机程序加载时,初始化代码登记设备代码、内核和全局变量。执行启动语句时,主机侧逻辑准备网格、线程块、参数和流,找到已登记的目标内核,再由运行时提交执行。此时 AMD GPU 执行的是 AMD 指令,不是在逐条模拟 SASS。
回到向量运算:分配与复制由 HIP 接口承接,x、y 对应目标平台上的设备内存;启动逻辑将这些设备地址与标量 a 作为参数交给已登记的 AMD 内核。算法和数组含义可以不变,但内存由谁管理、CPU 怎样找到内核、GPU 执行哪套指令,都已经换成目标栈的实现。
这也解释了一个边界:把 cuModuleLoadData 改成 hipModuleLoadData,不代表原先交进去的 cubin 或 PTX 可以原封不动继续用。接口形式相似,接口接受的代码对象格式仍然可能不同。 如果应用本身会动态生成设备代码,这条生成链也必须迁移。
API 对应,不等于所有状态行为相同
内存分配和简单内核启动较容易找到对应接口,但上下文、流、事件、模块生命周期同样是程序语义的一部分。上下文保存设备执行所需的资源与状态关联;切换它,不只是换一个设备编号。
例如,在这里讨论的 HIP-Clang 实现中,地址空间是进程级统一的,新建上下文不等于新建一套设备地址空间;首次调用 HIP API 时会创建默认的主上下文(primary context),并在上下文栈为空时压栈。依赖 CUDA Driver 上下文管理细节的程序,需要重新核对资源归属与切换行为,不能只确认函数存在。
库也要单独选择。ROCm 同时提供 hip* 可移植接口库和 roc* 面向 AMD 的库;后者可能暴露 AMD 特有能力。以稀疏计算为例,面向 AMD 的项目可以评估 rocSPARSE,而不是把 hipSPARSE 视为所有场景下的最终性能方案。HIPIFY 的 --roc 选项可以参与这种映射,但它不替代接口差异检查和性能验证,也不保证换用 roc* 就必然更快。
迁成 HIP 不必然意味着长期保留两份独立工程。可以共用可移植主体,只为特化内核保留后端分支;代价是上游每次引入新 CUDA 特性时,都要重新审视这些边界。
不改 CUDA 源码,也可能是在重新编译整个工程
另一类路线保留 .cu 和大量 CUDA API 名称,却更换编译器、头文件、运行时与库。它保留的是源码接口,不是 NVIDIA 二进制。
MUSA:源码转换与兼容编译是两条路
摩尔线程的 MUSIFY 属于源码转换路线。MUSA SDK 5.1.0 中的 musify-text 做纯文本匹配,例如把 cudaMalloc 改成 musaMalloc;转换后通常把 .cu 改为 .mu,交给 mcc 编译。纯文本不理解语义,因此可能改到不该改的内容,也需要人工排除与检查。
同一 SDK 还提供另一种构建方式:
mcc axpy.cu -mtgpu -cuda_wrapper -lcuda2musa \
-L/usr/local/musa/lib -O2 -o axpy
这是 SDK 手册中的兼容封装模式示例。输入仍是 .cu,设备部分经过前端、LLVM 中间表示(一种供编译器分析和优化的程序形式)和 MTGPU 代码生成,再嵌入主机产物;主机侧通过 libcuda2musa 承接 CUDA API 调用方式。
所以,这不只是转发 cudaMemcpy、让原来的设备二进制继续运行。设备代码已经重新编译为 MTGPU 目标代码。该模式的公开说明不足以把 Driver API、所有计算库和 NVIDIA fatbin/PTX 一并视为承诺范围,不能由这一条命令推导出“任意 CUDA 程序可直接运行”。
DTK:GPUfusion 提供的是 CUDA 编程环境
海光 DTK 原生提供 HIP 编程模型;DTK 26.10 的 GPUfusion 则提供 CUDA 兼容环境,包括名为 nvcc 的编译入口、头文件和库。加载该环境后,可以用类似 nvcc axpy.cu -o axpy 的方式,从 CUDA 源码构建 DCU 程序。
这里的 nvcc 是 GPUfusion 提供的入口。它解析 CUDA 编译选项,再按规则转换为目标平台构建:有些选项支持,有些忽略、警告或报错。一个工程没有修改 CMakeLists.txt,不代表每个编译选项仍有相同效果。
其 API 也区分“支持”“未严格转换”“不支持”。CUDA_STRICT=1 可以把未严格转换的接口变成编译错误,而不是带着行为差异继续编译。这把“能产出程序”与“没有使用已标注的非严格接口”分开检查;后者仍不是完整的正确性证明。
DTK 26.10 的兼容章节标示 CUDA 12.9,但已知限制部分仍保留对标 12.6 的表述;不宜把一个版本标签解释成该版本全部能力均可用。更具体的边界是:其 cuModuleLoadDataEx 限定加载本栈 nvrtcGetCUBIN 生成的二进制,不支持从 PTX 加载。这里沿用了 CUBIN 的接口名称,不能因此推断它能执行已有 NVIDIA cubin。
SCALE:由第三方直接编译 CUDA 方言
Spectral Compute 的 SCALE 也是源码重编译路线,提供可替代 nvcc 构建入口的交叉编译器及配套库,将 CUDA 源码直接编成目标 GPU 的原生机器码,并支持解析、编译内嵌 PTX。
内嵌 PTX 也能被编译,意味着它需要处理其中的指令语义,而不只是识别 CUDA C++ 表面的关键字。这并不意味着它可以接收所有已经编好的 NVIDIA 二进制,也不意味着每种 NVIDIA 专用操作都有等价、同速的目标实现。
SCALE 是第三方工具链,不能写成 AMD 对 CUDA 源码或 API 行为的官方承诺。“保持一份 CUDA 源码”减少了源码转换分叉,却把兼容责任转移给编译器和配套库;新语法、新 PTX 指令、新库接口仍然需要有人实现。同一份 CUDA C++ 代码在 nvcc 下可编译,也不保证另一套前端对模板、内建函数和扩展语法的处理完全一致;语言兼容必须落实到具体工具链版本。
ZLUDA 的不同之处:接住已有程序,再翻译 PTX
ZLUDA 是第三方项目,不是 AMD 官方兼容路线,也不是 HIPIFY 的另一种用法。其公开的 AMD 路径从未修改的 CUDA 应用出发:在进程中承接 CUDA 驱动接口和相关库调用,从设备模块取得 PTX,转换为 LLVM bitcode,再生成目标 GPU 机器码,经 ROCm/HIP 执行。
LLVM bitcode 是编译器内部使用的程序表示;它仍要经过优化与目标代码生成,不是 GPU 可直接执行的文件。ZLUDA 的 2025 年第四季度更新还引入了随项目提供的 LLVM,因此具体编译链也不能永久固定成“调用系统安装的某个编译器”。
这条路线能够保留现有主机二进制,但前提比“程序使用 CUDA”严格:
1. 程序调用的接口与库功能,需要有实现。只有同名函数还不够;数据结构、参数传递、句柄和生命周期必须满足二进制交互要求,也就是应用二进制接口(ABI)层面的要求。源码接口可以在重编译时调整,已有二进制则要求替代实现接得上原来的调用约定。
2. 设备模块需要提供它能处理的 PTX。若产物仅有 NVIDIA cubin,按这条公开机制就没有可供翻译的 PTX 输入;不能把它当成通用 SASS 翻译器。
3. PTX 使用的指令、同步和数值语义,也必须落到目标实现上。PTX 虽然是虚拟指令集,却不是消除了 NVIDIA 硬件假设的跨厂商高级语言。
把这些路线并排放置:
路线:HIPIFY、MUSIFY 改写源码
必需输入与替换点:源码;修改语言/API 表达后重新构建
可以保留什么:算法与可移植的并行结构
仍要承担什么:未转换功能、硬件假设、构建与后续维护
路线:SCALE、GPUfusion、MUSA wrapper 重编译
必需输入与替换点:CUDA 源码;替换编译器及配套接口实现
可以保留什么:受支持的源码与 API 写法
仍要承担什么:方言、选项、专用指令和库覆盖差异
路线:API/库替换
必需输入与替换点:调用方能接上目标接口,且数据与设备代码可用
可以保留什么:受支持的调用语义、数学操作定义
仍要承担什么:库算法、数值模式、ABI 和对象格式;不能单独解决所有设备代码
路线:ZLUDA 的 PTX 翻译
必需输入与替换点:可承接的主机二进制及可处理的 PTX
可以保留什么:已有主机程序和受支持的 PTX 语义
仍要承担什么:接口覆盖、PTX 指令映射、首次编译及库实现
这些路线可以组合。所谓“二进制兼容”,也不等于所有层次都原封不动:主机代码可以不变,设备代码却在第一次运行时被重新编译。
编译通过以后,还剩两类硬问题
第一类是程序原本依赖了什么硬件行为;第二类是目标硬件要花多少资源才能实现相同语义。
线程组宽度不能只换一个常数
NVIDIA 的 warp 按 32 个线程组织;AMD 的具体宽度依架构与执行模式而定,不能笼统写成“AMD 永远是 64”。这里的 lane 指组内线程的位置编号。在采用 64-lane wavefront 的目标上,一个用 32 位整数表示整组线程的掩码就可能失效。
下面是故意保留错误的教学片段,不是可直接使用的归约实现:
unsigned lane = threadIdx.x % warpSize;
uint32_t lower_lanes = (1u << lane) - 1u;
它想生成“编号小于当前 lane 的线程集合”。在这里讨论的 32 位 unsigned int 条件下,若 lane=40,左操作数移位 40 位已越过 C++ 的有效范围,行为未定义;HIPIFY 把 API 名换对,也不会自动修复这个算法。外层变量声明为 uint32_t,也不会改变右侧移位表达式的类型规则。
在 64-lane 目标上,使用足够宽的无符号类型只能修复掩码表达。还要继续检查:shuffle 是在逻辑 32 线程子组内交换,还是覆盖完整 wavefront?归约循环应进行几轮?参与屏障的线程是否一致?不能把所有 32 批量换成 64 就宣布正确。
DTK 26.10 的 GPUfusion 默认宽度为 64,另有实验性的 GPUFUSION_ENABLE_WARPSIZE32 软兼容模式,其说明明确提示性能损耗,并排除 warp 间存在数据依赖的场景。这体现了两种成本:修改算法适应目标组织,或者由兼容层维持原有逻辑分组。后者不必然免费。
同样的浮点运算,不一定要求逐位相同
数学上相同的求和,改变归约树就可能改变浮点结果;融合乘加、不同的低精度矩阵计算模式,也可能改变误差。应用应根据任务定义绝对/相对误差阈值,并覆盖普通值、极端值、NaN、无穷和次正规数——绝对值低于最小正规数的非零浮点数——而不是只比较一组随机输入。
但应用允许一定误差,与翻译器可以忽略指令规定,是两回事。如果程序明确使用了某种舍入方向,翻译器就需要实现它。
ZLUDA 的 2025 年第一季度实现说明给出了具体难点:PTX 可以逐指令指定舍入,以及是否把次正规数刷新为零;在它所针对的 AMD 路径上,相关行为受执行上下文中的浮点模式状态控制,不是每条算术指令都携带同样的选择。
因此,翻译器要沿控制流追踪模式:执行一段要求保留次正规数的指令前设置一种状态,进入要求刷新为零的分支前再设置另一种状态,并处理分支汇合与函数调用。这里的“模式状态”不是全 GPU 共用一个开关。
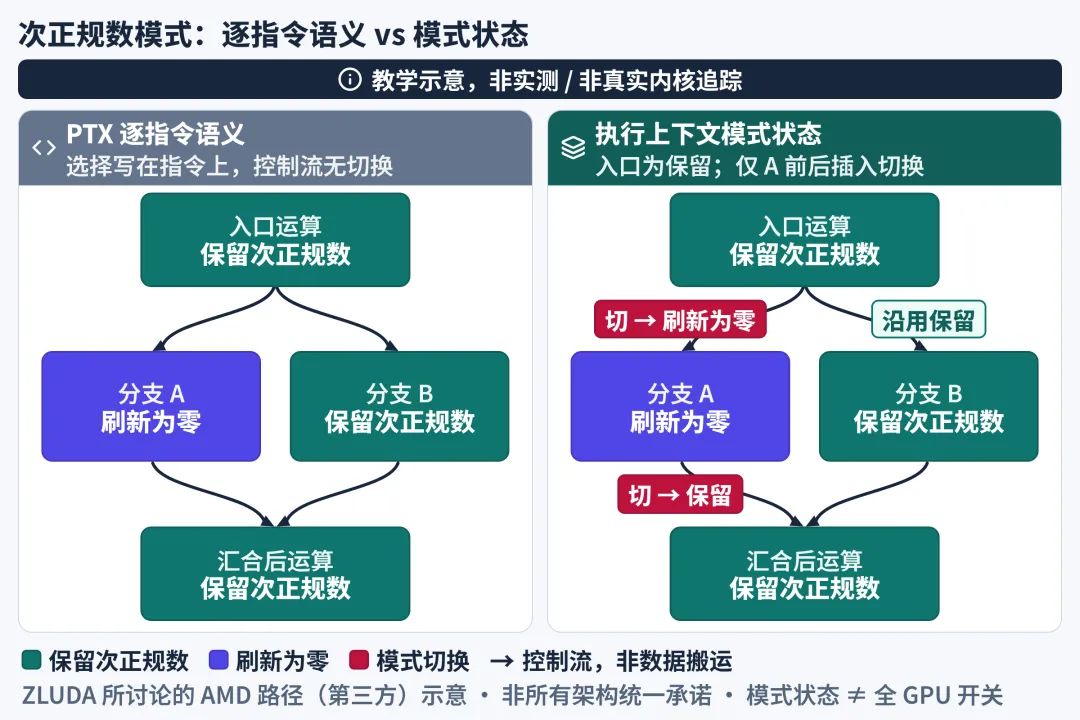
图中是控制流教学示意,不是真实内核的指令追踪:A 分支临时改用刷新为零的模式,汇合后的运算要求保留次正规数,因此从 A 返回前必须恢复;B 沿用保留模式,不需相同的切换。
插入模式切换会增加指令和编译分析成本;如果后续优化器没有把这种状态影响表达完整,还可能错误地合并两次本应不同的运算。ZLUDA 当时的实现说明也保留了这类误算风险。数值正确性不仅取决于硬件有没有加法指令,还取决于整条编译链是否保留了加法所依赖的状态。
目标原生机器码,仍可能映射得不好
共享内存在 AMD 上通常对应片上数据共享存储 LDS,但“功能对应”不意味着容量、存储体(bank)冲突代价和占用约束一样。一个线程块使用更多 LDS 或寄存器,可能减少同一计算单元上同时驻留的块;若寄存器溢出到内存,还会增加原算法之外的数据流量。驻留块减少是否拖慢程序,还取决于余下的并行工作能否覆盖访存等等待,不能只用占用率高低判定性能。
连续线程的地址分布也影响访存合并。保持原来的线程块形状,可能使目标机器的内存事务利用率下降;修改分块与数据布局,往往比改 API 更接近性能问题本身。
矩阵指令同理。Tensor Core 的 mma 与 AMD 的 MFMA 都涉及矩阵乘加,但不能按名称一一替换:支持的数据类型、矩阵块形状、各 lane 持有哪些片段,以及结果布局都可能不同。翻译器可以展开或重排以保持语义,但若重排、额外存储和同步过多,直接面向目标矩阵指令设计内核就可能更快。计算库的价值,恰恰是把这类选择放在已经优化过的实现里。
实际效果:功能测试、冷启动和稳态性能要分别看
在框架层,模型代码不变,可能只是因为换用了目标平台的算子后端。比如矩阵乘落到 ROCm 库,自定义算子则重新编译成 HIP 设备代码。这不说明框架正在执行原来的 CUDA 二进制。
假如一个项目的标准算子都可用,却还依赖只发布 cubin 的插件、动态生成 PTX 的组件或 NVIDIA 专用融合内核,框架主体支持某平台就不足以补齐这些依赖。功能验证的单位应是“这个版本项目在这个目标上的实际执行路径”,而不是“支持某框架”五个字。
SCALE 自己维护的开源项目验证表提供了一个有边界的例子。在 SCALE 1.7.3 的表中,PyTorch v2.9.0 在 gfx1100、gfx1201 两列通过,其余若干 AMD 架构列被跳过;llama.cpp b9522 在 gfx1100 通过,在 gfx1201 失败;cuda-samples v12.9 在所列目标上均未通过。这里的通过仅表示相应验证脚本通过,失败表也没有逐项标出是语言、库还是运行时问题。这不是独立第三方性能评测,既不能证明所有算子均受支持,也不能用绿色格子占比生成“CUDA 兼容率”。
第一次慢,和每一次都慢,不是一个问题
对于按需编译设备模块的路径,可以用下面的简化模型拆一次执行:
各项单位均为时间,分别表示初始化、当前缺失代码的编译、模块装载和实际工作。若后续运行能复用编译产物,重复工作主要承担 T_work,以及未被复用的初始化、装载等开销。缓存是否命中还取决于实现、代码、选项与目标架构;不能把所有首次成本都算到 kernel 上。
这是串行拆账模型,不假定这些阶段可以完全重叠。只计编译与实际工作的教学算例是:一次需额外编译 10 秒,随后运行 100 次、每次 20 毫秒,总计 12 秒,摊到每次为 120 毫秒;若只报告预热后每次 20 毫秒,就隐去了部署成本。两种口径都有用,但回答的问题不同。
ZLUDA 的公开更新提供了预编译 PTX 模块的工具,把运行时逐个编译提前完成。这能移动冷启动成本,却不能自动缩短同一内核在 GPU 上的稳态执行时间。源码路线也要计入构建与重编译,只是成本通常发生在部署前,而不是用户第一次执行时。
稳态要检查工作量和搬运量是否变了
对前面的 FP32 向量运算,若每个元素读取 x、读取旧 y、写入新 y,且忽略缓存复用、额外事务和标量 a 的开销,逻辑流量是每元素 12 字节。因此:
N 是元素个数,B 是这条数据路径的有效带宽上限,单位字节/秒。若教学假设 N=10^8、可用带宽 B=10^{12} 字节/秒,则理想搬运下界为 1.2 毫秒。这不是任何 GPU 的实测或延迟预测,也没有包括 CPU—GPU 复制。
如果迁移后出现额外临时数组、布局转换或寄存器溢出,分子不再是 12N;如果线程地址映射导致事务利用率变差,实际可用带宽也会下降。对于计算密集内核,则要检查目标矩阵指令是否真正被利用。仅知道两边峰值 TFLOPS,无法确定这些量。
公开结果能说明哪一层,不能说明哪一层
Spectral Compute 公布的 Extended OpenDwarfs 结果,在同一块 AMD Instinct MI300X 上比较 SCALE 1.7.3 与 HIPCC,使用 ROCm 7.2.4,采集日期为 2026 年 9 月 14 日。它比较的是同一硬件上的工具链,不是 AMD 对 NVIDIA。
该测试每配置独立运行五次取中位数,计入初始化、主机准备、传输和内核执行;短任务通过内部重复至少两秒来摊薄冷启动,不另行丢弃预热轮。其 Large 档公布的相对 HIP 性能如下,数值大于 1 表示 SCALE 更快:
这些结果保留的是套件的 Large 规模标签,展示页没有逐项给出精度和具体输入维度,也没有建立“针对每个目标人工调优到最佳”的原生基线。因此,它们只能说明该套件、该构建与该计时口径下,源码兼容编译的效果有快有慢,不能外推到某种精度的 GEMM,更不能换算成通用 CUDA 兼容损耗。另一组在 NVIDIA 硬件上与 nvcc 比较的结果,也不能与此表拼接成跨品牌加速比。
库替换还会改变比较对象。ZLUDA 作者在 2025 年第四季度更新中报告,llama.cpp 可以接近原生 ROCm 后端速度;其构建要求使用 CUDA 后端、包含指定 CUDA 架构目标并启用 cuBLAS 路径。这不是相对 NVIDIA GPU 的结论,而且没有配套的模型、量化、输入长度、硬件和逐项计时表,不能据此给出可复用的性能倍数。
同次更新中的 Katago 则是相反案例:补齐接口后能运行,但作者将严重变慢定位到部分操作在 MIOpen 中使用朴素实现,而 cuDNN 有优化实现。这是库内核选择影响稳态性能,不是“PTX 翻译必然慢”,更不是首次 JIT 的代价。缺少相同硬件条件、网络形状、精度与版本的完整表,也不宜把这个个例升级为平台性能结论。
本期可用公开结果不足以为 AMD HIP/ROCm、MUSA、DTK 建立统一的横向倍数。可用接口列表回答不了这个缺口;一项端到端成绩也不能替代对自定义内核、库调用和传输的分别计时。
怎样判定一个项目“已经兼容”
先用输入筛路线:拿到源码,检查语言、头文件、内嵌 PTX 和构建选项;拿到已有二进制,检查主机接口能否承接、设备部分是否提供可处理的 PTX。若只有 NVIDIA cubin,继续讨论 HIPIFY 转换比例没有意义——缺的是可进入迁移链路的输入。
内核能启动以后,确认实际执行的库与设备代码,避免只验证了小输入、回退路径或不同的数学模式。数值测试要覆盖任务要求及边界值;性能测试把冷启动与预热后运行分开,固定精度、形状、批量、布局和传输口径,并用目标平台的原生优化实现作基线。
最后看上游升级一次会发生什么:哪些源码需要重新转换,哪些专用内核需要重写,哪些变化只需重编译,哪些会要求兼容层新增接口。对大量调用成熟数学库的项目,应优先检查目标库;对充满内嵌 PTX、固定 warp 假设的项目,应优先检查指令与线程语义;对只交付二进制的项目,第一步甚至是确认有没有 PTX。这三种项目的“已经兼容”,需要三份不同的验收记录。