ARTICLE · 1211746
AI 算力底层:显卡、内存,决定大模型跑不跑得动
AI 算力底层:显卡、内存,决定大模型跑不跑得动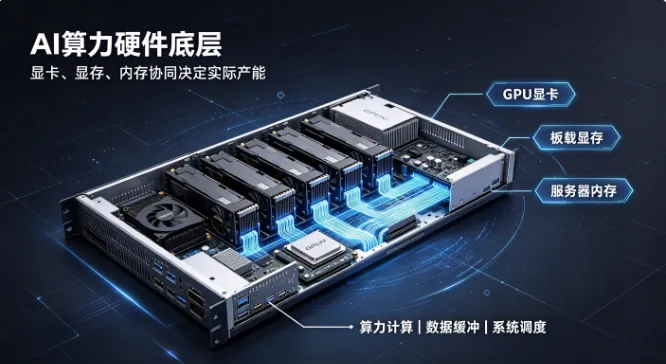
聊 AI 算力,大家第一反应就是 GPU 显卡。但很多人忽略,算力从来不是单靠一张强悍显卡就可以搞定。显卡、内存条、整机散热、集群协同环环相扣,共同撑起大模型推理的底座。 最近 AI 行业一直在热议算力降本。不少企业采购完一批高端算力显卡之后,上线才发现性能打了对折:跑大模型吞吐上不去,GPU 利用率始终徘徊在三四成,花出去的硬件预算没有释放出对应的业务产能。 很多人会把问题全部归罪于显卡本身。事实上,AI 算力是一套整套的系统,显卡、内存(显存 + 系统内存)相互依存,任何一块短板都会形成性能瓶颈。 算力显卡也就是大家常说的 AI‑GPU。 和普通家用游戏显卡不一样,算力显卡优先看重**FP16、FP8 算力、显存容量**,而不是游戏帧率。 显存(板载显存):这是显卡自己随身带的 “高速临时仓库”。 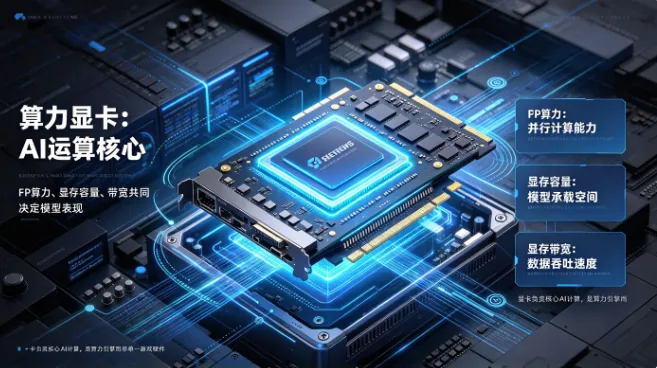
大模型的权重参数,要尽可能放进显存里面。显存容量不够,大模型根本装不下;显存带宽不够,就算显卡算力再强,数据吞吐也会卡脖子。 举个通俗例子:显存就像货车车厢,算力是货车马力。马力再大,车厢太小,一次装不下货物,只能来回反复搬运,速度直接掉下来。 这也是为什么现在做大模型推理,大家优先挑选大显存算力卡。同样算力数值,显存大小不一样,实际跑模型的效果差距非常明显。 很多小伙伴容易混淆显存和服务器内存。 显存属于显卡;服务器内存条属于主板主机。 当显存装不下全部模型参数的时候,系统就会把一部分模型权重溢出到服务器内存。 一旦发生显存往内存搬运数据,延迟会明显拉高,整体推理速度会断崖式下滑。 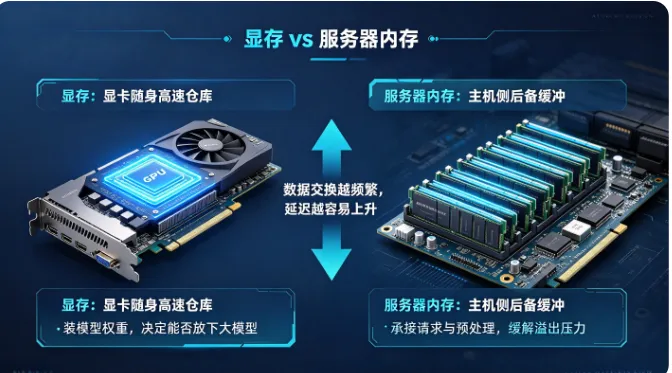
服务器内存的价值: 但服务器内存再大,也替代不了显卡显存。只能做兜底缓冲,不能当成跑大模型主力存储。 现在不少智算机房遇到的共性难题: ✅采购了一批高性能算力 GPU ❌GPU 利用率长期偏低 ❌业务并发上来之后延迟飙升 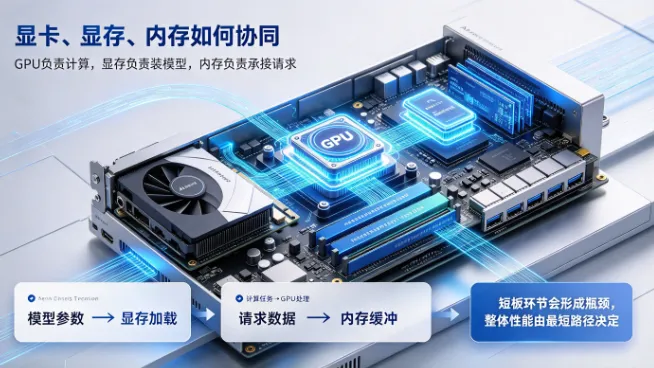
根源往往来自几个地方: 这也正好解释了行业转向液冷算力底座 + Token 工厂运营平台的逻辑。 硬件层面依靠液冷稳定控温,保障显卡持续满频工作;运营平台侧做推理调度优化,把显卡、内存的硬件潜力释放出来,拉高 GPU 整体利用率,最终降低每一枚 Token 的生产成本。 简单总结一句话: GPU 显卡负责核心 AI 计算;板载显存决定模型能不能装得下;服务器内存条负责业务缓冲兜底。 算力建设不是简单 “买买显卡堆机器”。硬件选型的时候不能只看算力参数,显存、整机内存、散热条件、上层调度运营,整套链路通盘考量,才可以把硬件投资真正转化成可用的 AI 业务产能。 聊 AI 算力,大家第一反应就是 GPU 显卡。但很多人忽略,算力从来不是单靠一张强悍显卡就可以搞定。显卡、内存条、整机散热、集群协同环环相扣,共同撑起大模型推理的底座。 最近 AI 行业一直在热议算力降本。不少企业采购完一批高端算力显卡之后,上线才发现性能打了对折:跑大模型吞吐上不去,GPU 利用率始终徘徊在三四成,花出去的硬件预算没有释放出对应的业务产能。 很多人会把问题全部归罪于显卡本身。事实上,AI 算力是一套整套的系统,显卡、内存(显存 + 系统内存)相互依存,任何一块短板都会形成性能瓶颈。 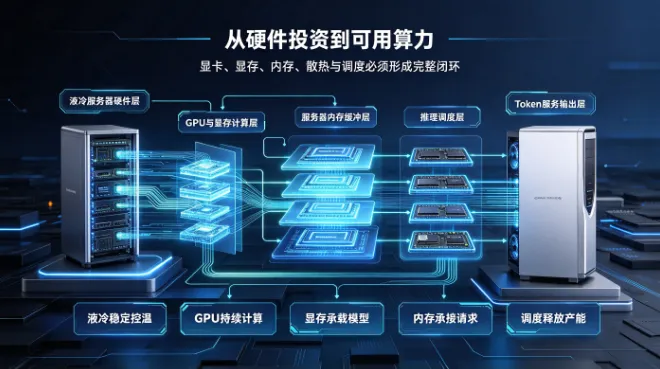
算力显卡也就是大家常说的 AI‑GPU。 和普通家用游戏显卡不一样,算力显卡优先看重**FP16、FP8 算力、显存容量**,而不是游戏帧率。 显存(板载显存)**:这是显卡自己随身带的 “高速临时仓库”。 大模型的权重参数,要尽可能放进显存里面。显存容量不够,大模型根本装不下;显存带宽不够,就算显卡算力再强,数据吞吐也会卡脖子。 举个通俗例子:显存就像货车车厢,算力是货车马力。马力再大,车厢太小,一次装不下货物,只能来回反复搬运,速度直接掉下来。 这也是为什么现在做大模型推理,大家优先挑选大显存算力卡。同样算力数值,显存大小不一样,实际跑模型的效果差距非常明显。 很多小伙伴容易混淆显存和服务器内存。 显存属于显卡;服务器内存条属于主板主机。 当显存装不下全部模型参数的时候,系统就会把一部分模型权重溢出到服务器内存。 一旦发生显存往内存搬运数据,延迟会明显拉高,整体推理速度会断崖式下滑。 服务器内存的价值: 但服务器内存再大,也替代不了显卡显存。只能做兜底缓冲,不能当成跑大模型主力存储。 现在不少智算机房遇到的共性难题: ✅采购了一批高性能算力 GPU ❌GPU 利用率长期偏低 ❌业务并发上来之后延迟飙升 根源往往来自几个地方: 这也正好解释了行业转向液冷算力底座 + Token 工厂运营平台的逻辑。 硬件层面依靠液冷稳定控温,保障显卡持续满频工作;运营平台侧做推理调度优化,把显卡、内存的硬件潜力释放出来,拉高 GPU 整体利用率,最终降低每一枚 Token 的生产成本。 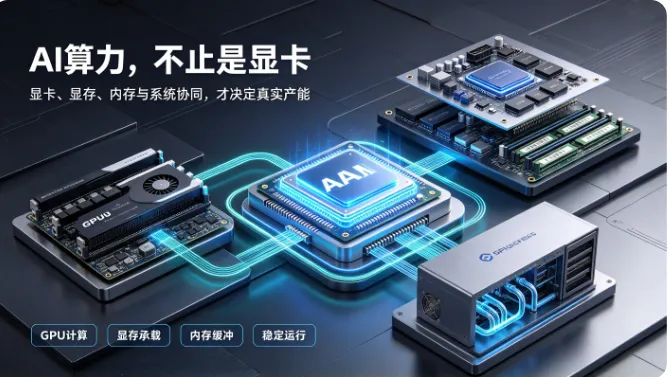
简单总结一句话: GPU 显卡负责核心 AI 计算;板载显存决定模型能不能装得下;服务器内存条负责业务缓冲兜底。 算力建设不是简单 “买买显卡堆机器”。硬件选型的时候不能只看算力参数,显存、整机内存、散热条件、上层调度运营,整套链路通盘考量,才可以把硬件投资真正转化成可用的 AI 业务产能。 聊 AI 算力,大家第一反应就是 GPU 显卡。但很多人忽略,算力从来不是单靠一张强悍显卡就可以搞定。显卡、内存条、整机散热、集群协同环环相扣,共同撑起大模型推理的底座。 最近 AI 行业一直在热议算力降本。不少企业采购完一批高端算力显卡之后,上线才发现性能打了对折:跑大模型吞吐上不去,GPU 利用率始终徘徊在三四成,花出去的硬件预算没有释放出对应的业务产能。 很多人会把问题全部归罪于显卡本身。事实上,AI 算力是一套整套的系统,显卡、内存(显存 + 系统内存)相互依存,任何一块短板都会形成性能瓶颈。 算力显卡也就是大家常说的 AI‑GPU。 和普通家用游戏显卡不一样,算力显卡优先看重**FP16、FP8 算力、显存容量,而不是游戏帧率。 显存(板载显存):这是显卡自己随身带的 “高速临时仓库”。 大模型的权重参数,要尽可能放进显存里面。显存容量不够,大模型根本装不下;显存带宽不够,就算显卡算力再强,数据吞吐也会卡脖子。 举个通俗例子:显存就像货车车厢,算力是货车马力。马力再大,车厢太小,一次装不下货物,只能来回反复搬运,速度直接掉下来。 这也是为什么现在做大模型推理,大家优先挑选大显存算力卡。同样算力数值,显存大小不一样,实际跑模型的效果差距非常明显。 很多小伙伴容易混淆显存和服务器内存。 显存属于显卡;服务器内存条属于主板主机。 当显存装不下全部模型参数的时候,系统就会把一部分模型权重溢出到服务器内存。 一旦发生显存往内存搬运数据,延迟会明显拉高,整体推理速度会断崖式下滑。 服务器内存的价值: 但服务器内存再大,也替代不了显卡显存。只能做兜底缓冲,不能当成跑大模型主力存储。 现在不少智算机房遇到的共性难题: ✅采购了一批高性能算力 GPU ❌GPU 利用率长期偏低 ❌业务并发上来之后延迟飙升 根源往往来自几个地方: 这也正好解释了行业转向液冷算力底座 + Token 工厂运营平台的逻辑。 硬件层面依靠液冷稳定控温,保障显卡持续满频工作;运营平台侧做推理调度优化,把显卡、内存的硬件潜力释放出来,拉高 GPU 整体利用率,最终降低每一枚 Token 的生产成本。 简单总结一句话: GPU 显卡负责核心 AI 计算;板载显存决定模型能不能装得下;服务器内存条负责业务缓冲兜底。 算力建设不是简单 “买买显卡堆机器”。硬件选型的时候不能只看算力参数,显存、整机内存、散热条件、上层调度运营,整套链路通盘考量,才可以把硬件投资真正转化成可用的 AI 业务产能。
🎞️算力显卡:AI 运算的核心引擎
📀服务器内存条:主机侧的后备缓冲区
承接预处理数据、用户请求队列; 显存溢出时作为后备缓冲; 多卡服务器内部,配合 CPU 完成调度、任务分发。
⚠️现实痛点:只堆显卡,为什么利用率依旧很低?
显存配比短板:显卡算力很强,但单卡显存偏小,模型放不下,频繁做内外存交换; 整机内存配置失衡,服务器内存条容量不足,请求队列堆积直接卡死; 散热约束:风冷机房温度上来之后,显卡会主动降频,硬件性能被迫缩水; 缺少上层调度优化,硬件本身没问题,但任务分配不合理,算力白白闲置。
✍️最后小结
🎞️算力显卡:AI 运算的核心引擎
📀服务器内存条:主机侧的后备缓冲区
承接预处理数据、用户请求队列; 显存溢出时作为后备缓冲; 多卡服务器内部,配合 CPU 完成调度、任务分发。
⚠️现实痛点:只堆显卡,为什么利用率依旧很低?
显存配比短板:显卡算力很强,但单卡显存偏小,模型放不下,频繁做内外存交换; 整机内存配置失衡,服务器内存条容量不足,请求队列堆积直接卡死; 散热约束:风冷机房温度上来之后,显卡会主动降频,硬件性能被迫缩水; 缺少上层调度优化,硬件本身没问题,但任务分配不合理,算力白白闲置。
✍️最后小结
🎞️算力显卡:AI 运算的核心引擎
📀服务器内存条:主机侧的后备缓冲区
承接预处理数据、用户请求队列; 显存溢出时作为后备缓冲; 多卡服务器内部,配合 CPU 完成调度、任务分发。
⚠️现实痛点:只堆显卡,为什么利用率依旧很低?
显存配比短板:显卡算力很强,但单卡显存偏小,模型放不下,频繁做内外存交换; 整机内存配置失衡,服务器内存条容量不足,请求队列堆积直接卡死; 散热约束:风冷机房温度上来之后,显卡会主动降频,硬件性能被迫缩水; 缺少上层调度优化,硬件本身没问题,但任务分配不合理,算力白白闲置。