ARTICLE · 1233592
LEDGER:用依赖图做Agent文档编辑,一致性提20%,token减85%
字数 3572,阅读大约需 18 分钟
LEDGER:用依赖图做Agent文档编辑,一致性提20%,token减85%
做过长文档智能编辑的团队,大概率都遇到过这个两难:把整篇文档都塞给模型吧,token成本随文档长度线性上涨,长文档动辄几万token,既贵又慢,还容易出现注意力分散,改着改着就跑偏了;只给目标段落的局部上下文吧,又很容易改出问题——改了个术语,后面引用的地方没跟着改;动了图的标题,正文里的对应描述没更新;甚至章节顺序调整了,交叉引用全错了。
本质上这不是模型能力不够,是上下文工程的问题:长文档里的依赖关系是结构化的,不是纯语义相似就能覆盖的。靠向量检索找相关段落,天然会漏掉显式引用、隐式前提、层级从属这些结构性依赖。
微软的这项工作,刚好针对这个痛点提出了LEDGER框架:把文档里的所有依赖关系显式建成一张轻量语义图,每次编辑的时候,沿着图去检索必要的上下文,不用全文档处理,还能自动做一致性校验。在1900个测试用例、6个主流模型上验证:一致性从56%提升到76%,单次编辑token用量减少85%,甚至低推理配置的LEDGER,效果能超过高推理配置的全文档基线。
一、Agent文档编辑的上下文工程难题
在讲具体方案之前,先理清楚这个问题的本质。Agentic文档编辑,比如“把第3节的术语统一更新”“修改图3的标题并同步所有引用”,本质上是个局部修改+全局一致性的问题。
现有方案基本分两类,但都有问题:
• 全文档方案:每次编辑都把整份文档喂给模型。好处是一致性有保障,坏处是成本O(n)线性增长,文档越长越贵,而且长上下文下模型注意力稀释,反而容易引入无关修改。 • 检索式方案:用语义相似度检索相关段落。好处是成本低,坏处是只能找到主题相关的内容,结构性依赖根本抓不到。比如“如图3所示”这种显式引用,向量相似度根本匹配不上;还有前面定义的变量、假设的前提,这些隐式依赖,纯语义检索也很容易漏掉。
结果就是:高效的方案不一致,一致的方案不高效。LEDGER要解决的就是这个矛盾:用显式的依赖图来建模所有结构和语义关系,既做到只取必要的上下文,又保证一致性不丢。
二、核心架构:一张依赖图,串起全流程
LEDGER的整体思路非常清晰:先把文档的依赖结构一次性抽出来建成图,之后每次编辑都基于这张图做定向检索,改完再做一致性校验并增量更新图。
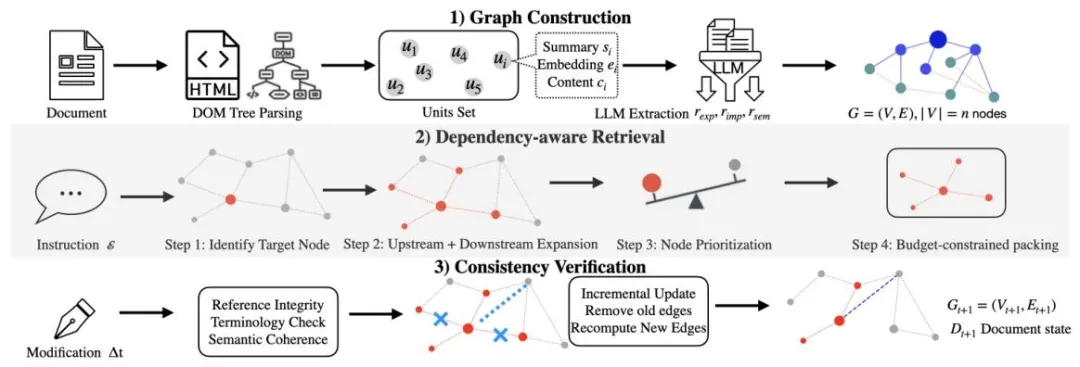
图1 LEDGER整体架构整个流程分三步:图构建、依赖感知检索、一致性校验。
1. 语义图构建:四类边,覆盖所有依赖
首先把文档解析成DOM树,拆成章节、段落、图表、公式等单元,每个单元对应图里一个节点。然后建立四类边,覆盖不同的依赖关系:
• 包含边(CONTAINS):直接从DOM树来,比如章节包含段落,段落包含公式。 • 显式引用边(REFERENCES):比如“见定理2”“如表3所示”,明确通过编号引用其他单元。用结构化抽取协议识别,保证最小、明确、目标存在。 • 隐式依赖边(DEPENDS):比如“这个结论”“上述算法”这种指代,还有前面定义的术语、变量,后面要用到的。用反事实测试协议判断:去掉这个单元,目标单元会不会语义不完整?会就是有依赖。 • 语义相关边(RELATED):主题相关但没有明确引用的单元,用嵌入余弦相似度判断,阈值0.7。
这四类边的重要性是递减的:目标单元 > 显式引用 > 隐式依赖 > 语义相关。这个优先级排序是后续检索的核心依据。
2. 依赖感知检索:按优先级取,预算内打包
每次收到编辑指令,检索分四步走:
第一步,定位目标。指令里有明确编号(比如“第2.1节”)就直接定位;没有就用指令嵌入找最相似的节点。
第二步,依赖扩展。从目标节点出发,沿着图的边双向扩展:上游是目标依赖的内容(比如前提、定义),下游是依赖目标的内容(比如引用目标的段落)。都要拿,改上游要确保下游还成立,改下游要确保上游前提对。
第三步,优先级打分。目标节点优先级最高,然后按边的类型降序:显式引用最高,其次隐式依赖,然后层级包含,最后语义相关。确保关键的结构性依赖优先进入上下文。
第四步,预算约束打包。按优先级从高到低往里加,直到token预算打满。默认大概取文档的10%-15%的token,就能覆盖所有关键依赖。
3. 一致性校验:三类检查,增量更新
修改完成之后,不是直接完事,还要做三类一致性检查:
• 引用完整性:所有从修改单元出发的引用,目标还存在不存在,有没有断链。 • 术语一致性:修改单元里的术语变了,依赖它的单元里有没有同步变。 • 语义连贯性:修改之后,和相关单元的语义相似度有没有大幅下降,有没有语义漂移。
检查完之后,增量更新图里和修改节点相关的边,不用全图重建,下次编辑继续用。
三、实验结果:一致性、效率、推理替代三重收益
研究做了非常全面的测试,1900个测试用例,覆盖7类编辑场景,6个主流模型(Claude 4.5全系列、GPT-4.1/5/5.2)。
1. 整体效果:一致性涨20点,token还更少
表1 六个模型的整体对比
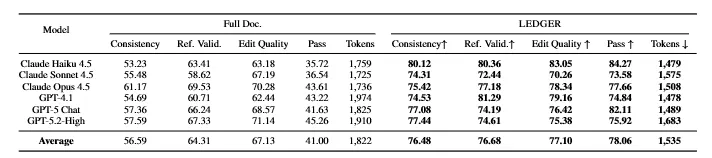
平均来看,LEDGER把一致性从56.6%拉到了76.5%,提升了近20个百分点;整体通过率从41%升到78%,接近翻倍。更有意思的是token用量反而更少了:平均每次编辑1535个token,比全文档的1822还少。因为LEDGER只取相关部分,虽然有结构开销,但比整份文档还是少很多。
小模型的提升尤其明显。Claude Haiku 4.5加LEDGER,一致性从53%升到80%,涨了27个点,甚至超过了全文档模式下的大模型。说明显式的结构引导,可以弥补模型本身能力的不足。
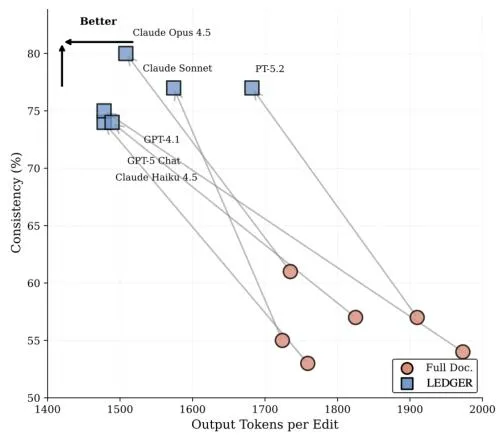
图3 效率-质量帕累托前沿从散点图看更直观:LEDGER的配置都集中在左上象限,一致性高、token少,基本就在帕累托前沿上。基线都在右下,要么一致性低,要么token多。
2. 分场景:依赖越重,收益越大
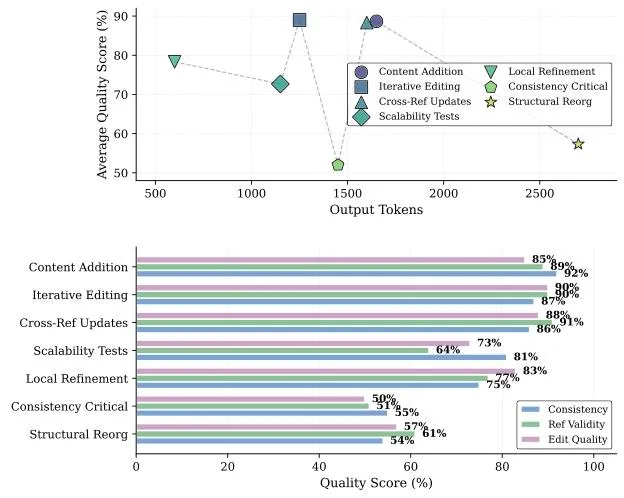
图2 不同编辑场景的表现不同类型的编辑,收益差异很大:
• 交叉引用更新、内容添加、迭代编辑这几类,一致性都在85%-88%,因为这些场景高度依赖引用追踪,刚好是LEDGER的强项。 • 局部细化也有85%的一致性,而且只需要560个token,效率极高。 • 结构重组是最难的,只有54%的一致性,因为跨层级的结构变动会触发级联更新,对图的构建和更新要求最高。
这个分布也很符合预期:结构性依赖越强的场景,显式建模的收益就越大;纯局部修改的场景,本来就不难,提升空间小。
3. 反直觉发现:结构可以替代推理
这是这篇论文很有价值的一个洞见:显式的依赖结构,可以替代模型的内部推理。
表2 GPT-5.2不同推理等级对比
数据非常说明问题:LEDGER加低推理,一致性80.12%,远高于全文档加高推理的57.59%。而且token还少了20%多。
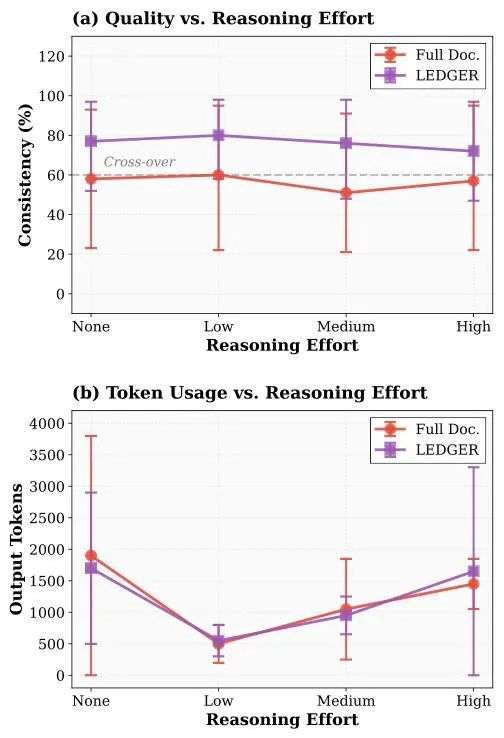
图6 推理努力的影响左图看一致性:LEDGER跨推理等级都很平稳,71%-80%之间;全文档基线是U型的,中推理反而比低推理还差,说明没有结构引导的时候,加推理反而可能引入混乱。右图看token:两边都随推理等级上涨,但LEDGER始终少11%-15%。
换句话说:靠结构能解决的问题,没必要靠堆推理算力。把依赖关系理清楚,小模型低推理,效果能超过大模型高推理。这个思路对于做落地的团队非常有价值。
4. 可扩展性:token不随文档长度涨
这是工程价值最大的一点:LEDGER的token用量基本不随文档长度增长。
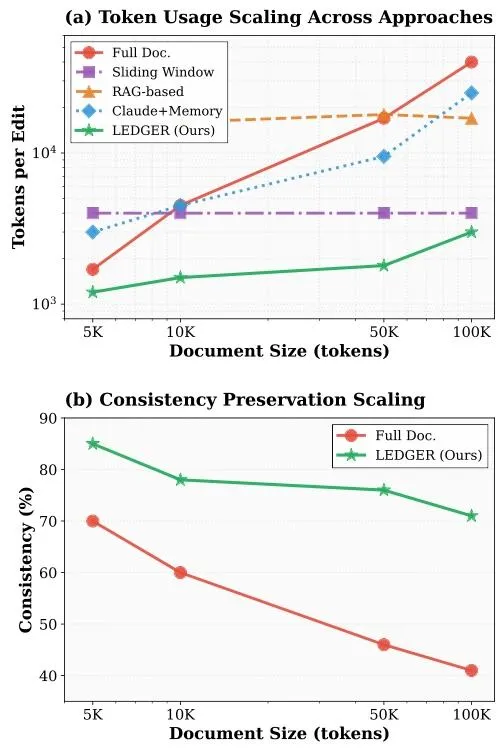
图7 可扩展性对比文档从5K token涨到100K token,全文档方案的token用量线性上涨,100K的时候要好几万token;LEDGER基本稳定在1500左右,几乎平的。100K文档的时候,相比全文档重生成,token减少了85%左右。而且文档越长,这个节省比例越大。
原因很直观:依赖是局部的。改一个段落,只需要它的上游前提、下游引用、所在章节这些,和整篇文档多长没关系。50页的文档和5页的文档,改一个段落需要的上下文量差不多。
5. 消融:依赖追踪是核心
表3 组件消融实验
三个组件都有贡献,其中去掉依赖追踪掉分最多,一致性掉了14个点。这也验证了最核心的价值就是显式的依赖建模。语义检索加层级结构只能到63%左右,加上显式引用和隐式依赖,才冲到76%。
表4 token预算敏感性
还有个很有意思的结论:10%-15%的内容就够了,再多加token,收益微乎其微,甚至到30%的时候还会轻微下降。因为无关的上下文多了,反而会干扰模型。这也和“Lost in the Middle”的现象一致:不是上下文越多越好,精准的相关上下文才有用。
四、工程启示与局限
对于做长文档Agent、智能编辑的团队,这篇工作有几个非常实在的启示:
第一,不要迷信全上下文,结构化检索性价比更高。对于结构化文档,把层级、引用、依赖这些结构先抽出来,按依赖优先级取上下文,比一股脑塞全文档效果更好,还便宜得多。
第二,结构知识可以替代推理算力。很多时候效果不好,不是模型不够大,是没给它结构化的引导。把依赖关系理清楚,小模型也能完成很复杂的跨章节一致性编辑。
第三,不要只用语义相似度做检索。对于文档编辑这类场景,显式引用、层级从属、前提依赖这些结构性关系,比主题相似度重要得多。纯向量检索天然漏掉这些,必须结合结构规则。
当然它也有局限:最适合结构清晰的技术文档、API文档、论文这类,有明确章节编号、图表编号、层级结构的内容;对于创意写作、对话记录这类无结构的内容,依赖就不好抽,效果会打折扣。另外依赖抽取本身也需要LLM调用,初始建图有一次性成本,适合多次编辑的场景,只改一次的话就不划算。
结语
LEDGER最有价值的地方,是它没有沿着“加大模型、加长上下文”的路子继续卷,而是换了个思路:把文档本身的结构和依赖显式地建模出来,用工程化的方法解决上下文工程问题。
它证明了一件事:在结构化场景里,显式的结构引导,比盲目的堆算力、堆上下文有效得多。对于做Agent落地的团队来说,这个思路非常值得借鉴:不要总想着让模型自己去理解一切,把我们知道的结构、规则、依赖,先验地编码进系统里,往往能用小得多的成本,达到更好的效果。
https://arxiv.org/pdf/2606.28379