ARTICLE · 1245868
自制小说 EPUB:26 个插件,一条从脏文本到成品书的流水线
自制小说 EPUB:26 个插件,一条从脏文本到成品书的流水线传送门: https://wwbcm.lanzouq.com/b01gicnsoj
密码:9ri1 
你有没有遇到过这种情况:从某个网站抓回来的小说文本,标题后面挂着一串括号注释,正文里混着“本章完”“求订阅”的广告尾巴;错别字要靠眼睛一页页挑;打包成 EPUB 传到多看里,封面缩略图模糊,立绘边缘发灰。 我以前靠人肉校对,一本书翻三遍。后来我把这套流程做成了 26 个 Sigil 插件,一条流水线跑完,每个插件只守一个岗位。 这篇文章就把这条流水线完整拆给你看:五个阶段、26 个插件,每个插件解决哪一类问题、为什么这么设计。 小说 EPUB 从无到有,会经过五个阶段:正文净化、文字体检、排版结构、图片质检、多看适配。 脏东西不是集中出现的,而是每个阶段各有各的脏:抓取文本带广告和错字,排版阶段带断行和多余分割线,图片阶段带半透明残留,打包阶段带元数据缺失。 所以我的做法不是做一个万能插件,而是每个阶段一个插件组,各守一岗。下面是这条流水线的全景:净化、体检、排版、图片、上架,五道工序,五组插件。 
从网站抓回来的文本,是第一手脏数据。这个阶段有九个插件负责把它洗干净。 错字和乱码是一类。FixPunctuation 负责标点引号修正,连 OCR 标点乱码都能修,还能豁免英文、网址和撇号,不误伤;FixOcrConfusables 专门治 OCR 形近字,“人”和“入”、“己”和“已”和“巳”这种靠字符集和整词锚定才敢动;FixTypoDict 挂着一本 1302 条的错别字词库,常见错字直接命中。 断行是一类。MergeBrokenDialogLines 专治引号没闭合就换段、叙述段被硬回车拆开的情况——这种问题人眼很难发现,因为它看起来就是两段。 杂质是一类。DeWatermark 去广告、导航、页码,带简介保护,60 字阈值以下不乱删;CleanPageMarkers 去页标记、页眉页脚;StripAuthorNotes 去作者括号元话语和引流完本感言;CleanTitleBrackets 清标题尾部括号注释。 最后是 ApplyReadNotes,读校笔记批量替换:规则预览、扫描确认再写回,错了还能批量撤销——它是这个阶段的收尾工具,把你自己的校对规则变成可重复执行的脚本。 净化之后是体检。这个阶段有九个只读插件,原则很一致:发现可疑,报告出来,交给人判断,绝不自动改。 为什么?因为这些检查项多数是低置信候选——“的、地、得”用错没有必然规律,繁体字残留可能是人名专用字,短句可能是人物语气。机器能做的,是把它们全部找出来、标好位置,但判不判,得靠眼睛。 CheckAdverbDe 核查“的、地、得”三类用法;CheckTraditionalChinese 扫繁体字残留;CheckDuplicateLines 查相邻重复行和重复章节名;CheckChapterGap 查缺章,中文数字章节名也能完整解析;CheckLongSentence 查 50 个汉字以上无句读的长句;CheckShortFragmentLines 查短促残句;CheckLineBreakPunctuation 查行首断行标点;CheckSplitCharWord 查标点分隔的自审字候选,命中词表才报高置信;CheckCrossBookPollution 查正文里串进来的异书内容——这是多源抓取最头疼的问题,不同书的内容混在一起,只有机器能逐页比对出来。 文本干净了,才谈得上排版。这个阶段四个插件,两修两查。 FormatNovel 管排版与章号规范,行首行尾的空白字符集一次清干净,U+3000 全角空格保留——这是逆向阅读器排版后沉淀出来的细节;FixDivider 预处理分割线,裸行识别、连续分割线合并、文末多余删除;TitleColorFromImage 让章标题颜色跟随章节配图的主色、卷标题颜色跟随卷页底图的主色——一本书的目录看起来顺眼,靠的是这个;CheckEpubStructure 查章节结构,样式块里有没有混进叙述文字、spine 头部顺序对不对,它逐条报。 
阅读顺序这件事值得多说一句。一本规范的小说 EPUB,顺序是固定的:封面、扉页、简介、编号页、公众号页、写真页,然后才进正文。这个顺序写在 spine 清单里,阅读器严格按它翻页。顺序乱了,读者翻书时就卡一下,看起来像书坏了。 图片阶段只有一个插件,但它的坑最深:CheckCutoutQuality,抠图质量量化核验。 判断一张透明立绘干不干净,传统标准是四角透明、主体完整。但真正毁掉成品的是半透明像素:PNG 的 alpha 通道在 64 到 253 之间的像素,浅色背景下发灰,深色背景下发白。这个插件会把 semi 占比量化出来,超标了给出修复方案——把 alpha 大于等于阈值的提到完全不透明,同时保留 1 到 63 的低 alpha 过渡带,这一圈渐变是抗锯齿的关键。 它还能把透明画布 padding 到目标尺寸(卷首图 1080×750、分割线 1:1),禁止拉伸变形;特效烟雾图自动豁免,不误修。 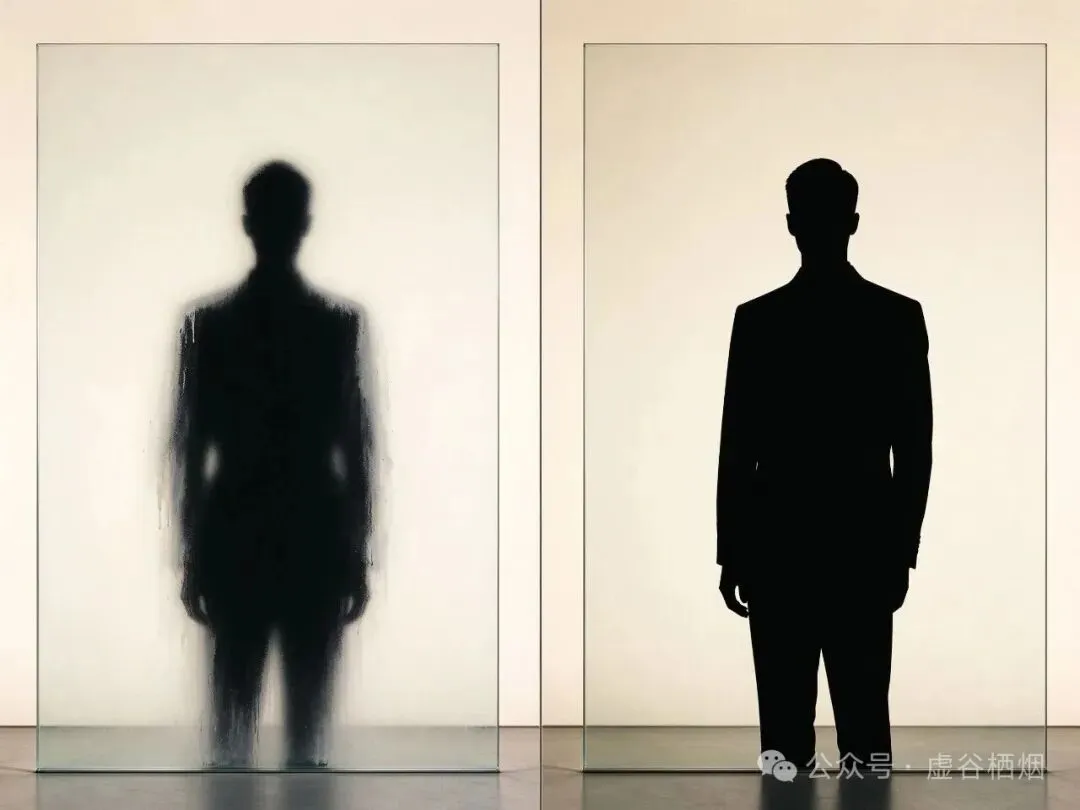
对比图里左边就是典型的半透明残留,右边是修复后的干净边缘——差别只有像素,但真实设备上看得很清楚。 打包之后,书要在多看里好看,还有最后三道检查。 CheckEpub2Compliance 是 EPUB2 合规体检,其中最重要的一块是多看元数据五件套:identifier 带 duokan-book-id,多看靠它识别书的身份证;meta 声明 DK-SONGTI 正文字体,拼错一个字母多看就锁不回宋体;meta 指向 cover.jpg,书架缩略图才不模糊;spine 封面页带 duokan-page-fullscreen,封面才能全屏;manifest 里 cover.jpg 和 cover~slim.jpg 双封面缺一不可。 CheckDuokanCss 校验多看引擎的 CSS 支持矩阵——渐变、伪元素、content 这些特性,多看认不认,它逐项报告;CheckFontFamilyRefs 查字体引用名的一致性和唯一性,同一个元素上 font-family 声明全书只能有一个。 误区一:检查插件越多越好。不是。这批插件的设计哲学是“只读报告优先、自动修复克制”——九个检查插件里绝大多数只报告不修改,会动手改的插件也都要求扫描预览、勾选确认、可以撤销。宁可漏改,不可错改。 误区二:报告多等于书有问题。不是。很多检查项本来就是低置信候选,插件的工作是把可疑点全部找出来标好位置,报告多恰恰说明检查足够细,真正该做的是人快速过一遍。 误区三:插件能代替校对。不能。它们把机械劳动自动化——逐行比对、逐页扫描、逐项核验元数据——但“这句话是不是病句、这个字是不是人名专用字”这类判断,最后仍由人来做。插件解放的是你的时间,不是你的判断。 这套流水线可以总结成一张行动清单: 净化阶段:抓回文本先过九个净化插件,错字、断行、广告、括号注释一次清。 体检阶段:九个只读检查全跑一遍,报告逐条过,人工判定。 排版阶段:FormatNovel 规范排版,FixDivider 处理分割线,TitleColorFromImage 定标题色,CheckEpubStructure 验结构。 图片阶段:CheckCutoutQuality 量化每张图,semi 超标就修,烟雾图豁免。 上架阶段:CheckEpub2Compliance、CheckDuokanCss、CheckFontFamilyRefs 三道检查全过,再进美化。 边界说明:多看相关的检查项,是第三方打包实践沉淀的可配置参数,不构成多看官方技术规范的引用;阅读器实际行为以它自己的版本为准。 自制 EPUB 最常犯的错,是把精力全花在看得见的地方——封面好不好看、排版精不精致——然后赌看不见的地方没问题。 更稳的做法是反过来:抓取之后先净化,净化之后先体检,打包之前先过三道适配检查。26 个插件不会替你判断,但它们能保证每一类机械劳动都不遗漏。 以后拿到任何一本书,都可以按这条流水线走一遍。能稳定跑完全程的书,基本就是“怎么看都不别扭”的那一类。
01 先搞清楚一个问题:一本书的脏,藏在五个阶段
02 第一阶段:正文净化——把抓回来的文本变成能读的正文
03 第二阶段:文字体检——只报告,不自动改
04 第三阶段:从正文到书——排版、分割线、标题颜色
05 第四阶段:图片质检——透明像素里的门道
06 第五阶段:多看适配——上架前最后三道检查
07 三个容易被误解的地方
08 以后做书,按这条流水线走
结尾:先过流水线,再谈美化