ARTICLE · 1248735
【听心烦说】我在自己电脑上跑通了 AI 换脸:150 帧 49 秒,坑有四个

做视频的时候,我碰到过一个需求:一段素材里,人脸得统一成同一个人。
网上现成的工具不少,但大多有两个问题。要么按月收钱,要么得先把素材传到人家的服务器上跑。前者还好说,后者我实在不太愿意——素材里如果有人,那就不是我的东西了,凭什么传出去。
那就自己装一个吧。
我以为这事一晚上能搞定。结果前后花了两天,而且真正折腾的压根不是软件本身,是四个我没预料到的坑。

一、先说清楚:AI 换脸到底在做什么
原理先讲明白,后面看步骤才不慌。
所谓"换脸",听着玄乎,拆开就是五步:
第一步,找到脸。程序先在一帧画面里找出所有的脸,框出来。这一步叫人脸检测。
第二步,认清五官位置。眼睛在哪、鼻子在哪、嘴角在哪,标出几十个点,叫关键点。有了这些点,程序才知道这张脸是什么姿态——正脸还是侧脸,仰头还是低头。
第三步,算出这张脸"长什么样"。把脸压缩成一串数字,相当于一个人的长相密码。
第四步,把 A 的脸的密码,套到 B 的脸上,生成一张新脸。
第五步,把新脸贴回原画面,边缘做融合,让它看着不像贴上去的。
所以它跟很多人想的不一样:不是把整张图重画一遍,而是只在原图人脸那一小块区域里做替换。背景、身体、衣服、光影,一动不动。
这也是为什么换完脸,人还是原来那个人,衣服还是那件衣服。
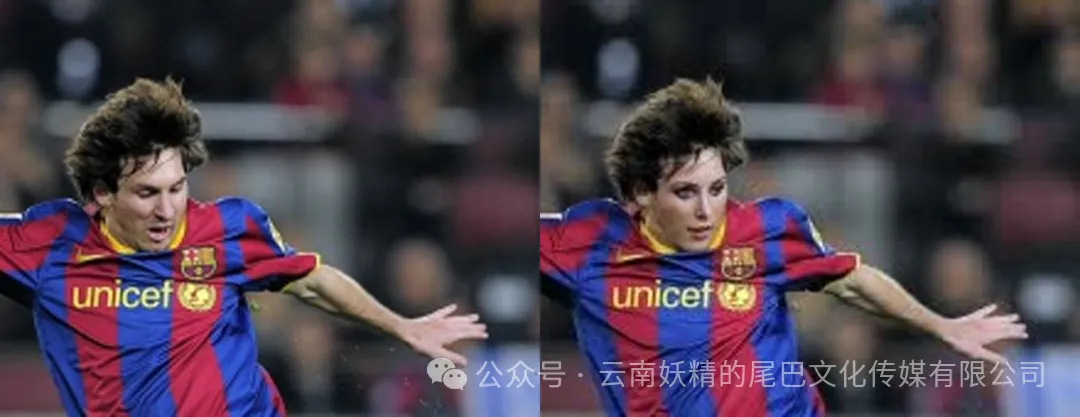
上面这张对比图,左边是原图,右边是换完的。脸换了,但构图、姿态、背景完全没变——这就是刚才说的"只动脸"。

二、为什么非要装在自己电脑上
三个理由,从最实际的开始说。
第一,素材不出门。这是我最看重的一条。程序跑在我自己机器上,图片和视频从头到尾没离开过这块硬盘。做内容的人都懂,素材里出现的每一张脸都可能涉及肖像权,能不外传就不外传。
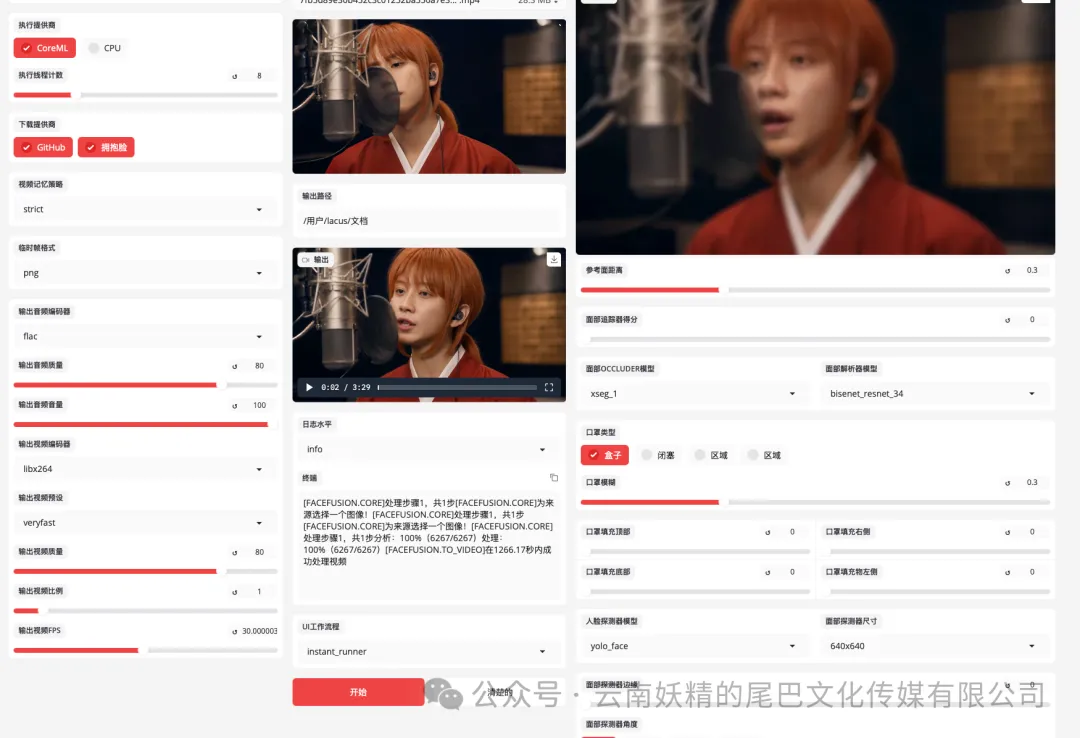
第二,不花钱。这是开源项目,软件本体免费。唯一的成本是电费和硬盘空间。
第三,可控。想批量就批量,想调参数就调参数,不用看谁的脸色,也不用担心哪天服务涨价或者关停。
但它也有明显的短板,得说明白:
慢。 这台机器是 M1 Max,苹果芯片,跑 AI 靠的是统一内存那块 GPU,跟英伟达的独立显卡比还是有差距。慢多少,下面有实测数字。
要动手。 它不是双击就装好的软件,得先配 Python 环境、装依赖、下模型。这一步劝退了大部分人——我这两天里,大半天就耗在这儿。
所以如果你只是想尝个鲜,用在线工具更省事;但如果你像我一样,素材不能外传、又想长期用,那自己装是值得的。

三、怎么装:从零到能跑
讲简明版。步骤本身不难,难的是环境(下一节细说)。
整体四步:
1. 准备 Python 环境。这个项目要 Python 3.10 到 3.12 之间。注意别用最新版——很多 AI 库还没跟上。 2. 建一个独立的虚拟环境。好处是装的这些东西不会污染系统,哪天不想要了,直接删文件夹。 3. 装依赖。一条命令的事,但会下载几百兆。 4. 跑起来。第一次运行会自动下载模型,也是几百兆。下完就出来一个网页界面。
界面是英文的,但结构特别简单,就三块:
左边一栏 SOURCE,放你的脸;旁边一栏 TARGET,放要处理的图片或视频;底部一个 START,点它开跑。
我第一次跑通的时候,单张图不到 3 秒就出结果了。真正磨人的全在下面。

四、四个坑:真正花掉我两天时间的东西
软件本身是好的,坑都在环境上。四个,逐个说。
坑一:装依赖,反复超时。
症状是安装到一半卡住,报错说某个几百 KB 的小包下载失败。
我第一反应是下载源的问题,换了两三个国内镜像,照样不行。
后来我做了个对比测试:手动去下载那个"下载失败"的文件,0.3 秒就下来了。可安装器自己去下,就是断。
这就说明问题根本不在源上,而在连接的保持上——短时间的小请求没问题,但安装器那种长时间的、并发的下载流,会被中途掐掉。
想通这一点,解决就简单了:把并发降下来、超时时间拉长,让它一个个慢慢下。慢是慢点,但一次就过了。
这事给我的教训是:报错信息指的地方,往往不是真正的原因。 报错说"网络错误",可能不是网络不通,而是连接被中断的方式有问题。
坑二:缓存悄悄膨胀到 1G。
这个坑不报错,是事后才发现的。
程序跑的时候会生成一个缓存目录,用来存编译好的模型。我一直没管它,回头一看——攒了整整 1G。
解决办法很简单:整个目录删掉,下次运行自动重建。就跟你电脑卡了重启一下一个道理。
坑三:模型加载失败。
有一次跑视频,报错说模型加载失败。
查下来是缓存的问题:同一时间多个进程都在编译模型,抢同一个缓存文件,互相踩了脚。
换成用 CPU 跑,不碰那套 GPU 缓存,就顺利过了。慢一点,但稳。
坑四:结尾那句吓人的报错。
这个其实不算坑,是虚惊。
每次跑完,最后都会蹦出一句 recursive_mutex lock failed,看着像是崩了。
实际上呢——成品早就写完存好了。这句话是推理引擎退出时的老毛病,跟结果没关系。
我第一次看到它,把整个流程白重跑了一遍。所以写在这儿:看到它别慌,先看输出文件在不在。

五、算笔账:这东西到底快不快
四个坑填完,说成果。
用苹果 M1 Max 的实测数据:
这是个什么概念:一段 6 秒的视频(150 帧),49 秒跑完。换算成一首 3 分 52 秒的歌,大概 5800 帧,全程要 25 到 35 分钟。
不快。但对着"素材不出门、不花一分钱"这两条,我觉得可以接受。
最后说两句边界,这个必须讲清楚。
只换该换的脸。 我自己的,或者明确授权给我的。别人的脸——哪怕是网上随手找的——都不行。这不是技术问题,是底线问题。
工具本身有授权限制。 这个开源项目默认带的那套换脸模型,官方标注是"仅供研究",不能商用。要商用得自己训模型,或者换可商用的方案。我做内容的时候注意到了这一点,也提醒一句:别稀里糊涂踩坑。
发布要标注。 按现行规定,AI 生成或处理过的内容发出去,得做标识。这一步别省。
两天折腾下来,最大的感受是:AI 这东西,网上说的和真上手之间,隔着一堆没人告诉你的细节。而那些细节,恰恰是最费时间、也最值钱的部分。
这也是我打算在这个号里写的东西——不讲概念,讲我实际怎么用、在哪儿栽过跟头。