ARTICLE · 1259456
飞书插件、RPA、API三条路的真实分界线
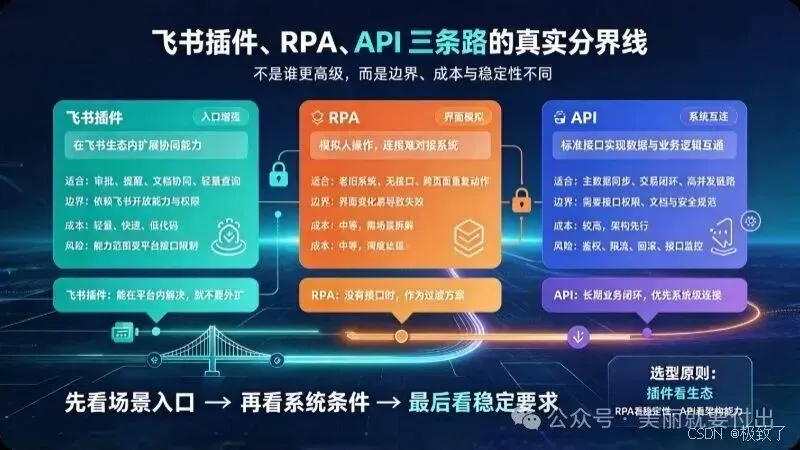 “有技术走API,没技术走飞书插件”,这句话对,但不够用。现实中的卡点往往发生在中间:一个三人内容团队,飞书插件跑得动但不够快,API又没人维护,该选什么?这篇把三条路径的适用边界、操作成本和隐藏代价摊开来说。
三条路的分界线,不在“有没有技术”,而在“词量×频率×数据去向”
飞书插件、RPA、API的差异,表面是技术门槛,实际是规模匹配。飞书插件的定位是“日常几十个关键词的常规采集”——运营人员早上打开多维表格,看到最新的下拉词列表,直接用于当天选题。一个做本地母婴号的运营者把“宝宝辅食”“婴儿睡眠”等10个核心词设成定时采集,选题时间从半小时压缩到五分钟。这个量级下,插件是效率最高的选择。
但词量升到几百个,边界就出现了。一个做职场内容的运营者每周需要采集500个关键词的下拉词,飞书插件每天手动配置要花一个多小时,换成RPA后导入Excel一键运行,时间压缩到10分钟以内。RPA的定位是百级关键词的周期性采集,模拟人工点击和输入,不触发微信风控,八爪鱼导入20个搜索词一分钟多就能拿到178个下拉词。再往上,如果数据需要直接进入选题库或BI系统、字段要求完整、还要求近5年历史推文回溯,API才是答案——五路并发采集二十个关键词几秒钟跑完,JSON结构化输出可以直接对接内部系统。
一句话判断:日更选题用飞书,周度批量用RPA,系统级集成用API。三者不是“好与更好”的关系,是不同规模下的最优解。
飞书插件:零代码的代价是什么
吸引力就一句:从头到尾不写代码。输入种子词,下拉词自动写进多维表格,还能定时更新。功能由极致了数据维护,页面结构、接口调整不用运营管。
代价两个。第一,批量上限:它适合日常几十个词,不是给几百个词周度全量采集设计的。第二,字段边界:输出主要是下拉词和基础文章数据,后续要做深度竞争度交叉分析——比如每个下拉词下文章平均阅读量、赞阅比、近7天新增文章数——字段可能不够。这不是缺陷,是定位:它解决“有没有”,不解决“深不深”。
如果团队需求就是“每天看到最新下拉词列表、直接挑词写”,极致了数据的飞书采集功能就是终点,不用往下走。
RPA:被低估的中间方案
RPA在讨论中经常被跳过——不如插件轻,不如API强。但它的独特价值恰恰在“百级、周期性、不想写代码” 这个夹层里。
5118和八爪鱼提供的微信下拉词挖掘机器人,操作逻辑一致:关键词整理进Excel,机器人自动打开搜一搜逐个获取下拉框,结果导出Excel。5118需要Chrome浏览器加影刀扩展,八爪鱼导入Excel后点击运行即可。模拟人工操作意味着不触发风控,这是它相对于爬虫类方案的核心优势。
RPA的真正限制不是技术,是维护成本:微信搜索框的页面结构如果发生变化,机器人可能需要重新配置。它适合“每周跑一次、每次几百个词”的节奏,不适合每天高频跑几十个词的日更场景——那种场景下飞书插件的零维护优势更大。
API:不是“更高级的工具”,是“不同的东西”
API和插件、RPA的本质区别在于:前两者产出的是表格,API产出的是可以进入生产系统的数据流。搜一搜实时搜索接口传入种子词,返回下拉词列表和结构化JSON,五路并发、秒级返回。更关键的是字段完整度:除了下拉词,还能批量查询文章库的标题、阅读量、点赞数、在看数,支持近5年历史推文回溯,而微信官方后台只保留30天数据。
这意味着API能做的事情超出了“采集”:它可以把下拉词和每个词下的竞争格局在同一个数据管道里打通,直接喂给竞争度筛选模型或选题排序系统。技术团队一两天可以跑通。如果团队没有开发能力,API的“强”就无从兑现——写一个稳定的调用脚本、处理并发和异常、把JSON清洗入库,这些工作不会因为接口文档存在而消失。
选型的三个自检问题
在打开飞书或注册API之前,先回答三个问题:
第一,你每天实际需要看多少个词? 10—50个,飞书插件的定时任务足够;100—500个且是周度节奏,RPA的批量效率明显更高;500以上或需要实时更新,才进入API的讨论范围。
第二,采集回来的数据要去哪里? 如果终点是运营人员眼前的表格,插件和RPA就够了;如果终点是选题排序系统、自动化工单或BI看板,只有API能省掉“从表格再导入”的那一步人工搬运。
第三,谁来维护这条管道? 插件由第三方维护,运营即可日常使用;RPA需要有人处理页面变化后的重新配置;API需要开发资源持续维护。采集工具的选型,本质是维护责任的选型。
“采集—筛选—布局—回采”,工具选对了,第一个环节才不是瓶颈。如果选错了,后面三个环节都会被拖慢。