ARTICLE · 1274057
【高质量】OCR 选型指南:把 PDF 和扫描件变成 AI 能读的结构化数据,6 个高分项目边界横评
每周一个 AI 岗位上手清单 · 第 03 期
OCR 是 AI 落地链路里最容易被低估的一环。你把文档喂给模型之前,得先有人把纸面上的字、表格和公式变成机器读得懂的东西。
这一期我们只做一件事:把同一类资料,交给不同的开源工具,看它们各自擅长什么、又各自在哪儿翻车。
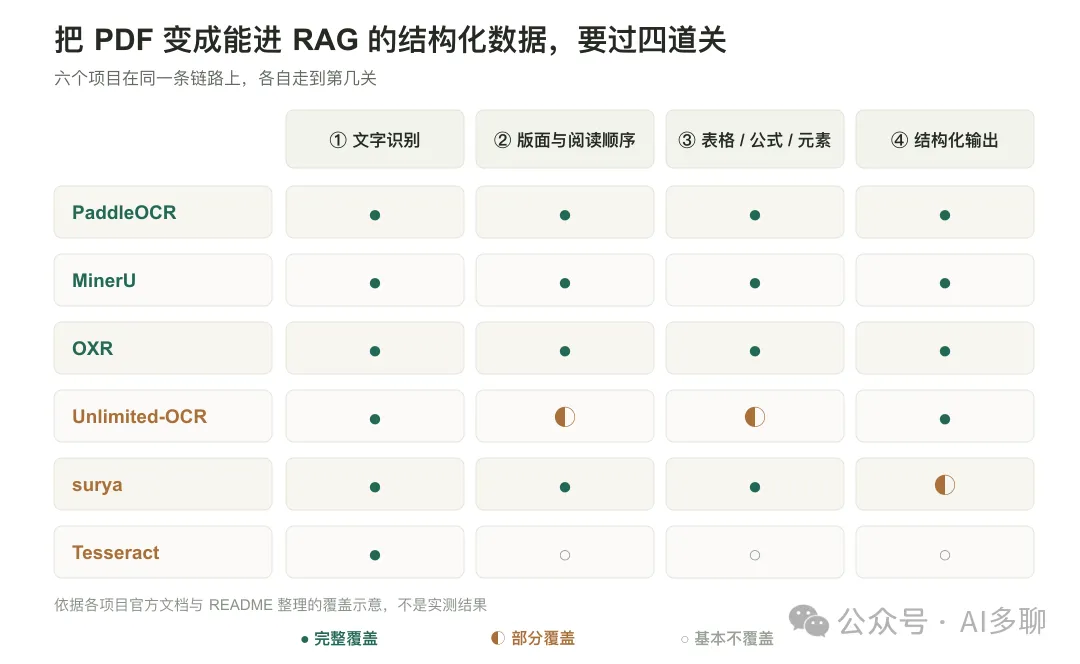
用途速查表:先按你的活儿选工具
六个项目的基本盘与选型结论
数据采集日期 2026 年 10 月 29 日,取自 GitHub 仓库页与 Releases 页。Star 是热度,不是能力评分。Fork 依次为 11,582、6,834、10,869、3,146、1,567、153。最新版本依次为 v3.7.0(2026-06-11)、mineru-4.0.12(2026-10-11)、5.5.4(2026-10-28)、无正式 release、v0.22.1(2026-07-20)、无正式 release。
先把两处需要核实的许可证讲清楚。OXR 在 GitHub 上未被识别为标准 SPDX 许可,仓库为新项目,商用前必须自行核对授权条款;MinerU 同样未被识别为标准 SPDX,其社区版历史上采用 AGPL 系列条款,对外提供网络服务时需重点评估。这两条与 Apache-2.0、MIT 的项目在商用风险上不是一回事,本文评分会体现这个差别。
1. PaddleOCR:中文场景的事实标准
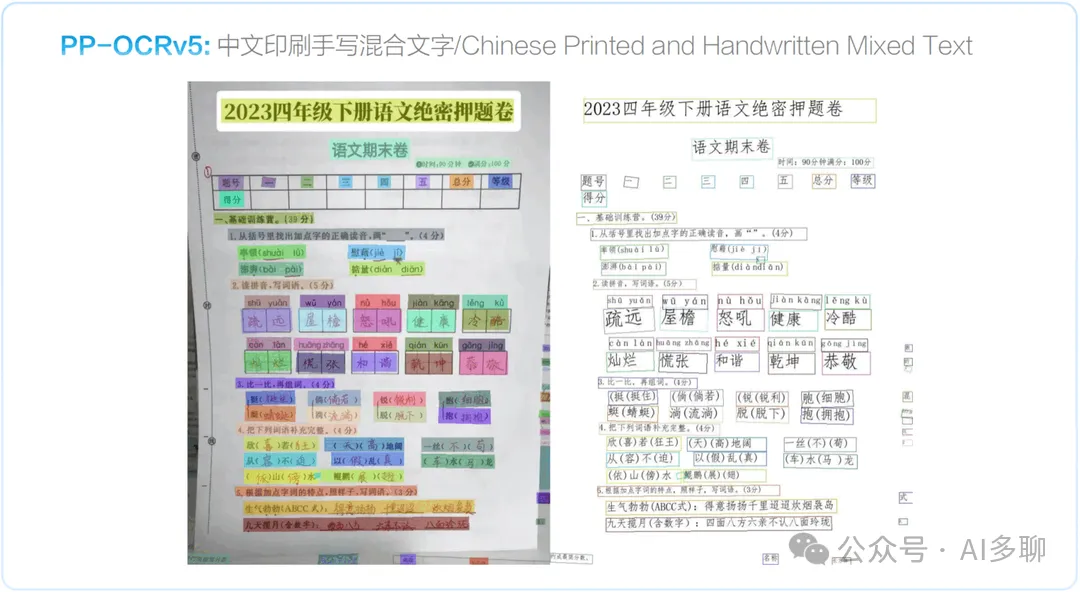
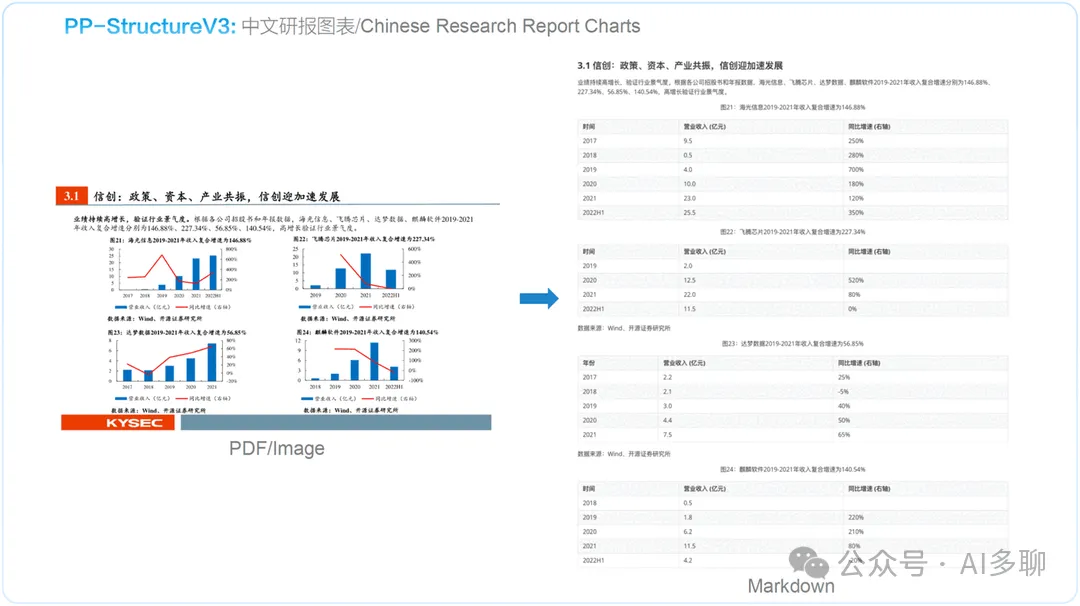
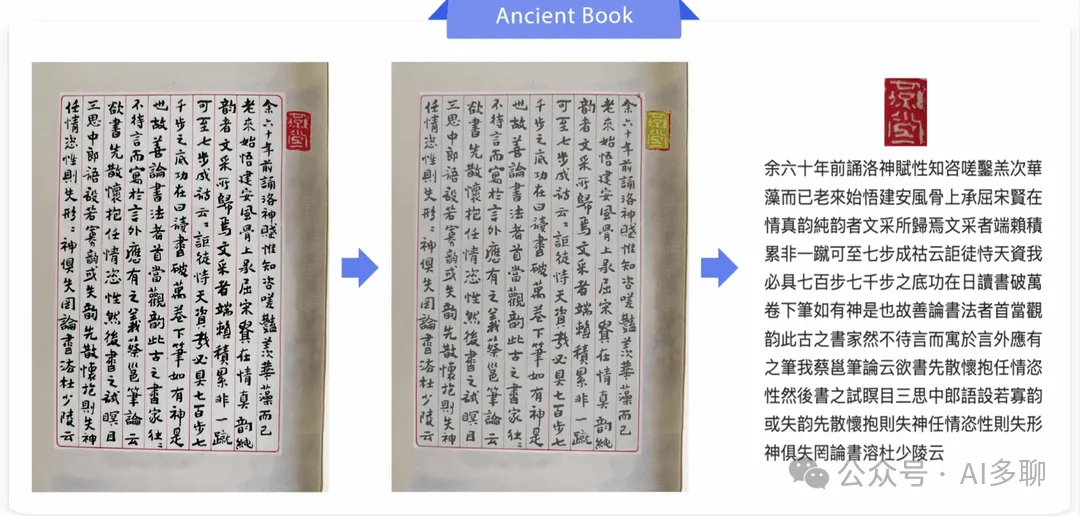
用途:把 PDF 或图片文档变成结构化数据。它的官方描述就一句话:turn any PDF or image document into structured data for your AI。覆盖文字检测、方向分类、文字识别、表格结构、公式、版面分析到印章、图表与公式识别,是一整套流水线,而不是单一 OCR 模型。
使用场景:中文业务系统的落地首选——发票、报销单、银行流水、身份证与合同截图转结构化字段;电商与直播的实时字幕与商品信息抽取;以及任何需要把图片转成可查询文本的批量流水线。它有 PP-OCR、PP-StructureV3、PaddleOCR-VL 等多条产品线,可以只取其中一段能力。
要求:有轻量级纯 CPU 部署路径,也有 GPU 加速与训练版本;PaddlePaddle 生态依赖较重,版本耦合需要留意;商用最宽松,Apache-2.0 无附加条件。
优势:中文识别准确率与速度的平衡点最好、社区规模最大、中文文档场景的踩坑经验沉淀最多。当你不确定选什么,先用 PaddleOCR,它的输出格式与后续工具的兼容性也是最好的。
限制:最新正式版 v3.7.0 发布于 2026 年 6 月,迭代节奏慢于近两周连发版本的其他项目;公式与化学式的还原精度不如专门做这件事的模型;超长文档不是它的设计目标。
2. MinerU:专门为 RAG 准备的那一个
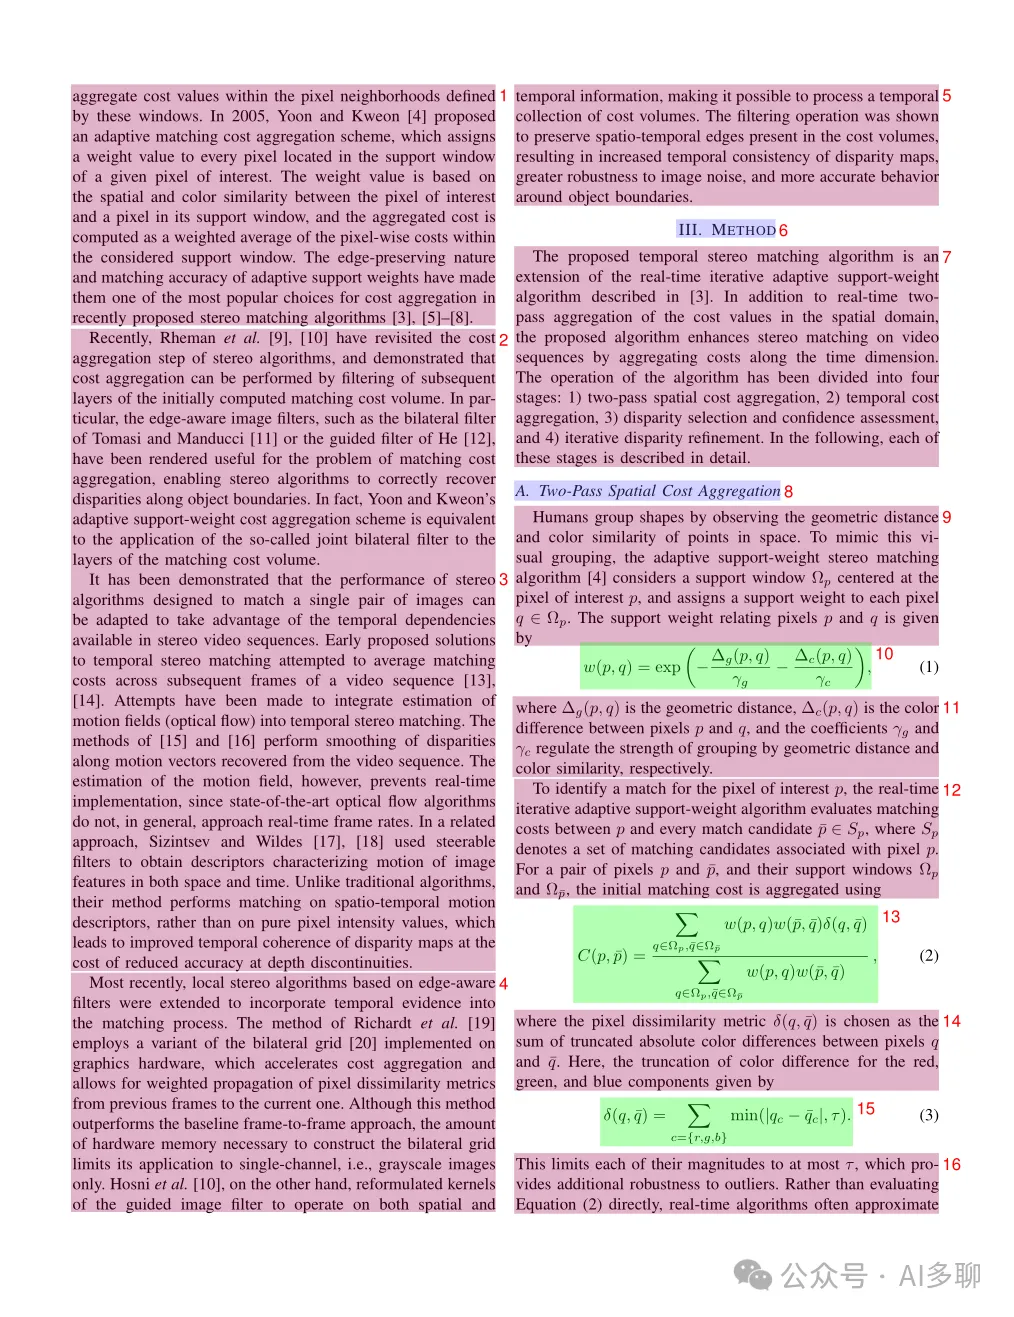
用途:把复杂 PDF 与 Office 文档转成 LLM 就绪的格式。它的目标很明确——产出的 Markdown 不是给人读的,是给模型读的:标题层级正确、表格是 HTML、公式是 LaTeX、图片位置有标记。
使用场景:企业知识库与论文库的批量入库;合同、研报、财报这类多栏排版 PDF 的结构化;以及任何"把 PDF 丢进 RAG,但检索效果不好"的场景——问题往往不在模型,而在解析阶段丢了表格结构。
要求:有 GPU 与纯 CPU 两套路径,CPU 路径可用但速度慢;模型体积较大,首次运行需要下载权重;需要一点 Python 环境配置。
优势:82,697 Star、6,834 Fork,是这个赛道里被生产验证最多的工具之一;针对中文学术 PDF 的版面理解明显强于通用 OCR;产出直接就是 Markdown,不需要二次加工。
限制:许可证是选型里最需要确认的一项,社区版历史上采用 AGPL 系列条款;中文文档强、英文与多语言复杂版面的表现弱于专门做多语言的工具;文档极长时同样会遇到显存与缓存瓶颈。
3. Tesseract:不能装依赖时的保底方案
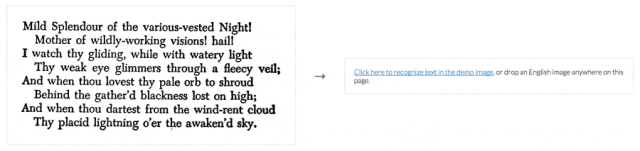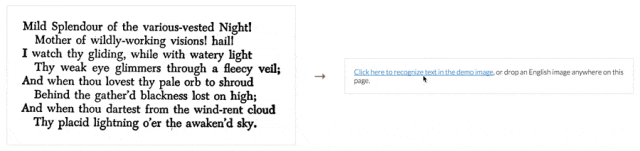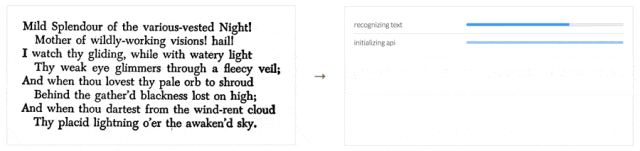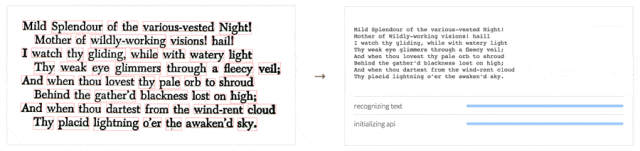
用途:最经典的开源 OCR 引擎,纯粹做文字识别,没有版面分析、没有表格结构、没有公式。
使用场景:系统里不允许装深度学习框架、只有 CPU、或者需要处理大量印刷体纯文本的场景;老旧文档数字化、扫描书正文入库;以及作为其他方案出错时的兜底对照。
要求:安装轻、内存占用低、语言包按需下载,是这六个里部署门槛最低的。
优势:Apache-2.0,资源占用最低,没有模型下载,在受限环境里它是唯一稳妥的选择;77,219 Star 与 10,869 Fork 意味着生态与文档沉淀深。
限制:能力边界非常清楚——只有文字识别,表格、版面、多栏一律处理不好;中文识别精度与当代模型差距明显;对倾斜、噪声、复杂背景的鲁棒性弱。本期它排在末位不是 Stars 的问题,是定位不同。
4. Unlimited-OCR:把长文档的缓存成本打下来
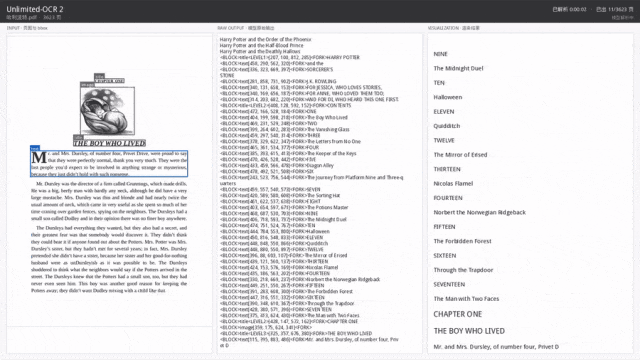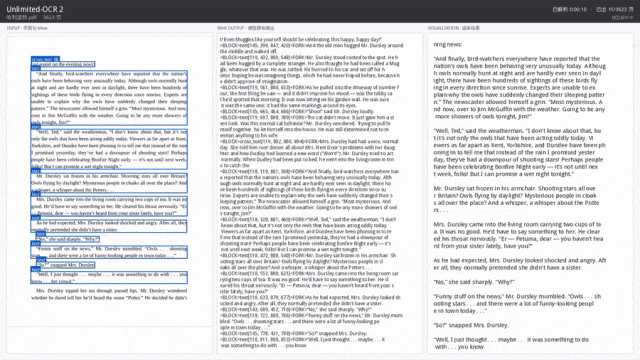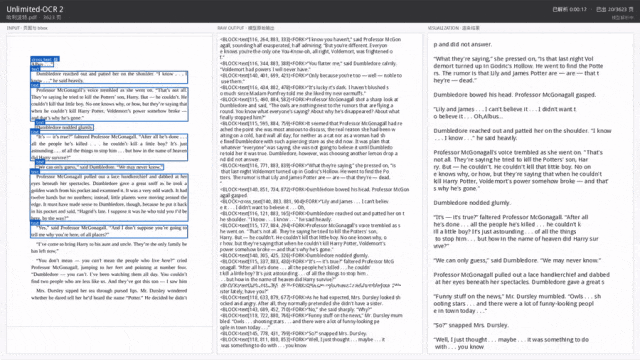
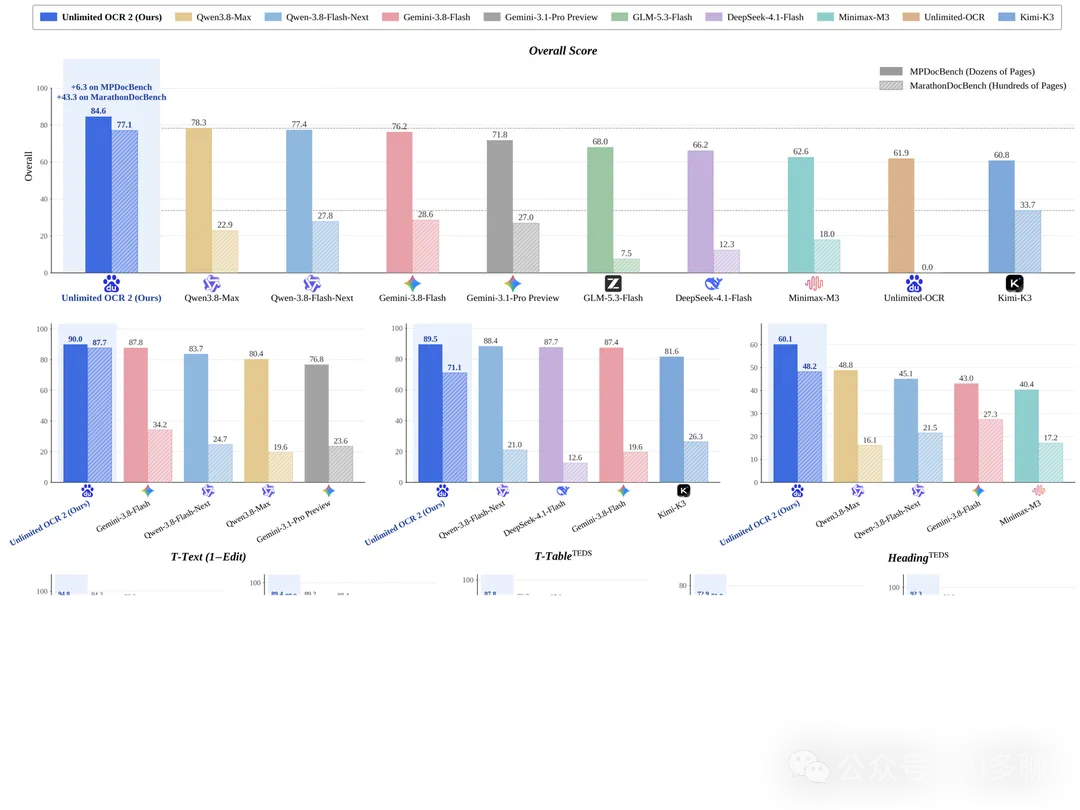
用途:一次性长时程解析——目标不是读一页,而是连续读完一整本。上一代在开源社区累计下载超 1000 万,GitHub 约 2.86 万 Star,是国内项目里少见的能进 Hugging Face 生态的 OCR。
使用场景:几百到几千页的合同、标书、卷宗、论文集批量入库;需要在单卡上处理长文档而不被显存卡住;以及把"整本书进知识库"从设想变成工程排期。
要求:需要 GPU 跑多页长序列;HF 与 GitHub 均有开源权重;MIT 许可证。
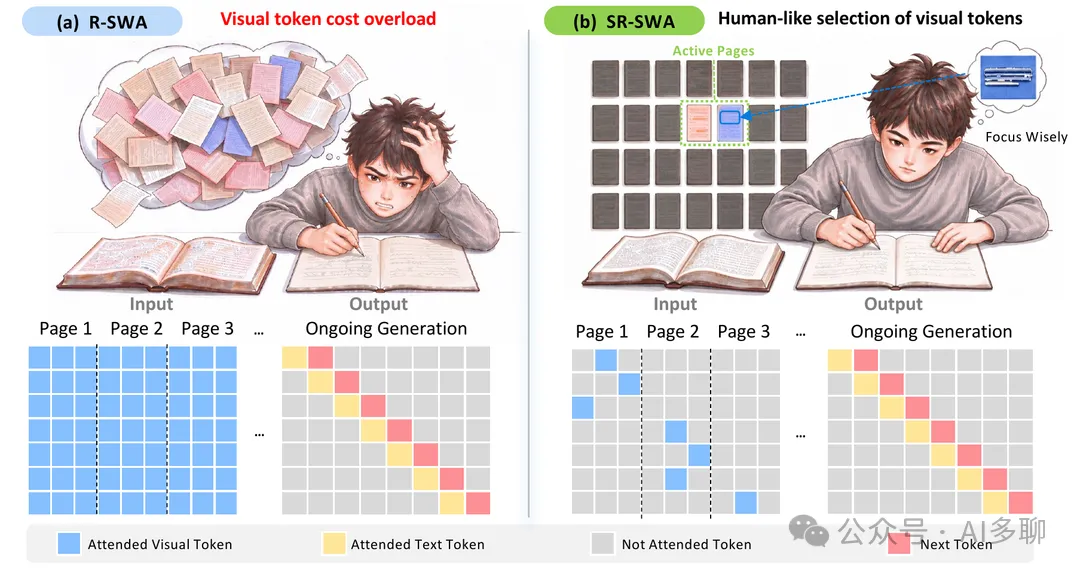
优势:百页级单序列测试中,峰值 KV Cache 占用从标准解码的 47GB 降至 1.77GB,减少约 96%。演示能力是连续读完 7 部《哈利·波特》共 3600 多页、《三体》全集 1200 多页。MIT 许可证在商用上最省心的一档。
限制:本代引入稀疏参考滑动窗口注意力 SR-SWA,分 Page Gate 与 Token Sieve 两层筛选,长文档里"该看哪几页、哪几行"由模型自己决定,调试与纠错比传统流水线更难;仓库无正式 release,版本要跟主干走。
5. surya:多语言与轻量的平衡点
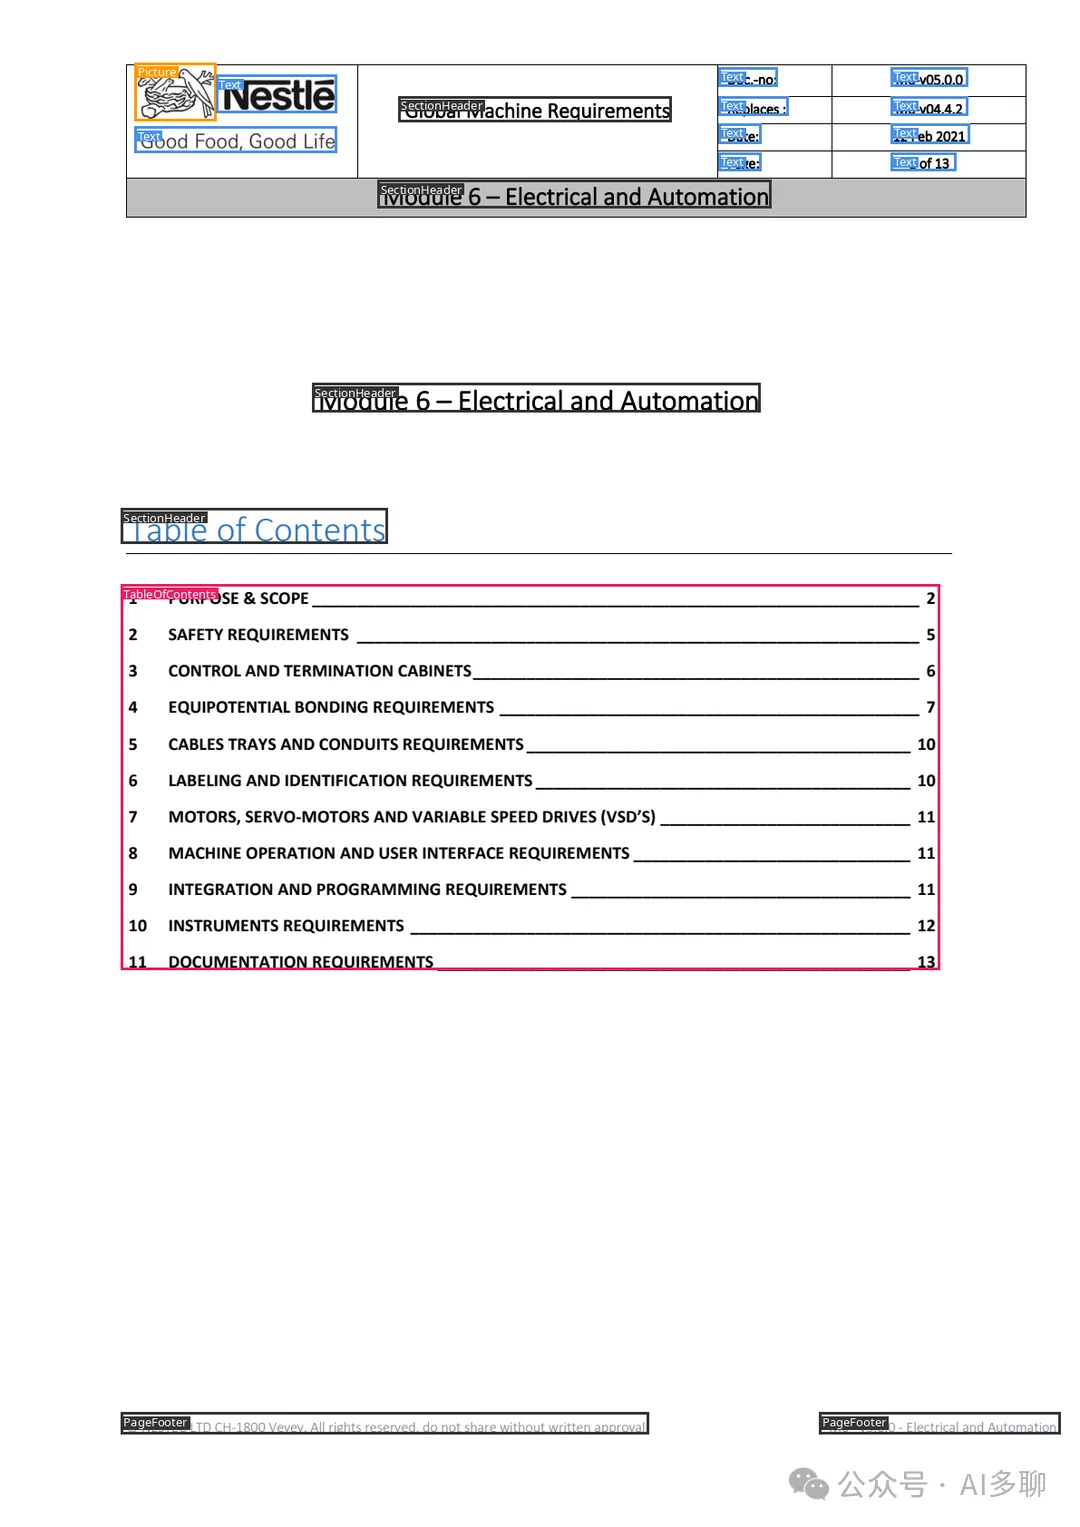
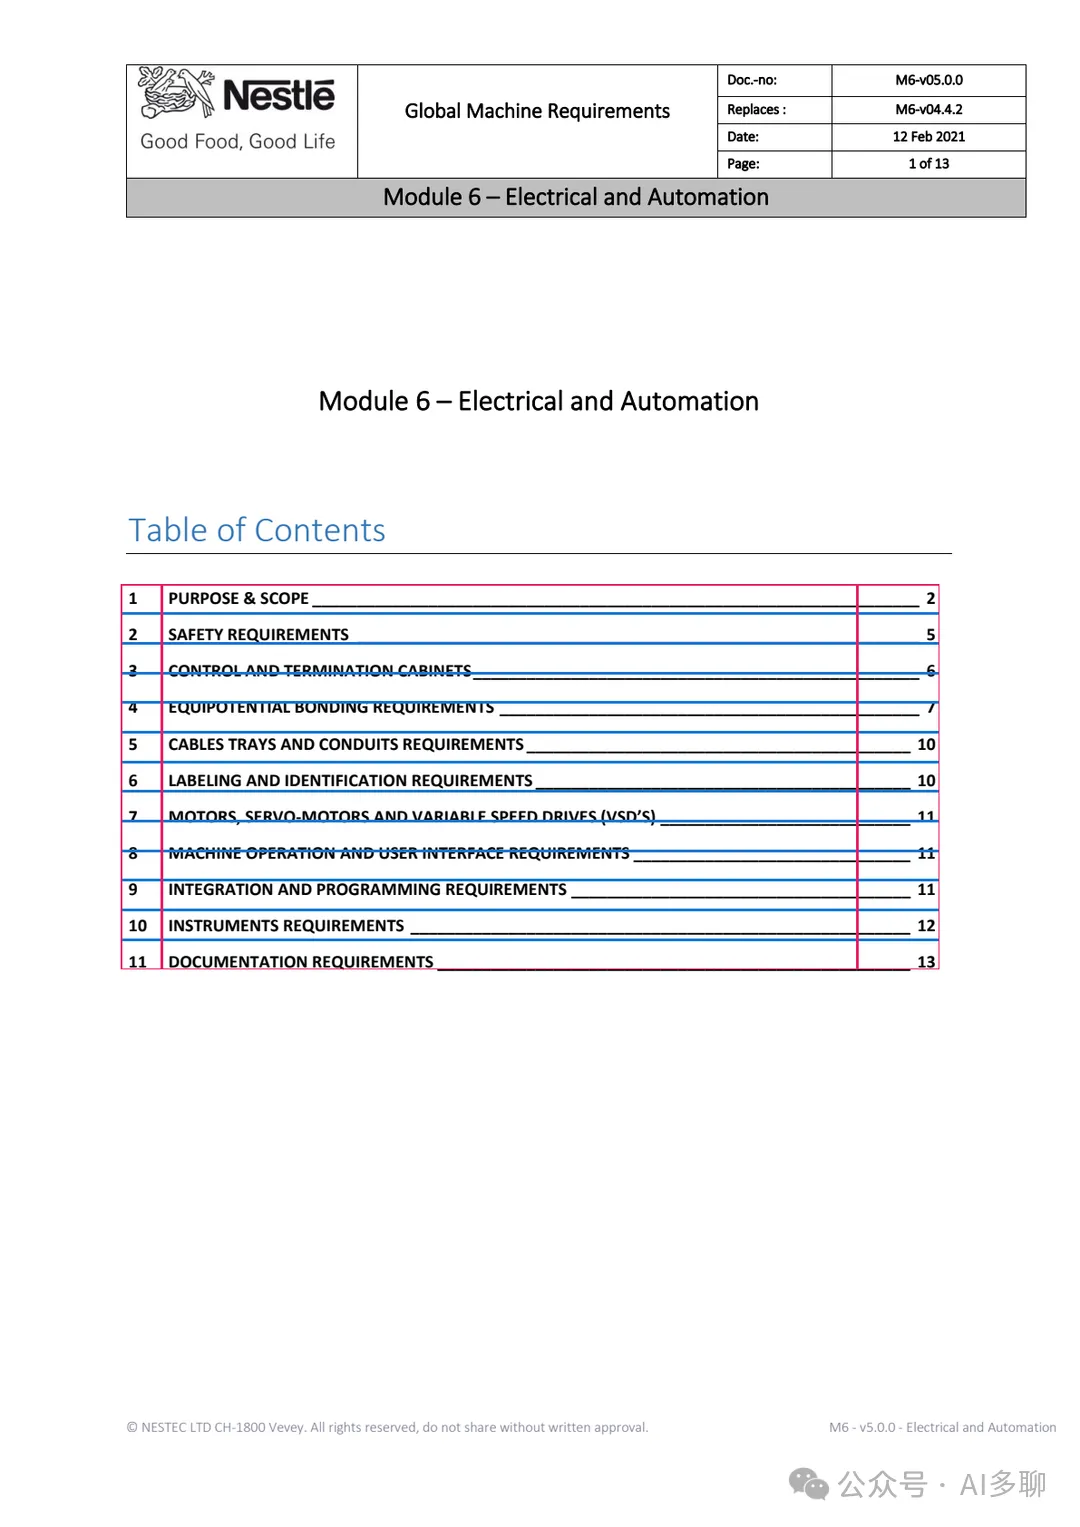
用途:一套覆盖 90 多种语言的文档工具:OCR、版面分析、阅读顺序判断与表格识别一次做完,输出带坐标。
使用场景:多语种资料库——海外论文、日文与欧洲语言合同、跨境电商多语言商品资料;以及对"需要拿到文字在页面中的位置"的场景,比如从扫描件里定位某个字段、给原图打标注。
要求:Python 环境,依赖现代 GPU 效果最好,CPU 也能跑但慢;模型权重需要下载。
优势:Apache-2.0 许可干净;多语言覆盖是这六个里最广的;版面、阅读顺序、表格一次输出,省掉拼装多个组件的麻烦。
限制:中文场景的表现不如 PaddleOCR 专项优化;版本发布节奏偏慢(最新 v0.22.1 为 2026 年 7 月);在长文档与复杂公式上不如专门方案。
6. OXR:刚开源就把三个基准打到了第一
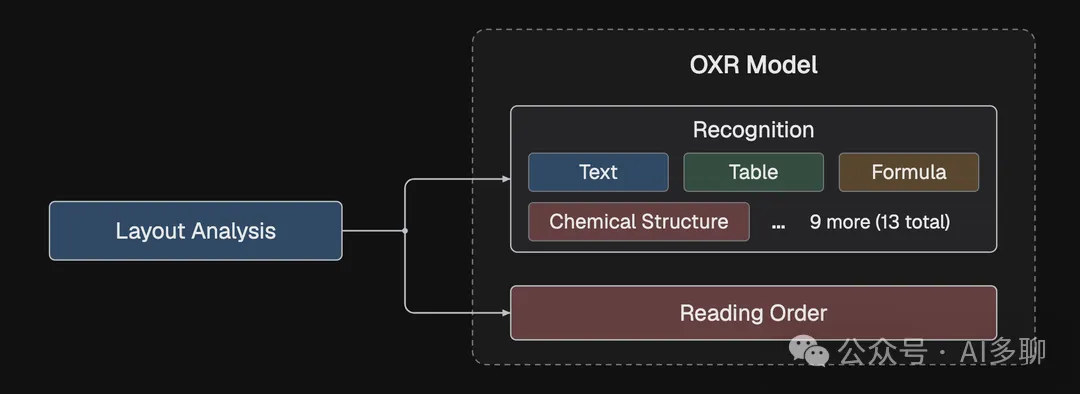
用途:Optical Everything Recognition——不只认字,还要把表格、公式、化学式、代码块等 13 类文档元素一起解析成可继续处理的表达,并保留版面坐标。表格输出 HTML,公式输出 LaTeX,化学方程式用 mhchem,化学结构式用 SMILES。
使用场景:科研文档的深度解析——上下标公式、跨行跨列表格、多栏论文的阅读顺序;以及对"OCR 结果要能直接喂给 Agent 或 RAG"的场景,它输出的就是带结构的 Markdown 与 JSON。
要求:1.3B 小模型,显存门槛明显低于同类;官方提供在线 Demo 与免费 API,可以先用真实文档试,不必先部署。
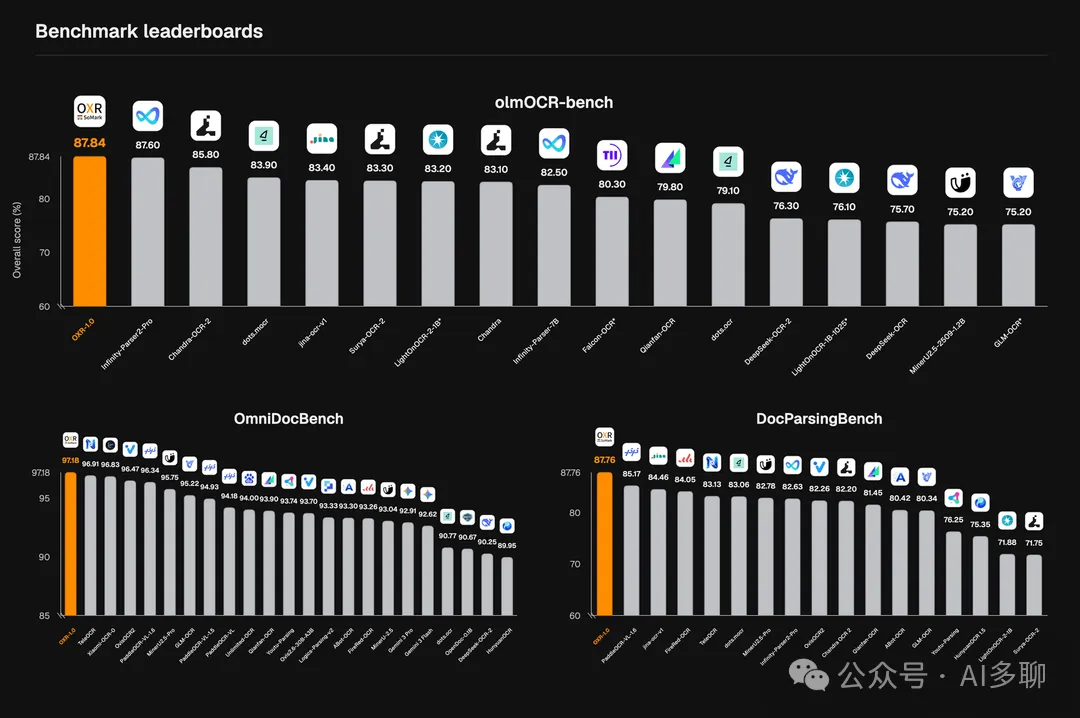
优势:官方公布数据在 OmniDocBench、olmOCR-Bench、DocParsingBench 分别取得 97.18、87.84、87.76 分,均列第一;速度是第二个亮点——同一张 RTX PRO 6000 Blackwell(96GB)上解析 100 页文档约 101 秒,PaddleOCR-VL-1.6 约 145 秒、MinerU2.5-Pro 约 255 秒。架构上由轻量版面模型定位区域、主模型做识别与阅读顺序,版面分析做成可插拔模块,业务可以换成自己的标准。
限制:2,192 Star、2026 年 10 月 5 日建仓,是六个里最年轻、验证最少的;GitHub 未识别出标准 SPDX 许可,商用前必须自行确认;上面的成绩全部来自团队自测,不是第三方独立验证。
加权评分:满分 5 分,权重合计 100%
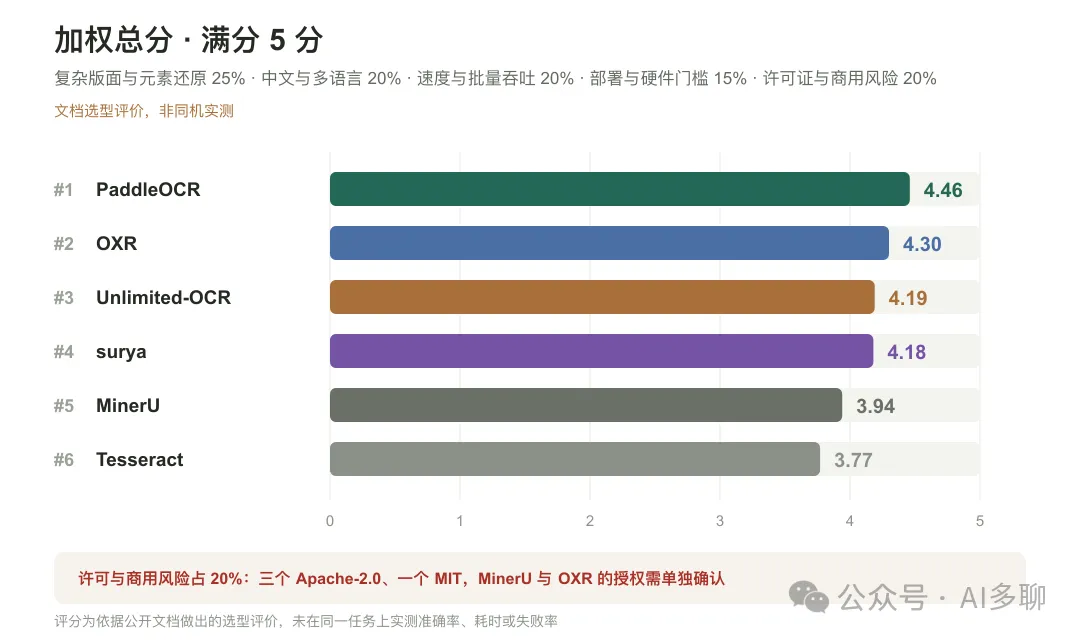
下表五个分项的权重依次为:版面=复杂版面与元素还原 25%,语言=中文与多语言 20%,速度=速度与批量吞吐 20%,部署=部署与硬件门槛 15%,许可=许可证与商用风险 20%。
评分尺度为 1 至 5 分,5 分为该维度上的最优表现。加权总分 = 各项得分乘以对应权重后求和,权重合计 100%。
各维度依据如下。
复杂版面与元素还原 25%:看表格、公式、多栏能不能还原成结构。OXR 覆盖 13 类元素并能判断阅读顺序,得 4.8;MinerU 专攻学术 PDF 版面,得 4.5;PaddleOCR 有 PP-StructureV3 与公式、图表、印章识别,得 4.2;Unlimited-OCR 关注长而未必关注复杂元素,得 4.2;surya 覆盖版面与表格但不主打公式化学式,得 4.0;Tesseract 只有文字识别,得 2.6。
中文与多语言 20%:PaddleOCR 的中文表现最好,得 4.8;Unlimited-OCR 与 OXR 对中文均有专门优化,得 4.6 与 4.5;surya 覆盖 90 多种语言但中文非强项,得 4.4;MinerU 中文强、外文复杂版面弱,得 4.4;Tesseract 中英均非当代最优,得 3.8。
速度与批量吞吐 20%:OXR 解析 100 页约 101 秒的实测数据与 1.3B 参数量级拿到 4.8;PaddleOCR 与 Unlimited-OCR 各 4.0;surya 与 MinerU 同为 3.8;Tesseract 速度不差但缺少批量流水线能力,得 3.2。
部署与硬件门槛 15%:Tesseract 装机即用、零 GPU 依赖,得 4.8;PaddleOCR 有完整的 CPU 到 GPU 梯度,得 4.3;MinerU 与 surya 得 3.8 与 3.6;OXR 模型虽小但需要评测验证环境,得 3.6;Unlimited-OCR 多页长序列对显存最敏感,得 2.8。
许可证与商用风险 20%:这一项分数越高代表风险越低。PaddleOCR、surya、Tesseract 都是标准 Apache-2.0,Unlimited-OCR 是 MIT,得 5.0;OXR 的许可未被 GitHub 识别为标准 SPDX 且项目最新,得 3.5;MinerU 的社区版历史上采用 AGPL 系列条款、商用需重点评估,得 3.0。
关于评分性质:本文的分数是依据公开文档与项目资料做出的选型评价,不是同机实测。没有在同一份文档上跑过这六个工具,也没有统计过各自的准确率、耗时或失败率,因此这些数字只用于表达同一维度下的相对关系。OXR 与 Unlimited OCR 引用的性能对比均为团队自测口径。
分场景排名与推荐
场景一:中文票据、截图、表单要转成结构化字段
PaddleOCR > surya > Tesseract。这是 PaddleOCR 的主场,输出格式也是后续业务系统最容易对接的。
场景二:整本论文或研报要转 Markdown 进 RAG
MinerU > Unlimited-OCR > OXR。MinerU 的产出就是给模型吃的,中文学术 PDF 的版面理解也更稳。
场景三:公式、多栏、跨行表格要精确还原
OXR > MinerU > PaddleOCR。要的是结构不是文字,LaTeX、HTML 表格、mhchem 这些表达方式能不能直接用,是这一场景的分水岭。
场景四:几百上千页的长文档批量入库
Unlimited-OCR > OXR > MinerU。KV Cache 从 47GB 压到 1.77GB 这件事,价值就体现在这个场景——它决定了长文档是"能跑"还是"跑不动"。
场景五:不能装依赖、只有 CPU
Tesseract > PaddleOCR > MinerU。Tesseract 在这一项不是"能力最弱所以排最后",而是"只有它真的能跑"。
推荐的两种组合
几个容易踩的坑
不要把 OCR 当成 RAG 的前端就完事。很多"模型答不准"的问题出在解析阶段丢了表格结构和阅读顺序。先用同一份文档对比几个工具的结构化输出,再去调提示词。
不要只看中文演示。PaddleOCR 的中文演示最好看,surya 的多语言能力最强,OXR 的结构化最完整。看的是你的资料实际长什么样,不是演示视频。
不要忽略许可证。六个项目里三个是标准 Apache-2.0,一个是 MIT;MinerU 与 OXR 的许可需要单独确认,做对外商业服务前先过法务。
不要在没跑通之前就谈速度。速度数字高度依赖显卡、批量大小与文档类型,各家自测口径也不一致。先拿自己最难看的那 100 页跑一遍。
资料来源
PaddlePaddle/PaddleOCR:https://github.com/PaddlePaddle/PaddleOCR opendatalab/MinerU:https://github.com/opendatalab/MinerU tesseract-ocr/tesseract:https://github.com/tesseract-ocr/tesseract baidu/Unlimited-OCR:https://github.com/baidu/Unlimited-OCR VikParuchuri/surya:https://github.com/VikParuchuri/surya SoMarkAI/OXR:https://github.com/SoMarkAI/OXR
数据采集日期 2026 年 10 月 29 日。图片说明:PaddleOCR、MinerU、surya 的素材取自各项目官方仓库;OXR 与 Unlimited-OCR 的素材取自其官方仓库或官方授权转载报道。流程覆盖图与评分图为依据公开资料整理的示意图,非产品界面。本文评分为文档选型评价,非同机实测,未包含任何实测的准确率、耗时或失败率数据。
你手上最需要AI实战的是哪一项?评论区写「票据」「论文」「合同」「外文」或「混合」,我按票数最高的那类准备下一期的实测样本。