ARTICLE · 1275224
Linux 6.12 源码深度剖析: vfs_write
Linux 6.12 内核深度解析:VFS 核心枢纽 vfs_write 的实现
1. 📌 技术点速览
在 Linux 操作系统中,一切皆文件。无论是普通文件、套接字、管道,还是字符/块设备,用户态发起的写操作最终都会汇聚到内核的虚拟文件系统层(Virtual File System, VFS)。vfs_write 函数正是 VFS 层处理数据写入的核心枢纽。
+-----------------------------------------------------------------+| User Space (用户态) || write() / pwrite() / writev() |+-----------------------------------------------------------------+| (System Call / syscall / svc)v+-----------------------------------------------------------------+| VFS Layer (内核态) || sys_write() -> ksys_write() -> vfs_write() || - 权限与边界校验 (FMODE_WRITE, access_ok, rw_verify_area) || - 写入屏障与冻结保护 (file_start_write) || - 动态分发 (f_op->write / f_op->write_iter) |+-----------------------------------------------------------------+|+-----------------------+-----------------------+| (Regular File) | (Socket) | (Device)v v v+---------------+ +---------------+ +---------------+| Ext4 / XFS | | Network Stack | | TTY / GPU |+---------------+ +---------------+ +---------------+
vfs_write 处于系统调用分发层与底层具体文件系统/设备驱动层之间,属于内核的 VFS (虚拟文件系统层) 模块。它主要解决以下三个核心问题:
统一抽象与多态分发:屏蔽底层介质(磁盘、网络、内存、硬件寄存器)的差异,为用户态提供统一的
write接口,并在内核中通过面向对象的设计(file_operations)将写请求分发给具体的存储介质或驱动。安全边界与合规性防御:在数据真正触达底层文件系统之前,进行严格的权限检查(是否可写)、地址空间合法性校验(防止恶意用户态指针越界访问内核空间)以及文件锁/配额限制。
文件系统一致性保护(Freeze Protection):通过超级块(Superblock)写入锁机制,防止在文件系统执行快照或冻结(Freeze)时发生数据写入,确保文件系统元数据与数据的一致性。
2. 🗺️ 软件功能架构图
以下架构图展示了从用户态发起 write 系统调用,通过 vfs_write 进行安全校验与冻结保护,最终跨模块分发到具体文件系统(如 Ext4)及页缓存(Page Cache)的完整流程。
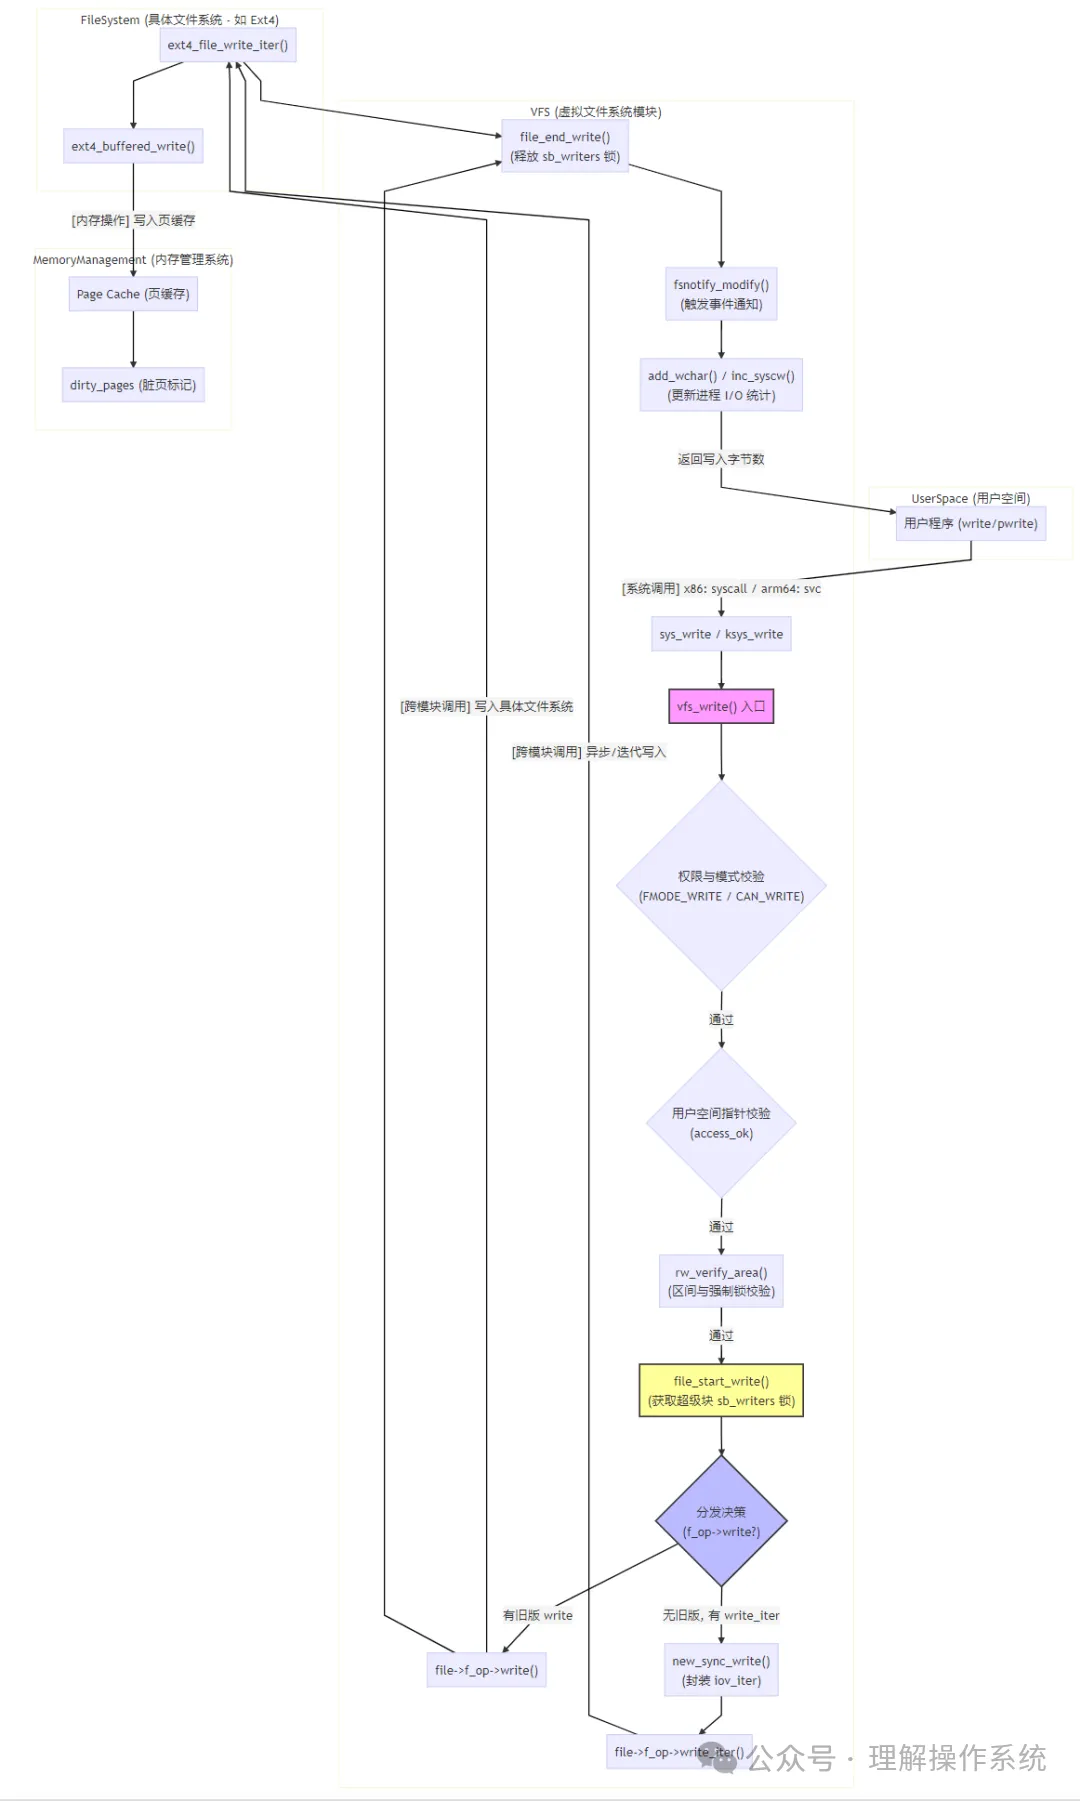
3. 🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 内核中,vfs_write 的核心实现位于 fs/read_write.c。下面我们对该函数进行逐行剖析。
/** 源码路径: fs/read_write.c* 核心职责: VFS 层的写操作总入口,负责安全校验、冻结保护、多态分发及 I/O 统计。*/ssize_t vfs_write(structfile *file, constchar __user *buf, size_t count, loff_t *pos){ssize_t ret;/** 1. 基础权限校验:* 检查文件描述符在打开时是否申请了写权限 (FMODE_WRITE)。* 如果文件是以只读方式 (O_RDONLY) 打开的,直接拒绝,返回 -EBADF (Bad file descriptor)。*/if (!(file->f_mode & FMODE_WRITE))return -EBADF;/** 2. 写入可行性校验:* 检查该文件类型是否支持写入 (例如,某些特殊的伪文件系统或只读挂载点会清除 FMODE_CAN_WRITE)。* 若不支持,返回 -EINVAL (Invalid argument)。*/if (!(file->f_mode & FMODE_CAN_WRITE))return -EINVAL;/** 3. 内存安全防御 (关键防御点):* access_ok 是一个与架构紧密相关的宏 (x86/arm64 均有各自的高效实现)。* 它用于确保用户态传入的指针 `buf` 及其长度 `count` 完全处于用户空间地址范围内。* 防止恶意用户传入内核空间地址(如 0xffff888000000000),利用内核权限向内核内存写入数据(Meltdown/漏洞防御)。* 若校验失败,返回 -EFAULT (Bad address)。*/if (unlikely(!access_ok(buf, count)))return -EFAULT;/** 4. 区间与锁校验:* rw_verify_area 会检查:* - 写入区间是否超出系统限制 (如超过 rlimit 中的 RLIMIT_FSIZE)。* - 是否触发了强制锁 (Mandatory Locking) 冲突。* - 检查 pos 指针是否溢出。*/ret = rw_verify_area(WRITE, file, pos, count);if (ret)return ret;/** 5. 单次写入上限截断:* MAX_RW_COUNT 定义为 INT_MAX & PAGE_MASK。* 限制单次系统调用写入的最大字节数,防止单次大 I/O 导致内核态长时间不释放 CPU,保障调度公平性。*/if (count > MAX_RW_COUNT)count = MAX_RW_COUNT;/** 6. 文件系统冻结保护 (Freeze Protection):* file_start_write 会获取当前文件系统超级块 (superblock) 的写入锁 (sb_writers)。* 如果此时系统管理员正在对该文件系统执行冻结操作 (如 fsfreeze,用于做 LVM 快照),* 当前写线程会在此处阻塞,直到文件系统被解冻 (Thaw)。* 这体现了 VFS 模块与 Superblock 模块之间的紧密协同。*/file_start_write(file);/** 7. 多态分发核心逻辑:* Linux 内核采用 C 语言实现了面向对象的多态。* - 优先使用旧版直驱接口 `file->f_op->write` (如某些简单字符设备驱动)。* - 若无 `write`,则检查是否实现了现代的异步/迭代接口 `file->f_op->write_iter` (主流文件系统如 Ext4, XFS 均采用此接口)。* 通过 `new_sync_write` 将同步写请求包装为 `kiocb` 和 `iov_iter`,然后调用 `write_iter`。* - 若两者皆无,说明该文件不支持写,返回 -EINVAL。*/if (file->f_op->write)ret = file->f_op->write(file, buf, count, pos);else if (file->f_op->write_iter)ret = new_sync_write(file, buf, count, pos);elseret = -EINVAL;/** 8. 写入成功后的后续处理:* - fsnotify_modify: 触发 inotify/fanify 事件,通知用户态监听该文件的 watcher (如 tail -f 或 systemd)。* - add_wchar: 将成功写入的字节数累加到当前进程的 `task_struct->ioac.write_bytes` 中,用于 /proc/PID/io 统计。*/if (ret > 0) {fsnotify_modify(file);add_wchar(current, ret);}/** 9. 系统调用计数与释放锁:* - inc_syscw: 增加当前进程的写系统调用次数计数器 (syscw)。* - file_end_write: 释放超级块的写入锁,允许其他冻结操作进行。*/inc_syscw(current);file_end_write(file);return ret;}
深入解析:new_sync_write 的桥梁作用
现代 Linux 内核(包括 6.12)为了统一同步与异步 I/O(AIO/io_uring),推荐文件系统只实现 .write_iter。当用户调用同步 write 时,VFS 必须通过 new_sync_write 进行适配转换:
/* 源码路径: fs/read_write.c (原理简化版) */staticssize_tnew_sync_write(struct file *filp, constchar __user *buf, size_t len, loff_t *ppos){struct iovec iov = { .iov_base = (void __user *)buf, .iov_len = len };struct kiocb kiocb;struct iov_iter iter;ssize_t ret;/* 1. 初始化内核 I/O 控制块 (kiocb),绑定文件指针与当前偏移量 */init_sync_kiocb(&kiocb, filp);kiocb.ki_pos = (ppos ? *ppos : 0);/* 2. 初始化迭代器 (iov_iter),将用户态单块内存 buf 包装为迭代器格式 */iov_iter_ubuf(&iter, ITER_SOURCE, (void __user *)buf, len);/* 3. 调用具体文件系统的 write_iter 接口 */ret = call_write_iter(filp, &kiocb, &iter);BUG_ON(ret == -EIOCBQUEUED); // 同步写不允许返回异步队列状态/* 4. 更新文件偏移量 */if (ret > 0 && ppos)*ppos = kiocb.ki_pos;return ret;}
4. ⚙️ 系统运行背景与上下文
vfs_write 它是 Linux 内核中多模块协同作战的典型代表。以下是它与架构、内存、调度及通知系统的跨模块交互细节:
4.1 架构层协同:x86 与 arm64 的 access_ok 差异
在 vfs_write 的入口处,access_ok(buf, count) 是保障内核安全的第一道防线。
x86_64 架构: x86_64 采用虚拟地址空间划分(用户态:
0x0000000000000000至0x00007fffffffffff)。access_ok在 x86 下的本质是检查(unsigned long)addr + size <= TASK_SIZE_MAX。如果越界,说明指针指向了内核空间(高位为 1 的地址),直接拦截。arm64 架构: arm64 拥有两个独立的虚拟地址空间页表基址寄存器(
TTBR0_EL1控制用户空间,TTBR1_EL1控制内核空间)。在 arm64 上,access_ok同样通过检查地址是否超出TASK_SIZE来实现。此外,arm64 硬件支持 PAN (Privileged Access Prevention,特权访问禁止) 技术。当内核态试图直接访问用户态数据时,如果未显式开启访问权限,硬件会触发 Page Fault。vfs_write下游的copy_from_user会在执行前通过uaccess_enable_not_uao()临时允许内核访问用户空间,拷贝完成后立即关闭,防止内核漏洞被利用。
4.2 内存管理模块 (MM) 协同:Page Cache 与脏页标记
当 vfs_write 调用到具体文件系统(如 Ext4)的 write_iter 时,通常会进入缓存 I/O (Buffered I/O) 流程:
页分配:Ext4 跨模块调用内存管理系统的
grab_cache_page_write_begin,在 Page Cache 中查找或分配对应的物理页(Page Frame)。数据拷贝:调用
copy_page_from_iter_atomic,将用户态buf中的数据拷贝到内核 Page Cache 页中。脏页标记:数据拷贝完成后,调用
__set_page_dirty_nobuffers将该页标记为“脏页 (Dirty Page)”。此时数据仅存在于内存中,并未落盘。异步刷盘:内存管理系统的后台线程(
writeback机制)会定期或在内存紧张时,将这些脏页通过块设备驱动写入物理磁盘。
4.3 锁与一致性协同:sb_writers 机制
file_start_write(file) 内部调用了 __sb_start_write(file_inode(file)->i_sb, SB_FREEZE_WRITE)。
这是 VFS 与超级块管理模块的协同。
Linux 支持三级冻结:
SB_FREEZE_WRITE(禁止普通写)、SB_FREEZE_PAGEFAULT(禁止页缺页写)、SB_FREEZE_FS(禁止文件系统元数据修改)。sb_writers采用的是 Per-CPU 读写信号量 (percpu-rwsem)。在正常高并发写入时,各个 CPU 仅累加本地的 Read 计数器,无锁竞争,性能极高。当执行fsfreeze时,冻结线程会获取 Write 锁,此时会合并所有 CPU 的计数器并阻塞后续的vfs_write。
5. 💡 10年老兵避坑指南/实战案例
在超大规模生产环境中,围绕 vfs_write 及其跨模块协同,常常会遇到各种诡异的性能瓶颈与死锁问题。以下整理了两个经典实战案例及排查方案。
5.1 案例一:文件系统冻结导致的“神秘”进程 D 状态死锁
生产背景
某云原生数据库节点在执行每日备份时,会调用 fsfreeze -f /data 对挂载点进行冻结以创建一致性 LVM 快照。然而,在冻结期间,数据库主进程突然出现大量 D 状态(Uninterruptible Sleep)线程,导致业务完全停摆。即使解冻(fsfreeze -u)也无法恢复。
根因剖析
通过 cat /proc/PID/stack 查看 D 状态线程的内核调用栈:
[<0>] percpu_down_read+0x51/0x90[<0>] __sb_start_write+0x2e/0x70[<0>] vfs_write+0xa5/0x1c0[<0>] ksys_write+0x5f/0xe0[<0>] do_syscall_64+0x5b/0x110[<0>] entry_SYSCALL_64_after_hwframe+0x6c/0x76
可以看出,线程阻塞在 vfs_write 内部的 file_start_write(即 __sb_start_write)。 为什么解冻无法唤醒它们? 因为该数据库在写入时,持有了一个自定义的全局事务锁(Transaction Lock),然后调用了 write。而另一个线程在等待该事务锁。当 write 因为 fsfreeze 阻塞在 sb_writers 读锁上时,它并没有释放数据库的事务锁。这导致了跨模块死锁:
数据库事务锁被写线程 A 持有。
写线程 A 在 VFS 层等待
fsfreeze释放写锁。备份脚本(试图执行解冻或后续操作)因为需要获取数据库事务状态而被阻塞。
避坑与调优
应用层规避:在调用
write等可能阻塞在 VFS 层的系统调用前,绝对不要持有应用层的高开销全局锁。超时机制:对于关键业务,避免使用可能永久阻塞的同步
write,改用io_uring或非阻塞 I/O,并对fsfreeze的持有时间进行严格监控。
5.2 案例二:高并发下 sb_writers 导致的 CPU 暴涨与 Cache Line 抖动
生产背景
在一台 128 核的 arm64 服务器上运行超高并发的 KV 存储服务,小数据块(4KB)同步写入非常频繁。在业务高峰期,系统 CPU 利用率飙升,但 I/O 吞吐量(IOPS)却上不去。通过 perf top 观察发现,大量 CPU 时间消耗在 __sb_start_write 和 percpu_down_read 中。
根因剖析
虽然 sb_writers 使用了 percpu-rwsem 以优化读锁性能,但在 128 核的高并发环境下,频繁调用 file_start_write 和 file_end_write 依然会带来不可忽视的开销:
Per-CPU 内存屏障开销:在 arm64 架构下,
percpu_down_read内部为了保证内存一致性,会执行smp_mb()(强内存屏障指令)。在高核数下,频繁的内存屏障会导致 CPU 流水线停顿(Pipeline Stall)。频繁的系统调用:每次 4KB 的写入都伴随着一次
vfs_write的完整生命周期,包括两次sb_writers的状态修改。
解决方案与排查工具
1、合并 I/O (Batching):在应用层引入 Buffer,将多次小写入合并为一次大写入(如 64KB),或者改用 writev(向量化写入),大幅减少进入 vfs_write 的次数。
2、使用 io_uring:io_uring 支持内核线程(SQPOLL)代理写入,能够极大地减少系统调用上下文切换及相关的锁开销。
3、ftrace 追踪脚本: 使用 trace-cmd 或 bpftrace 监控 vfs_write 的耗时分布,找出是否存在异常延迟:
# 使用 bpftrace 统计 vfs_write 的耗时直方图 (单位: 微秒)bpftrace -e 'kprobe:vfs_write {@start[tid] = nsecs;}kretprobe:vfs_write /@start[tid]/ {@latency_us = hist((nsecs - @start[tid]) / 1000);delete(@start[tid]);}'