ARTICLE · 1292691
Linux 6.12 源码深度剖析: wp_page_copy
Linux 6.12 内核深度解析:写时复制(COW)核心函数 wp_page_copy
📌 技术点速览
在 Linux 内核中,写时复制(Copy-on-Write, COW)是实现进程高效隔离与内存节约的核心机制。当父进程通过 fork() 创建子进程时,双方共享相同的物理内存页,且这些页在页表(PTE)中被标记为“只读”。一旦任意进程尝试写入这些共享页,CPU 就会触发写保护缺页异常(Write-Protect Page Fault)。
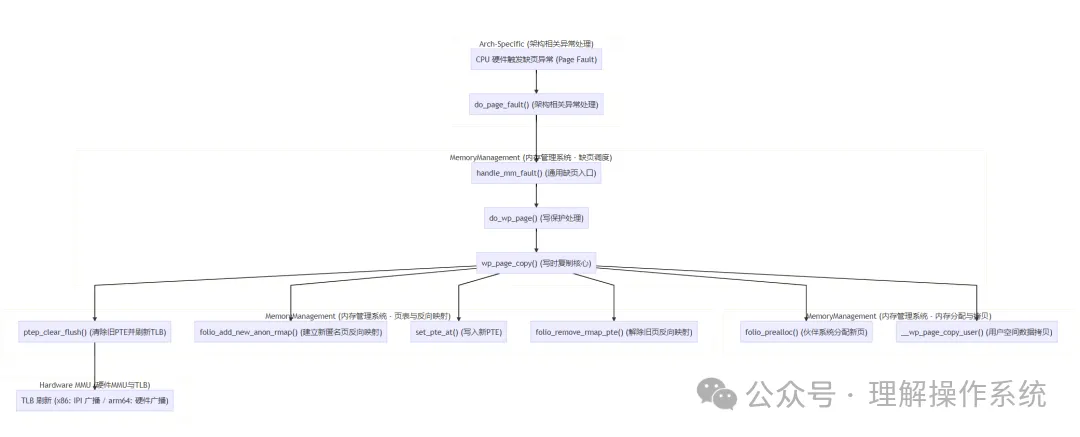
wp_page_copy 函数正是用于解决写保护缺页异常的核心实现。它位于虚拟内存管理的核心路径上,负责分配新的物理页、拷贝旧页数据、更新页表、处理反向映射(rmap)并刷新 TLB。该函数隶属于 MemoryManagement (内存管理系统) 模块,是连接虚拟内存管理、物理内存分配器以及底层硬件 MMU 的关键纽带。
🗺️ 软件功能架构图
以下是 wp_page_copy 在 Linux 内核中的调用上下文及跨模块协同架构图。图中清晰展示了从硬件异常触发,到内存管理系统内部各子模块协同,再到硬件 MMU 刷新的完整生命周期。
🔍 核心源码硬核解析 (基于 Linux 6.12)
在 Linux 6.12 中,wp_page_copy 的实现位于 mm/memory.c。以下是该函数的完整核心源码,伴有极其详尽的逐行中文注释与架构级原理解释。
staticvm_fault_twp_page_copy(struct vm_fault *vmf){/* 1. 解析缺页上下文 */const bool unshare = vmf->flags & FAULT_FLAG_UNSHARE; // 是否仅执行解除共享(如 mprotect 或 io_uring 触发)struct vm_area_struct *vma = vmf->vma; // 获取当前虚拟内存区域 (VMA)struct mm_struct *mm = vma->vm_mm; // 获取当前进程的内存描述符struct folio *old_folio = NULL; // 指向写保护的旧物理页 (以 folio 组织)struct folio *new_folio = NULL; // 指向即将分配的新物理页pte_t entry; // 新的页表项 (PTE)int page_copied = 0; // 标记是否成功完成了物理页拷贝struct mmu_notifier_range range; // 用于通知外部 MMU (如 KVM, IOMMU) 的范围结构体vm_fault_t ret;bool pfn_is_zero; // 标记旧页是否为系统全局零页 (Zero Page)delayacct_wpcopy_start(); // 开启写时复制延迟统计 (用于 taskstats)if (vmf->page)old_folio = page_folio(vmf->page); // 获取旧页对应的 folio 结构/* 2. 准备匿名映射上下文 */ret = vmf_anon_prepare(vmf); // 确保 VMA 已经关联了 anon_vma 结构,用于反向映射if (unlikely(ret))goto out;/* 3. 优化判断:如果旧页是全局零页,则无需实际拷贝,直接分配一个全零的新页即可 */pfn_is_zero = is_zero_pfn(pte_pfn(vmf->orig_pte));/** 4. 关键设计:在未持有页表锁 (PTL) 的情况下预分配新页。* 内存分配(可能触发内存回收、压缩甚至 OOM)是高延迟操作。* 绝不能在持有页表锁的情况下调用,否则会严重阻塞其他线程的页表访问。*/new_folio = folio_prealloc(mm, vma, vmf->address, pfn_is_zero);if (!new_folio)goto oom;/* 5. 执行数据拷贝 */if (!pfn_is_zero) {int err;/* 将旧页的数据拷贝到新分配的物理页中 */err = __wp_page_copy_user(&new_folio->page, vmf->page, vmf);if (err) {/** 如果拷贝失败(例如遭遇硬件 MCE 内存损坏 -EHWPOISON),* 则释放新页,并根据错误类型决定是否向用户空间发送信号。*/folio_put(new_folio);if (old_folio)folio_put(old_folio);delayacct_wpcopy_end();return err == -EHWPOISON ? VM_FAULT_HWPOISON : 0;}kmsan_copy_page_meta(&new_folio->page, vmf->page); // KMSAN (KernelMemorySanitizer) 元数据拷贝}__folio_mark_uptodate(new_folio); // 标记新页数据已是最新的 (Uptodate)/* 6. 初始化 MMU 通知器,准备使外部页表失效(如 GPU 或 KVM 虚拟机页表) */mmu_notifier_range_init(&range, MMU_NOTIFY_CLEAR, 0, mm,vmf->address & PAGE_MASK,(vmf->address & PAGE_MASK) + PAGE_SIZE);mmu_notifier_invalidate_range_start(&range);/** 7. 核心同步点:重新获取页表锁 (PTL) 并执行“双重检查锁 (Double-Checked Locking)”* 因为在 `folio_prealloc` 和 `__wp_page_copy_user` 期间,我们没有持有页表锁,* 另一个内核线程可能已经并发处理了该缺页异常并修改了此 PTE。*/vmf->pte = pte_offset_map_lock(mm, vmf->pmd, vmf->address, &vmf->ptl);/* 验证当前的 PTE 是否与触发异常时的 orig_pte 完全一致 */if (likely(vmf->pte && pte_same(ptep_get(vmf->pte), vmf->orig_pte))) {if (old_folio) {/* 如果旧页不是匿名页(例如是只读的文件页映射),需要调整内存计数器 */if (!folio_test_anon(old_folio)) {dec_mm_counter(mm, mm_counter_file(old_folio));inc_mm_counter(mm, MM_ANONPAGES);}} else {/* 如果是零页,可能需要解除 KSM (Kernel Shared Memory) 零页映射 */ksm_might_unmap_zero_page(mm, vmf->orig_pte);inc_mm_counter(mm, MM_ANONPAGES);}/* 刷新架构相关的 CPU Cache (主要针对 VIVT 架构,现代 x86/arm64 多为 PIPT,此函数多为空) */flush_cache_page(vma, vmf->address, pte_pfn(vmf->orig_pte));/* 8. 构造新的 PTE 属性 */entry = mk_pte(&new_folio->page, vma->vm_page_prot); // 根据 VMA 属性创建基础 PTEentry = pte_sw_mkyoung(entry); // 标记该页已被访问 (Young)if (unlikely(unshare)) {/* 如果仅仅是解除共享,保留原有的脏页和 uffd 标记,但不赋予写权限 */if (pte_soft_dirty(vmf->orig_pte))entry = pte_mksoft_dirty(entry);if (pte_uffd_wp(vmf->orig_pte))entry = pte_mkuffd_wp(entry);} else {/* 正常 COW 路径:赋予写权限 (Writable) 并标记为脏页 (Dirty) */entry = maybe_mkwrite(pte_mkdirty(entry), vma);}/** 9. 极其关键的安全设计:先清除并刷新旧的 PTE,再写入新的 PTE。* 必须使用 `ptep_clear_flush` 强行同步所有 CPU 的 TLB。* 如果先写新 PTE 再刷 TLB,会产生一个短暂的窗口期:* 此时 CPU A 已经加载了新 PTE(可写),而 CPU B 仍在使用旧 TLB(只读但指向旧物理页)。* 如果此时旧物理页的引用计数被释放并被其他进程复用,CPU B 就会非法读取/写入其他进程的数据!*/ptep_clear_flush(vma, vmf->address, vmf->pte);/* 10. 建立新页的反向映射 (RMAP) *//* 标记该新页为当前进程独占 (RMAP_EXCLUSIVE),并加入匿名页反向映射系统 */folio_add_new_anon_rmap(new_folio, vma, vmf->address, RMAP_EXCLUSIVE);folio_add_lru_vma(new_folio, vma); // 将新页挂入 LRU 链表,使其受内存回收机制管理BUG_ON(unshare && pte_write(entry));/* 11. 将新 PTE 写入硬件页表 */set_pte_at(mm, vmf->address, vmf->pte, entry);/* 更新架构相关的 MMU Cache (例如在 arm64 上可能用于预装载 TLB) */update_mmu_cache_range(vmf, vma, vmf->address, vmf->pte, 1);if (old_folio) {/** 12. 解除旧页的反向映射。* 必须在页表完全切换(set_pte_at)且 TLB 刷新(ptep_clear_flush)之后,* 才能安全地减少旧页的 mapcount。* 否则,其他 CPU 可能在 mapcount 归零、旧页被释放复用后,依然通过旧 TLB 写入该页。*/folio_remove_rmap_pte(old_folio, vmf->page, vma);}/* 成功替换,将 new_folio 指向 old_folio,以便在函数末尾统一释放旧页的引用计数 */new_folio = old_folio;page_copied = 1;pte_unmap_unlock(vmf->pte, vmf->ptl); // 释放页表锁} else if (vmf->pte) {/* 双重检查失败:说明其他线程已经抢先完成了缺页处理 */update_mmu_tlb(vma, vmf->address, vmf->pte);pte_unmap_unlock(vmf->pte, vmf->ptl);}/* 13. 结束 MMU 通知器区间 */mmu_notifier_invalidate_range_end(&range);/* 14. 统一的资源清理 */if (new_folio)folio_put(new_folio); // 如果发生了并发竞争导致放弃,或者成功替换,此处释放对应的 folio 引用if (old_folio) {if (page_copied)free_swap_cache(old_folio); // 如果成功拷贝,尝试从 swap cache 中释放旧页folio_put(old_folio); // 递减旧页的引用计数}delayacct_wpcopy_end();return 0;oom:ret = VM_FAULT_OOM;out:if (old_folio)folio_put(old_folio);delayacct_wpcopy_end();return ret;}
🛠️ 核心职责体现
wp_page_copy 的代码设计完美体现了 MemoryManagement (内存管理系统) 的三大核心职责:
并发安全与锁优化:采用“无锁预分配 + 双重检查锁(Double-Checked Locking)”机制。在不持有页表锁(PTL)的情况下进行高延迟的物理页分配(
folio_prealloc)和数据拷贝(__wp_page_copy_user),最大化减少了 PTL 的持锁时间,避免了多线程并发缺页时的锁崩溃。严格的内存一致性(TLB 顺序):通过“先清除旧 PTE 并刷新 TLB(
ptep_clear_flush),再写入新 PTE(set_pte_at),最后递减旧页反向映射计数(folio_remove_rmap_pte)”的严密顺序,彻底杜绝了多核架构下的时序竞争(Race Condition)和潜在的内存越界/脏数据泄露漏洞。生命周期与反向映射管理:通过
folio_add_new_anon_rmap和folio_remove_rmap_pte维护了精确的物理-虚拟映射关系,确保了内存回收系统(Reclaim)在面临内存压力时,能够准确找到并回收这些匿名页。
⚙️ 系统运行背景与上下文
wp_page_copy 绝非孤立运行,它处于 Linux 内核多个核心子系统交汇的十字路口。
1. 中断/异常子系统与硬件 MMU 的协同
当用户态进程尝试写入一个被标记为“只读”的页时:
硬件层面:CPU 的 MMU 发现页表项中的
Writable位为 0,立即触发 Page Fault 异常(x86 下为#PF异常,arm64 下为Data Abort异常,异常状态码 FSC 指示为 Permission Fault)。架构相关处理:CPU 自动跳转到内核的异常向量表。在 arm64 上,执行
el1_da或el0_da,最终调用do_page_fault();在 x86 上,调用exc_page_fault()。通用内存管理:异常处理程序读取控制寄存器(x86 的
CR2,arm64 的FAR_EL1)获取缺页的虚拟地址,并封装为vm_fault结构体,向下传递给handle_mm_fault()->do_wp_page(),最终进入wp_page_copy()。
2. 进程调度器(Scheduler)的跨模块交互
在 wp_page_copy 执行过程中,可能会与调度器发生深度交互:
主动让出 CPU:
folio_prealloc()内部调用伙伴系统分配器。如果系统物理内存极度紧张,分配器会进入“直接内存回收(Direct Reclaim)”或“内存压缩(Memory Compaction)”路径。这些路径涉及磁盘 I/O(Swap Out)或等待页面锁,会调用schedule()将当前进程挂起,让出 CPU。延迟统计(Delay Accounting):代码前后的
delayacct_wpcopy_start()和delayacct_wpcopy_end()会向调度器的任务统计模块(Taskstats)汇报当前进程在写时复制上消耗的时间,作为系统性能调优(如iotop、vmstat)的数据源。
3. 架构相关 MMU 抽象层的差异化实现
wp_page_copy 内部的页表操作和 TLB 刷新在不同硬件架构上有着截然不同的底层行为:
ptep_clear_flush | invlpg 指令刷新本地 TLB。 4. 高延迟,存在 IPI 暴风雨风险。 | tlbi (TLB Invalidate) 硬件广播指令(如 tlbi vae1is)。 3. 硬件总线自动同步所有核心的 TLB,无需软件 IPI 中断。 4. 低延迟,硬件级高并发。 |
set_pte_at | barrier())写入内存,x86 的强内存模型(TSO)保证了写入顺序。 | dsb ishst(数据同步屏障)指令,确保页表写入在 MMU 硬件下一次翻译前对全局可见。 |
💡 10年老兵避坑指南/实战案例
在超大规模高并发的生产环境中,写时复制(COW)机制常常成为系统性能瓶颈的幕后黑手。以下结合一个真实的生产案例,剖析因不理解 wp_page_copy 机制导致的系统崩溃及调优方案。
🚨 生产案例:Redis 宿主机 CPU 突发暴涨与业务超时
1. 背景与现象
某核心 Redis 缓存集群,在每天下午进行 RDB 自动快照(bgsave)时,宿主机 CPU 使用率会瞬间飙升至 90% 以上,伴随 Redis 响应延迟(P99)从 1ms 暴涨至 500ms 以上,导致下游大量微服务出现连接超时。
2. 根因剖析
fork()触发全量只读映射:Redis 执行bgsave时,会fork()一个子进程。fork瞬间,父子进程的所有虚拟内存页(可能高达数十 GB)在页表中全部被标记为只读。高频写操作触发 COW 暴风雨:Redis 作为缓存,承载着极高并发的写请求。每当有写请求到达,CPU 就会触发写保护缺页异常,疯狂调用
wp_page_copy。TLB 刷新的 IPI 锁死多核(x86 架构特有): 在 x86 架构下,
wp_page_copy内部的ptep_clear_flush会向所有运行该 Redis 进程的 CPU 核心发送 IPI 中断以刷新 TLB。 在高并发写、大内存页表的场景下,成千上万个wp_page_copy并发执行,导致系统充斥着 IPI 广播暴风雨。CPU 核心几乎所有的时间都浪费在响应 IPI 中断和等待页表锁(PTL)上,导致系统陷入假死状态。
3. 诊断排查方法
Step 1: 使用 perf 抓取内核热点
在问题发生时,执行以下命令抓取 CPU 热点:
perf record -g -p <redis_pid> -- sleep 10perf report -g --hierarchical
异常热点输出示例:
- 85.40% [kernel]- 62.10% do_page_fault- 58.30% handle_mm_fault- 55.10% do_wp_page- 52.40% wp_page_copy+ 38.20% ptep_clear_flush+ 10.10% __wp_page_copy_user
可以看到,超过 50% 的 CPU 时间被消耗在 wp_page_copy 及其内部的 ptep_clear_flush(TLB 刷新)上。
Step 2: 监控系统中断变化
通过监控 /proc/interrupts 中的 CAL(Function call interrupts,在 x86 上常用于 TLB 刷新的 IPI 广播)增长速率:
watch -d "cat /proc/interrupts | grep CAL"在 Redis bgsave 期间,CAL 中断的每秒增长量达到了数十万次,证实了 IPI 暴风雨的存在。
4. 终极调优与避坑解决方案
方案 A:禁用透明大页(Transparent Huge Pages, THP)
虽然大页可以减少页表项数量,但在 COW 场景下,THP 是灾难性的。 如果启用了 THP,当写入一个 2MB 的大页中的任意一个字节时,wp_page_copy 必须分配并拷贝一整个 2MB 的物理页,而不是普通的 4KB 页。这会导致拷贝延迟(__wp_page_copy_user)暴增 512 倍,并极易引发严重的内存碎片和 OOM。
修复命令:
echo never > /sys/kernel/mm/transparent_hugepage/enabledecho never > /sys/kernel/mm/transparent_hugepage/defrag
方案 B:利用 MADV_DONTFORK 优化非必要内存
对于 Redis 内部的一些非关键大内存缓冲区(如客户端输入输出缓冲区、复制积压缓冲区 repl-backlog-size),这些数据不需要被写入 RDB 快照。 可以通过修改 Redis 源码或使用动态链接库拦截 malloc,对这些区域调用 madvise:
madvise(addr, length, MADV_DONTFORK); 被标记为 MADV_DONTFORK 的虚拟内存区域在 fork() 时不会被子进程继承,从而彻底免除了这部分内存的写时复制开销。
方案 C:调整内核参数减少页表锁竞争
在多线程应用中,可以通过启用页表锁拆分(Split Page Table Locks)来缓解 PTL 锁竞争。确保内核编译选项开启了 CONFIG_SPLIT_PTE_PTL(Linux 6.12 默认对 4KB 页开启)。对于 PMD 级别的大页锁,确保 CONFIG_ARCH_ENABLE_SPLIT_PMD_PTL 处于开启状态。