ARTICLE · 1293405
小米 0.8B OCR:先把文档读准,理解训练也能反哺解析
导读在 Xiaomi-OCR-0 的实验中,理解数据对解析的作用,随着解析基础加强,由负向转为正向。小米基于 Qwen3.5-0.8B-Base,训练出兼顾文档解析、字段抽取与视觉问答的模型。关键在于这些任务怎样一起学、何时互相帮助。三阶段训练与阶段消融,解释了这一点,也说明了小模型成绩的适用范围。
本文 2482 字,阅读约 6 分钟
解析与理解,是同一个模型的两种任务
2026 年 9 月 30 日,小米发布了 Xiaomi-OCR-0 的模型权重。它基于 Qwen3.5-0.8B-Base,保留约 8 亿参数的视觉语言模型体量,继续训练文档解析、字段抽取与视觉问答能力。
这些任务有什么区别?设想一页财务表,里面有部门、季度和金额。让模型把整页转成可编辑文档,它需要认出每个数字,保留行列关系,并按正确顺序输出。让它回答“第二季度哪个部门支出最高”,它就要找到相关列,把数值与部门对应起来,再完成比较。
前者是文档解析,目标是尽可能忠实、完整地重建内容与结构。后者属于围绕文档的理解任务,目标是根据问题选择信息并给出答案。指定几个字段,让模型输出 JSON 这样的结构化记录,也属于按任务提取信息。
两种任务都会用到视觉编码器提取的图像特征,以及语言模型根据指令生成输出的能力。不能把解析对应到视觉编码器、把理解对应到语言模型。区别在于输出目标:解析要保留完整内容与结构,问答则集中处理当前问题所需的信息。
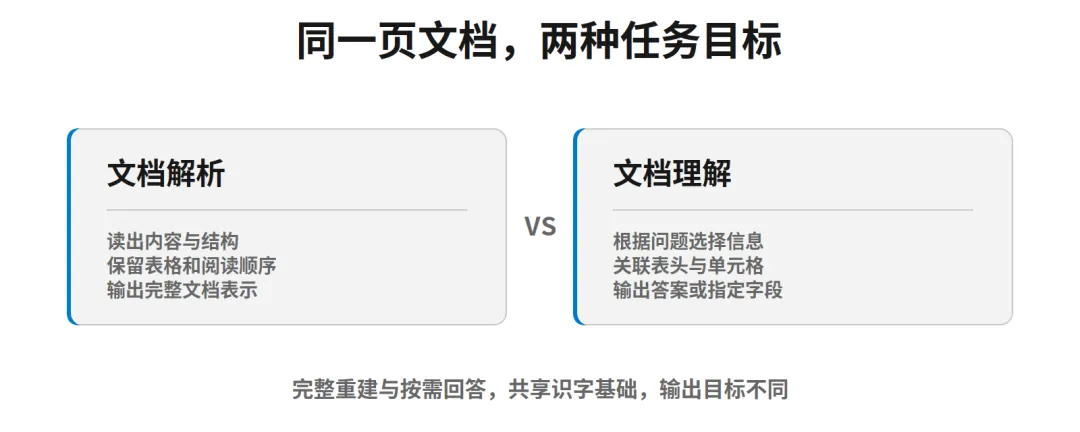
Xiaomi-OCR-0 使用同一个模型,通过不同指令完成这些任务。它的训练语料约有 1.7 亿条样本,其中既有裁出的文字、表格和公式区域,也有整页文档;样本量不等于文档页数。
理解监督,就是用问题与答案、指定字段与对应结果,教模型利用文档信息。小米的阶段实验发现:在较弱的解析基础上加入理解数据,解析得分下降;解析基础较强时,加入理解数据则带来提升。这让训练顺序成为值得细看的问题。
三阶段训练,各自补上什么
第一阶段使用 Q-Mask 做文字与位置的对齐。只要求输出正确文字,还没有直接告诉模型,这些文字对应图像的哪一块。Q-Mask 在训练时增加一个预测空间掩码的辅助解码器:除了学习输出答案,还要标出答案对应的图像区域。这样,文字内容与位置就有了联合监督。
第二阶段是持续预训练(Continued Pre-Training,CPT),即在已有模型基础上,继续用文档领域数据训练。额外的掩码解码器会被移除,保留训练过的视觉语言骨干。模型根据图像、任务指令和已有输出,学习预测下一个 Token,也就是文本片段,逐步生成文字、表格、公式或问答结果。
这里有一处容易忽略的差别:裁出一块表格来识别,能练局部结构;用整页文档及其完整解析结果训练,能直接监督跨区域组织内容、恢复阅读顺序。论文同时使用区域和整页监督,后面的消融也专门比较了整页数据的作用。
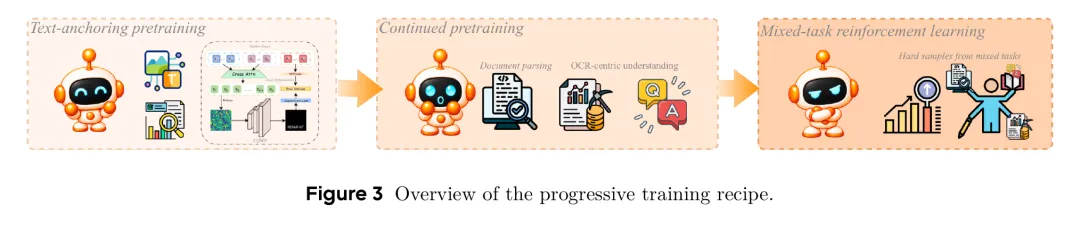 从文字与位置对齐,到多任务持续预训练,再到混合任务强化学习 | 来源:Xiaomi-OCR-0 技术报告,图 3
第三阶段是混合任务强化学习 Mix-RL,重点处理挖掘出的困难样本。持续预训练主要让模型模仿目标输出;强化学习则根据生成结果的得分,调整模型产生这些输出的概率。这里按任务分别打分:文字看编辑相似度,表格看结构及单元格内容的匹配,公式看识别匹配,问答看答案是否接近标准答案。字段抽取还要检查格式和字段值。
这样做的必要性很具体:表格中的字符即使大多正确,一处合并单元格错位,也可能破坏整张表的含义。不同任务需要不同的判分依据。
作者还分别比较了保留或移除关键训练环节的结果,这就是组件消融。评测使用 OmniDocBench v1.6,综合检查文字、公式、表格与阅读顺序。论文表 11 中,Q-Mask 带来约 0.30 分的综合提升;另一训练阶段的 Mix-RL 带来约 0.35 分的提升。两组起点不同,不能相加,但分别支持了空间监督与后续任务奖励的作用。
这些训练还依赖可靠的目标答案。小米的数据引擎会让多个不同的 OCR 专家模型交叉比较标注;遇到分歧,再将候选表格或公式渲染回图像,用更大的模型对照原图修正,重新检查共识。单个模型反复回答一致,仍可能一直答错,因此一致性只能提供筛选线索。这些校验发生在训练数据准备过程中,不能据此把最终的 0.8B 模型当成可靠的自查器。
同样的理解数据,为什么会从减分变成加分
训练环节本身有效,还不能回答:理解数据何时有益?论文表 10 为此设置了早、中、晚三组消融,每组改变监督数据、保持其余设置不变,再评估解析表现。
这里的早、中、晚,是解析训练基础不同的实验设置,不对应前面的 Q-Mask、CPT、Mix-RL 三个环节。
早期:加入理解数据,解析退步。使用全部解析数据的 9%,且只有区域级监督时,加入文档理解数据,综合分从 93.594 降到 93.264,下降 0.330 分,各项分指标也变差。
中期:先补整页,再加理解。使用 29% 的解析数据时,增加整页监督,综合分先从 94.730 提高到 94.941。整页与区域样本大约为 1∶5;随后加入与早期实验相同的理解数据池,综合分进一步升到 95.580,增加 0.639 分,表格内容与结构匹配指标 TEDS 提高了 1.024 分。
理解监督的作用因此不只体现为“问答做得更好”,也体现在解析任务本身。
后期:正向作用仍在,收益变小。使用 50% 的解析数据、保持中期的整页与区域比例时,加入理解数据,综合分从 95.8924 升到 95.9673,约增加 0.075 分。公式、表格和阅读顺序改善,但衡量文字识别误差的编辑距离略有变差,说明综合分提升并不代表每一项都改善。
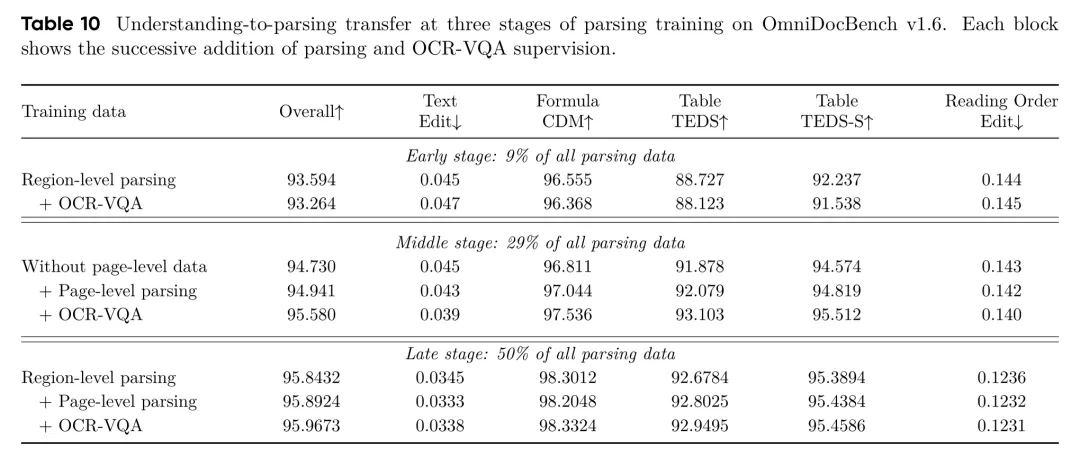 每个阶段分别比较加入理解监督前后的结果;重点看 Overall 列,各组基线不同 | 来源:Xiaomi-OCR-0 技术报告,第 16 页表 10
这组证据支持的是:随着解析基础建立,理解监督对解析的作用可以由负转正。它还没有证明一个适用于所有 OCR 模型的固定切换点。9%、29%、50% 是这组实验使用的解析数据比例;跨阶段还存在数据量与监督结构的变化,不能解释成“任何模型训练到 29% 就该加入问答”。
可以从任务要求理解这种可能的联系:回答表格问题需要关注表头、数值与行列关系,这些关系也有助于结构恢复;但模型连局部文字都还认不稳时,额外的任务目标可能干扰基础能力学习。前者是任务层面的解释,实验直接验证的是阶段结果的变化,并没有定位模型内部发生作用的唯一机制。
小模型的成绩,要连着任务和流程看
最终模型同时获得了较强的解析与理解成绩,但两类成绩需要分别看。作者报告,Xiaomi-OCR-0 在 DocVQA、InfoVQA、ChartQA、OCRBench 和 TextVQA 五项基准上的平均分为 83.2,高于所列 Qwen3.5-0.8B 的 72.9。这里的平均分按五项任务的 0–100 尺度计算,不能当作任意文档问答都有 83.2% 的准确率。
文档解析的 OmniDocBench v1.6 综合分为 96.83,但对应的是两阶段系统:先由外部 PP-DocLayoutV3 检测区域,再让 Xiaomi-OCR-0 识别裁块,最后组装整页结果。0.8B 只指视觉语言模型,不包含外部版面检测器。这份成绩也不能直接代表单次整页输入的表现。
容量对照同样有启发。论文中的 4B 专项解析教师得分为 96.9745,0.8B Mix-RL 模型为 96.8277,差距约 0.15 分;理解任务中,4B 专项教师为 88.1,0.8B 模型为 83.2,差距约 4.9 分。
这里的教师是分别专注解析或理解的参考模型;0.8B 模型同时训练两类任务。每个任务使用的数据量相同,但任务配比不同,因此不是只改变参数量的严格对照。它提示的边界仍然清楚:解析成绩接近,不代表理解能力也已接近。模型够不够用,要按任务验证;参数少也不能直接推出速度快或内存占用低。
“先读准,再读懂”说的是训练能力的建立顺序。它不要求用户使用时先调用一个解析模型,再调用另一个理解模型。对开发者而言,这份报告提供了一个具体的检查方向:增加问答或抽取数据后,既看理解指标有没有提高,也回头看文字、表格和阅读顺序是否退步;出现退步时,检查原有解析基础、整页监督和任务配比,而不是只继续堆数据。
2026 年 10 月 OCR 更新:长文档怎么读,识别结果谁来验?
论文: https://arxiv.org/abs/2609.36136代码与运行说明: https://github.com/xiaomi-research/Xiaomi-OCR-0模型权重: https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
参考资料
•Xiaomi-OCR-0 技术报告(方法、阶段消融与评测口径): https://arxiv.org/abs/2609.36136
•Xiaomi-OCR-0 官方仓库(发布记录与运行流程): https://github.com/xiaomi-research/Xiaomi-OCR-0
•Xiaomi-OCR-0 官方模型卡(任务、模型权重与评测说明): https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
文章仅做学术分享,如有侵权请联系删除,非常感谢!