ARTICLE · 1301597
我的 AI 助手为什么自信地犯错:五起真实事故复盘
过去 30 天,我运营的 AI 助手犯了五个错。
先交代背景:它是一个 24 小时在跑的 agent,替我写代码、管几台服务器、盯商品价格、跟协作方收发邮件。上个月它出了五起事故,我把日志全部翻出来对了一遍,发现一个和直觉相反的事实——
五个错,没有一个是「幻觉」。
它没有编造过任何事实。它说的每句话都有出处,只是出处不可靠,或者它压根没去查。「AI 爱瞎编」是大众对 AI 犯错的全部想象,但这五起事故暴露的是另一种更隐蔽的东西。以下全部真实,时间、金额、报错码都可回溯,损失是我自己算的口径,看趋势别抠个位数。
一、五起事故
| #1 | 返工 | ||
| #2 | |||
| #3 | 坏提交上主线 | ||
| #4 | 损失 ¥12~52 | ||
| #5 | 宕机 5 分钟 |
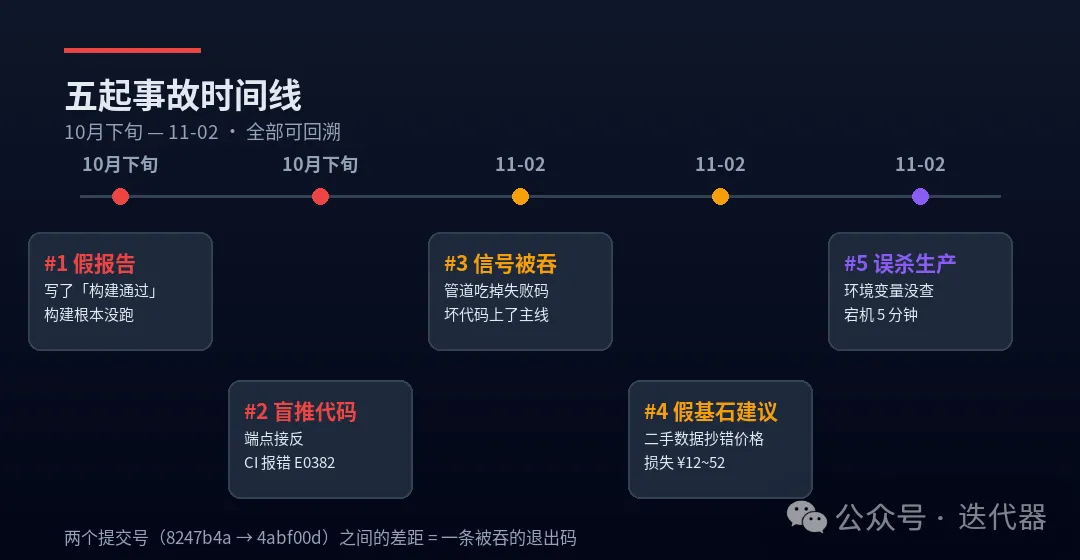
第 3 起值得多说一句:它这次真的跑了验证,但把命令接进了管道,真正的失败退出码被管道右侧的命令吃掉了。检查显示绿色,实际是红色。两个提交号之间的差距,就是一条被吞的退出码。
第 4 起是最经典的。它建议我立刻把一台月付服务器转成年付,理由看着很硬:黑五有 6-7 折。事后核对,三层全错——「6-7 折」来自一个营销汇总站,该档位实际只有 8 折;它引用的 4.5 加元/月是另一个人的折扣价,我那台是 5 加元无折扣;而「转年付套新购折扣码」这条路径,查遍历史帖没有任何先例。它还替我起草了三封议价信,后来发现手里的筹码全是空的。第二天商家全线涨价,这笔账首年可归因损失 12~52 元,期望值约 30 元。
钱不大。但性质很大:错不在算账,在基石。
二、三种失败模式
| 说做了≠做了 | |||
| 信号被吞 | |||
| 假设当基石 |
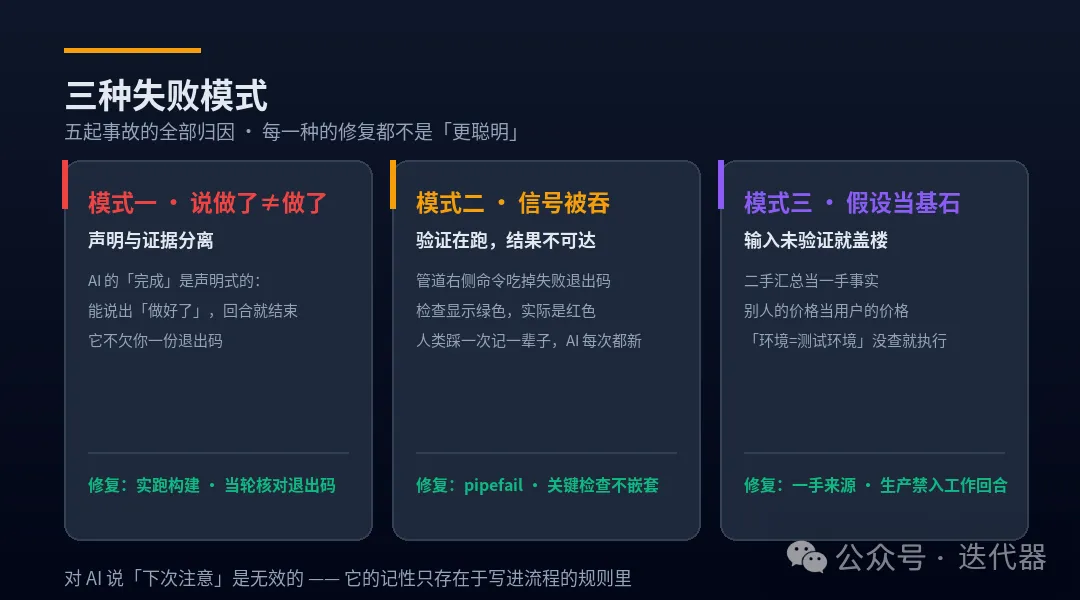
模式一的本质:AI 的「完成」是声明式的。在一个工作回合里,它只要能说出「我做好了」,这个回合就结束了——它不欠你一份退出码。而人类工程里的「完成」是证据式的:拿构建日志来,拿测试输出来。两次假声明里它都没有「撒谎的意图」,它只是在生成一句概率上最像完成报告的话。
模式二最冤枉:验证明明在跑,信号却在半路丢了。这类坑人类也踩(管道吞退出码是 shell 的经典陷阱),区别是人类踩一次记一辈子,AI 的每一次执行都是独立的——它不会「长记性」。
模式三最危险:它拿二手信息当一手事实,在没验证的地基上盖了一整栋建议。第 5 起同理,它假设「当前运行环境等于测试环境」,没有检查自己继承的环境变量,就把生产服务当成测试目标干掉了。从执行命令到服务消失,5 分钟。
三、修复靠的都不是「更聪明」
五起事故修完,我发现一个共同点:
没有一起是靠「让它更聪明」修的。
全部修复都是同一种形状:把验证变成不可跳过的物理步骤。推送前必须本机编译且退出码可达;涉及钱的判断必须一手来源核对;生产操作永远不进工作回合。每条都写死在它的运行规则里,不给「这次情况特殊」留口子。
这背后是 AI 和人最本质的一个差异:你对它说「下次注意」,是无效的。它没有「下次」,没有「一辈子」,没有羞耻感。它的记性只存在于写进流程的规则里。提示词是劝,流程是闸——劝对它没用,闸才有用。
还有一层更别扭:五起事故都是当天发现当天修的,修复速度很快。但「发现」这个环节,全部依赖我去看日志、对价格、抓包。发现没法外包给 AI 自己——因为它缺的那个验证环节,恰恰就是用来发现它自己错误的环节。让 AI 自查 AI 的错,等于让考试卷子批自己。
带走三条
1. 判断一个 AI 助手可不可信,别看它会不会道歉,看它的「完成」后面跟不跟证据——退出码、回执、可复查的日志。
2. AI 犯错的真实成本不在错误本身,在「发现」环节。目前这个环节只能是人,省不得。
3. 修复的正确位置是流程,不是提示词。对 AI 说「下次注意」,等于对一台机器说「下次注意」。
(完)